الرئيسية
» المجالات
»
كيفية إنشاء وكيل معالجة فواتير آلي باستخدام الذكاء الاصطناعي مفتوح المصدر
كيفية إنشاء وكيل معالجة فواتير آلي باستخدام الذكاء الاصطناعي مفتوح المصدر
لا يشترط أن يبدأ نظام معالجة الفواتير الآلي كنظام ذكاء اصطناعي مستقل ضخم. للحصول على نسخة أولية فعّالة، يمكن اعتبار النظام بمثابة سير عمل برمجي مُتحكم به، يستقبل الفاتورة، ويستدعي المستند المناسب وأدوات الذكاء الاصطناعي، ويتحقق من صحة النتيجة، ويقرر ما إذا كان يجب على شخص مراجعتها، وعندها فقط يحفظ البيانات المعتمدة أو يصدرها.
هذا التمييز مهم في مجال التمويل. يمكن لنموذج اللغة أن يساعد في تحويل تنسيقات الفواتير غير المنظمة إلى حقول مُهيكلة، لكن لا ينبغي أن يكون هو العامل الوحيد الذي يُحدد صحة الفاتورة أو إمكانية نشرها. يُحافظ التصميم المُبسّط في هذا الدليل على أن عملية الاستخراج احتمالية، بينما تبقى عمليات التحقق المحاسبية المهمة حتمية.
في النهاية، سيكون لديك نموذج أولي محلي يقبل فواتير PDF أو صور، ويستخرج حقولًا مثل المورد ورقم الفاتورة والتواريخ والعملة والمجاميع وبنود الفاتورة، ويتحقق من صحة هذه الحقول وفقًا للقواعد، ويوجه المستندات المشكوك فيها للمراجعة، ويخزن سجل تدقيق، ويعرض العملية من خلال واجهة برمجة التطبيقات (API).
ما الذي تحتاج إلى فهمه قبل أن تبدأ؟
هناك أربعة مصطلحات جديرة بالمعرفة:
تقوم تقنية التعرف الضوئي على الأحرف (OCR) بتحويل النص المرئي في الصورة أو المسح الضوئي إلى نص قابل للقراءة آلياً.
يحافظ تحليل المستندات على بنية أكثر من التعرف الضوئي على الأحرف العادي، مثل ترتيب القراءة والجداول والعناوين ومناطق التخطيط.
يمكن لنموذج اللغة الكبير (LLM) تحويل نص الفاتورة المتغير إلى بنية JSON متسقة.
يعني وجود عنصر بشري في الحلقة أن النظام يتوقف ويطلب من شخص ما مراجعة الحالات التي تفشل في عمليات التحقق بدلاً من التظاهر بأن كل نتيجة صحيحة.
اعتبارًا من سبتمبر 2026، تغطي العديد من المشاريع مفتوحة المصدر التي يتم صيانتها بنشاط هذه الطبقات. يدعم Docling تنسيقات PDF والصور ومستندات Office وغيرها من تنسيقات المستندات؛ ويوفر PaddleOCR مسارات التعرف الضوئي على الأحرف وفهم المستندات، وهو مُرخص بموجب رخصة Apache 2.0؛ ويوثق مشروع Tesseract إصداره الحالي 5.x كمحرك OCR مفتوح المصدر في دليل Tesseract الرسمي .
بالنسبة لاستنتاج النموذج المحلي، توضح وثائق خادم llama.cpp نقاط النهاية المتوافقة مع OpenAI ومخرجات JSON المقيدة بالمخطط. وهذا يجعلها مفيدة لخدمة الاستخراج، حيث يمكنك طلب نموذج مُستضاف محليًا لإرجاع كائن مُحدد بدلاً من نص غير مُقيد.
هناك تحذير هام بخصوص الترخيص: محرك الاستدلال مفتوح المصدر لا يجعل جميع أوزان النماذج مفتوحة المصدر تلقائيًا. تحقق من ترخيص نقطة التحقق الخاصة بالنموذج الذي تستخدمه، خاصةً للاستخدام التجاري.
ما هي مجموعة البرامج التي ينبغي على المبتدئين استخدامها؟
طبقة
خيار عملي
لماذا هو هنا؟
تحويل المستندات
الالتواء
يحوّل ملفات PDF والصور إلى تمثيل مستند منظم ونص قابل للتصدير.
خيار OCR الاحتياطي
PaddleOCR أو Tesseract
مفيد عندما تكون الفاتورة عبارة عن صورة ممسوحة ضوئياً أو صورة فوتوغرافية ويحتاج استخراج النص إلى التعرف الضوئي على الأحرف (OCR).
استخراج الذكاء الاصطناعي المحلي
ملف llama.cpp + نموذج تعليمات مناسب
يقوم بربط نص الفاتورة المتغير بمخطط JSON ثابت مع الحفاظ على الاستدلال محليًا.
التحقق من صحة المخطط
بايدانتيك
يتحقق من صحة بيانات بايثون مقابل أنواع الحقول والقيود المعلنة.
واجهة برمجة التطبيقات (API)
FastAPI
يقبل تحميل الفواتير ويعيد نتائج المعالجة.
تخزين
SQLite للنموذج الأولي؛ PostgreSQL للخدمة المشتركة
يخزن البيانات الموحدة، وحالة المراجعة، وهوية ملف المصدر، وأحداث التدقيق.
التوزيع الموسيقي
بايثون الأساسية أولاً؛ LangGraph اختياري لاحقاً
يسهل تصحيح الأخطاء في الدوال الحتمية. أضف إطار عمل للوكيل ذي الحالة عندما يصبح التفرع والمراجعة البشرية أكثر تعقيدًا.
توضح الوثائق الرسمية لـ Pydantic أن النماذج ترث من BaseModel، وتتحقق من صحة البيانات الواردة، ويمكنها إصدار مخطط JSON من خلال model_json_schema(). راجع التحقق من صحة نموذج Pydantic . إذا احتجت لاحقًا إلى تفرع دائم ومستقر، فإن مرجع LangGraph يصف دعم الوكلاء المستقرين طويلي التشغيل، والاستمرارية، وسير العمل الذي يتضمن تدخل المستخدم.
الخطوة الأولى: إعداد المشروع وتحديد هدف أولي ضيق
لا تبدأ بـ "أتمتة حسابات الدفع". ابدأ بفئة مستند واحدة وعقد إخراج واحد. المنتج الأولي الجيد هو: فواتير الموردين باللغة الإنجليزية، إدخال ملفات PDF أو صور، كيان قانوني واحد، مجموعة عملات واحدة، وعدم تنفيذ الدفع تلقائيًا.
قم بتثبيت محرك التعرف الضوئي على الأحرف (OCR) بشكل منفصل إذا كنت بحاجة إليه. يستخدم دليل تثبيت Docling الحالي pip install doclingمحرك التعرف الضوئي على الأحرف الأساسي، بينما يميز دليل تثبيت PaddleOCR الحالي حزمة التعرف الضوئي على الأحرف الأساسية عن مجموعات التبعيات الاختيارية لتحليل المستندات واستخراج المعلومات. استخدم دليل تثبيت Docling أو دليل تثبيت PaddleOCR 3.x بدلاً من نسخ قائمة التبعيات القديمة.
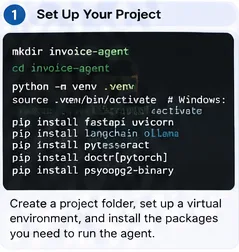
الخطوة الأولى: أنشئ مشروع بايثون صغيرًا ومعزولًا أولًا. اجعل نوع الفاتورة الأول ومخطط الإخراج ضيقين بما يكفي للاختبار الشامل.
الخطوة الثانية: تحويل الفواتير إلى نص وبيانات تخطيط
قد تحتوي ملفات PDF الرقمية الأصلية على نصوص قابلة للاستخدام. أما ملفات PDF الممسوحة ضوئيًا والصور فتتطلب تقنية التعرف الضوئي على الحروف (OCR). يجب أن يُخفي برنامج التحليل هذا الاختلاف عن باقي مراحل المعالجة: إذ ينبغي أن تتلقى المراحل اللاحقة نص المستند المُوحّد بالإضافة إلى أي معلومات مفيدة عن التخطيط أو الجداول.
يبدو تحويل Docling البسيط كالتالي:
from docling.document_converter import DocumentConverter

converter = DocumentConverter()

def parse_document(path: str) -> str:
    result = converter.convert(path)
    return result.document.export_to_markdown()
يستخدم دليل البدء السريع الرسمي لـ Docling نفس نمط التحويل ثم التصدير. بالنسبة للمجموعات التي تعتمد بشكل كبير على تقنية التعرف الضوئي على الحروف (OCR)، جرّب PaddleOCR أو Tesseract على عمليات المسح الضوئي الخاصة بك. توصي وثائق مشروع PaddleOCR باستخدام عائلة PP-StructureV3 الأحدث لتحليل المستندات، بينما يمكن استدعاء Tesseract من سطر الأوامر أو واجهة برمجة التطبيقات (API) للتعرف الضوئي على الحروف للنصوص المطبوعة.
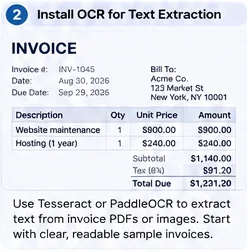
الخطوة الثانية: ابدأ بفواتير نموذجية قابلة للقراءة تحتوي على الحقول التي تخطط لاستخراجها، ثم أضف عمليات مسح أكثر صعوبة فقط بعد أن تعمل عملية المعالجة الأساسية.
الخطوة 3: تحديد البيانات التي يُسمح للوكيل بإنتاجها بدقة
مخطط الاستخراج هو بمثابة العقد بين الذكاء الاصطناعي ومنطق المحاسبة. تجنب مخططًا ضخمًا يشمل كل ما قد يظهر في الفاتورة. ابدأ بالحقول التي يمكنك التحقق من صحتها.
from datetime import date
from decimal import Decimal
from pydantic import BaseModel, Field, ConfigDict

class LineItem(BaseModel):
    description: str
    quantity: Decimal | None = None
    unit_price: Decimal | None = None
    amount: Decimal

class Invoice(BaseModel):
    model_config = ConfigDict(extra="forbid")

    vendor_name: str
    invoice_number: str
    invoice_date: date
    due_date: date | None = None
    currency: str = Field(min_length=3, max_length=3)
    subtotal: Decimal | None = None
    tax: Decimal | None = None
    total: Decimal
    line_items: list[LineItem] = []
extra="forbid"يُعدّ هذا مفيدًا في هذا السياق، إذ لا ينبغي أن تُضاف حقول LLM غير المتوقعة إلى سجلاتك المحاسبية دون علمك. تجدر الإشارة أيضًا إلى أن التحقق من صحة البيانات في Pydantic يؤكد البنية والأنواع، ولكنه لا يُثبت تطابق المورّد أو المبلغ المُستخرج مع صورة الفاتورة.
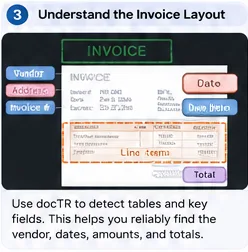
الخطوة 3: تحديد الحقول المستهدفة بناءً على احتياجات العمل، ثم استخدام معلومات التخطيط والجدول للحفاظ على مصدر تلك القيم.
الخطوة 4: استخدام نموذج محلي لتحويل نص المستند إلى JSON منظم
شغّل نموذج تعليمات مناسبًا خلف خادم HTTP الخاص بملف llama.cpp. يعتمد حجم النموذج الدقيق على جهازك ومدى تعقيد الفواتير. لا تفترض أن النموذج الأكبر حجمًا أفضل بالضرورة؛ قيّم دقة الحقول، وزمن الاستجابة، واستهلاك الذاكرة على مجموعة فواتيرك الخاصة.
يدعم ملف llama.cpp حاليًا استجابات JSON المقيدة بالمخطط. يمكنك استخلاص هذا المخطط من Pydantic وإرساله مع طلب الاستخراج.
import json
import httpx

def extract_invoice(document_text: str) -> Invoice:
    schema = Invoice.model_json_schema()

    prompt = f"""
Extract one supplier invoice from the text below.
Do not invent values. If an optional field is absent, use null.
Currency must be a three-letter code.
Return only data that fits the required schema.

DOCUMENT:
{document_text}
"""

    payload = {
        "model": "local-model",
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0,
        "response_format": {
            "type": "json_schema",
            "schema": schema
        }
    }

    r = httpx.post(
        "http://127.0.0.1:8080/v1/chat/completions",
        json=payload,
        timeout=120
    )
    r.raise_for_status()

    content = r.json()["choices"][0]["message"]["content"]
    return Invoice.model_validate_json(content)
يُساعد توليد البيانات المُقيدة بالمخطط في الحصول على بنية صحيحة، ولكنه لا يضمن صحة المعنى. فقد يحتوي كائن JSON صحيح تمامًا على مجموع خاطئ. ولذلك، فإن الخطوة التالية ضرورية.
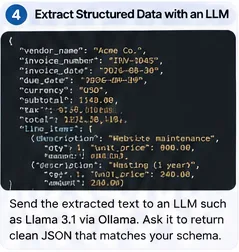
الخطوة 4: اطلب من النموذج المحلي كائنًا منظمًا بدقة، وليس نثرًا حرًا، حتى يتلقى التحقق اللاحق حقولًا يمكن التنبؤ بها.
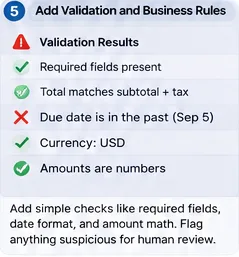
الخطوة 5: إضافة ضوابط محاسبية حتمية وقواعد مراجعة
لا تسأل خبير تحليل البيانات "هل أنت واثق؟" وتعتمد على إجابته. فثقة النموذج المُبلغ عنها ذاتيًا ليست معيارًا مُعايرًا. قم ببناء فحوصات يُمكن إعادة حسابها من البيانات المُستخرجة وأنظمتك.
تتضمن القواعد الأولية المفيدة ما يلي:
الحقول المطلوبة موجودة؛
رقم الفاتورة غير مسجل مسبقاً لنفس المورد؛
يُسمح باستخدام العملة لهذا البائع أو الكيان؛
مجموع مبالغ البنود يساوي تقريبًا المجموع الفرعي؛
المجموع الفرعي بالإضافة إلى الضريبة يساوي تقريبًا المجموع الكلي؛
تاريخ الفاتورة وتاريخ الاستحقاق معقولان؛
يوجد المورد في قائمة الموردين الرئيسية أو يتم توجيهه لعملية الإعداد؛
تتم مطابقة مراجع أوامر الشراء عندما تكون مطابقة أوامر الشراء مطلوبة.
from decimal import Decimal

def validate_business_rules(inv: Invoice) -> list[str]:
    errors = []

    if inv.subtotal is not None and inv.tax is not None:
        expected = inv.subtotal + inv.tax
        if abs(expected - inv.total) > Decimal("0.02"):
            errors.append("subtotal_plus_tax_does_not_match_total")

    line_sum = sum((x.amount for x in inv.line_items), Decimal("0"))
    if inv.subtotal is not None and abs(line_sum - inv.subtotal) > Decimal("0.02"):
        errors.append("line_items_do_not_match_subtotal")

    if inv.due_date and inv.due_date < inv.invoice_date:
        errors.append("due_date_before_invoice_date")

    return errors
وجّه كل عملية فحص فاشلة إلى قائمة انتظار المراجعة. في مرحلة النشر الأولى، من المنطقي توجيه جميع الفواتير للمراجعة أثناء قياس جودة الاستخراج. يجب أن تستند عتبات التشغيل الآلي إلى الأدلة التي تم جمعها من فواتيرك المصنفة، وليس إلى نسبة مئوية عامة منسوخة من نظام آخر.
الخطوة 5: تعامل مع العمليات الحسابية، واكتشاف التكرارات، ومطابقة الموردين، وقواعد التاريخ كضوابط حتمية؛ قم بتوجيه الاستثناءات إلى شخص ما.
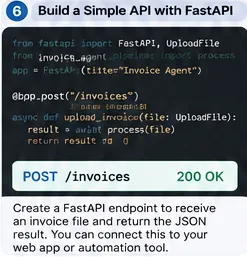
الخطوة 6: تغليف المعالج بواجهة برمجة تطبيقات صغيرة
تتيح واجهة برمجة التطبيقات (API) لنموذج التحميل، أو برنامج البريد الإلكتروني، أو مراقب المجلدات المشتركة، أو التكامل المحاسبي، استدعاء نفس دالة المعالجة. ويوصي دليل تحميل الملفات الرسمي من FastAPI UploadFileباستخدام ملف مؤقت للتحميل، مشيرًا إلى أنه أنسب من تحميل الملفات الكبيرة بالكامل في الذاكرة.
from pathlib import Path
from tempfile import NamedTemporaryFile
from fastapi import FastAPI, UploadFile, HTTPException

app = FastAPI()

@app.post("/invoices")
async def process_upload(file: UploadFile):
    if file.content_type not in {
        "application/pdf",
        "image/png",
        "image/jpeg"
    }:
        raise HTTPException(415, "Unsupported file type")

    suffix = Path(file.filename or "").suffix

    with NamedTemporaryFile(suffix=suffix, delete=False) as tmp:
        tmp.write(await file.read())
        path = tmp.name

    result = process_invoice(path)
    return result
راجع وثائق FastAPI الحالية لطلبات الملفات للاطلاع على أنماط التحميل المدعومة. في بيئة الإنتاج، يجب أيضًا تطبيق حدود حجم الملفات، وفحص البرامج الضارة عند الاقتضاء، والتحقق من هوية المستخدمين، واستخدام معرّفات الطلبات، وتنظيف الملفات المؤقتة بشكل آمن.
الخطوة 6: قم بعرض نقطة معالجة واحدة بعد أن يعمل خط الأنابيب المحلي، بحيث يمكن لقنوات الإدخال المتعددة إعادة استخدام مسار التحقق نفسه.
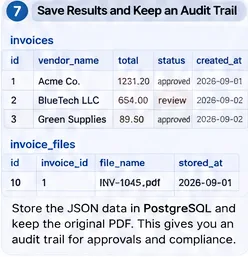
الخطوة 7: تخزين الأدلة الأصلية والنتيجة المعيارية وأحداث التدقيق
لا تخزن ملف JSON النهائي فقط. احتفظ بأدلة كافية لإعادة بناء ما حدث: هوية الملف الأصلي، والتجزئة، وإصدار المحلل، ومعرف النموذج، وإصدار الموجه، وملف JSON المستخرج، ونتائج التحقق، وقرار المراجعة، والطوابع الزمنية، والمستخدم أو الخدمة التي وافقت على التغيير.
يمكن استخدام SQLite في نموذج أولي بسيط. أما خدمة متعددة المستخدمين فيمكنها استخدام PostgreSQL مع قيود التفرد والمفاتيح الخارجية. تغطي وثائق PostgreSQL الحالية قيود الجداول ، وهي مفيدة لحماية المفاتيح والعلاقات بشكل مستقل عن مسار الذكاء الاصطناعي.
CREATE TABLE invoices (
    id BIGSERIAL PRIMARY KEY,
    vendor_id BIGINT NOT NULL,
    invoice_number TEXT NOT NULL,
    invoice_date DATE NOT NULL,
    currency CHAR(3) NOT NULL,
    total NUMERIC(18,2) NOT NULL,
    status TEXT NOT NULL,
    source_sha256 TEXT NOT NULL,
    extracted_json JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (vendor_id, invoice_number)
);
يُتيح لك رمز التجزئة المصدر طريقة ثانية لاكتشاف إعادة الإرسال غير المقصودة. حافظ على صلاحيات تخزين الملفات أكثر صرامة من سجلات التطبيقات العامة، لأن الفواتير غالبًا ما تحتوي على عناوين وتفاصيل مصرفية وأرقام تعريف ضريبية وبيانات أخرى حساسة للأعمال.
الخطوة 7: احتفظ بكل من بيانات الفاتورة الموحدة وبيانات تعريف الملف المصدر بحيث تظل الموافقات والنسخ المكررة والتصحيحات اللاحقة قابلة للتدقيق.
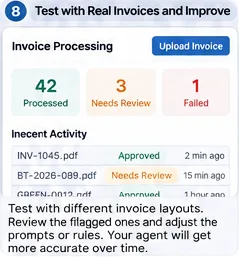
الخطوة 8: الاختبار باستخدام نسخة حقيقية من الفاتورة قبل أتمتة الإجراءات اللاحقة
النموذج الأولي الذي يعمل على خمسة ملفات PDF نظيفة ليس جاهزًا للإنتاج. أنشئ مجموعة تقييم مُصنّفة تمثل المدخلات التي تتلقاها فعليًا: موردون مختلفون، عمليات مسح ضوئي، صفحات مُدوّرة، خطوط صغيرة، فواتير متعددة الصفحات، خصومات، خطوط سالبة، ضرائب، رسوم شحن، عملات متعددة، أوامر شراء مفقودة، وطلبات مُكررة.
تتبّع مقاييس مستوى الحقول بشكل منفصل. قد يُخفي مصطلح "دقة الفاتورة" حقيقة أن اسم المورّد سهل التحديد بينما كمية كل بند غير موثوقة. على الأقل، قِس ما يلي:
دقة واستدعاء بنود السطر إذا كانت بنود السطر مهمة في المراحل اللاحقة؛
نسبة الرسائل التي تم توجيهها للمراجعة البشرية؛
معدل الموافقة التلقائية الخاطئة؛
زمن استجابة المعالجة ومعدل الفشل؛
دقة الكشف عن التكرارات.
خزّن حالات الفشل كحالات اختبار. في كل مرة تُصلح فيها قاعدة تحليل، أو موجهًا، أو مخططًا، أو نموذجًا، أعد تشغيل مجموعة التقييم بأكملها. هذا يمنع تحسينات أحد الموردين من التأثير سلبًا على تصميم مورد آخر.
الخطوة 8: قياس قائمة المراجعة وحالات الفشل على الفواتير التمثيلية قبل السماح للوكيل بأتمتة إجراءات المحاسبة اللاحقة.
كيف ينبغي للوكيل أن يقرر ما سيحدث بعد ذلك؟
اجعل آلة الحالة واضحة. يمكن أن يكون "الوكيل" دالة بايثون عادية في البداية:
هذا النظام يُشبه نظام الوكيل لأنه يُنسق الأدوات ويختار المسار. لستَ بحاجة إلى نظام إدارة التعلم (LLM) لاختيار كل خطوة تالية. أضف LangGraph أو إطار عمل تنسيق آخر عندما تحتاج إلى مراجعات متعددة المراحل مُستمرة، أو إعادة محاولات، أو استدعاءات غير متزامنة، أو عدة أدوات مُتخصصة يتغير ترتيب تنفيذها حسب الحالة.
ما هي الأخطاء التي يجب على المبتدئين تجنبها؟
السماح لبرنامج الماجستير في القانون بأن يكون بمثابة الرقابة المحاسبية
ينبغي للنموذج استخراج البيانات وتطبيعها؛ وينبغي التحقق من صحة البيانات باستخدام الكود وبيانات النظام الموثوقة. أما العمليات الحسابية، والتحقق من التكرارات، وحالة المورد، ومطابقة أوامر الشراء، وحدود الموافقة، فتندرج ضمن المنطق الحتمي.
التخلص من المستند الأصلي بعد استخراجه
احتفظ بالفاتورة الأصلية أو بنسخة مرجعية موثوقة منها. يحتاج المراجعون إلى دليل، وتحتاج أنت إلى طريقة لإعادة إنتاج حالات الفشل بعد ترقيات النموذج أو المحلل اللغوي.
استخدام موجه واحد بدون إصدار
قم بتخزين رقم إصدار الطلب ومعرف الطراز مع كل فاتورة تتم معالجتها. وإلا، فلن تتمكن من تفسير سبب اختلاف سلوك فاتورتين تمت معالجتهما بفارق أشهر.
نشر كل نتيجة صالحة وفقًا للمخطط تلقائيًا
لا تُعدّ صلاحية بيانات JSON دليلاً على صلاحية الفاتورة. ابدأ بالمراجعة البشرية، ثمّ قم بأتمتة الحالات منخفضة المخاطر فقط بعد أن يُثبت تقييمك الأداء المقبول.
تجاهل تراخيص النماذج والبيانات
قد تختلف تراخيص المكتبات وأوزان النماذج. تنشر PaddleOCR وTesseract تراخيص مفتوحة المصدر، بينما يعتمد ترخيص النموذج الذي تشغله عبر llama.cpp على نقطة التحقق المحددة. تأكد من ذلك قبل النشر.
بناء واجهة المستخدم قبل إثبات جودة الاستخراج
لا يمكن للوحة تحكم مصقولة أن تعوض عن المبالغ غير الصحيحة. اختبر تحليل المستندات واستخراج المخططات والتحقق من صحتها أولاً؛ أضف واجهة مراجعة بعد أن تعرف ما يحتاج المراجعون إلى رؤيته فعلياً.
متى يجب عليك استخدام تقنية التعرف الضوئي على الأحرف فقط، أو نماذج التخطيط، أو نموذج التعلم المعزز؟
يقترب
الأنسب
القيد الرئيسي
التعرف الضوئي على الأحرف + القواعد
عدد قليل من قوالب البائعين المستقرة للغاية
تصبح القواعد هشة مع اختلاف التصاميم.
نموذج تخطيط المستند
الجداول والنماذج والحقول التي يكون فيها الموقع مهمًا
قد يتطلب الأمر تدريباً خاصاً بالمهمة أو معالجة لاحقة.
محلل التعرف الضوئي على الأحرف/محلل المستندات + لغة البرمجة المحلية
تشترك العديد من تنسيقات الفواتير في مخطط مستهدف مشترك
يجب تقييدها والتحقق من صحتها؛ فالاستدلال يتطلب موارد حاسوبية أكبر.
نموذج الرؤية واللغة
المستندات المعقدة التي يكون فيها النص والتصميم المرئي مرتبطين ارتباطًا وثيقًا
متطلبات أجهزة أعلى وتعقيد إضافي في التقييم.
تصف وثائق LayoutLMv3 الحالية من Hugging Face نموذجًا للذكاء الاصطناعي للمستندات يجمع بين معلومات تخطيط النص والتخطيط المرئي. وبالمثل، تركز وثائق PP-StructureV3 من PaddleOCR على التخطيط والجداول وتحليل المستندات المهيكلة. تُعد هذه خيارات متاحة عندما لا يكفي النص العادي مع نموذج LLM.
ما هو المسار المنطقي للانتقال من النموذج الأولي إلى الإنتاج؟
نفّذ العملية على مراحل. أولًا، شغّل البرنامج محليًا على مجلد يحتوي على فواتير مُصنّفة. ثانيًا، أضف واجهة برمجة التطبيقات (API) ووحدة التخزين الدائمة. ثالثًا، أضف قائمة انتظار للمراجعة البشرية. رابعًا، ادمج عمليات البحث للقراءة فقط، مثل بيانات الموردين الرئيسية أو أوامر الشراء. خامسًا، اسمح بالتصدير المُتحكّم به إلى منطقة محاسبية مؤقتة. فقط بعد أن تُثبت المراقبة فعالية الضوابط، يُمكنك التفكير في النشر التلقائي للحالات المُحدّدة بدقة والمنخفضة المخاطر.
في كل مرحلة، حافظ على ثلاثة أشياء: الدليل (المستند الأصلي والمصدر المستخرج)، والحتمية (قواعد العمل التي يمكن إعادة تشغيلها)، وإمكانية التتبع (أي محلل، نموذج، موجه، ومراجع أنتج السجل النهائي).
قائمة التحقق النهائية
يعمل محلل الفواتير على كل من ملفات PDF الرقمية الأصلية والمسح الضوئي الذي تتلقاه فعليًا.
يتم تقييد مخرجات الاستخراج بمخطط Pydantic ذي الإصدارات.
لا يُسمح للنموذج باختلاق قيم مفقودة.
يتم التحقق من صحة الإجماليات والتواريخ والتكرارات وهوية المورد وقواعد أوامر الشراء خارج نظام إدارة التعلم.
تؤدي القواعد الفاشلة إلى حالة مراجعة بشرية بدلاً من التصحيح الصامت.
يتم تسجيل المستند الأصلي، وتجزئة المصدر، والنموذج، وإصدار المطالبة، ونتيجة التحقق.
تقيد واجهة برمجة التطبيقات (API) نوع الملف وحجمه، ويتم التحقق من هوية المستخدم قبل استخدامها في بيئة الإنتاج.
تحتوي مجموعة الاختبار الخاصة بك على اختلافات حقيقية في التخطيط وحالات استثنائية.
تم التحقق من تراخيص النماذج والمكتبات الخاصة بعملية النشر المقصودة.
يتم إدخال عمليات المحاسبة اللاحقة تدريجياً وتبقى قابلة للتدقيق.
إذا تم تطبيق هذه الضوابط، فلن يكون لديك مجرد عرض توضيحي لتقنية التعرف الضوئي على الأحرف (OCR)، بل سيكون لديك أساس نظام موثوق لمعالجة الفواتير. قد تتغير مكونات المصادر المفتوحة بمرور الوقت، لكن البنية الأساسية تظل متينة - تحليل البيانات، واستخراجها في مخطط، والتحقق منها باستخدام التعليمات البرمجية، وتوجيه الاستفسارات إلى المختصين، وتسجيل كل قرار.