الرئيسية
» المجالات
»
كيفية قياس جودة استجابة طلاب الماجستير في القانون باستخدام أطر التقييم
كيفية قياس جودة استجابة طلاب الماجستير في القانون باستخدام أطر التقييم
إنّ الطريقة الأكثر موثوقية لقياس جودة استجابة نموذج التعلم الآلي هي التعامل مع التقييم كنظام اختبار قابل للتكرار، وليس كدرجة واحدة. حدّد معنى "جيد" لتطبيقك، وأنشئ مجموعة بيانات تقييم تمثيلية، واجمع بين الفحوصات الحتمية والتقييم القائم على النموذج والتقييم البشري، وقارن كل تغيير مُقترح بالخط الأساسي، وفحص حالات الفشل حسب الفئة قبل إطلاق المنتج.
هذا الأمر بالغ الأهمية لأن نموذج التعلم القائم على التعلم (LLM) قد يُنتج إجابة تبدو مُنمقة ظاهريًا، بينما هي في الواقع خاطئة، أو غير مدعومة بأدلة، أو ناقصة، أو غير آمنة، أو مُتناقضة مع التعليمات. يُحوّل إطار التقييم الفعال هذه المخاوف الغامضة إلى معايير واضحة يُمكن إعادة تطبيقها بعد أي تغيير فوري، أو ترقية للنموذج، أو تغيير في عملية الاسترجاع، أو تحديث للأداة، أو مراجعة لسياسة السلامة.
ملاحظة توثيقية: تم التحقق من إمكانيات الإطار الموضحة أدناه مقابل الوثائق الرسمية المتاحة في 13 سبتمبر 2026. تتطور هذه الأدوات بسرعة، لذا تحقق من واجهات برمجة التطبيقات الحالية قبل نسخ التعليمات البرمجية الخاصة بالإطار إلى بيئة الإنتاج.
ما الذي يجب قياسه أولاً؟
ابدأ بالفشل الذي يهم المستخدمين أكثر من غيره. بالنسبة لروبوت دعم يعتمد على الحقائق، قد يكون الصواب والامتثال للسياسات هما العاملان الرئيسيان. أما بالنسبة للتوليد المعزز بالاسترجاع (RAG)، فإن المصداقية وجودة الاسترجاع مهمتان، لأن الإجابة السلسة قد تتضمن معلومات غير مدعومة بالسياق المسترجع. بالنسبة للوكيل، لا تكفي جودة الإجابة النهائية؛ فقد تحتاج أيضًا إلى تقييم اختيار الأداة، وحججها، وإتمام المهمة، والخطوات غير الضرورية.
بُعد الجودة
ما يطلبه
نوع جيد من المُقيِّمين
الصواب
هل الإجابة صحيحة من الناحية الواقعية أو المنطقية؟
مقارنة المراجع، فحص الكود، محكم ماجستير القانون، أو مراجعة بشرية
التعليمات التالية
هل التزم النموذج بالقيود المطلوبة؟
قواعد المدونة بالإضافة إلى حكم يعتمد على معايير التقييم
الثبات على الأرض
هل تدعم السياق المقدم هذه الادعاءات؟
عمليات التحقق الخاصة بالقاضي أو مستوى المطالبة وفقًا لنظام RAG
الأهمية
هل تجيب الإجابة على السؤال المطروح دون انحراف عن الموضوع؟
قاضي ماجستير القانون أو مراجعة بشرية
الامتثال للتنسيق
هل الناتج بتنسيق JSON صالح، أو متوافق مع المخطط، أو قابل للاستخدام الآلي بأي شكل آخر؟
الكود الحتمي
السلامة والسياسة
هل تخالف الإجابة قواعد التقديم الخاصة بك؟
عمليات تدقيق السياسات، وقاضي برنامج الماجستير في القانون، والمراجعة البشرية المستهدفة
كفاءة
ما هو زمن الاستجابة، واستخدام الرموز المميزة، والتكلفة التي تطلبتها الاستجابة؟
القياس عن بعد والتتبع
لا تُدخل هذه القيم في رقم واحد مبكرًا. قد يكون النموذج المرشح الذي يحقق نقطتين في الأسلوب ولكنه يُدخل عددًا قليلًا من الإخفاقات السياسية الخطيرة إصدارًا أسوأ. حافظ على وضوح الأبعاد الحرجة كبوابات منفصلة.
آلية تقييم من أربع مراحل تعمل عبر مختلف الأطر
1. بناء مجموعة بيانات تقييم تمثيلية
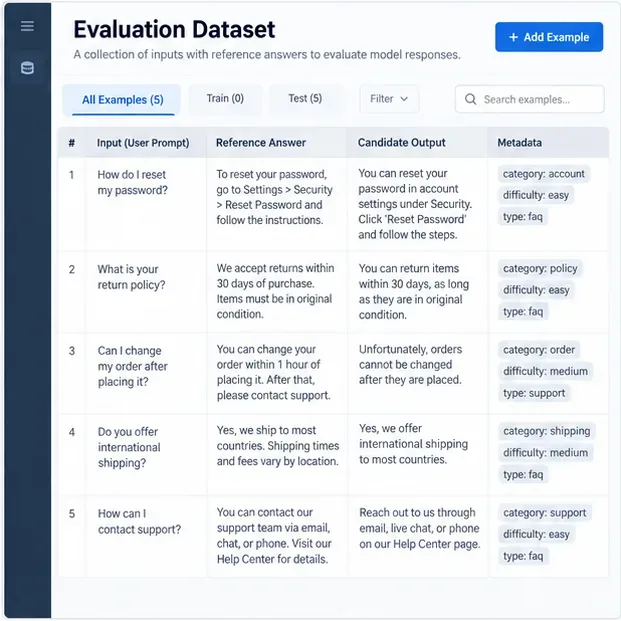
يجب أن تتضمن مجموعة بياناتك مدخلات واقعية، وسلوكًا متوقعًا كلما أمكن. يمكن أن تحتوي بعض الصفوف على إجابات مرجعية دقيقة، بينما قد تحتاج صفوف أخرى إلى معايير تقييم بدلًا من جملة واحدة "مثالية". أضف بيانات وصفية مثل نوع المهمة، وشريحة العملاء، واللغة، ومستوى الصعوبة، وشروط الاسترجاع، أو فئة الأمان، لتتمكن من تحليل النتائج لاحقًا.
على سبيل المثال، تخيل مساعد دعم عملاء. لا تقتصر مجموعة التقييم المفيدة على أسئلة الأسئلة الشائعة البسيطة فحسب، بل يجب أن تشمل أيضًا الطلبات الغامضة، والاستثناءات المتعلقة بالسياسات، وحالات نقص السياق، والمطالبات العدائية، والمتابعات متعددة المراحل، وأمثلة يكون فيها السلوك الصحيح هو القول بأنه لا يمكن تحديد الإجابة.
توصي إرشادات التقييم الحالية لشركة لانغ سميث بالبدء بأمثلة مُنتقاة يدويًا تُظهر السلوك الأمثل، ثم توسيع مجموعة البيانات لتشمل السجلات التاريخية والأعطال المكتشفة في بيئة الإنتاج. يدعم نظام التقييم مجموعات البيانات التي تحتوي على مدخلات، ومخرجات مرجعية اختيارية، وبيانات وصفية. راجع وثائق مفاهيم التقييم الخاصة بشركة لانغ سميث .
ينبغي أن تتضمن مجموعة بيانات التقييم مطالبات واقعية مع مراجع أو سلوك متوقع، وأن تحافظ على البيانات الوصفية لتحليل الفشل لاحقاً.
متى يكون هذا النهج مناسبًا؟ في أغلب الأحيان. حتى عند استخدام تقييم الإنتاج المباشر، لا تزال بحاجة إلى مجموعة بيانات مستقرة غير متصلة بالإنترنت لاختبارات الانحدار. إذا لم يكن لديك إجابة مرجعية للمهام المفتوحة، فقم بتخزين معايير التقييم، والحقائق المطلوبة، والسلوكيات المحظورة، أو تفضيلات الأزواج بدلاً من ذلك.
2. قم بمطابقة كل بُعد من أبعاد الجودة مع المُقيِّم المناسب
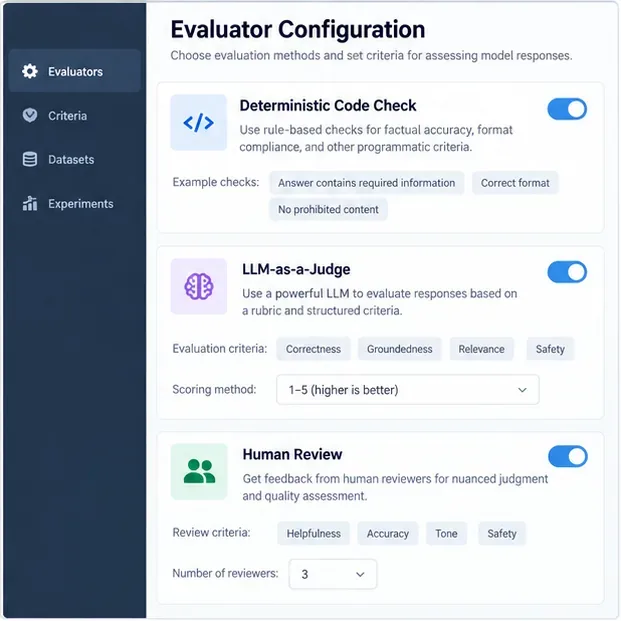
تجمع أقوى مجموعات التقييم بين أنواع المقيمين المختلفة لأنه لا يوجد مصحح واحد مثالي لكل سؤال.
تعتبر عمليات التحقق الحتمية هي الأفضل عندما يكون الشرط واضحًا لا لبس فيه: JSON صالح، وتسميات دقيقة، ومفاتيح مطلوبة، وتسامح عددي، وقواعد التعبير النمطي، أو ما إذا كان استدعاء الأداة قد استخدم وسائط معتمدة.
يمكن أن تساعد المقاييس القائمة على المراجع عندما تكون هناك إجابة معروفة، لكن تشابه السلاسل وحده غالباً ما يكون هشاً للغاية بالنسبة لإعادة الصياغة الصحيحة ومتسامحاً للغاية مع النصوص الخاطئة دلالياً التي تشترك في المفردات.
يُعدّ استخدام LLM-as-a-judge مفيدًا لمعايير مثل الاكتمال، والملاءمة، والنبرة، والأمانة، أو ما إذا كانت الإجابة المفتوحة تفي بمعيار التقييم.
يُعد التقييم الثنائي مفيدًا عندما يكون من الأسهل تحديد ما إذا كان المرشح أ أو الأساس ب أفضل من تحديد درجة مطلقة ذات مغزى.
لا تزال المراجعة البشرية مهمة لمعايرة أدوات التصحيح الآلية، وحل القضايا الذاتية أو ذات المخاطر العالية، والتحقق مما إذا كان المقياس نفسه يعكس قيمة المستخدم.
تُعرّف واجهة برمجة تطبيقات التقييم الحالية من OpenAI التقييمَ على أنه معايير اختبار بالإضافة إلى مخطط مصدر بيانات، وتدعم أدوات التقييم القابلة لإعادة الاستخدام. تتضمن واجهة برمجة تطبيقات التقييم الخاصة بها عمليات فحص السلاسل النصية الحتمية، وأدوات تقييم تشابه النصوص، وأدوات التقييم القائمة على النماذج؛ راجع مرجع واجهة برمجة تطبيقات التقييم من OpenAI ومرجع أدوات التقييم من OpenAI . تدعم خدمة تقييم الذكاء الاصطناعي من Vertex AI التابعة لـ Google Cloud مقاييس قائمة على النماذج، سواءً كانت نقطية أو ثنائية، بالإضافة إلى مقاييس قائمة على الحسابات؛ ويمكن أن تتضمن نتائجها درجات لكل حالة، وتفسيرات، ومتوسطات إجمالية، وانحرافات معيارية، ومعدلات فوز ثنائية. راجع وثائق نتائج تقييم Vertex AI .
استخدم القواعد الحتمية حيثما أمكن، وأضف قضاة ماجستير القانون القائمين على المعايير للجودة الدلالية، واحتفظ بالمراجعة البشرية متاحة للمعايرة والحالات الدقيقة.
متى يكون هذا النهج مناسبًا: استخدم عمليات التحقق الحتمية للمتطلبات القابلة للتحقق آليًا، ومقاييس LLM للجودة الدلالية، والتدخل البشري عندما يكون للاختلاف عواقب مهمة على العمل أو السلامة. بالنسبة لنظام RAG، يوفر Ragas مقاييس مثل دقة السياق، واستدعاء السياق، وملاءمة الاستجابة، ودقتها، بالإضافة إلى مقاييس استخدام الوكيل/الأداة بما في ذلك دقة استدعاء الأداة ودقة الوكيل في تحقيق الهدف. راجع وثائق مقاييس Ragas . وبالمثل، يوفر DeepEval مقاييس خاصة بالمهام وتقييمًا مخصصًا لمقاييس LLM، بما في ذلك تسجيل النقاط على غرار G-Eval؛ راجع وثائق مقاييس DeepEval .
3. قم بتشغيل نفس مجموعة البيانات مقابل خط الأساس والمرشح
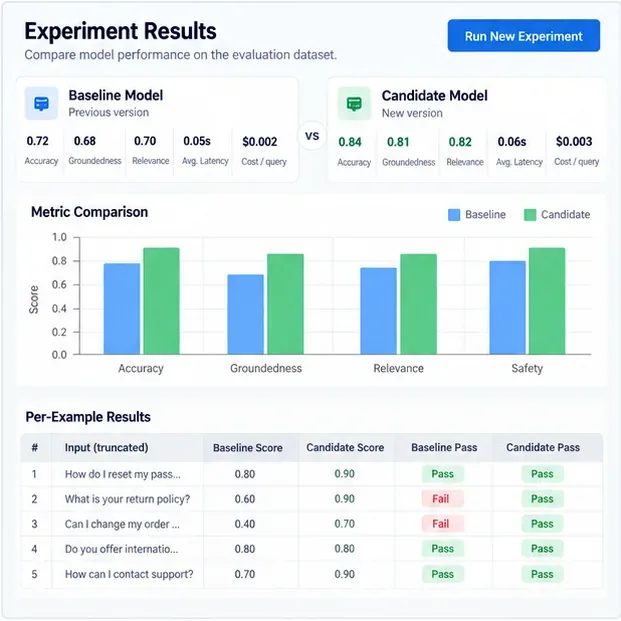
تُعدّ النتائج المطلقة مفيدة، لكن قرارات الإصدار عادةً ما تكون أوضح عند اختبار التكوين الجديد مقابل الإصدار الذي تثق به بالفعل. حافظ على استقرار مجموعة البيانات، وتعريفات المُقيِّم، ومعلمات النموذج، وإعدادات أخذ العينات قدر الإمكان. ثم قارن الأمثلة نفسها جنبًا إلى جنب.
تتبع ثلاثة مستويات على الأقل من النتائج:
نتائج كل مثال على حدة: ما هي المطالبات المحددة التي تحسنت أو تراجعت؟
نتائج كل شريحة: هل تغير الأداء بالنسبة للأسئلة ذات السياق الطويل، أو لغة معينة، أو الحالات الصعبة، أو فئة منتج، أو المدخلات المعادية؟
النتائج الإجمالية: ماذا حدث لمعدل النجاح، ومتوسط الدرجات، وزمن الاستجابة، واستخدام الرموز، والتكلفة، وعدد حالات الفشل الشديد؟
بالنسبة للأنظمة غير الحتمية، يُنصح بإعادة إجراء الاختبارات المهمة مرات كافية لفهم التباين بدلاً من افتراض أن إكمال اختبار واحد يُمثل النموذج. إذا كان قرار الإصدار جوهريًا، فاستخدم مقارنات ثنائية على نفس الأمثلة، وأبلغ عن عدم اليقين بدلاً من الاعتماد فقط على تغيير طفيف في المتوسط.
يدعم LangSmith التجارب غير المتصلة بالإنترنت لمقارنة الإصدارات والمقيّمين الثنائيين، بينما تدعم حزمة تقييم GenAI الحالية في MLflow مجموعات بيانات التقييم، والمسجلات المدمجة والمخصصة، ومحكمي LLM، والتعليقات البشرية، والتتبع، ومراقبة الإنتاج. راجع تقييم LangSmith وتقييم MLflow LLM والوكلاء .
قم بمقارنة المرشح بالخط الأساسي الحالي على نفس الأمثلة، ثم افحص كل من المقاييس الإجمالية ونتائج النجاح أو الفشل لكل مثال على حدة.
متى يكون هذا النهج مناسبًا: عند تغيير أي نموذج، أو موجه النظام، أو مسار الاسترجاع، أو تطبيق الأداة، أو إعدادات فك التشفير. لا ينبغي ترقية أي مرشح لمجرد ارتفاع أحد المقاييس الإجمالية؛ بل يجب أن يستوفي معايير الإصدار على الأبعاد الحرجة ويتجنب التراجعات غير المقبولة على مستوى الشريحة.
4. فحص حالات الفشل، ومعايرة جهاز التقييم، وتحويل حالات التراجع إلى اختبارات جديدة
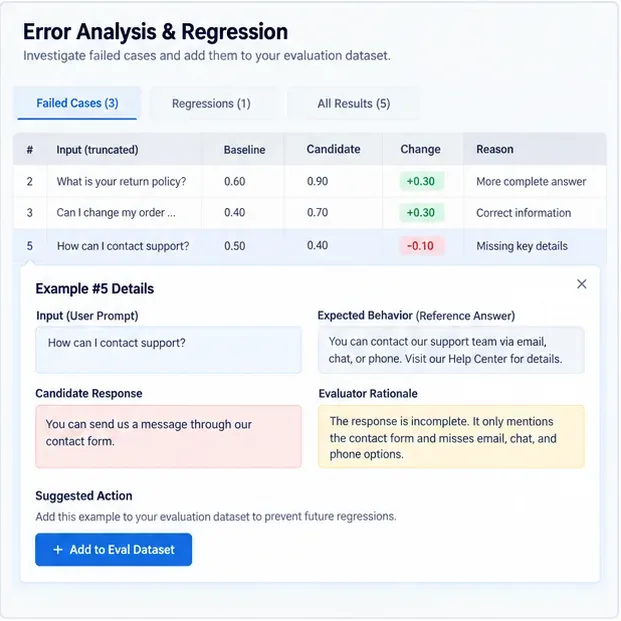
لا تُعدّ عملية التقييم مفيدة إلا إذا غيّرت من خطواتك اللاحقة. صنّف حالات الفشل حسب شدتها وسببها الجذري. قد ينتج انخفاض درجة التأسيس عن ضعف الاسترجاع، أو توجيه يشجع على التخمين، أو معايير تقييم غامضة للغاية، أو إجابة مرجعية غير صحيحة. اقرأ الأمثلة الأساسية قبل تغيير النموذج.
ثم يتم تحويل حالات الفشل المهمة إلى حالات تراجع دائمة. وهذا يخلق حلقة مفرغة: يكشف قسم الإنتاج عن عطل، ويؤكده أحد المستخدمين، وتُضاف الحالة إلى مجموعة البيانات غير المتصلة بالإنترنت، ويتم اختبار الإصلاح على المجموعة الكاملة، ويتم منع الإصدارات المستقبلية من إعادة إدخال المشكلة نفسها.
يحتاج قضاة برامج الماجستير في القانون أيضًا إلى التقييم. توضح وثائق جوجل صراحةً كيفية مقارنة مخرجات المقاييس القائمة على النماذج مع التقييمات البشرية لتقييم مدى كفاءة القاضي في حالة استخدام معينة. وبالمثل، يستخدم مشروع GDPval التابع لـ OpenAI التقييم الثنائي من قبل الخبراء كمعيار أساسي، ويصف التقييم الآلي بأنه تقريب وليس بديلاً عن رأي الخبراء. راجع إرشادات Vertex AI حول تقييم نموذج القاضي ومنهجية GDPval الخاصة بـ OpenAI .
قم بمراجعة الأمثلة الفاشلة الفعلية، وتأكد من أن المُقيِّم يُصدر حكمه بشكل صحيح، وأضف عمليات التراجع المهمة إلى مجموعة الاختبار الدائمة.
متى يكون هذا النهج مناسبًا: دائمًا في حالات الأخطاء الجسيمة، وكلما كان لمُحكِّم رسالة الماجستير في القانون تأثير على قرار الإفراج. إذا اختلف المُراجعون البشريون مرارًا وتكرارًا مع المُحكِّم، فيجب تعديل معايير التقييم، وتوفير مراجع أوضح، وتغيير نموذج المُحكِّم، أو إعادة هذا المعيار إلى المُراجعة البشرية.
ما مدى موثوقية الحاصل على درجة الماجستير في القانون كقاضٍ؟
يتمتع محكمو برامج الماجستير في القانون بسلطة كبيرة لقدرتهم على تقييم المخرجات المفتوحة على نطاق لا يمكن للتقييم البشري وحده تحقيقه. وقد أظهر بحث G-Eval الأصلي ارتباطًا أفضل بكثير بالتقييم البشري مقارنةً بالمقاييس الآلية التقليدية في سياق التلخيص الذي دُرِس. مع ذلك، حذّر البحث نفسه من أن مقيّمي برامج الماجستير في القانون قد يُفضّلون النصوص المُولّدة آليًا. انظر البحث الأصلي لـ G-Eval .
أظهرت دراسة منفصلة أجريت على منصتي MT-Bench وChatbot Arena أن حكام برامج التعلم الآلي المتميزين قادرون على التوافق بشكل جيد مع تفضيلات المستخدمين، مع توثيق التحيزات المتعلقة بالموقف، والإسهاب، وتعزيز الذات، والتفكير المنطقي. راجع الدراسة الأصلية حول استخدام التعلم الآلي كحكم .
الخلاصة العملية ليست "عدم استخدام محكمي LLM مطلقًا"، بل هي: معايرتهم. قم ببناء عينة مصنفة بشريًا، وقم بقياس الاتفاق، وفحص فئات الاختلاف، وقم بترتيب الإجابات عشوائيًا أو تبديلها في الاختبارات الثنائية عندما تكون تأثيرات الموقع محتملة، وتجنب السماح لنفس توجيه المحكم الغامض بتحديد كل قرار إصدار بصمت.
أي إطار تقييم يجب أن تختار؟
نطاق
الأنسب
قوة ملحوظة
مقيّمو OpenAI ومسؤولو التصحيح
الفرق التي تستخدم بالفعل واجهات برمجة تطبيقات OpenAI وترغب في إجراء عمليات تقييم أصلية لواجهة برمجة التطبيقات
تعريفات تقييم قابلة لإعادة الاستخدام مع أدوات تقييم حتمية وقائمة على النماذج
لانغ سميث
تطبيقات ماجستير القانون التي تتطلب التتبع، ومجموعات البيانات، واختبارات الانحدار غير المتصلة بالإنترنت، والتقييم عبر الإنترنت
الفرق التي تركز على لغة بايثون والتي ترغب في تقييمات على غرار الاختبارات وحكام LLM قابلين للتخصيص
كتالوج مقاييس واسع النطاق، وتقييم المكونات/التقييم الشامل، ومقاييس مسار الوكيل
تقييم MLflow GenAI
الفرق التي تستخدم MLflow بالفعل أو ترغب في ربط التقييمات بالتتبع وإدارة دورة الحياة
مجموعات البيانات، والمقيّمون، والتعليقات البشرية، وتتبع التجارب، ومراقبة الإنتاج
تقييم الذكاء الاصطناعي العام من Vertex AI
عمليات النشر على Google Cloud
سير عمل التقييم النقطي، والتقييم الثنائي، والتقييم القائم على النموذج، والتقييم القائم على الحساب
يُعدّ تصميم التقييم أهم من اختيار إطار العمل. يمكنك بناء مجموعة تقييم ضعيفة على منصة متطورة، أو مجموعة قوية باستخدام بضعة نصوص برمجية. فضّل الأداة التي تجعل اختباراتك قابلة للتكرار، ومُؤرشفة، وسهلة الفحص، وسهلة التشغيل قبل كل تغيير جوهري.
بطاقة تقييم عملية للإفراج
بالنسبة لمساعد الإنتاج، يمكن التعبير عن قرار إصدار مفيد بمجموعة من المعايير بدلاً من درجة واحدة مُجمّعة. على سبيل المثال، اشتراط عدم وجود أي إخفاقات أمان حرجة في مجموعة بيانات السلامة المُختارة، وعدم وجود تراجع ذي دلالة إحصائية في صحة المهام، ونسبة نجاح دنيا في أسئلة التقييم (RAG) للتحقق من صحة البيانات، ومخرجات هيكلية صحيحة في كل حالة من حالات المخطط، وأن يكون زمن الاستجابة أو التكلفة ضمن الميزانية التشغيلية. يجب أن تُستمد العتبات الدقيقة من مدى تحملك للمخاطر ومتطلبات المستخدم؛ فلا توجد نسبة مئوية عالمية تجعل نموذج التعلم القائم على التعلم "جيدًا بما فيه الكفاية".
احتفظ أيضًا بالأمثلة الأصلية التي استندت إليها النتيجة. فإذا ارتفع إصدار من 0.84 إلى 0.86، فلا يزال من الضروري معرفة الحالتين اللتين تغيرتا، وما إذا كان لهذه التغييرات أهمية. عمليًا، تستفيد الفرق بشكل أكبر من عدد قليل من حالات الفشل المصنفة بوضوح، مقارنةً بمتوسط لوحة معلومات مثير للإعجاب يفتقر إلى إمكانية التتبع.
أخطاء التقييم الشائعة
اختبار المسارات السعيدة فقط: إضافة الغموض، والحالات الشاذة، ومحاولات الحقن الفوري، والسياق المفقود، والإخفاقات التاريخية المعروفة.
استخدام المطابقة التامة للإجابات المفتوحة: احتفظ بالمطابقة التامة للمخرجات التي تتطلب الدقة فعلاً.
الثقة في قاضي ماجستير القانون دون معايرة: قارن ذلك بالتقييمات البشرية وراجع حالات الاختلاف.
تحسين المتوسط مع إخفاء الإخفاقات الخطيرة: الحفاظ على السلامة والسياسة والأبعاد الحاسمة الأخرى كبوابات صريحة.
تغيير مجموعة البيانات أثناء مقارنة النماذج: قم بتجميد مجموعة المقارنة أو إصدارها بحيث تظل النتائج قابلة للتفسير.
تجاهل انحراف الإنتاج: تحمي التقييمات غير المتصلة بالإنترنت الإصدارات؛ ويكشف التقييم عبر الإنترنت والمراجعة البشرية المأخوذة عينات منها عن سلوك المستخدم الجديد وأنماط الفشل الجديدة.
خلاصة القول
يُعدّ قياس جودة استجابة نموذج التعلم القائم على اللغة تخصصًا هندسيًا، وليس مجرد اختبار مبدئي. ابدأ بمجموعة بيانات تمثيلية، وحدد أبعاد الجودة الخاصة بكل مهمة، واختر فحوصات حتمية حيثما أمكن حساب المتطلبات، واستخدم أدوات تقييم نموذج التعلم القائم على اللغة عند الحاجة إلى التقييم الدلالي، وقم بمعايرة هذه الأدوات مع البشر، وقارن التغييرات المقترحة بخط أساس ثابت. ثم حوّل كل فشل مهم في الواقع العملي إلى اختبار انحدار مستقبلي.
إذا اتبعت تلك الحلقة، فإن إطار التقييم يصبح أكثر من مجرد لوحة معلومات لإعداد التقارير: يصبح نظام مراقبة الجودة الذي يخبرك ما إذا كان الموجه أو النموذج أو تغيير الاسترجاع أو تحديث الوكيل قد جعل المنتج أفضل بالفعل.