CrewAI 에이전트가 중복 작업을 실행하지 않도록 하는 방법: 실용적인 중복 제거 가이드

CrewAI 에이전트가 작업을 반복하지 않도록 하려면 작업 소유권, 종속성, 위임, 재시도, Flow 트리거, 상태 지속성, 캐싱 및 멱등성을 수정하십시오.
많은 워크로드에서 LLM API 청구서를 50% 줄이는 것이 가능하지만, 이는 보편적인 보장이 아닙니다. 결과는 지출이 어디서 발생하느냐에 따라 달라집니다: 캐시되지 않은 입력 토큰, 캐시된 입력 토큰, 출력 토큰, 추론 토큰, 도구 호출 또는 재시도 등입니다. 프롬프트 압축은 길거나 반복적인 입력이 청구서의 상당 부분을 차지할 때 가장 효과적입니다. 따라서 실질적인 목표는 "모든 프롬프트를 절반 길이로 만드는 것"이 아니라 "답변을 변경하지 않는 토큰을 제거하고, 답변을 변경하는 토큰은 보존하며, 실제 트래픽에서 절감 효과를 검증하는 것"입니다.
이 가이드는 네 가지 구현 단계를 사용합니다: 기준선 측정, 중복 입력 제거, 캐시 재사용을 위한 프롬프트 정리, API가 지원하는 경우 장황한 출력 지침을 구조화된 컨트롤로 이동. 예시는 벤치마크 주장이 아닌 설명용입니다. 제공업체의 가격 정책과 캐시 동작은 시간이 지남에 따라 변하므로, 프로덕션 추정치를 만들기 전에 현재 요율을 확인하세요.
사용 중인 모델의 청구 방정식부터 시작하세요. 간단한 텍스트 워크로드의 경우, 총 요청 비용은 대략 캐시되지 않은 입력 비용 + 캐시된 입력 비용 + 출력 비용입니다. 일부 모델이나 기능은 다른 과금 항목을 추가합니다. OpenAI의 현재 API 응답은 캐시된 토큰 세부 정보를 포함하여 입력 및 출력 토큰 사용량을 공개하며, 모델 페이지는 입력, 캐시된 입력 및 출력에 대한 별도 요율을 게시합니다.
| 설명용 워크로드 | 입력 토큰 | 출력 토큰 | 상대적 결과 |
|---|---|---|---|
| 기준 요청 | 10,000 | 1,000 | 기준 비용의 100% |
| 입력만 절반으로 줄임 | 5,000 | 1,000 | 출력이 변경되지 않으면 총 절감액은 50% 미만 |
| 입력과 출력 모두 절반으로 줄임 | 5,000 | 500 | 요율이 변경되지 않으면 토큰 기반 비용이 약 50% 낮아짐 |
구체적인 현재 예시로, 공식 GPT-5.6 Sol 모델 페이지는 2026년 9월 11일 기준으로 백만 입력 토큰당 $4, 백만 캐시된 입력 토큰당 $0.40, 백만 출력 토큰당 $20을 명시했습니다. 해당 요율에서 입력 10,000/출력 1,000 요청은 다른 수수료가 제외된 상태에서 약 $0.06입니다. 입력만 5,000 토큰으로 줄이면 이 예시는 약 $0.04가 되어 33% 절감됩니다. 입력과 출력 모두를 절반으로 줄이면 약 $0.03이 되어 50% 절감됩니다. 이러한 가격은 변경될 수 있으므로, 산술을 영구적인 견적이 아닌 방법으로 취급하세요. 현재 가격은 공식 GPT-5.6 Sol 모델 페이지를 참조하세요.
| 기법 | 최적의 적용 대상 | 주요 위험 | 측정해야 할 사항 |
|---|---|---|---|
| 토큰 감사 | 모든 프로덕션 워크로드 | 잘못된 구성 요소 최적화 | 입력, 캐시된 입력, 출력, 재시도, 성공적인 작업당 비용 |
| 중복 제거 | 긴 시스템 프롬프트, 반복적인 정책, 장황한 예시 | 실제로 중요한 제약 조건 삭제 | 작업 성공률 및 지침 준수 동등성 |
| 캐시 친화적 레이아웃 | 안정적인 지침이나 컨텍스트를 공유하는 반복 요청 | 동적 텍스트가 너무 일찍 나타나 캐시 재사용률이 낮음 | 캐시된 토큰 비율 및 지연 시간 |
| 구조화된 출력 컨트롤 | JSON 추출, 분류, 고정 응답 형식 | 작업에 비해 스키마가 너무 경직됨 | 출력 토큰, 파싱 실패, 재시도 |
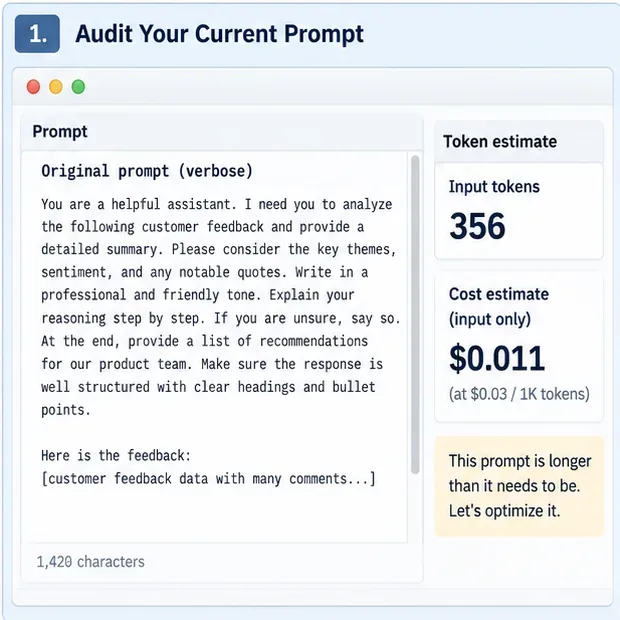
캡션: 설명용 토큰 감사 인터페이스는 압축 전 원래 프롬프트 크기와 샘플 비용 추정치를 기록합니다. 수치는 현재 제공업체 가격이 아닙니다.
하나의 수동으로 선택된 프롬프트를 최적화하는 대신 프로덕션 요청의 대표 샘플을 수집하세요. 최소한 입력 토큰, 가능한 경우 캐시된 입력 토큰, 출력 토큰, 모델 이름, 지연 시간, 재시도 횟수, 최종 답변이 비즈니스 품질 검사를 통과했는지 여부를 기록하세요. 제공업체가 입력 토큰 카운팅 엔드포인트를 제공하는 경우, 결정적인 예산 관리가 필요할 때 요청을 보내기 전에 이를 사용하세요. OpenAI는 현재 공식 API 참조에서 Responses 입력 토큰 카운팅 엔드포인트를 문서화하고 있습니다.
단순 API 호출 비용이 아닌, 성공적인 작업당 비용을 계산하세요. 재시도를 더 많이 유발하는 압축된 프롬프트는 각 요청이 더 짧더라도 더 비쌀 수 있습니다. 기준선을 작업 유형별로도 세분화하세요: 요약, 추출, RAG 질문 답변, 에이전트 도구 사용, 긴 대화는 일반적으로 다른 토큰 프로필을 가집니다.

캡션: 설명용 전후 프롬프트는 반복적인 문구와 불필요한 프로세스 지침을 제거하면서 동일한 요청된 출력을 유지합니다.
가장 안전한 첫 번째 압축 패스는 의미적 중복 제거입니다. 반복적인 역할 설명, 중복된 제약 조건, 정중한 채우기 문구, 명백한 형식에 대한 설명, 동일한 패턴을 두 번 이상 가르치는 예시를 삭제하세요. 겹치는 규칙을 하나의 지침으로 병합하세요. 동일한 요구 사항을 반복하는 여러 문장보다 하나의 정확한 문장을 선호하세요.
You are a helpful assistant who is an expert in product analysis.
I need you to analyze the following customer feedback and provide
a detailed summary. Please identify the key themes, overall sentiment,
notable quotes, and recommendations for our product team. Make sure
your response is professional, clear, concise, and well structured.
Analyze the customer feedback.
Return: key themes, overall sentiment, notable quotes, and product recommendations.
Be concise and factual.
예외, 정책 경계, 도메인 정의, 도구 안전 규칙 또는 증거 요구 사항이 길다는 이유만으로 압축하여 제거하지 마세요. 이러한 항목은 종종 높은 가치의 토큰입니다. 유용한 테스트는 "이 문장을 제거하면 허용 가능한 출력이 변경될 수 있는가?"라고 묻는 것입니다. 그렇다면, API 컨트롤이나 스키마가 동일한 동작을 더 신뢰성 있게 강제할 수 없는 한 유지하세요.
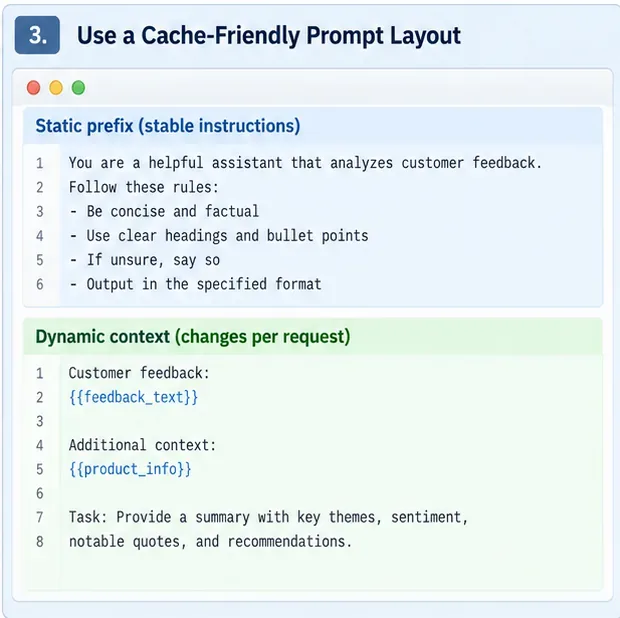
캡션: 설명용 프롬프트 레이아웃은 안정적인 지침을 재사용 가능한 접두어에 배치하고 요청별 컨텍스트를 나중에 추가합니다.
프롬프트 캐싱은 원시 토큰 수를 줄이지 않지만, 일반 입력 요율로 청구되는 금액을 줄이고 프롬프트 처리 지연 시간을 낮출 수 있습니다. 이로 인해 프롬프트 레이아웃이 비용 최적화의 일부가 됩니다. 시스템 지침, 공유 예시, 도구 가이드 및 기타 안정적인 콘텐츠를 함께 그룹화하세요. 요청별 사실, 검색된 구절, 사용자 데이터 및 현재 질문은 나중에 배치하세요.
OpenAI의 모델 가이드는 프롬프트 캐시 재사용을 개선하기 위해 정적 콘텐츠를 먼저, 동적 콘텐츠를 마지막에 배치할 것을 명시적으로 권장하며, 응답 사용량 객체는 측정을 위해 캐시된 토큰 정보를 공개합니다. 공식 모델 가이드 및 Responses API 참조를 참조하세요.
제공업체의 캐시 시맨틱이 이러한 변경이 안전하다고 명시하지 않는 한, 재사용 가능한 접두어 내에서 무해한 공백, 예시 순서, 타임스탬프, 랜덤 ID 또는 사용자별 텍스트를 변경하지 마세요. 프롬프트가 재사용되고 있다고 가정하는 대신 API 응답에서 캐시 적중률을 측정하세요.
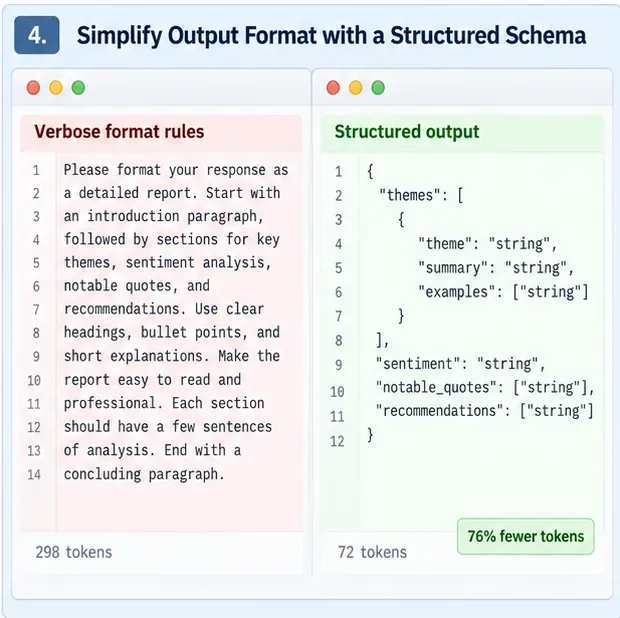
캡션: 설명용 구조화된 출력 뷰는 스키마가 동일한 응답 형태를 반복적으로 설명하는 많은 줄의 산문을 어떻게 대체할 수 있는지 보여줍니다.
추출 및 분류 프롬프트는 자연어로 JSON 필드, 허용 값, 중첩, 순서 및 검증 규칙을 설명하는 데 토큰을 낭비하는 경우가 많습니다. API가 구조화된 출력이나 유형화된 도구 인수를 지원하는 경우, 해당 계약의 가능한 한 많은 부분을 구조화된 인터페이스로 이동하고 자연어 지침은 의미에 집중하세요.
현재 OpenAI 가이드는 가능한 경우 프롬프트에서 출력 스키마 정의를 제거하고 대신 구조화된 출력(Structured Outputs)을 사용할 것을 구체적으로 권장합니다. 이는 프롬프트 텍스트를 줄일 수 있을 뿐만 아니라 잘못된 출력으로 인한 재시도를 줄일 수도 있습니다. 정확한 메커니즘은 제공업체마다 다르므로, 다른 API에 OpenAI 특정 요청 형식을 복사하기 전에 해당 제공업체의 문서를 확인하세요.
네 가지 기본 단계가 안정화된 후, 더 큰 절감 효과는 일반적으로 문장 다듬기보다 컨텍스트를 줄이는 데서 나옵니다. RAG 시스템에서는 더 적지만 더 관련성 높은 구절을 검색하고, 거의 동일한 청크를 중복 제거하며, 답변에 영향을 미칠 수 없는 문서 첨부 피하세요. 긴 대화의 경우, 내구성 있는 사실과 미해결된 결정은 유지하되, 현재 작업에 더 이상 영향을 미치지 않는 턴은 요약하거나 삭제하세요. 에이전트 시스템의 경우, 아키텍처가 안전하게 허용하는 경우 현재 단계와 관련된 도구와 도구 설명만 노출하세요.
학습된 프롬프트 압축기는 매우 긴 컨텍스트에 대한 또 다른 옵션입니다. Microsoft의 오픈소스 LLMLingua 프로젝트는 토큰 수준 프롬프트 압축을 구현합니다. 원본 LLMLingua 논문은 평가된 설정에서 제한된 벤치마크 저하와 함께 최대 20배의 압축률을 보고했습니다. LongLLMLingua는 긴 컨텍스트 작업을 목표로 하며, LLMLingua-2는 작업에 구애받지 않는 학습된 압축기를 사용합니다. 이러한 결과는 연구 결과일 뿐이며, 동일한 비율이 데이터에서 품질을 보존할 것이라는 보장은 아닙니다. 공격적인 압축을 배포하기 전에 자체 작업, 언어, 모델 및 프롬프트 유형을 벤치마킹하세요.
동일한 대표 요청에서 A/B 평가를 실행하세요. 기준선과 압축 버전은 동일한 모델, 추론 설정, 도구, 검색 입력 및 성공 기준을 사용해야 합니다. 회귀의 원인을 식별할 수 있도록 가능한 경우 한 번에 하나의 압축 기법만 변경하세요.
| 지표 | 중요한 이유 | 제안된 해석 |
|---|---|---|
| 입력 토큰 감소 | 원시 프롬프트 축소 표시 | 유용하지만 그 자체로는 충분하지 않음 |
| 캐시된 토큰 비율 | 안정적인 접두어가 재사용되는지 여부 표시 | 품질이 변경되지 않으면 높을수록 일반적으로 더 좋음 |
| 출력 토큰 감소 | 총 비용을 실질적으로 변경할 수 있음 | 간결한 출력이 여전히 작업을 완료하는지 확인 |
| 성공적인 작업당 비용 | 재시도 및 실패 포함 | 이것이 주요 비즈니스 지표임 |
| 작업 성공률 / 정확도 | 정보 손실 감지 | 테스트 전에 허용 가능한 비열등성 임계값 설정 |
| p50 및 p95 지연 시간 | 실제 사용자 영향 표시 | 압축 전처리 비용이 추론 절감 효과를 상쇄할 수 있음 |
프롬프트가 50% 짧아졌다고 해서 승리를 선언하지 마세요. 더 강력한 수용 조건은 압축된 구성이 사전 정의된 품질, 지연 시간 및 신뢰성 허용 범위 내에 머무르면서 측정된 비용을 목표 금액만큼 줄이는 것입니다.
다음 절감이 올바른 결정을 위해 필요한 사실을 제거하거나, 환각을 증가시키거나, 도구 호출 오류를 유발하거나, 정책 준수를 약화시키거나, 절감 효과를 상쇄할 정도로 재시도를 증가시킬 때 압축을 중단하거나 후퇴하세요. 각 프롬프트를 압축하기 위해 별도의 모델을 실행하는 경우 압축으로 인해 지연 시간이 추가될 수도 있습니다. 실제 추론 환경에서의 프롬프트 압축에 관한 2026년 연구는 유리한 프롬프트 길이 및 하드웨어 영역 밖에서는 전처리 오버헤드가 추론 이득을 상쇄할 수 있음을 발견했으며, 이는 토큰 수만이 아닌 엔드투엔드 성능을 측정해야 하는 또 다른 이유입니다.
작은 프롬프트의 경우, 전용 압축 모델을 추가하는 것보다 수동 정리 및 캐시 친화적 정리가 일반적으로 더 정당화됩니다. 큰 RAG 페이로드나 다중 문서 워크플로우의 경우, 제거 가능한 토큰 볼륨이 훨씬 크기 때문에 컨텍스트 선택 및 학습된 압축이 더 매력적입니다.
50% 절감은 일부 장황하고 컨텍스트가 많은 워크로드에 대해 합리적인 엔지니어링 목표이지만, 기본 기대치가 아니라 검증해야 할 결과로 취급해야 합니다. 가장 신뢰할 수 있는 경로는 먼저 측정하고, 의미적으로 중복된 텍스트를 제거하고, 안전한 캐시 재사용을 극대화하고, 구조화된 컨트롤로 출력 계약을 단축한 다음, 검색 가지치기, 요약 또는 테스트된 프롬프트 압축기를 사용하여 남은 가장 큰 컨텍스트 블록을 공격하는 것입니다. 품질이 수용 범위 내에 머무르는 동안 최종 성공적인 작업당 비용이 감소하면 압축이 작동하고 있는 것입니다. 품질이나 재시도가 악화되면 누락된 정보를 복원하고 요청의 다른 부분을 최적화하세요.
CrewAI 에이전트가 작업을 반복하지 않도록 하려면 작업 소유권, 종속성, 위임, 재시도, Flow 트리거, 상태 지속성, 캐싱 및 멱등성을 수정하십시오.
미국 프리랜서 업무를 위한 독립 계약자 경비 추적기를 구축하세요. IRS 기준 카테고리, 영수증 기록, 2026년 마일리지 요율, 세무 검토 플래그를 포함합니다.
시간 계산기, 야간 근무 수식, 주간 합계, 품질 점검 및 명확한 한계를 갖춘 무료 직원 근무 일정표를 엑셀로 만들어 보세요.
테이블, 드롭다운, 후속 조치 알림, 간단한 파이프라인 요약 기능을 갖춘 실용적인 엑셀 리드 트래커를 구축하고, CRM으로 전환해야 할 시기를 판단하는 명확한 신호를 확인하세요.
서비스 이력, 마감일, 가동 중단 시간, 비용, 점검 기록 및 명확한 안전 경계를 포함하여 작업장 자산용 실용적인 엑셀 장비 유지보수 로그를 구축하세요.
개인 부동산 중개인을 위한 HubSpot 무료 CRM과 Zoho CRM 무료를 연락처 제한, 파이프라인, 이메일, 자동화, 모바일 도구 및 업그레이드 장단점 등을 기준으로 비교해 보세요.
LM Studio를 통해 Windows 11에서 DeepSeek을 로컬로 실행하세요. 일반 PC에 적합한 모델 선택법, 다운로드 및 로드 방법, 오프라인 사용 확인 및 일반적인 문제 해결 방법을 알아보세요.
4가지 실용적인 프롬프트 압축 기법, 캐시 친화적 레이아웃, 구조화된 출력, 품질 보존 평가 계획을 통해 LLM API 비용을 절감하세요.
셀프 호스팅 n8n과 Claude를 사용하여 무료 호스팅이 가능한 AI 콘텐츠 재활용 파이프라인을 구축하세요. 구조화된 출력, 검토 게이트 및 현실적인 API 비용 가이드를 포함합니다.
타임라인, 벤더 추적, 예상 비용 대 실제 비용, 결제 및 당일 작업을 포함한 Word용 실용적인 인쇄 가능한 이벤트 기획 체크리스트 및 예산 템플릿을 사용하세요.







