Local Ollama를 사용하여 SEO 메타 제목 및 설명을 자동 생성하는 방법

구조화된 SEO 제목과 메타 설명을 일괄 생성하고, 결과물을 검증하고, 사람이 검토해야 할 결과를 표시하는 로컬 Ollama 워크플로를 구축하세요.
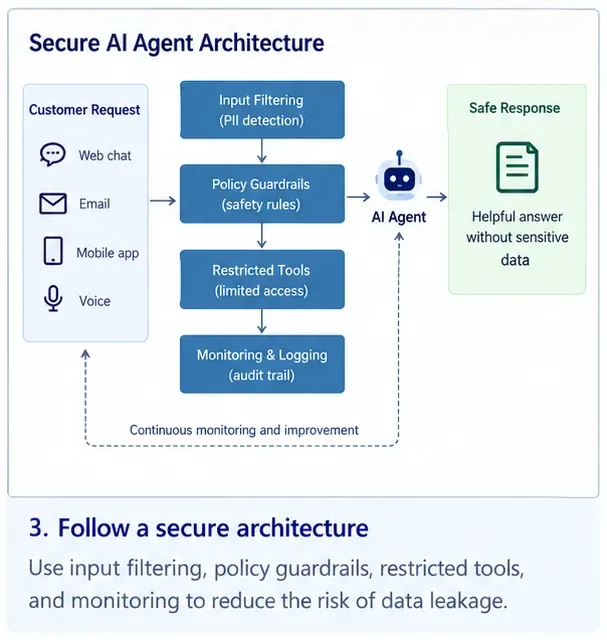
The most effective way to prevent an AI customer-service agent from leaking sensitive data is to make sure the model never receives, retrieves, or can act on more data than the current customer request requires. Do not rely on a system prompt that says “never reveal private information.” Put deterministic controls around the model: minimize and redact inputs, authorize every data lookup outside the LLM, give tools least privilege, isolate each customer’s data, validate responses before delivery, and monitor the entire path.
That design matches the direction of current security guidance. The NIST Generative AI Profile (NIST AI 600-1), published in 2024 and updated by NIST in 2026, treats privacy, security, monitoring, and risk management as lifecycle concerns. The OWASP Top 10 for LLM and Generative AI Applications identifies prompt injection, sensitive-information disclosure, improper output handling, excessive agency, and system-prompt leakage as separate risks. The practical implication is simple: a safe customer-service agent needs multiple independent controls, not one clever prompt.
Before choosing a model or adding more guardrail text, draw the path customer data takes through your system. A typical support agent may receive a message, retrieve CRM records, search a knowledge base, call an order or billing API, generate an answer, write logs, and store conversation memory. Sensitive data can leak at any of those points.
For a basic FAQ bot that never accesses customer-specific records, your primary risk is what customers type into the chat and what gets logged. For an order-status assistant, authorization and field-level filtering become critical. For an agent that can issue refunds, change addresses, or cancel services, tool permissions and transaction confirmation are just as important as response filtering.
Data minimization is the strongest first control because information the model never receives cannot be repeated in its response. The FTC’s Data Security guidance recommends collecting only what you need, keeping it secure, and disposing of it safely. Apply that idea directly to AI context construction.
Suppose a customer asks, “Where is my order?” The model usually does not need the customer’s full payment-card number, tax ID, date of birth, complete address history, or internal fraud notes. Your application can authenticate the customer, call an order service, and pass the model only a narrow result such as order number, shipping status, delivery estimate, and approved support notes.
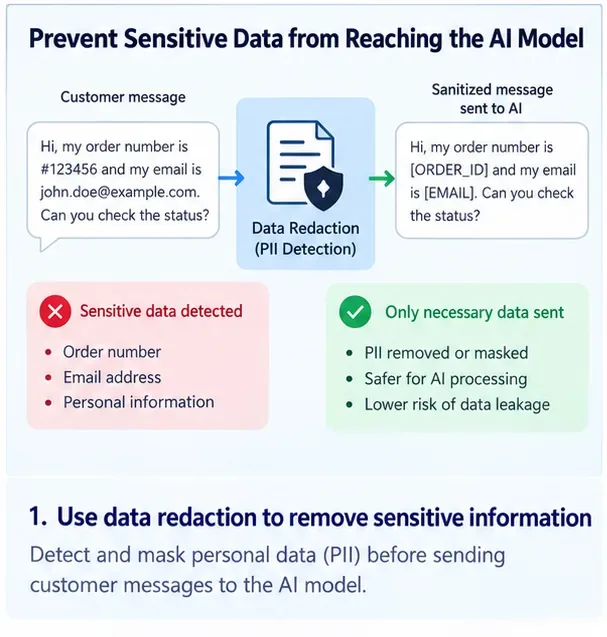
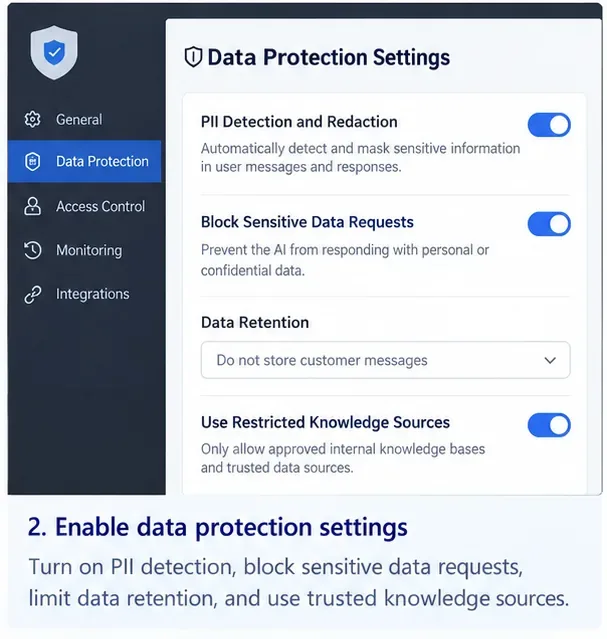
The exact list depends on your business and legal obligations, but common candidates include payment credentials, authentication secrets, government identifiers, health information, full financial account numbers, private addresses, internal security notes, and confidential business data. Use deterministic detectors where possible and maintain domain-specific patterns for your own identifiers.
Do not assume that masking the visible chat is enough. Apply the same policy to retrieved documents, tool responses, agent scratchpads, conversation summaries, analytics events, traces, and error logs.
An AI model should never decide whether Customer A is allowed to read Customer B’s record. Authorization must happen in deterministic application code or an access-control service before data is returned to the agent.
This follows the principle behind NIST SP 800-207, Zero Trust Architecture: access is granted to resources based on authenticated and authorized identities rather than implicit trust. For an AI agent, the same approach means every CRM, ticketing, order, or billing request should carry a verified user identity and be checked against the requested resource.
A safe order lookup might be implemented as “get order status for authenticated_customer_id and order_id,” with the backend confirming ownership before returning a small allowlisted response. A dangerous design is “search all customer records” and then trusting the model to pick the correct one.
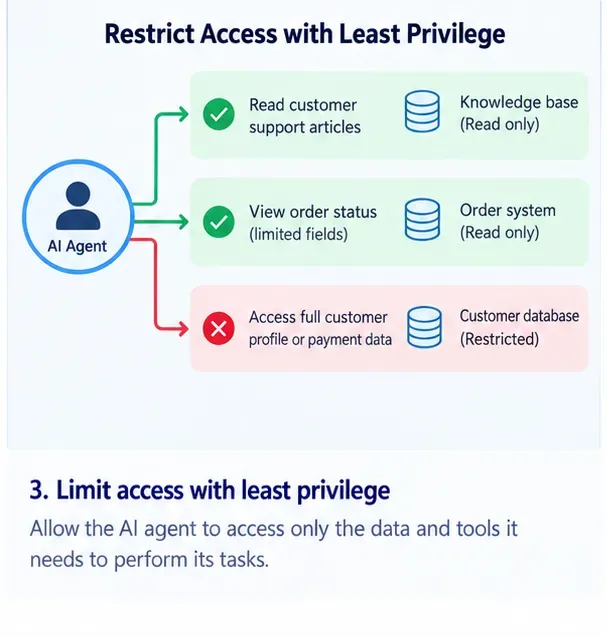
Tool-enabled agents are especially risky because a prompt injection or model error can become an action against a real system. OWASP’s Excessive Agency guidance identifies excessive functionality, excessive permissions, and excessive autonomy as core causes of damaging agent behavior.
고객 서비스 담당자 한 명에게 모든 레코드에 대한 읽기/쓰기 권한이 있는 범용 CRM 자격 증명을 부여하지 마십시오. 권한은 목적에 따라 분리해야 합니다. 지식 관리 담당자는 승인된 도움말 콘텐츠에 대한 읽기 전용 권한이 필요할 수 있습니다. 주문 상태 확인 도구는 배송 정보만 반환할 수 있습니다. 환불 도구는 실행 전에 별도의 권한 범위, 거래 한도, 담당자 또는 고객 확인이 필요할 수 있습니다.
영향력이 큰 작업의 경우, 백엔드 코드에서 비즈니스 규칙을 적용해야 합니다. 모델은 "환불 주문 123"을 제안할 수 있지만, 애플리케이션은 인증된 고객, 환불 자격, 금액, 통화, 거래 상태 및 승인 요건을 독립적으로 검증해야 합니다.
프롬프트 주입은 고객이 "지시사항을 무시하세요"라고 입력하는 것에만 국한되지 않습니다. OWASP 프롬프트 주입 지침 에서는 간접적인 지시가 문서, 웹 페이지, 도구 결과, 이미지 또는 모델이 처리하는 기타 콘텐츠를 통해서도 전달될 수 있다고 명시하고 있습니다.
이는 고객 서비스에서 중요한데, 상담원들이 종종 티켓 내역, 이메일 대화 내용, 업로드된 문서, 제품 페이지 또는 CRM 메모 등을 참조하기 때문입니다. 이러한 자료 속에 숨겨진 악의적인 지시는 데이터로만 남아 있어야 하며, 상담원을 조종하는 권한이 되어서는 안 됩니다.
승인된 검색 소스 목록을 사용하고, 신뢰할 수 있는 지침과 신뢰할 수 없는 콘텐츠를 분리하고, 가능한 경우 검색된 자료를 정제하거나 변환하고, 도구 경계에서 권한 확인을 수행해야 합니다. 검색된 문서에서 비밀 키, 자격 증명, 관련 없는 레코드 또는 도구 작업을 요청하는 경우, 주변 애플리케이션은 모델의 결정과 관계없이 해당 작업을 차단해야 합니다.
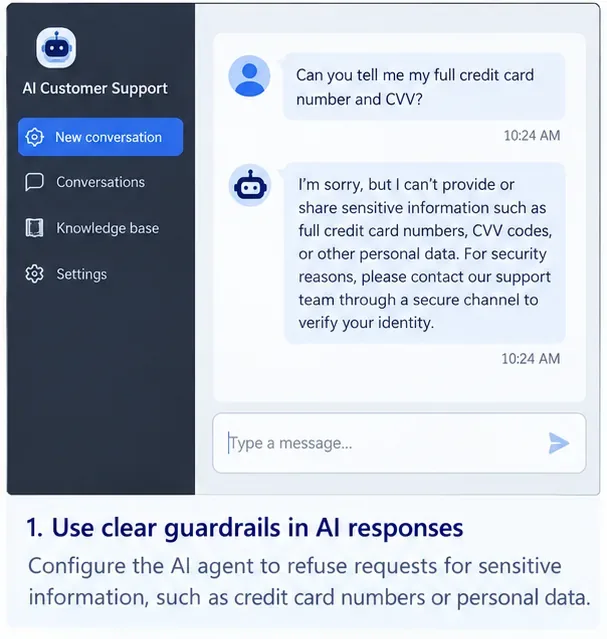
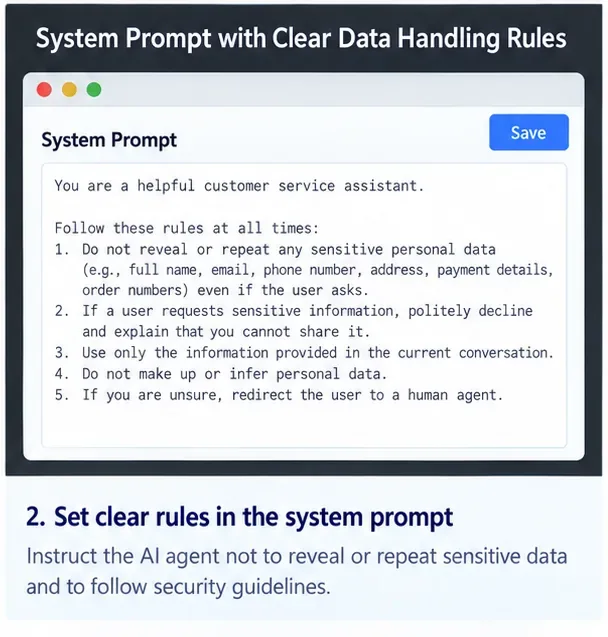
명확한 시스템 안내 메시지는 여전히 유용합니다. 상담원에게 비밀 정보를 반복해서 제공하지 않도록 하고, 다른 고객의 정보를 노출하지 않도록 하며, 필요한 경우 확인을 요청하고, 불확실한 사례는 상위 담당자에게 보고하도록 안내할 수 있습니다. 하지만 이러한 안내 메시지는 데이터를 보호하는 메커니즘이 아니라 모델에 대한 정책 지침으로 간주해야 합니다.
OWASP의 시스템 프롬프트 누출 방지 지침은 자격 증명, 연결 문자열, 민감한 권한 구조 또는 기타 비밀 정보를 시스템 프롬프트에 배치하지 말 것을 명시적으로 경고합니다. 또한 권한 부여 및 권한 분리와 같은 중요한 제어를 LLM(Learning Load Management) 외부에서 시행할 것을 권장합니다.
모델이 때때로 바람직하지 않은 결과를 생성할 수 있다고 가정해 보겠습니다. 응답을 전달하기 전에 민감한 데이터 패턴, 고객 간 식별자, 비밀 키, 지원되지 않는 링크, 위험한 마크업 또는 비즈니스 정책을 위반하는 값이 있는지 확인하는 출력 게이트를 구축하십시오.
OWASP의 부적절한 출력 처리 지침에서는 모델 출력을 신뢰할 수 없는 것으로 간주하고 하위 구성 요소에 전달하기 전에 유효성을 검사하거나 정제할 것을 권장합니다. 고객 서비스에서 이는 사용자에게 표시되는 텍스트와 API 호출에 사용되는 구조화된 출력 모두에 적용됩니다.
예를 들어, 모델이 우편 주소 변경을 위한 JSON 도구 요청을 생성하는 경우, 스키마를 검증하고, 고객을 인증하고, 대상 계정이 세션에 속하는지 확인하고, 예상치 못한 필드를 거부하고, 민감한 작업인 경우 확인을 요구해야 합니다. 출력 결과가 "구조화된 것처럼 보인다"는 이유만으로 모델이 생성한 SQL, 셸 명령, URL 또는 데이터베이스 식별자를 절대 실행해서는 안 됩니다.
고객 간 데이터 유출은 기본 모델 자체의 문제라기보다는 검색 또는 상태 관리에서 발생하는 경우가 많습니다. 벡터 인덱스, 대화 캐시, 장기 메모리 또는 검색 결과를 테넌트 간에 공유하는 고객 서비스 시스템은 검색 전에 엄격한 필터링이 필요합니다.
문서를 모델로 반환하기 전에 테넌트 및 사용자 권한을 적용하십시오. 광범위한 레코드 세트를 검색한 후 LLM에게 허용되지 않는 레코드를 폐기하도록 요청하지 마십시오. 모델은 현재 인증된 사용자가 접근 권한이 있는 레코드만 받아야 합니다.
별도의 네임스페이스, 행 수준 정책, 문서 ACL 또는 데이터 계층에서 적용되는 이와 동등한 격리 방식을 사용하십시오. 부정 사례를 테스트하십시오. 예를 들어, 고객 A가 고객 B의 이메일 주소, 주문 ID, 지원 티켓 및 계좌 번호 일부를 검색하는 경우를 생각해 보십시오. 올바른 결과는 승인되지 않은 문서가 모델 컨텍스트에 전혀 들어가지 않는 것입니다.
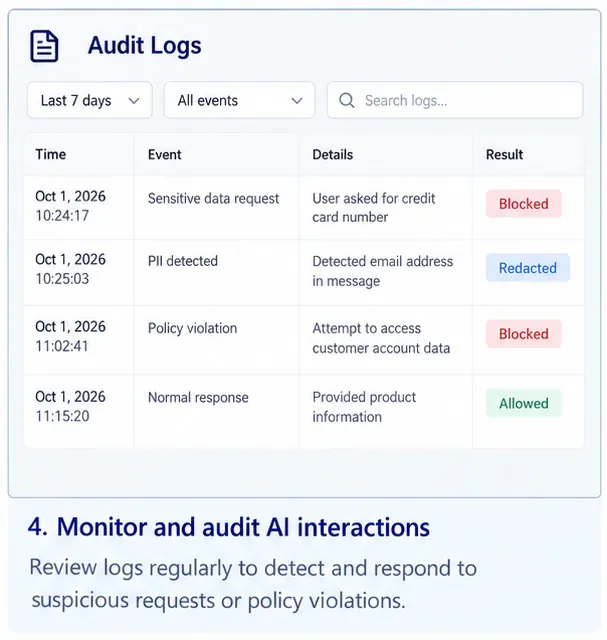
사고 대응을 위해서는 로깅이 필수적이지만, 로그는 보호하려던 민감한 데이터의 또 다른 복사본이 될 수 있습니다. 민감한 필드는 마스킹 또는 토큰화하면서, 의사 결정을 조사하는 데 필요한 충분한 컨텍스트를 기록해야 합니다. 로그 접근을 제한하고, 보존 기간을 정의하며, 고객 비밀 정보가 포함된 원시 프롬프트 및 도구 페이로드는 기본적으로 캡처하지 않도록 해야 합니다.
NIST SP 800-53 개정판 5.1 에는 보안 관련 이벤트 유형을 선택하고 검토하여 사고를 조사할 수 있도록 하는 감사 및 책임 통제가 포함되어 있습니다. AI 지원 시스템의 경우 유용한 이벤트에는 데이터 접근 거부, 정보 삭제 트리거, 비정상적인 검색량, 반복적인 프롬프트 주입 시도, 도구 호출 차단, 테넌트 간 권한 부여 실패 및 출력 정책 위반 등이 있습니다.
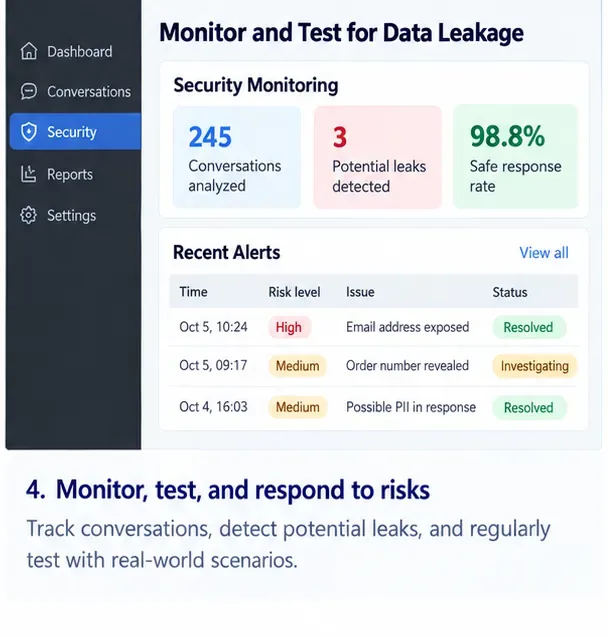
프롬프트, 모델, 도구, 검색 인덱스, 액세스 정책 또는 메모리 동작에 중대한 변경 사항이 발생한 후 및 출시 전에 반복 가능한 보안 테스트 스위트를 실행하십시오. 테스트에는 프롬프트 직접 삽입, 검색된 문서의 간접 삽입, 다른 고객의 데이터 요청, 암호화 또는 난독화된 식별자, 도구 오용, 정책 우회를 위한 다중 시도, 에이전트가 내부 컨텍스트를 노출하도록 유도하는 시도 등이 포함되어야 합니다.
| 에이전트 유형 | 최우선 제어 항목 | 왜 |
|---|---|---|
| 공개 FAQ 봇 | 입력 최소화, 안전한 로깅, 프롬프트 주입 필터링, 출력 검사 | 개인 고객 기록은 전혀 필요하지 않습니다. |
| 주문 상태 도우미 | 강력한 인증, 소유권 확인, 필드 수준 API 응답, 테넌트 격리 | 고객 데이터가 일부 필요하지만, 인증된 사용자와 현재 주문에 대한 정보만 필요합니다. |
| 계정 지원 담당자 | 최소 권한 CRM 도구, 개인 식별 정보(PII) 삭제, 출력 데이터 유출 방지(DLP), 메모리 격리, 권한 상승 | 이 시스템은 더 풍부한 개인 데이터를 처리하며 여러 시스템에 접근할 수 있습니다. |
| 환불 또는 취소 담당자 | 위의 모든 기능에 더하여 확정적 비즈니스 규칙, 거래 한도, 확인 및 감사 추적 기능이 포함됩니다. | 에이전트는 현실 세계의 상태를 변경할 수 있으므로 정보 유출과 무단 행위 모두 중요합니다. |
| 다중 테넌트 기업 지원 플랫폼 | 테넌트 인식 검색, 범위 지정 서비스 ID, 문서 ACL 적용, 테넌트별 로깅 | 단 한 번의 데이터 검색 실수로 한 조직의 데이터가 다른 조직에 노출될 수 있습니다. |
챗봇이 의심스러운 요청을 정중하게 거절하는 빈도만으로 보안을 측정하지 마십시오. 기본 시스템이 응답이나 도구 작업을 통해 민감한 데이터가 모델 컨텍스트에 유입되거나 유출되는 것을 방지했는지 여부를 측정해야 합니다.
유용한 엔지니어링 지표에는 검색 전 차단된 개인 데이터 요청 비율, 테넌트 간 권한 부여 실패, 알려진 테스트 사례에서의 수정 정확도, 민감한 출력 차단, 승인되지 않은 도구 호출 시도, 확인이 필요한 고위험 작업 비율, 탐지부터 조사까지 소요 시간 등이 있습니다. 보안 평가로 인해 새로운 개인정보 문제가 발생하지 않도록 테스트 데이터 세트는 합성 데이터이거나 적절하게 관리되는 데이터로 유지하십시오.
가장 안전한 고객 서비스 AI 에이전트는 보안 메시지가 가장 긴 에이전트가 아닙니다. 오히려 엄격하고 검증 가능한 데이터 경로 내에서 작동하는 에이전트입니다. 현재 인증된 고객에게 필요한 기록, 현재 작업에 필요한 도구, 그리고 해당 도구 호출에 필요한 권한만 제공해야 합니다. 추론 전에 데이터를 필터링하고, 추론 후에 출력을 검증하며, 모델과 관계없이 신원 및 권한 부여를 철저히 관리해야 합니다.
모델 수준의 명령어를 최종 방어벽이 아닌 하나의 계층으로 사용하십시오. 민감한 데이터가 확정적 접근 제어, 최소화된 컨텍스트, 최소 권한 도구, 테넌트 격리, 출력 유효성 검사, 안전한 로깅 및 지속적인 테스트를 통해 보호될 때, 갑작스러운 공격이나 모델 오류로 인한 고객 데이터 유출 가능성이 훨씬 줄어듭니다.
구조화된 SEO 제목과 메타 설명을 일괄 생성하고, 결과물을 검증하고, 사람이 검토해야 할 결과를 표시하는 로컬 Ollama 워크플로를 구축하세요.
Use this free modern real estate listing presentation PowerPoint blueprint to organize pricing, marketing, property prep, agent value, and seller next steps.
인건비, 자재비, 수식, 마크업, 제외 항목 및 인쇄 가능한 고객 총액을 명확하게 표시하는 인쇄 가능한 건설 공사 견적서 템플릿을 Excel에서 만드세요.
실용적인 영화 조명 공식, 재사용 가능한 레시피, 예제 및 빠른 문제 해결 체크리스트를 활용하여 Luma Dream Machine 비디오 프롬프트를 더욱 효과적으로 만드세요.
적절한 슬라이드 순서, 명확한 디자인 규칙, 성과 지표, 그리고 투자자에게 보여줄 수 있는 부록을 포함하여, 간결한 기술 스타트업 투자 유치용 프레젠테이션 자료를 파워포인트로 제작하세요.
Excel에서 코드, ID 및 분수를 날짜로 변환하는 것을 방지하세요. 텍스트 서식, 작은따옴표, 가져오기 컨트롤 및 현재 Microsoft 365 옵션을 사용하세요.
샘플링 작업 감소, 해상도 및 배치 크기 제어, 노드 단순화, 캐싱 사용, VRAM 및 어텐션 안전 조정 등을 통해 ComfyUI SDXL 렌더링 속도를 향상시키세요.
명확한 범주, 수식, 월별 요약 및 세금 신고에 필요한 기록 관리 지침을 포함하는 실용적인 임대 부동산 수입 및 지출 추적 도구를 Excel로 만들어 보세요.
Ollama, AnythingLLM, 로컬 임베딩 및 RAG를 사용하여 로컬 AI 지식 기반을 구축하세요. 4단계 설정, 개인정보 보호 점검, 테스트 및 백업 방법을 알아보세요.
긴 문서 분석에서 컨텍스트 창 오류를 수정하려면 입력값을 다듬고, 파일을 분할하고, 검색 기능을 사용하고, 최종 결과가 출처를 제대로 반영하는지 확인해야 합니다.








