Local Ollama를 사용하여 SEO 메타 제목 및 설명을 자동 생성하는 방법

구조화된 SEO 제목과 메타 설명을 일괄 생성하고, 결과물을 검증하고, 사람이 검토해야 할 결과를 표시하는 로컬 Ollama 워크플로를 구축하세요.
제품 페이지, 문서 페이지, 블로그 페이지 등 게시할 페이지가 300개나 있는데 메타데이터 열이 비어 있습니다. 모든 제목과 메타 설명을 수동으로 작성하는 것은 시간이 많이 걸리고, 사이트 전체에 하나의 패턴을 복사해서 붙여넣으면 결과가 반복적이며, 현지 언어 모델에 "SEO 제목"을 요청하면 불필요한 설명, 지어낸 주장, 또는 일관성 없는 형식이 반환되는 경우가 많습니다.
메타데이터 생성을 소규모 데이터 파이프라인처럼 처리하는 것이 더 나은 접근 방식입니다. 모델에는 페이지별 정보만 제공하고, 구조화된 출력을 요구하며, 코드에서 유효성을 검사한 후 게시하기 전에 예외 사항을 검토합니다. Ollama는 http://localhost:11434/api설치 후 로컬 API를 바로 사용할 수 있고 JSON 스키마 구조화 출력을 지원하기 때문에 이러한 워크플로에 적합합니다. 여기에 참조된 Ollama 및 Google 검색 문서는 2026년 9월 13일에 확인되었습니다.
대부분의 실패는 단일 "잘못된 프롬프트"보다는 모델 주변의 워크플로에서 발생합니다. 일반적인 원인으로는 페이지 콘텐츠를 너무 적게 입력하는 것, 모델이 자유 형식의 산문으로 답변하도록 허용하는 것, 모든 URL에 동일한 키워드 공식을 적용하는 것, 사이트 수준의 중복 검사 없이 결과를 게시하는 것 등이 있습니다.
문자 제한에 대한 오해도 여전히 존재합니다. 구글은 페이지 요소나 메타 설명에 고정된 길이 제한이 없다고 밝히고 있습니다. 제목 링크와 스니펫은 필요에 따라, 일반적으로 기기 화면 너비에 맞춰 잘립니다. 또한 구글 시스템에서 다른 표현 방식이 더 유용하다고 판단할 경우 페이지 콘텐츠에서 다른 제목 링크나 스니펫을 생성할 수도 있습니다. 제목 링크 , 스니펫 및 메타 설명<title> 에 대한 구글의 공식 지침을 참조하세요 .
즉, 스크립트는 일관성을 위해 편집상의 길이 제한을 적용할 수 있지만, 해당 숫자를 Google의 요구 사항으로 명시해서는 안 됩니다. 아래 예시에서 제목 65자, 설명 165자는 내부적인 가이드라인일 뿐입니다. CMS, 브랜드, 현지화 요구 사항 및 검토 프로세스에 맞게 변경하십시오.
Ollama의 공식 빠른 시작 가이드에는 macOS, Windows 및 Linux 지원이 명시되어 있습니다. 설치 후 로컬 모델을 다운로드하세요. Ollama의 최신 문서 gemma3에서는 API 예제에서 이 모델을 자주 사용하므로, 이 튜토리얼에서는 이 모델을 사용하는 것이 편리합니다.
ollama pull gemma3다음으로 로컬 엔드포인트를 테스트합니다.
curl http://localhost:11434/api/generate -d '{"model":"gemma3","prompt":"Reply with the word ready.","stream":false}'Ollama API 문서에 따르면 로컬 API는 주소에서 제공됩니다 http://localhost:11434/api. 또한 이 주소에 대한 로컬 액세스에는 인증이 필요하지 않다고 명시되어 있습니다. 로컬 서비스가 실행 중이 아닌 경우, 서비스를 시작하는 데 사용되는 CLI 명령어는 다음과 같습니다. 진정한 로컬 추론이 목표라면 모델을 ollama serve다른 값으로 대체하지 마십시오 .-cloud
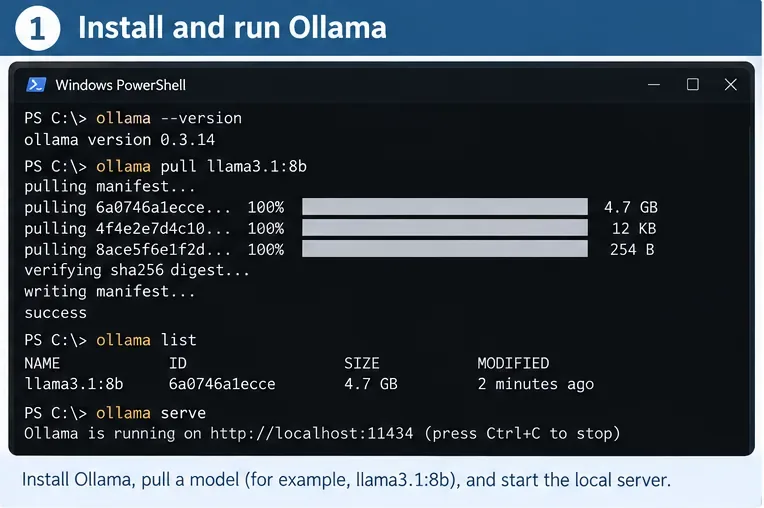
이 글은 SEO 메타데이터에 있어 어떤 모델이 보편적으로 가장 좋다고 주장하지 않습니다. 모델의 가용성과 하드웨어 호환성은 시간이 지남에 따라 변할 수 있으며, 대형 모델은 더 많은 메모리를 필요로 하고 일반적으로 응답 속도가 느립니다. 먼저 컴퓨터에서 원활하게 실행될 수 있는 모델로 시작하여 소규모 리뷰 세트를 생성한 후, 사실 정확성, 고유성, 지연 시간 및 일관성을 비교한 다음 수천 페이지를 처리하는 것이 좋습니다.
자유 형식 텍스트는 자동화에 취약합니다. "세 가지 좋은 옵션이 있습니다…"와 같은 응답은 프로그램이 실제 제목이 어디서 시작되는지 추측해야 합니다. Ollama의 구조화된 출력 문서에서는 필드 에 JSON 스키마를 전달하는 것을 지원합니다 format. 또한 문서에서는 Python의 Pydantic을 통해 재사용 가능한 스키마를 사용하는 것을 권장하며, 낮은 온도(예: )가 결정성을 향상시킬 수 있다고 언급합니다 0.
이 예제에서 사용된 두 개의 Python 패키지를 설치하세요.
python -m pip install -U ollama pydantic그런 다음 생성하세요 generate_meta.py:
from ollama import Client
from pydantic import BaseModel, Field

MODEL = "gemma3"
client = Client(host="http://localhost:11434")

class SeoMeta(BaseModel):
    title: str = Field(min_length=10, max_length=65)
    description: str = Field(min_length=70, max_length=165)

SYSTEM = """
You create SEO metadata from the page content supplied by the user.

Rules:
- Accurately describe only what is present in the page content.
- Write a concise, descriptive title.
- Write a useful meta description that distinguishes this page from other pages.
- Do not repeat keywords unnaturally.
- Keep the same primary language as the page.
- Do not invent prices, dates, features, guarantees, statistics, or claims.
- The length bounds in the JSON schema are our editorial limits, not Google rules.
- Return only the structured result required by the schema.
"""

def generate_meta(url: str, source_title: str, h1: str, body_text: str) -> SeoMeta:
    prompt = f"""
URL: {url}
Current title: {source_title}
H1: {h1}

Page text:
{body_text[:12000]}

Create one meta title and one meta description for this page.
"""
    response = client.chat(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        format=SeoMeta.model_json_schema(),
        options={"temperature": 0},
    )
    return SeoMeta.model_validate_json(response.message.content)

if __name__ == "__main__":
    result = generate_meta(
        url="https://example.com/guides/clean-cast-iron",
        source_title="Cast Iron Guide",
        h1="How to Clean a Cast-Iron Skillet Without Damaging the Seasoning",
        body_text=(
            "This guide explains how to remove stuck food, wash a cast-iron "
            "skillet, dry it thoroughly, and apply a thin layer of oil..."
        ),
    )
    print(result.model_dump_json(indent=2))
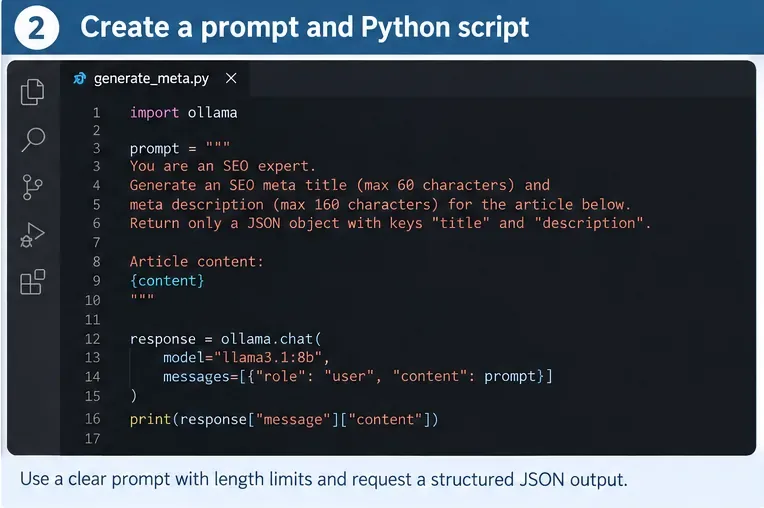
구글은 자사의 제목-링크 시스템이 페이지의 주요 시각적 제목, <head>, <head>와 같은 제목 태그, 주요 텍스트, 앵커 텍스트 및 기타 신호를 고려할 수 있다고 밝혔습니다 . <title>로컬 생성기가 구글의 시스템을 그대로 재현할 필요는 없지만, 원본 제목, H1 태그, URL 및 대표적인 본문 텍스트를 제공하면 제안된 메타데이터가 사용자가 실제로 보게 될 페이지 내용과 일치하는 데 도움이 됩니다.<h1>og:title
관련 없는 키워드 목록을 입력하고 모델에게 "그냥 끼워 넣으세요"라고 요청하지 마세요. Google은 설명적이고 간결한 제목을 명시적으로 권장하며 키워드 남용과 반복적인 정형 문구를 경고합니다. 설명의 경우, Google은 설명이 정확하고 사람이 읽기 쉽고 다양하다면 대규모 데이터베이스 기반 사이트에 페이지별 프로그래밍 방식 생성이 적합하다고 말합니다.
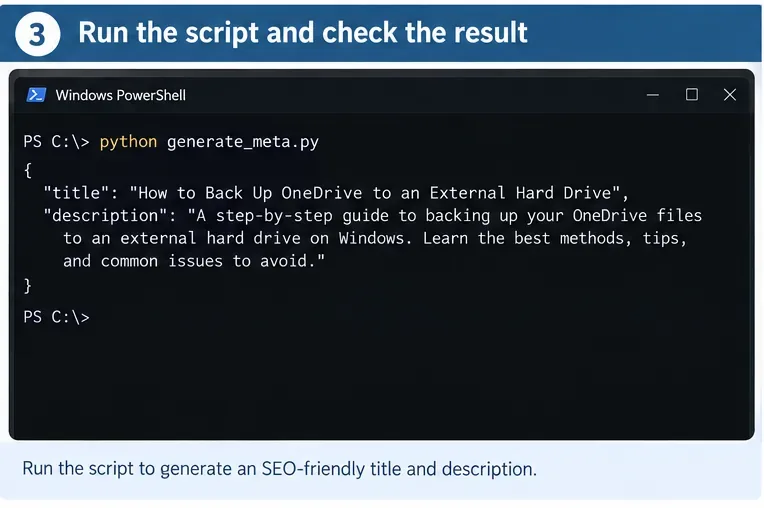
스크립트를 실행하세요:
python generate_meta.py성공적인 결과는 Pydantic이 유효성 검사를 수행할 수 있는 JSON 객체여야 합니다. 더 중요한 것은, 사람이 직접 검토하여 해당 객체를 원본 페이지와 비교하고 다음 네 가지 질문에 신속하게 답변할 수 있어야 한다는 것입니다.
스키마는 데이터 유형과 길이를 제한할 수 있지만, 문장의 진실성이나 충분한 구체성을 보장할 수는 없습니다. 측정 가능한 검사를 기반으로 재시도 로직을 구축하세요. 예를 들어, 빈 필드, 중복된 제목, 금지된 정형 문구, 또는 제목을 거의 그대로 반복하는 설명은 거부하도록 설정할 수 있습니다. 페이지에 규제 대상이거나 중요도가 높은 내용이 포함된 경우, 자동화를 통해 신뢰도를 높이려 하기보다는 사람의 검토를 요구해야 합니다.
재시도 메시지는 간결하게 유지하세요. "더 좋게 만들어 보세요"와 같이 모든 것을 다시 생성하는 대신, 모델에 무엇이 실패했는지 알려주세요. 예를 들어, "제안된 제목이 다른 페이지와 중복됩니다. 제공된 콘텐츠를 기반으로 모든 주장을 유지하면서 H1 태그의 고유한 주제를 사용하여 제목을 다시 작성하세요."와 같이 말이죠. 이렇게 하면 실패 원인을 더 쉽게 분석할 수 있습니다.
한 페이지 테스트가 안정적으로 진행되면 입력값을 CSV 파일에 저장하세요 . CSV 파일에는 url, source_title, h1, 와 같은 열을 content포함해야 합니다. 콘텐츠 필드에는 탐색 메뉴, 쿠키 알림 또는 수천 개의 관련 없는 바닥글 링크가 아닌, 정리된 페이지 텍스트가 포함되어야 합니다.
이 배치 로직을 생성기 함수 아래에 추가하거나 별도의 스크립트에 배치하세요.
import csv

rows = []
seen_titles = set()

with open("pages.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        meta = generate_meta(
            url=row["url"],
            source_title=row.get("source_title", ""),
            h1=row.get("h1", ""),
            body_text=row["content"],
        )

        flags = []
        normalized = meta.title.casefold().strip()
        if normalized in seen_titles:
            flags.append("duplicate_title")
        seen_titles.add(normalized)

        rows.append({
            **row,
            "generated_title": meta.title,
            "generated_description": meta.description,
            "title_length": len(meta.title),
            "description_length": len(meta.description),
            "qa_flags": ",".join(flags),
        })

with open("seo_meta_output.csv", "w", newline="", encoding="utf-8") as f:
    fieldnames = list(rows[0].keys())
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(rows)
생성된 CSV 파일은 Excel, LibreOffice, 데이터베이스 가져오기 도구 또는 CMS 워크플로에서 검토할 수 있습니다. 첫 실행 시 기존 메타데이터를 자동으로 덮어쓰지 마십시오. 검토자가 원본 제목과 설명을 비교하고 롤백이 용이하도록 생성된 제안서와 함께 원본 제목 및 설명을 보관하십시오.
| 확인하다 | 무엇을 신고해야 할까요? | 왜 중요한가 |
|---|---|---|
| 스키마 유효성 검사 | 누락되었거나 유효하지 않은 필드 | 잘못된 형식의 출력이 CMS에 입력되는 것을 방지합니다. |
| 중복 소유권 확인 | 두 URL에 동일한 정규화된 제목이 있습니다. | 페이지를 구분하는 데 도움이 됩니다. |
| 언어 검사 | 메타데이터 언어는 페이지 언어와 다릅니다. | Google은 페이지의 기본 언어 및 문자 체계를 일치시키는 것을 권장합니다. |
| 증거 확인 | 출처에 숫자, 가격, 날짜, 브랜드 또는 보증 정보가 없습니다. | 환각 관련 주장을 줄여줍니다. |
| 기본 점검 사항 | 사이트 전체에 걸쳐 오랫동안 반복되는 문구 | 구글은 정형화된 제목을 반복해서 사용하지 말 것을 권장합니다. |
| 편집 길이 검토 | 선택하신 주택 범위 외부 | CMS 출력의 일관성을 유지합니다. 이는 Google의 문자 제한 규칙과는 관련이 없습니다. |
| 인간 평가 | 전략적 페이지, 민감한 페이지, 트래픽이 많은 페이지 또는 모호한 페이지 | 자동화는 예외를 숨기는 것이 아니라 드러내야 합니다. |
먼저 Ollama가 실행 중이고 http://localhost:11434접속 가능한지 확인하십시오. 공식 인증 문서에 따르면 로컬 API에는 인증이 필요하지 않습니다. 스크립트가 실수로 https://ollama.com/api다른 호스팅 엔드포인트를 가리키는 경우, 해당 엔드포인트는 인증이 필요합니다.
format=SeoMeta.model_json_schema()자연어로 JSON 형식만 요청하는 대신 스키마를 활용하세요 . 구조화된 출력은 프로덕션 파이프라인에 적합한 제어 계층입니다.
페이지별 H1 텍스트와 의미 있는 본문 콘텐츠를 입력하고, 전역 탐색 관련 불필요한 요소를 제거하며, 페이지별 설명을 명시적으로 요청합니다. 그런 다음 페이지 간 중복 및 유사성 검사를 실행합니다. 반복은 모델 문제라기보다는 입력 문제인 경우가 많습니다.
입력값을 권위 있는 페이지 텍스트로 줄이고, 제공된 콘텐츠 범위를 넘어서는 사실적 주장을 하지 않는다는 기본 규칙을 강화하세요. 중요한 페이지의 경우, 생성된 주장을 승인하기 전에 구조화된 소스 필드와 비교하세요. 소스 자체가 모호한 경우, 모델이 반복적으로 추측하도록 하는 대신 해당 행을 사람이 검토하도록 보내세요.
아키텍처를 변경하기 전에 측정하십시오. 페이지별 생성 시간, 입력 크기, 모델 이름 및 실패율을 기록하십시오. 관련 없는 본문 텍스트는 잘라내고, 안정적인 페이지 섹션은 처리하고, 품질이 허용 가능한 수준으로 유지되면 더 작은 로컬 모델을 테스트하십시오. 메타데이터로 인해 검토 작업이 더 많이 발생한다면 아무리 빠른 모델이라도 유용하지 않습니다.
이미 OpenAI 호환 클라이언트용 코드를 작성했다면, Ollama는 OpenAI API와의 부분적인 호환성을 문서화하고 있습니다 (링크 참조) http://localhost:11434/v1/. 이를 통해 마이그레이션 작업을 줄일 수 있습니다. 로컬 전용 메타데이터 도구를 새로 개발하는 경우, Ollama의 네이티브 Python 클라이언트가 더 간단하며, Ollama 문서에서 구조화된 출력 예제를 직접 확인할 수 있습니다.
자동화를 완료하기 전에, 다양한 콘텐츠 유형(짧은 기사, 긴 가이드, 제품 페이지, 카테고리 페이지, 숫자 페이지, 지원되는 모든 언어로 작성된 페이지 등)이 포함된 검토 세트를 만드세요. 동일한 모델과 프롬프트를 모든 콘텐츠에 적용한 다음, 다음 체크리스트를 확인하세요.
localhost로컬 모델이며, 선택된 모델은 클라우드 태그가 지정된 모델이 아닙니다.마지막으로, 자동화가 제어할 수 있는 것과 없는 것을 기억해야 합니다. 잘 작성된 <title>메타 설명은 검색 엔진에 유용한 페이지 수준 신호를 제공하지만, Google은 다른 페이지 콘텐츠에서 제목 링크와 스니펫을 생성할 수 있습니다. 따라서 목표는 특정 검색 결과 표시 방식을 강요하는 것이 아닙니다. 목표는 정확하고, 명확하며, 유용한 메타데이터를 대규모로 생성하는 동시에, 오류를 프로덕션 단계에 도달하기 전에 잡아낼 수 있도록 충분한 검증 및 검토 과정을 유지하는 것입니다.
구조화된 SEO 제목과 메타 설명을 일괄 생성하고, 결과물을 검증하고, 사람이 검토해야 할 결과를 표시하는 로컬 Ollama 워크플로를 구축하세요.
Use this free modern real estate listing presentation PowerPoint blueprint to organize pricing, marketing, property prep, agent value, and seller next steps.
인건비, 자재비, 수식, 마크업, 제외 항목 및 인쇄 가능한 고객 총액을 명확하게 표시하는 인쇄 가능한 건설 공사 견적서 템플릿을 Excel에서 만드세요.
실용적인 영화 조명 공식, 재사용 가능한 레시피, 예제 및 빠른 문제 해결 체크리스트를 활용하여 Luma Dream Machine 비디오 프롬프트를 더욱 효과적으로 만드세요.
적절한 슬라이드 순서, 명확한 디자인 규칙, 성과 지표, 그리고 투자자에게 보여줄 수 있는 부록을 포함하여, 간결한 기술 스타트업 투자 유치용 프레젠테이션 자료를 파워포인트로 제작하세요.
Excel에서 코드, ID 및 분수를 날짜로 변환하는 것을 방지하세요. 텍스트 서식, 작은따옴표, 가져오기 컨트롤 및 현재 Microsoft 365 옵션을 사용하세요.
샘플링 작업 감소, 해상도 및 배치 크기 제어, 노드 단순화, 캐싱 사용, VRAM 및 어텐션 안전 조정 등을 통해 ComfyUI SDXL 렌더링 속도를 향상시키세요.
명확한 범주, 수식, 월별 요약 및 세금 신고에 필요한 기록 관리 지침을 포함하는 실용적인 임대 부동산 수입 및 지출 추적 도구를 Excel로 만들어 보세요.
Ollama, AnythingLLM, 로컬 임베딩 및 RAG를 사용하여 로컬 AI 지식 기반을 구축하세요. 4단계 설정, 개인정보 보호 점검, 테스트 및 백업 방법을 알아보세요.
긴 문서 분석에서 컨텍스트 창 오류를 수정하려면 입력값을 다듬고, 파일을 분할하고, 검색 기능을 사용하고, 최종 결과가 출처를 제대로 반영하는지 확인해야 합니다.








