Birçok iş yükünde LLM API faturasını %50 oranında azaltmak mümkündür, ancak bu evrensel bir garanti değildir. Sonuç, harcamanızın nereden kaynaklandığına bağlıdır: önbelleğe alınmamış girdi tokenları, önbelleğe alınmış girdi tokenları, çıktı tokenları, akıl yürütme tokenları, araç çağrıları veya yeniden denemeler. İstem sıkıştırma, uzun veya tekrarlayan girdilerin faturanın anlamlı bir kısmını oluşturduğu durumlarda en iyi sonucu verir. Bu nedenle pratik hedef, "her istemi yarı uzunluğa indirmek" değildir. Hedef, "yanıtı değiştirmeyen tokenları kaldırmak, değiştiren tokenları korumak ve tasarrufu gerçek trafik üzerinde doğrulamaktır."
Bu rehber dört uygulama adımı kullanır: temel ölçümü almak, gereksiz girdileri kaldırmak, önbellek yeniden kullanımı için istemleri düzenlemek ve API desteklediğinde ayrıntılı çıktı talimatlarını yapılandırılmış kontrollerle değiştirmek. Örnekler, kıyaslama iddialarından ziyade açıklayıcı niteliktedir. Sağlayıcı fiyatlandırması ve önbellek davranışı zaman içinde değiştiğinden, üretim tahmini yapmadan önce güncel oranları doğrulayın.
%50 API maliyet azaltımı gerçekte ne gerektirir?
Modeliniz için faturalandırma denklemiyle başlayın. Basit bir metin iş yükü için, toplam istek maliyeti yaklaşık olarak önbelleğe alınmamış girdi, önbelleğe alınmış girdi ve çıktı maliyetlerinin toplamıdır. Bazı modeller veya özellikler başka faturalandırılabilir kategoriler ekler. OpenAI'nin güncel API yanıtları, önbelleğe alınmış token detayları dahil olmak üzere girdi ve çıktı token kullanımını gösterir ve model sayfaları girdi, önbelleğe alınmış girdi ve çıktı için ayrı oranları yayınlar.
| Açıklayıcı iş yükü | Girdi tokenları | Çıktı tokenları | Göreceli sonuç |
|---|
| Temel istek | 10.000 | 1.000 | Temel maliyetin %100'ü |
| Sadece girdi yarıya indirildi | 5.000 | 1.000 | Çıktı değişmediğinde toplam tasarruf %50'den az |
| Girdi ve çıktı yarıya indirildi | 5.000 | 500 | Oranlar değişmediğinde token tabanlı maliyet yaklaşık %50 daha düşük |
Somut bir güncel örnek olarak, resmi GPT-5.6 Sol model sayfası 11 Eylül 2026 tarihinde, milyon girdi tokenı başına 4 $, milyon önbelleğe alınmış girdi tokenı başına 0,40 $ ve milyon çıktı tokenı başına 20 $ fiyat listelemiştir. Bu oranlarda, 10.000 girdi/1.000 çıktı isteği diğer ücretler hariç yaklaşık 0,06 $'a mal olur. Girdiyi sadece 5.000 tokena indirmek bu örneği yaklaşık 0,04 $'a, yani %33'lük bir azalmaya getirir. Hem girdiyi hem de çıktıyı yarıya indirmek ise yaklaşık 0,03 $'a, yani %50'lik bir azalmaya getirir. Bu fiyatlar değişebilir, bu nedenle aritmetiği kalıcı bir teklif olarak değil, bir yöntem olarak ele alın. Güncel fiyatlandırma için resmi GPT-5.6 Sol model sayfasına bakın.
Hızlı referans: En yüksek değerli dört hamle
| Teknik | En uygun olduğu durum | Temel risk | Ölçülmesi gerekenler |
|---|
| Token denetimi | Herhangi bir üretim iş yükü | Yanlış bileşeni optimize etmek | Girdi, önbelleğe alınmış girdi, çıktı, yeniden denemeler, başarılı görev başına maliyet |
| Gereksizlik giderme | Uzun sistem istemleri, tekrarlanan politikalar, ayrıntılı örnekler | Gerçekten önemli olan bir kısıtlamayı silmek | Görev başarısı ve talimat uyumu paritesi |
| Önbellek dostu düzen | Stabil talimatları veya bağlamı paylaşan tekrarlayan istekler | Dinamik metnin çok erken görünmesi nedeniyle düşük önbellek yeniden kullanımı | Önbelleğe alınmış token oranı ve gecikme |
| Yapılandırılmış çıktı kontrolleri | JSON çıkarımı, sınıflandırma, sabit yanıt formatları | Şemanın görev için çok katı olması | Çıktı tokenları, ayrıştırma hataları, yeniden denemeler |
Adım 1: İstemleri değiştirmeden önce gerçek token temelini ölçün
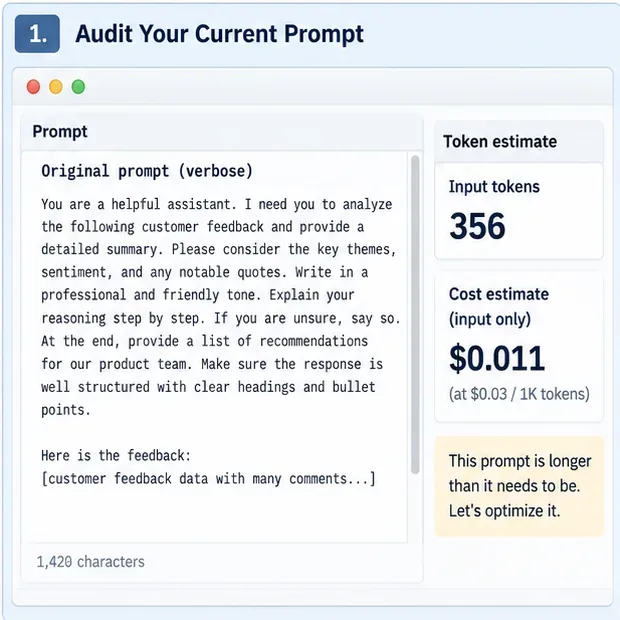
Altyazı: Açıklayıcı bir token denetim arayüzü, sıkıştırma öncesi orijinal istem boyutunu ve örnek bir maliyet tahminini kaydeder; rakamlar güncel sağlayıcı fiyatlandırması değildir.
Tek elle seçilmiş bir istemi optimize etmek yerine, üretim isteklerinin temsili bir örneğini toplayın. En azından girdi tokenlarını, mevcutsa önbelleğe alınmış girdi tokenlarını, çıktı tokenlarını, model adını, gecikmeyi, yeniden denemeleri ve son yanıtın iş kalitesi kontrolünüzü geçip geçmediğini kaydedin. Sağlayıcınız bir girdi token sayma uç noktası sunuyorsa, kesin bütçeleme gerektiğinde istekleri göndermeden önce bunu kullanın. OpenAI şu anda resmi API referansında bir Responses girdi token sayma uç noktasını belgeliyor.
Sadece API çağrısı başına maliyeti değil, başarılı görev başına maliyeti hesaplayın. Daha fazla yeniden denemeye neden olan sıkıştırılmış bir istem, her istek daha kısa olsa bile daha pahalı olabilir. Temeli görev türüne göre de segmentlere ayırın: özetleme, çıkarım, RAG soru-cevap, ajan araç kullanımı ve uzun sohbetler genellikle farklı token profillerine sahiptir.
Adım 2: Karar açısından kritik bilgileri silmeden gereksizlikleri giderin

Altyazı: Açıklayıcı bir önce-ve-sonra istemi, tekrarlanan ifadeleri ve gereksiz süreç talimatlarını kaldırırken aynı istenen çıktıları korur.
En güvenli ilk sıkıştırma geçişi anlamsal tekilleştirmedir. Tekrarlanan rol açıklamalarını, yinelenen kısıtlamaları, kibar dolgu metinlerini, bariz biçimlendirmelerin açıklamalarını ve aynı kalıbı birden fazla kez öğreten örnekleri silin. Örtüşen kuralları tek bir talimatta birleştirin. Aynı gereksinimi tekrarlayan birkaç cümle yerine tek bir hassas cümleyi tercih edin.
Önce
Ürün analizi konusunda uzman, yardımsever bir asistansınız.
Aşağıdaki müşteri geri bildirimlerini analiz etmenizi ve
ayrıntılı bir özet sunmanızı istiyorum. Lütfen ana temaları, genel duyguyu,
dikkat çekici alıntıları ve ürün ekibimiz için önerileri belirleyin. Yanıtınızın
profesyonel, net, öz ve iyi yapılandırılmış olduğundan emin olun.
Sonra
Müşteri geri bildirimlerini analiz edin.
Şunları döndürün: ana temalar, genel duygu, dikkat çekici alıntılar ve ürün önerileri.
Öz ve olgusal olun.
Uzun oldukları için istisnaları, politika sınırlarını, alan tanımlarını, araç güvenlik kurallarını veya kanıt gereksinimlerini sıkıştırarak yok etmeyin. Bunlar genellikle yüksek değerli tokenlardır. Yararlı bir test şudur: "Bu cümleyi kaldırırsam, kabul edilebilir çıktı değişebilir mi?" Evet ise, bir API kontrolü veya şeması aynı davranışı daha güvenilir bir şekilde uygulayamadığı sürece onu koruyun.
Adım 3: Stabil içeriği önce, dinamik içeriği sona koyun
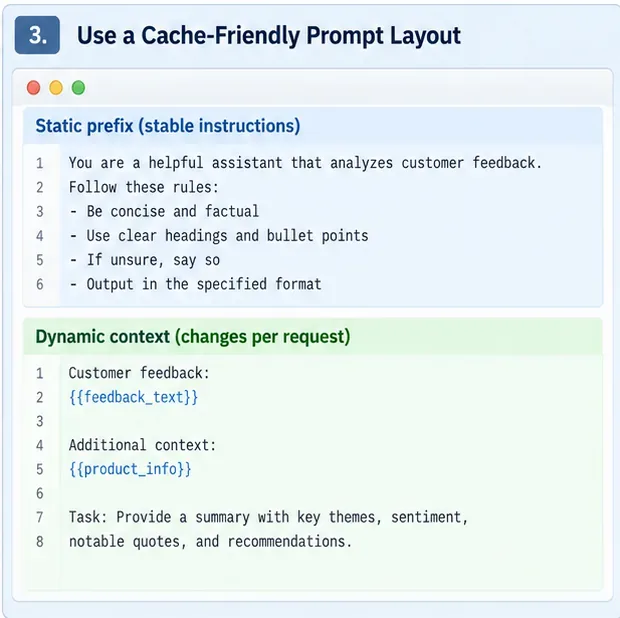
Altyazı: Açıklayıcı bir istem düzeni, stabil talimatları yeniden kullanılabilir bir önekte yerleştirir ve istek spesifik bağlamı sona ekler.
İstem önbelleği ham token sayısını azaltmaz, ancak normal girdi oranında faturalanan miktarı ve istem işleme gecikmesini azaltabilir. Bu, istem düzenini maliyet optimizasyonunun bir parçası haline getirir. Sistem talimatlarını, paylaşılan örnekleri, araç rehberliğini ve diğer stabil içerikleri bir araya getirin. İstek spesifik gerçekleri, alınan pasajları, kullanıcı verilerini ve mevcut soruyu sona koyun.
OpenAI'nin model rehberi, istem önbelleği yeniden kullanımını iyileştirmek için statik içeriği önce, dinamik içeriği sona koymayı açıkça önerir ve yanıt kullanım nesnesi ölçüm için önbelleğe alınmış token bilgilerini sunar. Resmi model rehberine ve Responses API referansına bakın.
Sağlayıcının önbellek semantiği bu değişikliklerin güvenli olduğunu belirtmediği sürece, aksi takdirde yeniden kullanılabilir bir önekteki zararsız boşlukları, örnek sıralamasını, zaman damgalarını, rastgele kimlikleri veya kullanıcı bazlı metinleri değiştirmekten kaçının. Bir istemin yeniden kullanıldığını varsaymak yerine, API yanıtından önbellek isabetlerini ölçün.
Adım 4: Format hakkındaki düzyazıyı yapılandırılmış çıktı kontrolleriyle değiştirin
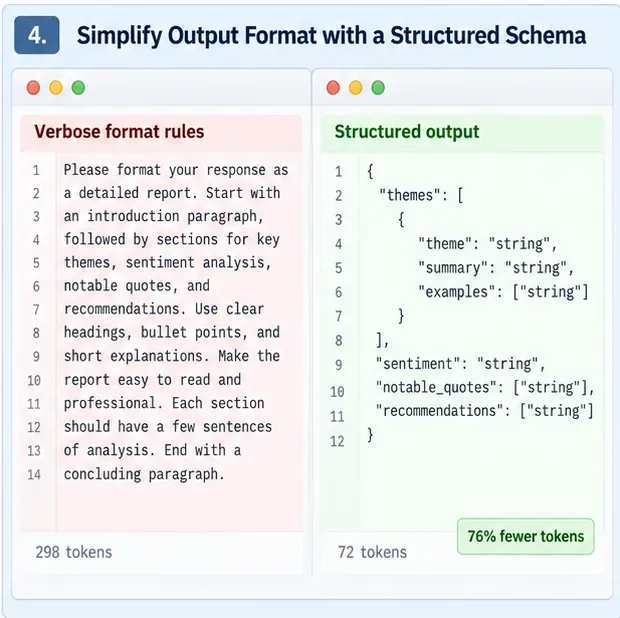
Altyazı: Açıklayıcı bir yapılandırılmış çıktı görünümü, bir şemanın aynı yanıt şeklini tekrar tekrar tanımlayan birçok düzyazı satırını nasıl değiştirebileceğini gösterir.
Çıkarım ve sınıflandırma istemleri, JSON alanlarını, izin verilen değerleri, iç içe geçmeyi, sıralamayı ve doğrulama kurallarını doğal dilde tanımlayarak genellikle token israf eder. API yapılandırılmış çıktıları veya tipli araç argümanlarını desteklediğinde, bu sözleşmenin mümkün olan en büyük kısmını yapılandırılmış arayüze taşıyın ve doğal dil talimatını anlama odaklı tutun.
Güncel OpenAI rehberi, mümkün olduğunda çıktı şeması tanımlarını istemden kaldırmayı ve bunun yerine Yapılandırılmış Çıktıları kullanmayı özellikle önerir. Bu, istem metnini azaltabilir ve ayrıca hatalı çıktı yeniden denemelerini azaltabilir. Kesin mekanik sağlayıcıya göre değiştiğinden, OpenAI'ye özgü bir istek formatını başka bir API'ye, o sağlayıcının belgelerini kontrol etmeden kopyalamayın.
RAG, uzun belgeler ve sohbetler için gelişmiş sıkıştırma
Dört temel adım stabil hale geldikten sonra, daha büyük tasarruflar genellikle cümle ifadelerini cilalamak yerine bağlamı azaltmaktan gelir. RAG sistemlerinde, daha az ancak daha alakalı pasajlar alın, neredeyse aynı parçaları tekilleştirin ve yanıtı etkileyemeyecek belgeleri eklemekten kaçının. Uzun sohbetler için, kalıcı gerçekleri ve çözümlenmemiş kararları tutun, ancak artık mevcut görevi etkilemeyen turları özetleyin veya atın. Ajan sistemleri için, mimariniz güvenli bir şekilde izin verdiğinde, yalnızca mevcut aşamayla ilgili araçları ve araç açıklamalarını ortaya koyun.
Öğrenilen istem sıkıştırıcıları, çok uzun bağlamlar için başka bir seçenektir. Microsoft'un açık kaynak LLMLingua projesi, token düzeyinde istem sıkıştırmasını uygular. Orijinal LLMLingua makalesi, değerlendirilen ayarlarında sınırlı kıyaslama bozulmasıyla 20×'e kadar sıkıştırma oranları bildirdi. LongLLMLingua uzun bağlamlı görevleri hedeflerken, LLMLingua-2 görevden bağımsız öğrenilen bir sıkıştırıcı kullanır. Bunlar araştırma sonuçlarıdır, aynı oranların verilerinizde kaliteyi koruyacağına dair bir vaat değildir. Agresif sıkıştırmayı dağıtmadan önce kendi görevlerinizi, dillerinizi, modellerinizi ve istem türlerinizi kıyaslayın.
Optimizasyonun gerçekten daha iyi olduğunu nasıl kanıtlarsınız?
Aynı temsili istekler üzerinde bir A/B değerlendirmesi çalıştırın. Temel ve sıkıştırılmış sürümler aynı modeli, akıl yürütme ayarlarını, araçları, alma girdilerini ve başarı kriterlerini kullanmalıdır. Bir gerilemeye neyin neden olduğunu belirleyebilmek için mümkün olduğunda tek bir sıkıştırma tekniğini değiştirin.
| Metrik | Neden önemli? | Önerilen yorumlama |
|---|
| Girdi token azaltımı | Ham istem küçülmesini gösterir | Faydalı, ancak tek başına yeterli değil |
| Önbelleğe alınmış token oranı | Stabil öneklerin yeniden kullanılıp kullanılmadığını gösterir | Kalite değişmediğinde daha yüksek genellikle daha iyidir |
| Çıktı token azaltımı | Toplam maliyeti önemli ölçüde değiştirebilir | Öz çıktının görevi tamamlamaya devam ettiğini doğrulayın |
| Başarılı görev başına maliyet | Yeniden denemeleri ve hataları içerir | Bu birincil iş metriğidir |
| Görev başarısı / doğruluk | Bilgi kaybını tespit eder | Test etmeden önce kabul edilebilir bir eşdeğerlik eşiği belirleyin |
| p50 ve p95 gecikmesi | Gerçek kullanıcı etkisini gösterir | Sıkıştırma ön işleme, çıkarım tasarruflarını dengeleyebilir |
Bir istem %50 daha kısa olduğu için zafer ilan etmeyin. Daha güçlü kabul koşulu şudur: Sıkıştırılmış yapılandırma, önceden tanımlanmış kalite, gecikme ve güvenilirlik toleranslarınız içinde kalarak ölçülen maliyeti yaklaşık hedef miktarınız kadar azaltır.
Sıkıştırmayı ne zaman bırakmalısınız?
Sonraki azaltım doğru kararlar için gerekli gerçekleri kaldırdığında, halüsinasyonları artırdığında, araç çağrısı hatalarına neden olduğunda, politika uyumunu zayıflattığında veya tasarrufları silecek kadar yeniden denemeyi artırdığında durun veya geri adım atın. Her istemi sıkıştırmak için ayrı bir model çalıştırıyorsanız, sıkıştırma gecikmeyi de artırabilir. Gerçek dünya çıkarım ayarlarında istem sıkıştırması üzerine 2026 tarihli bir çalışma, ön işleme yükünün, elverişli istem uzunluğu ve donanım rejimlerinin dışında çıkarım kazançlarını iptal edebildiğini buldu; bu da yalnızca token sayısını değil, uçtan uca performansı ölçmek için başka bir nedendir.
Küçük istemler için, manuel temizlik ve önbellek dostu organizasyon, özel bir sıkıştırma modeli eklemekten genellikle daha kolay haklı çıkarılabilir. Büyük RAG yükleri veya çoklu belge iş akışları için, bağlam seçimi ve öğrenilen sıkıştırma, kaldırılabilir token hacmi çok daha büyük olduğundan daha cazip hale gelir.
Hızlı uygulama kontrol listesi
- Girdi, önbelleğe alınmış girdi, çıktı, gecikme, yeniden denemeler ve görev başarısı ile bir üretim temeli yakalayın.
- Önce yinelenen talimatları, düşük değerli düzyazıyı ve gereksiz örnekleri kaldırın.
- Alan tanımlarını, istisnaları, kanıt gereksinimlerini ve güvenlik kısıtlamalarını koruyun.
- Önbellek semantiği yeniden kullanılabilir önekleri ödüllendirdiğinde, stabil istem içeriğini dinamik istek spesifik içeriğin önüne koyun.
- Sabit yanıt formatlarını düzyazıda tekrar tekrar tanımlamak yerine yapılandırılmış çıktıları veya araç şemalarını kullanın.
- RAG için, token düzeyinde sıkıştırmayı denemeden önce alakasız ve yinelenen bağlamı azaltın.
- Çıktı uzunluğunu yalnızca görev doğru bir şekilde tamamlanabiliyorsa sınırlayın.
- Sadece istem token sayısını değil, başarılı görev başına maliyeti karşılaştırın.
- Her anlamlı sıkıştırma değişikliğinden önce ve sonra regresyon testleri çalıştırın.
- Modelleri veya API sürümlerini değiştirdiğinizde sağlayıcı fiyatlandırmasını ve önbellek kurallarını yeniden kontrol edin.
Sonuç
%50'lik bir azaltım, bazı ayrıntılı, bağlam ağırlıklı iş yükleri için makul bir mühendislik hedefidir, ancak varsayılan bir beklenti olarak değil, doğrulanması gereken bir sonuç olarak ele alınmalıdır. En güvenilir yol, önce ölçmek, anlamsal olarak gereksiz metni kaldırmak, güvenli önbellek yeniden kullanımını en üst düzeye çıkarmak, yapılandırılmış kontrollerle çıktı sözleşmelerini kısaltmak ve ardından kalan en büyük bağlam bloklarına alma budaması, özetleme veya test edilmiş bir istem sıkıştırıcı ile saldırmaktır. Kalite kabul bandınız içinde kalırken başarılı görev başına nihai maliyet düşerse, sıkıştırma işe yarıyor demektir. Kalite veya yeniden denemeler kötüleşirse, eksik bilgileri geri yükleyin ve isteğin farklı bir bölümünü optimize edin.
Birincil referanslar








