如何使用 Local Ollama 自動產生 SEO 元標題和描述

建立本地 Ollama 工作流程,批量產生結構化的 SEO 標題和元描述,驗證輸出,並將結果標記出來以供手動審核。
衡量LLM響應品質最可靠的方法是將評估視為一個可重複的測試系統,而不是單一的分數。首先,要明確「良好」對您的應用程式意味著什麼;其次,要建立一個具有代表性的評估資料集;第三,要將確定性檢查與基於模型和人工判斷相結合;第四,要將每個候選變更與基線進行比較;最後,在發布之前,要按類別檢查失敗項。
這一點至關重要,因為LLM(邏輯學習模型)可能會給出看似完美無缺的答案,但實際上可能是錯誤的、缺乏依據的、不完整的、不安全的,或者與您的指令不符。一個有效的評估框架可以將這些模糊的問題轉換為明確的標準,以便在提示變更、模型升級、檢索變更、工具更新或安全性策略修訂後重新運行。
文件說明:以下所述的框架功能已根據 2026 年 9 月 13 日發布的官方文件進行了核實。這些工具發展迅速,因此在將特定於框架的程式碼複製到生產環境之前,請務必驗證目前的 API。
首先要考慮對使用者而言最重要的失敗因素。對於事實型支援機器人來說,正確性和策略性合規性可能最為關鍵。對於檢索增強型生成(RAG)來說,依據性和檢索品質至關重要,因為流暢的回答仍然可能包含一些檢索到的上下文不支持的事實。對於智能體而言,最終答案的品質還不夠;您可能還需要對工具選擇、工具論證、任務完成情況以及不必要的步驟進行評分。
| 品質維度 | 它問的是什麼 | 優秀的評估者類型 |
|---|---|---|
| 正確性 | 答案在事實上或邏輯上是否正確? | 參考文獻比對、程式碼檢查、LLM 評審或人工審核 |
| 按照指示 | 該模型是否滿足所需的限制條件? | 規則加上基於評分標準的評審 |
| 腳踏實地 | 所提供的背景資訊是否支持這些說法? | RAG 特定法官或索賠級別檢查 |
| 關聯 | 回答是否切中要害,沒有偏離主題? | LLM 法官或人工審查 |
| 格式合規性 | 輸出是否為有效的 JSON 格式,是否符合模式要求,或可供機器使用? | 確定性代碼 |
| 安全與政策 | 這個答案是否違反了您的應用程式規則? | 政策審查、LLM 法官和有針對性的人工審查 |
| 效率 | 回應所需的延遲、令牌使用量和成本是多少? | 遙測和追蹤 |
不要過早地將這些因素平均化為一個數值。一個候選模型雖然在風格上獲得了兩分,但即使引入少量嚴重的策略缺陷,也可能是一個更糟糕的版本。務必將關鍵維度作為單獨的關卡進行管理。
您的資料集應包含真實的輸入,並儘可能包含預期行為。某些行可以有精確的參考答案;而其他行可能需要一個評分標準,而不是一個單一的「金句」。新增任務類型、客戶群、語言、難度、檢索條件或安全類別等元數據,以便後續對結果進行篩選。
例如,想像一下客戶支援助理。一個有效的評估集不應只包含簡單的常見問題,還應包括含義模糊的請求、策略例外情況、缺少上下文的情況、對抗性提示、多輪後續跟進,以及正確做法是表示「無法確定答案」的情況。
LangSmith 目前的評估指南建議首先使用人工整理的範例來展示良好行為,然後透過添加生產環境中發現的歷史追蹤和故障案例來擴展資料集。其評估系統支援包含輸入、可選參考輸出和元資料的資料集。請參閱LangSmith 評估概念文件。
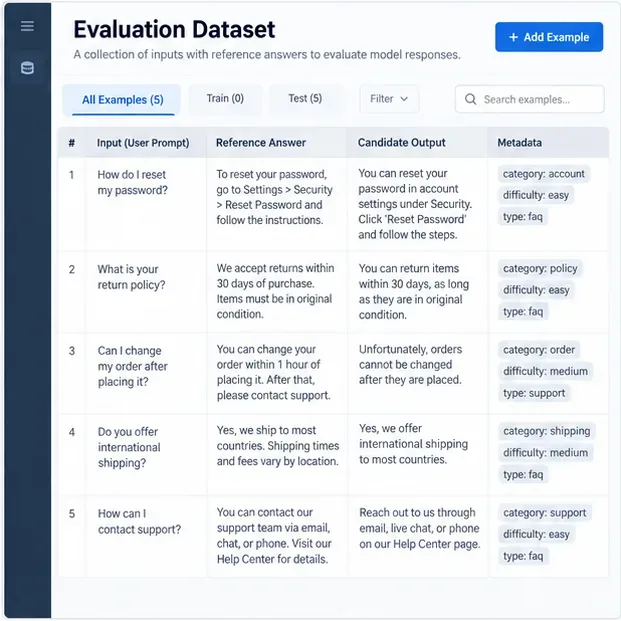
這種方法幾乎總是適用。即使使用即時生產環境進行評估,仍然需要一個穩定的離線資料集用於回歸測試。如果開放式任務沒有參考答案,可以儲存評分標準、必要事實、禁止行為或成對偏好等資訊。
最有效的評估體系會混合使用不同類型的評估員,因為沒有哪個評分員能夠完美應對所有問題。
OpenAI 目前的 Evals API 將評估定義為測試標準加上資料來源模式,並支援可重複使用的評分器。其評分器 API 包括確定性字串檢查、文字相似度評分器和基於模型的評分器;請參閱OpenAI Evals API 參考文件和OpenAI 評分器參考文件。 Google Cloud 的 Vertex AI Gen AI 評估服務支援基於模型的逐點和成對指標以及基於計算的指標;其結果可以包括每個實例的得分、解釋、聚合均值、標準差和成對勝率。請參閱Vertex AI 評估結果文件。
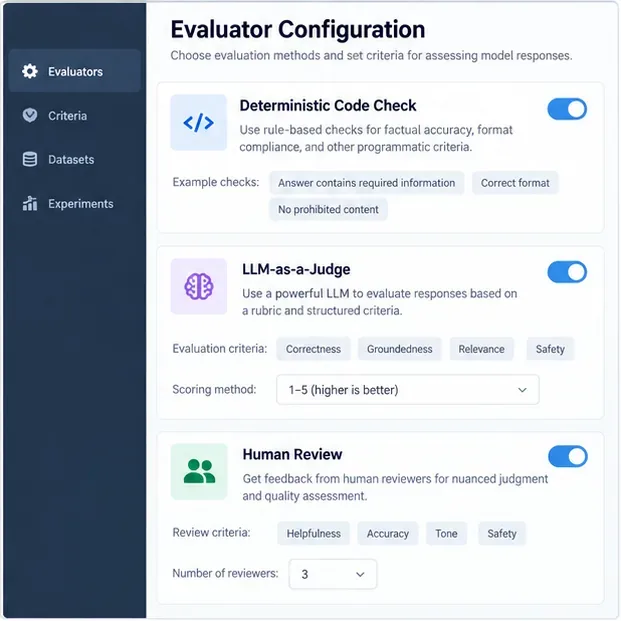
當這種方法適用時:對於機器可驗證的需求,使用確定性檢查;對於語義質量,使用 LLM 評判器;而當分歧會產生重大業務或安全後果時,則由人工進行評判。對於 RAG 系統,Ragas 提供諸如上下文精確度、上下文召回率、回應相關性和忠實度等指標,以及代理/工具使用指標,包括工具呼叫準確率和代理目標準確率。請參閱Ragas 指標文件。 DeepEval 也提供特定任務的指標和自訂 LLM 評判器評估,包括 G-Eval 風格的評分;請參閱DeepEval 指標文件。
絕對分數固然有用,但通常情況下,將新配置與您已信任的版本進行比較測試,能更清楚地做出發布決策。請盡可能保持資料集、評估器定義、模型參數和取樣設定的穩定性。然後,將相同的範例進行並排比較。
至少追蹤三個層級的結果:
對於非確定性系統,應多次重複執行重要測試以了解其變異性,而不是假設一次測試結果就能代表整個模型。如果發布決策至關重要,則應使用相同範例的成對比較,並報告不確定性,而不是僅依賴平均值的微小變化。
LangSmith 支援離線實驗,用於比較不同版本和成對評估器;而 MLflow 目前的 GenAI 評估堆疊支援評估資料集、內建和自訂評分器、LLM 評審、人工回饋、追蹤和生產監控。請參閱LangSmith 評估及MLflow LLM 及智能體評估。
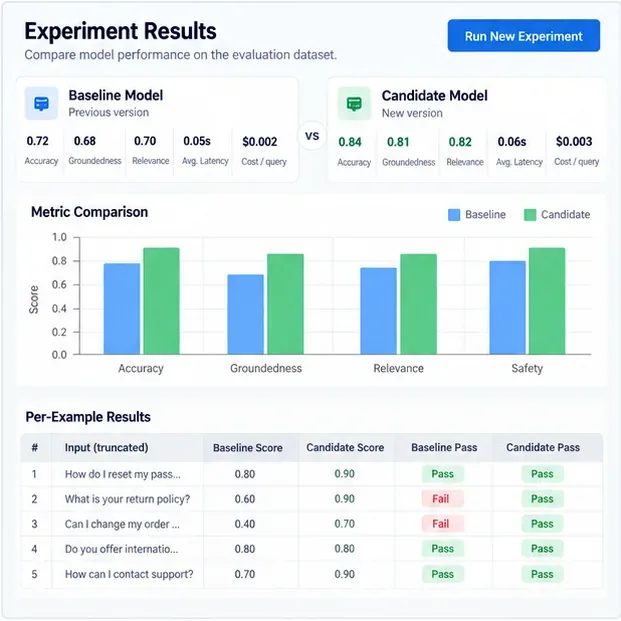
此方法適用於以下情況:當您變更模型、系統提示、檢索管道、工具實作或解碼設定時。不應僅僅因為某個聚合指標上升就將候選版本升級;它必須在關鍵維度上滿足發布閾值,並避免出現不可接受的切片級回歸。
只有當評估結果能夠改變你下一步的操作時,它才是有價值的。按嚴重程度和根本原因對失敗進行排序。低可信度分數可能源自於檢索不充分、提示訊息鼓勵猜測、評分標準過於模糊或參考答案錯誤。在更改模型之前,請先閱讀相關的範例。
然後,將重要的故障升級為永久性回歸案例。這會形成一個良性循環:生產環境發現故障,人工確認後,案例被添加到離線資料集,修復方案針對完整測試套件進行測試,從而阻止未來的版本再次引入相同的問題。
LLM 評判員也需要評估。谷歌的文檔明確描述如何將基於模型的指標輸出與人工評分進行比較,以評估評判員是否足以勝任特定用例。 OpenAI 的 GDPval 工作也類似地使用專家成對評分作為主要標準,並將自動評分描述為專家判斷的近似值而非替代品。請參閱Vertex AI 關於評估評判員模型的指南以及OpenAI 的 GDPval 方法論。
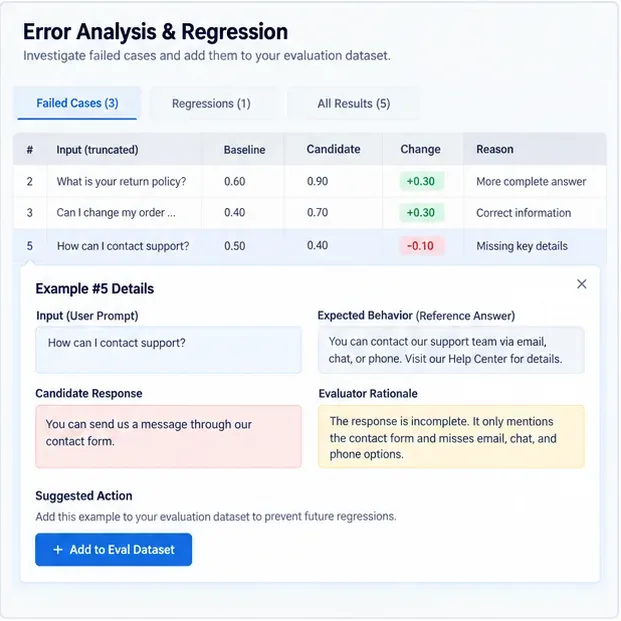
這種方法的適用場景:始終用於影響重大的錯誤,以及LLM評審員影響發布門檻的情況。若人工審閱者一再與評審員意見相左,則應修改評分標準、提供更清楚的參考資料、變更評審員模型,或將該標準交回人工審閱。
LLM 評判系統之所以強大,是因為它們能夠以人工評審無法企及的規模評估開放式輸出。最初的 G-Eval 研究報告稱,在所研究的摘要場景下,LLM 評判系統與人工評判的相關性顯著優於傳統的自動評估指標。然而,同一篇論文也指出,LLM 評判系統可能會偏向 LLM 產生的文本。參見G-Eval 的原始論文。
針對 MT-Bench 和 Chatbot Arena 的獨立研究發現,優秀的 LLM 評判員能夠很好地契合人類的偏好,同時也能記錄其立場、冗長程度、自我提升以及推理相關的偏見。參見最初的LLM 作為評判員的研究。
實際結論並非“永遠不要使用LLM評審”,而是:要對他們進行校準。建立一個人工標註的樣本,衡量一致性,檢查分歧類別,在成對測試中,當位置效應可能存在時,隨機化或交換答案順序,並避免讓同一個模糊的評委提示默默地決定每一次發布決定。
| 框架 | 最佳匹配 | 顯著優勢 |
|---|---|---|
| OpenAI 評估和評分器 | 已在使用 OpenAI API 並希望進行 API 原生評估運行的團隊 | 具有確定性和基於模型的評分器的可重複使用評估定義 |
| 朗史密斯 | 需要追蹤、資料集、離線回歸測試和線上評估的LLM應用程式 | 強大的實驗對比和生產回饋循環 |
| 拉加斯 | RAG 管道和代理/工具使用評估 | 專門設計的檢索、忠實度、相關性和工具指標 |
| 深度評估 | 以 Python 為中心的團隊,需要測試式評估和可自訂的 LLM 評測系統 | 廣泛的指標目錄、組件/端到端評估和代理軌跡指標 |
| MLflow GenAI 評估 | 已經使用 MLflow 或希望將評估與追蹤和生命週期管理關聯起來的團隊 | 數據集、評分員、人工回饋、實驗追蹤和生產監控 |
| Vertex AI Gen AI 評估 | Google Cloud 部署 | 逐點、成對、基於模型和基於計算的評估工作流程 |
框架的選擇遠不如評估設計重要。你可以用複雜的平台建立一個功能薄弱的評估套件,也可以用幾個腳本建立一個強大的評估套件。選擇工具時,應優先考慮那些能夠使測試可重複、版本化、易於檢查,並且在每次重大更改之前都易於運行的工具。
對於產品助理而言,一個有效的發布決策可以用一系列關卡來表示,而不是一個綜合評分。例如,要求在精心設計的安全集中零個關鍵安全故障,任務正確性無統計學意義上的下降,RAG 問題達到最低的可靠性通過率,每個模式案例都有有效的結構化輸出,並且延遲或成本在運營預算範圍內。具體的閾值必須取決於您的風險承受能力和使用者需求;沒有一個通用的百分比可以判定一個 LLM 是否「夠好」。
同時,也要保留評分背後的原始案例。如果某個版本的分數從 0.84 提升到 0.86,你仍然需要知道哪兩個案例發生了變化,以及這些變化是否重要。實際上,團隊從少量分類清晰的失敗案例中學到的東西,比從缺乏可追溯性的、看似漂亮的儀錶板平均值中學到的東西要多得多。
衡量LLM響應品質是一門工程學科,而非憑感覺。首先要準備一個具有代表性的資料集,定義特定任務的品質維度,在需求可以計算的地方選擇確定性檢查,在需要語義判斷的地方使用LLM評判員,並用人工方式校準這些評判員,然後將候選變更與穩定的基線進行比較。之後,將每一個重要的實際故障轉化為未來的回歸測試。
如果按照這個循環來,評估框架就不僅僅是一個報告儀表板了:它變成了一個品質控制系統,可以告訴你提示、模型、檢索更改或代理更新是否真的使產品變得更好。
建立本地 Ollama 工作流程,批量產生結構化的 SEO 標題和元描述,驗證輸出,並將結果標記出來以供手動審核。
Use this free modern real estate listing presentation PowerPoint blueprint to organize pricing, marketing, property prep, agent value, and seller next steps.
在 Excel 中建立一個可列印的建築工程估價模板,其中包含清晰的人工、材料、公式、加價、排除項和可直接列印的客戶總計。
利用實用的電影級照明公式、可重複使用的配方、範例和快速故障排除清單,建立更強大的 Luma Dream Machine 視訊提示。
Build a minimalist tech startup investor pitch deck in PowerPoint with the right slide order, clear design rules, traction metrics, and investor-ready appendix.
阻止 Excel 將程式碼、ID 和分數轉換為日期。使用文字格式、撇號、匯入控制項和最新的 Microsoft 365 選項。
透過減少採樣工作、控制解析度和批次大小、簡化節點、使用快取以及安全地調整 VRAM 和注意力來加快 ComfyUI SDXL 渲染速度。
Build a practical rental property income and expense tracker in Excel with clear categories, formulas, monthly summaries, and tax-ready recordkeeping guidance.
使用 Ollama、AnythingLLM、本地嵌入和 RAG 建立私人本地 AI 知識庫。學習四步驟設定、隱私檢查、測試和備份。
透過修剪輸入、分割文件、使用檢索以及驗證最終答案是否涵蓋來源文件來修復長文檔分析中的上下文視窗錯誤。








