如何使用 Local Ollama 自動產生 SEO 元標題和描述

建立本地 Ollama 工作流程,批量產生結構化的 SEO 標題和元描述,驗證輸出,並將結果標記出來以供手動審核。
您已準備好發布 300 個產品、文件或部落格頁面,但元資料列仍然為空。手動編寫每個標題和元描述速度很慢;在整個網站中複製一種模式會產生重複的結果;而向本地語言模型請求“SEO 標題”通常會返回額外的註釋、虛構的說法或不一致的格式。
更好的方法是將元資料生成視為一個小型資料管道:僅向模型提供頁面特定信息,要求結構化輸出,在程式碼中進行驗證,然後在發布前審查異常情況。 Ollama 非常適合這種工作流程,因為它的本機 API 在http://localhost:11434/api安裝後即可使用,並且 Ollama 支援 JSON Schema 結構化輸出。此處引用的 Ollama 和 Google 搜尋文件已於 2026 年 9 月 13 日查閱。
大多數故障並非源自於單一“錯誤提示”,而是源自於圍繞模型的工作流程。常見原因包括:頁面內容輸入過少、允許模型以自由格式文字回答、對每個 URL 應用相同的關鍵字公式,以及發布輸出時未進行網站層級重複性檢查。
關於字元限制也存在一個長期存在的誤解。谷歌表示,頁面元素或元描述的長度沒有固定限制<title>;標題連結和摘要會根據需要進行截斷,通常是根據設備寬度。當Google系統認為其他表示形式較為合適時,也可能會根據頁面內容產生不同的標題連結或摘要。請參閱谷歌關於標題連結、摘要和元描述的官方指南。
這意味著腳本可以強制執行編輯長度限制以保持一致性,但不應將這些數字標記為 Google 的要求。在下面的範例中,標題 65 個字元和描述 165 個字元的限制僅為內部限制。請根據您的內容管理系統 (CMS)、品牌、在地化需求和審核流程進行變更。
Ollama 的官方快速入門指南列出了對 macOS、Windows 和 Linux 的支援。安裝完成後,下載一個本機模型。 Ollama 目前的文件經常gemma3在 API 範例中使用它,因此對於本教學來說,它是一個方便的中性範例:
ollama pull gemma3然後測試本地端點:
curl http://localhost:11434/api/generate -d '{"model":"gemma3","prompt":"Reply with the word ready.","stream":false}'Ollama API 文件指出,本機 API 服務位於 [此處應填寫服務地址] http://localhost:11434/api。 Ollama 也指出,透過此位址進行本機存取無需身份驗證。如果您的本機服務未運行,ollama serve請使用文件中提供的 CLI 命令啟動它。-cloud如果您的目標是真正進行本地推理,請避免替換模型。
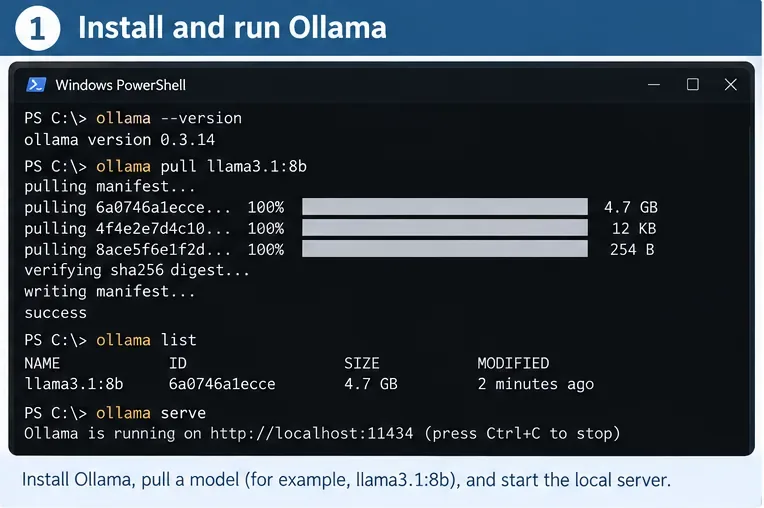
本文有意避免聲稱存在一種適用於所有情況的最佳 SEO 元資料模型。模型的可用性和硬體相容性會隨時間變化,而且模型越大,需要的記憶體通常越多,反應速度也越慢。建議先選擇一個您的機器能夠流暢運行的模型,產生一個小型評論集,然後在處理數千個頁面之前,比較其事實準確性、唯一性、延遲和一致性。
自由格式文字對於自動化來說並不友善。例如,「這裡有三個不錯的選擇…」這樣的回應會迫使程式猜測實際標題的起始位置。 Ollama 的結構化輸出文件支援在欄位中傳遞 JSON 模式format。該文件還建議在 Python 中使用 Pydantic 來實現可重複使用的模式,並指出較低的溫度(例如 100°C 0)可以提高確定性。
安裝本範例中使用的兩個 Python 套件:
python -m pip install -U ollama pydantic然後創建generate_meta.py:
from ollama import Client
from pydantic import BaseModel, Field

MODEL = "gemma3"
client = Client(host="http://localhost:11434")

class SeoMeta(BaseModel):
    title: str = Field(min_length=10, max_length=65)
    description: str = Field(min_length=70, max_length=165)

SYSTEM = """
You create SEO metadata from the page content supplied by the user.

Rules:
- Accurately describe only what is present in the page content.
- Write a concise, descriptive title.
- Write a useful meta description that distinguishes this page from other pages.
- Do not repeat keywords unnaturally.
- Keep the same primary language as the page.
- Do not invent prices, dates, features, guarantees, statistics, or claims.
- The length bounds in the JSON schema are our editorial limits, not Google rules.
- Return only the structured result required by the schema.
"""

def generate_meta(url: str, source_title: str, h1: str, body_text: str) -> SeoMeta:
    prompt = f"""
URL: {url}
Current title: {source_title}
H1: {h1}

Page text:
{body_text[:12000]}

Create one meta title and one meta description for this page.
"""
    response = client.chat(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        format=SeoMeta.model_json_schema(),
        options={"temperature": 0},
    )
    return SeoMeta.model_validate_json(response.message.content)

if __name__ == "__main__":
    result = generate_meta(
        url="https://example.com/guides/clean-cast-iron",
        source_title="Cast Iron Guide",
        h1="How to Clean a Cast-Iron Skillet Without Damaging the Seasoning",
        body_text=(
            "This guide explains how to remove stuck food, wash a cast-iron "
            "skillet, dry it thoroughly, and apply a thin layer of oil..."
        ),
    )
    print(result.model_dump_json(indent=2))
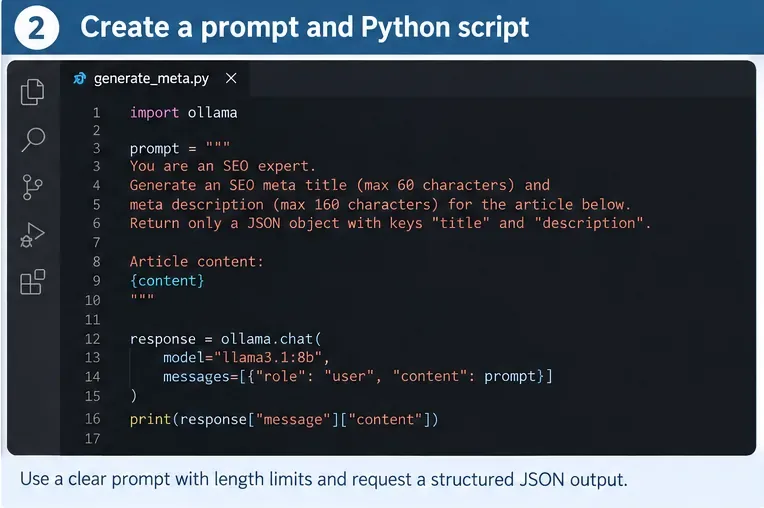
Google表示,其標題連結系統會考慮頁面的<title>主要視覺標題、標題(例如H1 標籤) <h1>、og:title顯著文字、錨文本和其他訊號。您的本機產生器無需完全複製Google的系統,但提供來源標題、H1 標籤、URL 和代表性正文文字有助於確保產生的元資料與讀者實際看到的頁面保持一致。
不要輸入不相關的關鍵字列表,然後要求模型「強行插入」。谷歌明確建議使用描述性強、簡潔明了的標題,並警告不要堆砌關鍵字和重複使用模板式內容。對於描述,Google表示,如果描述準確、易於理解且內容豐富,則適用於大型資料庫驅動的網站,可以使用頁面特定的程式化生成方式。
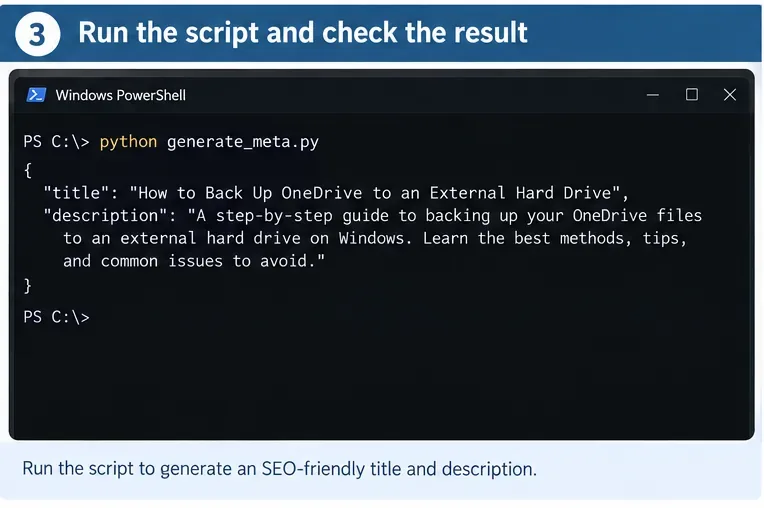
運行腳本:
python generate_meta.py成功的結果應該是一個 Pydantic 可以驗證的 JSON 物件。更重要的是,人工審核人員應該能夠將其與來源頁面進行比較,並快速回答以下四個問題:
模式可以限制資料類型和長度,但無法保證句子的真實性或足夠具體。圍繞可衡量的檢查建立重試邏輯。例如,拒絕空白欄位、重複標題、禁止的樣板文字或幾乎逐字重複標題的描述。如果頁麵包含受監管或高風險的聲明,則需要人工審核,而不是試圖透過自動化來消除信任。
盡量縮小重試提示的範圍。不要一遍又一遍地重複“改進”,而是告訴模型哪裡出了問題:“建議的標題與另一個頁面重複。請使用 H1 中的唯一主題重寫標題,同時確保每個聲明都基於提供的內容。”這樣可以更輕鬆地審核失敗原因。
一旦單頁測試可靠,請將輸入內容儲存在 CSV 檔案中,並包含諸如url`<content> `、 source_title`<content> h1`、 `<content>` 和 `<content>` 等欄位content。 `<content>` 欄位應包含清理後的頁面文本,而不是導航選單、Cookie 通知或成千上萬個無關的頁腳連結。
將此批次邏輯新增至生成器函數下方,或將其放在單獨的腳本中:
import csv

rows = []
seen_titles = set()

with open("pages.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        meta = generate_meta(
            url=row["url"],
            source_title=row.get("source_title", ""),
            h1=row.get("h1", ""),
            body_text=row["content"],
        )

        flags = []
        normalized = meta.title.casefold().strip()
        if normalized in seen_titles:
            flags.append("duplicate_title")
        seen_titles.add(normalized)

        rows.append({
            **row,
            "generated_title": meta.title,
            "generated_description": meta.description,
            "title_length": len(meta.title),
            "description_length": len(meta.description),
            "qa_flags": ",".join(flags),
        })

with open("seo_meta_output.csv", "w", newline="", encoding="utf-8") as f:
    fieldnames = list(rows[0].keys())
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(rows)
您可以在 Excel、LibreOffice、資料庫匯入工具或您的 CMS 工作流程中查看輸出的 CSV 檔案。首次運作時,請勿自動覆蓋即時元資料。請保留原始標題和描述以及產生的提案,以便審查者進行比較,並方便回滾。
| 查看 | 需要標記的內容 | 為什麼這很重要 |
|---|---|---|
| 模式驗證 | 缺失或無效字段 | 防止格式錯誤的輸出進入內容管理系統。 |
| 重複標題檢查 | 兩個URL上的標題相同 | 有助於區分不同的頁面。 |
| 語言檢查 | 元資料語言與頁面語言不同 | 谷歌建議使用與網頁主要語言和書寫系統相符的語言。 |
| 證據查核 | 來源中缺少數字、價格、日期、品牌或保證資訊。 | 減少幻覺相關的指控。 |
| 樣板檢查 | 全站範圍內重複出現的長句 | 谷歌不建議使用重複的模板標題。 |
| 編輯篇幅檢查 | 超出您選擇的房屋範圍 | 保持 CMS 輸出一致;這不是Google的字元限制規則。 |
| 人為評價 | 策略性、敏感度、高流量或意義模糊的頁面 | 自動化應該發現異常情況,而不是隱藏異常情況。 |
首先確認 Ollama 正在運作且http://localhost:11434可存取。官方身份驗證文件指出,本地 API 不需要身份驗證。如果您的腳本意外指向了https://ollama.com/api另一個託管端點,則該端點需要身份驗證。
使用模式format=SeoMeta.model_json_schema()而非僅以自然語言請求 JSON 資料。結構化輸出是生產流水線的理想控制層。
輸入頁面專屬的 H1 標題和有意義的正文內容,移除全域導航幹擾,並明確要求提供頁面專屬描述。然後運行跨頁面重複項和相似度檢查。重複通常是輸入問題,而非模型問題。
將輸入內容精簡為權威頁面文本,並強化基準規則:不得提出超出所提供內容的任何事實性主張。對於重要頁面,在批准之前,應將產生的斷言與結構化來源欄位進行比較。如果來源本身存在歧義,則應將該行提交人工審核,而不是反覆提示模型進行猜測。
在更改架構之前進行測量。記錄每頁的產生時間、輸入大小、模型名稱和失敗率。截斷無關的正文文本,處理穩定的頁面部分,如果品質仍然可接受,則測試一個較小的本地模型。如果模型的元資料產生的審核工作量超過了它節省的工作量,那麼速度最快的模型也毫無用處。
如果您已經為相容 OpenAI 的用戶端編寫了程式碼,Ollama 文件中提供了部分OpenAI API 相容性說明http://localhost:11434/v1/。這可以減少遷移工作量。對於新的僅限本機使用的元資料工具,Ollama 原生 Python 用戶端更簡單,並且在 Ollama 文件中直接提供了結構化輸出範例。
在完成自動化流程之前,請先建立一個包含不同內容類型的審核集:一篇短文、一篇長篇指南、一個產品頁面、一個分類頁面、一個包含數字的頁面,以及所有支援語言的頁面。對所有內容類型執行相同的模型和提示,然後檢查以下清單。
localhost,所選模型是本地模型,而不是雲端標記模型。最後,請記住自動化可以控制什麼,不能控制什麼。好的<title>元描述可以為搜尋引擎提供有用的頁面級訊號,但Google可以從頁面其他內容產生標題連結和摘要。因此,我們的目標不是強制呈現特定的搜尋結果,而是大規模地產生準確、獨特且有用的元數據,同時保留足夠的驗證和審核機制,以便在錯誤進入生產環境之前將其發現並修正。
建立本地 Ollama 工作流程,批量產生結構化的 SEO 標題和元描述,驗證輸出,並將結果標記出來以供手動審核。
Use this free modern real estate listing presentation PowerPoint blueprint to organize pricing, marketing, property prep, agent value, and seller next steps.
在 Excel 中建立一個可列印的建築工程估價模板,其中包含清晰的人工、材料、公式、加價、排除項和可直接列印的客戶總計。
利用實用的電影級照明公式、可重複使用的配方、範例和快速故障排除清單,建立更強大的 Luma Dream Machine 視訊提示。
Build a minimalist tech startup investor pitch deck in PowerPoint with the right slide order, clear design rules, traction metrics, and investor-ready appendix.
阻止 Excel 將程式碼、ID 和分數轉換為日期。使用文字格式、撇號、匯入控制項和最新的 Microsoft 365 選項。
透過減少採樣工作、控制解析度和批次大小、簡化節點、使用快取以及安全地調整 VRAM 和注意力來加快 ComfyUI SDXL 渲染速度。
Build a practical rental property income and expense tracker in Excel with clear categories, formulas, monthly summaries, and tax-ready recordkeeping guidance.
使用 Ollama、AnythingLLM、本地嵌入和 RAG 建立私人本地 AI 知識庫。學習四步驟設定、隱私檢查、測試和備份。
透過修剪輸入、分割文件、使用檢索以及驗證最終答案是否涵蓋來源文件來修復長文檔分析中的上下文視窗錯誤。








