如何使用 Local Ollama 自動產生 SEO 元標題和描述

建立本地 Ollama 工作流程,批量產生結構化的 SEO 標題和元描述,驗證輸出,並將結果標記出來以供手動審核。
自動化發票處理代理不需要一開始就是一個大型的自主人工智慧系統。對於初步可用的版本,可以將其視為一個受控的軟體工作流程:接收發票,呼叫對應的文件和人工智慧工具,驗證結果,判斷是否需要人工審核,最後才儲存或匯出已核准的資料。
這種區別在金融領域至關重要。語言模型可以幫助我們將雜亂的發票格式轉換為結構化字段,但它不應是決定發票是否有效或可以安全過帳的唯一因素。本指南採用初學者友善的設計,使資料擷取過程保持機率性,而重要的會計核查則保持確定性。
到最後,您將擁有一個本地原型,該原型可以接受 PDF 或圖像發票,提取供應商、發票編號、日期、貨幣、總計和行項目等字段,根據規則驗證這些字段,將可疑文檔路由到審核,存儲審計跟踪,並通過 API 公開該過程。
有四個術語值得了解:
截至 2026 年 9 月,多個活躍維護的開源專案涵蓋了這些層面。 Docling支援 PDF、圖像、辦公室文件和其他文件格式;PaddleOCR提供OCR和文件理解管道,並以 Apache 2.0 許可發布;Tesseract 專案在其官方手冊中將其當前的 5.x 系列作為開源 OCR 引擎進行了說明。
對於本機模型推理,llama.cpp 的伺服器文件描述了與 OpenAI 相容的端點和受模式約束的 JSON 輸出。這使其適用於提取服務,因為您可以要求本地託管的模型返回已定義的對象,而不是不受約束的文字。
一項重要的授權警告:開源推理引擎並不意味著所有模型權重都是開源的。請務必查看您部署的特定模型檢查點的許可協議,尤其是在商業用途中。
| 層 | 務實的選擇 | 它為何在此 |
|---|---|---|
| 文件轉換 | 馴鹿 | 將 PDF 和圖像轉換為結構化文件表示和可匯出的文字。 |
| OCR 回退 | PaddleOCR 或 Tesseract | 當發票是掃描件或照片,需要使用 OCR 技術提取文字時,此功能非常有用。 |
| 本地人工智慧提取 | llama.cpp + 合適的指令模型 | 將可變發票文字對應到穩定的 JSON 模式,同時保持推理本地化。 |
| 模式驗證 | 皮丹蒂克 | 根據聲明的欄位類型和約束條件驗證 Python 資料。 |
| API | FastAPI | 接受發票上傳並傳回處理結果。 |
| 貯存 | 原型系統使用 SQLite;共享服務使用 PostgreSQL | 儲存規範化資料、審核狀態、來源文件標識和稽核事件。 |
| 管弦樂 | 首先使用純 Python;LangGraph 可稍後新增。 | 確定性函數更容易調試。當分支邏輯和人工審核變得更加複雜時,可以新增有狀態代理框架。 |
Pydantic 的官方文件解釋說BaseModel,模型繼承自 `PydanticModel`,可以驗證傳入的數據,並透過 `PydanticModel` 產生 JSON Schema model_json_schema()。請參閱Pydantic 模型驗證。如果您以後需要持久化的有狀態分支,LangGraph 的參考文件介紹了長時間運行的有狀態代理、持久化和人機協作工作流程的支援。
不要一開始就著手「自動化應付帳款」。先從一種文檔類型和一種輸出合約入手。一個好的最小可行產品 (MVP) 應該包含:英文供應商發票、PDF 或圖像輸入、單一法人實體、單一貨幣集,並且不自動執行付款。
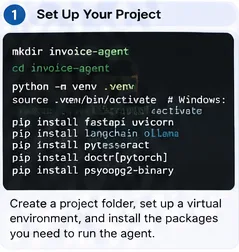
mkdir invoice-agent
cd invoice-agent
python -m venv .venv

# Linux/macOS
source .venv/bin/activate

pip install docling pydantic fastapi uvicorn httpx python-multipart
如果需要,請單獨安裝您的 OCR 引擎。 Docling 目前的安裝指南使用 [此處應填寫安裝指南pip install docling];PaddleOCR 目前的安裝文件則將其基礎 OCR 套件與可選的文件解析和資訊提取依賴項組區分開來。請使用Docling 安裝指南或PaddleOCR 3.x 安裝指南,而不是複製舊的依賴項清單。
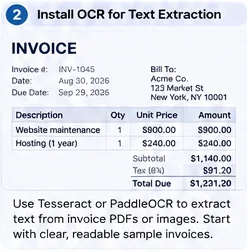
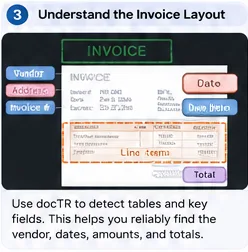
數位產生的 PDF 檔案可能已經包含可用文字。掃描的 PDF 檔案和照片需要進行 OCR 識別。解析器應該對後續流程隱藏這種差異:後續階段應該接收規範化的文件文字以及任何有用的佈局或表格資訊。
一個最簡化的 Docling 轉換範例如下:
from docling.document_converter import DocumentConverter

converter = DocumentConverter()

def parse_document(path: str) -> str:
    result = converter.convert(path)
    return result.document.export_to_markdown()
Docling 的官方快速入門指南也採用了相同的先轉換後導出的模式。對於包含大量 OCR 內容的文件集,建議您先用自己的掃描件測試 PaddleOCR 或 Tesseract。 PaddleOCR 的專案文件推薦使用其較新的 PP-StructureV3 系列進行文件分析,而 Tesseract 可以透過命令列或 API 調用,用於印刷文字的 OCR 識別。
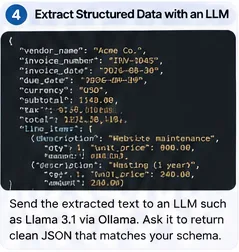
提取模式是人工智慧與會計邏輯之間的契約。避免使用包含「發票上可能出現的任何內容」的龐大模式。從可驗證的欄位開始。
from datetime import date
from decimal import Decimal
from pydantic import BaseModel, Field, ConfigDict

class LineItem(BaseModel):
    description: str
    quantity: Decimal | None = None
    unit_price: Decimal | None = None
    amount: Decimal

class Invoice(BaseModel):
    model_config = ConfigDict(extra="forbid")

    vendor_name: str
    invoice_number: str
    invoice_date: date
    due_date: date | None = None
    currency: str = Field(min_length=3, max_length=3)
    subtotal: Decimal | None = None
    tax: Decimal | None = None
    total: Decimal
line_items: list[LineItem] = []extra="forbid"在這種情況下,Pydantic 驗證非常有用,因為意外的 LLM 欄位不應悄悄地成為會計記錄的一部分。另請注意,Pydantic 驗證僅確認結構和類型,並不能證明提取的供應商或金額與發票影像相符。
在 llama.cpp 的 HTTP 伺服器後執行適當的指令模型。模型的具體大小取決於您的硬體和發票的複雜程度。不要想當然地認為更大的模型就一定更好;請使用您自己的發票資料集對欄位準確率、延遲和記憶體使用情況進行基準測試。
llama.cpp 目前支援受模式約束的 JSON 回應。您可以從 Pydantic 取得該模式,並將其與擷取請求一起傳送:
import json
import httpx

def extract_invoice(document_text: str) -> Invoice:
    schema = Invoice.model_json_schema()

    prompt = f"""
Extract one supplier invoice from the text below.
Do not invent values. If an optional field is absent, use null.
Currency must be a three-letter code.
Return only data that fits the required schema.

DOCUMENT:
{document_text}
"""

    payload = {
        "model": "local-model",
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0,
        "response_format": {
            "type": "json_schema",
            "schema": schema
        }
    }

    r = httpx.post(
        "http://127.0.0.1:8080/v1/chat/completions",
        json=payload,
        timeout=120
    )
    r.raise_for_status()

    content = r.json()["choices"][0]["message"]["content"]
    return Invoice.model_validate_json(content)
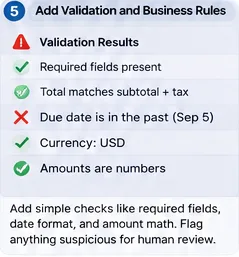
模式約束產生有助於確保結構有效,但並不能保證語意正確。一個完全有效的 JSON 物件仍然可能包含錯誤的總數。因此,下一步是必不可少的。
不要問LLM「你有自信嗎?」然後就相信他們的回答。自我報告的模型自信度並非經過校準的控制指標。要建立能夠從提取的資料和你的系統中重新計算的檢驗機制。
一些有用的基本規則包括:
from decimal import Decimal

def validate_business_rules(inv: Invoice) -> list[str]:
    errors = []

    if inv.subtotal is not None and inv.tax is not None:
        expected = inv.subtotal + inv.tax
        if abs(expected - inv.total) > Decimal("0.02"):
            errors.append("subtotal_plus_tax_does_not_match_total")

    line_sum = sum((x.amount for x in inv.line_items), Decimal("0"))
    if inv.subtotal is not None and abs(line_sum - inv.subtotal) > Decimal("0.02"):
        errors.append("line_items_do_not_match_subtotal")

    if inv.due_date and inv.due_date < inv.invoice_date:
        errors.append("due_date_before_invoice_date")

return errors將所有檢查失敗的發票都提交到審核佇列。對於首次部署,在評估提取品質期間,將所有發票提交審核是合理的。自動化閾值應基於您自行標記的發票收集的證據,而不是從其他系統複製的通用百分比。
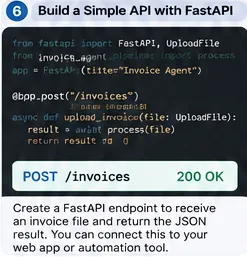
API 允許上傳表單、郵件工作程序、共用資料夾監視器或會計整合呼叫同一個處理函數。 FastAPI 的官方文件上傳指南建議UploadFile上傳文件時使用臨時文件,並指出這種方式比將大文件完全加載到記憶體中更合適。
from pathlib import Path
from tempfile import NamedTemporaryFile
from fastapi import FastAPI, UploadFile, HTTPException

app = FastAPI()

@app.post("/invoices")
async def process_upload(file: UploadFile):
    if file.content_type not in {
        "application/pdf",
        "image/png",
        "image/jpeg"
    }:
        raise HTTPException(415, "Unsupported file type")

    suffix = Path(file.filename or "").suffix

    with NamedTemporaryFile(suffix=suffix, delete=False) as tmp:
        tmp.write(await file.read())
        path = tmp.name

    result = process_invoice(path)
return result請參閱最新的FastAPI 請求文件文檔,以了解支援的上傳模式。在生產環境中,還應強制執行檔案大小限制、在適當情況下進行惡意軟體掃描、對呼叫者進行身份驗證、使用請求 ID 並確保臨時檔案安全清理。
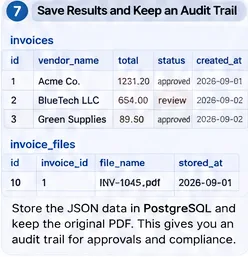
永遠不要只儲存最終的 JSON 資料。要保留足夠的證據來重現發生的情況:原始文件標識、雜湊值、解析器版本、模型標識符、提示符版本、提取的 JSON 資料、驗證結果、審核決定、時間戳記以及批准更改的用戶或服務。
一個簡單的原型可以使用 SQLite。多用戶服務可以使用 PostgreSQL,並啟用唯一性和外鍵約束。 PostgreSQL 目前的文件涵蓋了表格約束,這對於獨立於 AI 管線保護鍵和關係非常有用。
CREATE TABLE invoices (
    id BIGSERIAL PRIMARY KEY,
    vendor_id BIGINT NOT NULL,
    invoice_number TEXT NOT NULL,
    invoice_date DATE NOT NULL,
    currency CHAR(3) NOT NULL,
    total NUMERIC(18,2) NOT NULL,
    status TEXT NOT NULL,
    source_sha256 TEXT NOT NULL,
    extracted_json JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (vendor_id, invoice_number)
);
來源哈希值提供了檢測意外重複提交的第二種方法。由於發票通常包含地址、銀行詳細資料、稅務識別號碼和其他業務敏感數據,因此文件儲存權限應比一般應用程式日誌更為嚴格。
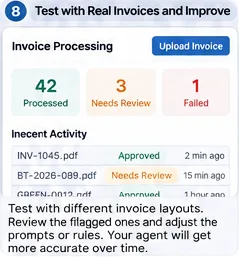
一個能在五個乾淨的 PDF 文件上運行的原型還不能用於生產環境。你需要建立一個標籤的評估資料集,該資料集應涵蓋你實際收到的各種輸入:不同的供應商、掃描件、旋轉過的頁面、小字體、多頁發票、折扣、負值行、稅費、運費、多種貨幣、缺少的採購訂單以及重複提交的文件。
將字段級指標單獨追蹤。 「發票準確率」可能會掩蓋供應商名稱容易取得但行項目數量不可靠的事實。至少應衡量以下指標:
將失敗案例儲存為測試用例。每次修復解析器規則、提示符號、模式或模型後,都要重新執行整個評估集。這樣可以防止一個供應商的改進悄悄破壞另一個供應商的佈局。
保持狀態機的明確定義。 「代理」最初可以是一個簡單的 Python 函數:
def process_invoice(path: str) -> dict:
    text = parse_document(path)
    invoice = extract_invoice(text)
    errors = validate_business_rules(invoice)

    if errors:
        status = "needs_review"
    else:
        status = "validated"

    record_id = save_invoice(
        source_path=path,
        invoice=invoice,
        validation_errors=errors,
        status=status,
    )

    return {
        "id": record_id,
        "status": status,
        "invoice": invoice.model_dump(mode="json"),
        "validation_errors": errors,
    }
這本身就具有類似代理的功能,因為它能夠協調工具並選擇分支。您無需使用 LLM 來選擇每個後續步驟。當您需要持久化的多階段審查、重試、非同步回呼或多個執行順序因案例而異的專用工具時,可以新增 LangGraph 或其他編排框架。
模型應進行提取和規範化;代碼和可信系統資料應進行驗證。算術運算、重複性檢查、供應商狀態、採購訂單比對和核准權限等都屬於確定性邏輯。
請保留原始發票或其有效參考憑證。審核人員需要證據,而您也需要一種方法來重現模型或解析器升級後出現的問題。
為每張已處理的發票儲存提示版本和型號識別碼。否則,您將無法解釋為什麼相隔數月處理的兩張發票的處理方式不同。
JSON 有效性並不等於發票有效性。首先進行人工審核,然後在評估結果顯示其效能可接受後,僅對低風險案例啟用自動化審核。
庫和模型權重可能採用不同的許可證。 PaddleOCR 和 Tesseract 發布的是開源許可證,而您透過 llama.cpp 運行的模型的許可證則取決於特定的檢查點。請在部署前確認其許可證。
精美的儀錶板無法彌補數據量錯誤。請先測試文件解析、模式提取和驗證;在了解審閱者實際需要看到的內容之後,再加入審閱介面。
| 方法 | 最佳匹配 | 主要限制 |
|---|---|---|
| OCR + 規則 | 少量高度穩定的供應商模板 | 隨著佈局的變化,規則變得脆弱不堪。 |
| 文檔佈局模型 | 表格、表單和欄位中,位置至關重要。 | 可能需要針對特定任務的訓練或後處理。 |
| OCR/文檔解析器 + 本機LLM | 許多發票格式都具有共同的目標架構 | 必須加以約束和驗證;推理需要消耗更多計算資源。 |
| 視覺語言模型 | 文字和視覺佈局緊密耦合的複雜文檔 | 更高的硬體需求和更複雜的評估流程。 |
Hugging Face 目前的LayoutLMv3 文件描述了一種結合文字和視覺佈局資訊的文檔 AI 模型。 PaddleOCR 的 PP-StructureV3 文件同樣著重於版面、表格和結構化文件分析。當純文字加上 LLM 不足以滿足需求時,這些都是可行的選擇。
分階段進行。首先,在本地運行,處理已標記的發票資料夾。其次,新增 API 和持久性儲存。第三,引入人工審核隊列。第四,整合唯讀查詢,例如供應商主資料或採購訂單。第五,允許受控匯出到會計暫存區。只有在監控驗證了控制措施後,才能考慮對嚴格定義的低風險情況進行自動過帳。
在每個階段,都要保留三樣東西:證據(原始文件和提取的來源文件)、確定性(可以重新運行的業務規則)和可追溯性(哪個解析器、模型、提示和審閱者產生了最終記錄)。
如果這些控制措施到位,您擁有的就不僅僅是一個 OCR 演示:您擁有了一個可靠的發票處理代理的基礎。開源元件可能會隨時間變化,但架構始終保持穩定——解析證據、提取到模式中、透過程式碼進行驗證、將不確定情況轉交給相關人員,並記錄每一個決策。
建立本地 Ollama 工作流程,批量產生結構化的 SEO 標題和元描述,驗證輸出,並將結果標記出來以供手動審核。
Use this free modern real estate listing presentation PowerPoint blueprint to organize pricing, marketing, property prep, agent value, and seller next steps.
在 Excel 中建立一個可列印的建築工程估價模板,其中包含清晰的人工、材料、公式、加價、排除項和可直接列印的客戶總計。
利用實用的電影級照明公式、可重複使用的配方、範例和快速故障排除清單,建立更強大的 Luma Dream Machine 視訊提示。
Build a minimalist tech startup investor pitch deck in PowerPoint with the right slide order, clear design rules, traction metrics, and investor-ready appendix.
阻止 Excel 將程式碼、ID 和分數轉換為日期。使用文字格式、撇號、匯入控制項和最新的 Microsoft 365 選項。
透過減少採樣工作、控制解析度和批次大小、簡化節點、使用快取以及安全地調整 VRAM 和注意力來加快 ComfyUI SDXL 渲染速度。
Build a practical rental property income and expense tracker in Excel with clear categories, formulas, monthly summaries, and tax-ready recordkeeping guidance.
使用 Ollama、AnythingLLM、本地嵌入和 RAG 建立私人本地 AI 知識庫。學習四步驟設定、隱私檢查、測試和備份。
透過修剪輸入、分割文件、使用檢索以及驗證最終答案是否涵蓋來源文件來修復長文檔分析中的上下文視窗錯誤。








