Mengurangi tagihan API LLM sebesar 50% dimungkinkan dalam banyak beban kerja, tetapi ini bukan jaminan universal. Hasilnya bergantung pada dari mana pengeluaran Anda berasal: token input yang tidak di-cache, token input yang di-cache, token output, token penalaran, panggilan alat, atau percobaan ulang. Kompresi prompt bekerja paling baik ketika input yang panjang atau repetitif merupakan bagian signifikan dari tagihan. Oleh karena itu, tujuan praktisnya bukanlah "membuat setiap prompt setengah lebih pendek." Tujuannya adalah "menghapus token yang tidak mengubah jawaban, mempertahankan token yang mengubah jawaban, dan memverifikasi penghematan pada lalu lintas nyata."
Panduan ini menggunakan empat langkah implementasi: mengukur baseline, menghapus input yang redundan, mengatur prompt untuk penggunaan ulang cache, dan memindahkan instruksi output yang bertele-tele ke kontrol terstruktur di mana API mendukungnya. Contoh-contoh yang diberikan bersifat ilustratif dan bukan klaim benchmark. Harga penyedia dan perilaku cache berubah seiring waktu, jadi verifikasi tarif terkini sebelum membuat estimasi produksi.
Apa yang sebenarnya diperlukan untuk pengurangan biaya API sebesar 50%?
Mulai dengan persamaan penagihan untuk model Anda. Untuk beban kerja teks sederhana, total biaya permintaan kira-kira adalah biaya input yang tidak di-cache ditambah input yang di-cache ditambah output. Beberapa model atau fitur menambahkan kategori penagihan lainnya. Respons API OpenAI saat ini mengekspos penggunaan token input dan output, termasuk detail token yang di-cache, dan halaman model mereka menerbitkan tarif terpisah untuk input, input yang di-cache, dan output.
| Beban kerja ilustratif | Token input | Token output | Hasil relatif |
|---|
| Permintaan baseline | 10.000 | 1.000 | 100% dari biaya baseline |
| Hanya input dipotong setengah | 5.000 | 1.000 | Penghematan total kurang dari 50% ketika output tetap tidak berubah |
| Input dan output keduanya dipotong setengah | 5.000 | 500 | Biaya berbasis token kira-kira 50% lebih rendah ketika tarif tidak berubah |
Untuk contoh konkret saat ini, halaman model resmi GPT-5.6 Sol mencantumkan, pada 11 September 2026, $4 per juta token input, $0,40 per juta token input yang di-cache, dan $20 per juta token output. Pada tarif tersebut, permintaan dengan 10.000 input/1.000 output biayanya sekitar $0,06 sebelum biaya lain. Memotong hanya input menjadi 5.000 token membawa contoh tersebut menjadi sekitar $0,04, pengurangan 33%. Memotong input dan output masing-masing setengah membawa biaya menjadi sekitar $0,03, pengurangan 50%. Harga-harga ini dapat berubah, jadi perlakukan aritmetika ini sebagai metode, bukan kutipan permanen. Lihat halaman model resmi GPT-5.6 Sol untuk harga terkini.
Referensi cepat: empat langkah bernilai tertinggi
| Teknik | Cocok untuk | Risiko utama | Yang harus diukur |
|---|
| Audit token | Setiap beban kerja produksi | Mengoptimalkan komponen yang salah | Input, input yang di-cache, output, percobaan ulang, biaya per tugas yang berhasil |
| Penghapusan redundansi | Prompt sistem yang panjang, kebijakan yang diulang, contoh yang bertele-tele | Menghapus batasan yang sebenarnya penting | Kesuksesan tugas dan paritas kepatuhan terhadap instruksi |
| Tata letak ramah cache | Permintaan berulang yang berbagi instruksi atau konteks stabil | Penggunaan ulang cache rendah karena teks dinamis muncul terlalu awal | Rasio token yang di-cache dan latensi |
| Kontrol output terstruktur | Ekstraksi JSON, klasifikasi, format respons tetap | Skema terlalu kaku untuk tugas tersebut | Token output, kegagalan parsing, percobaan ulang |
Langkah 1: Ukur baseline token nyata sebelum mengubah prompt
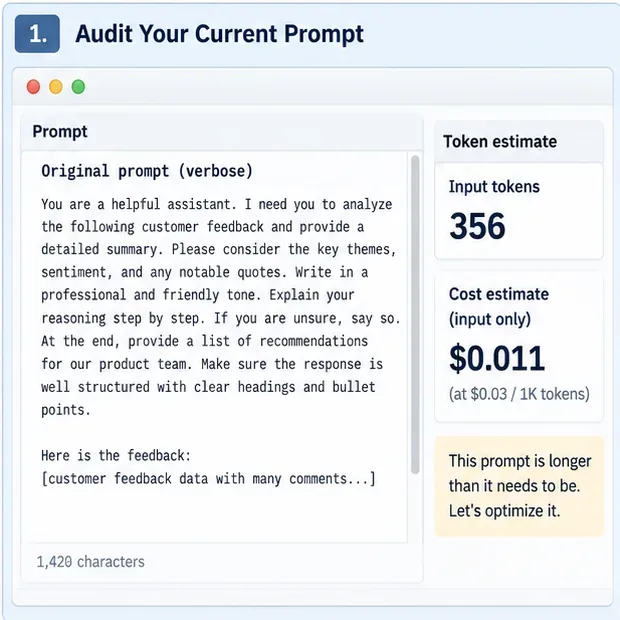
Caption: Antarmuka audit token ilustratif mencatat ukuran prompt asli dan estimasi biaya sampel sebelum kompresi; angka-angka tersebut bukan harga penyedia saat ini.
Kumpulkan sampel representatif dari permintaan produksi daripada mengoptimalkan satu prompt yang dipilih secara manual. Minimal, catat token input, token input yang di-cache jika tersedia, token output, nama model, latensi, percobaan ulang, dan apakah jawaban akhir lolos pemeriksaan kualitas bisnis Anda. Jika penyedia Anda menawarkan endpoint penghitung token input, gunakan itu sebelum mengirim permintaan ketika Anda membutuhkan penganggaran yang deterministik. OpenAI saat ini mendokumentasikan endpoint penghitung token input Responses dalam referensi API resminya.
Hitung biaya per tugas yang berhasil, bukan hanya biaya per panggilan API. Prompt terkompresi yang menyebabkan lebih banyak percobaan ulang bisa menjadi lebih mahal meskipun setiap permintaan lebih pendek. Segmenkan baseline berdasarkan jenis tugas juga: ringkasan, ekstraksi, tanya jawab RAG, penggunaan alat agen, dan percakapan panjang biasanya memiliki profil token yang berbeda.
Langkah 2: Hapus redundansi tanpa menghapus informasi kritis keputusan

Caption: Prompt sebelum dan sesudah ilustratif mempertahankan output yang diminta sama sambil menghapus pengulangan kata dan instruksi proses yang tidak perlu.
Pass kompresi pertama yang paling aman adalah deduplikasi semantik. Hapus deskripsi peran yang diulang, batasan yang diduplikasi, pengisi sopan, penjelasan format yang jelas, dan contoh yang mengajarkan pola yang sama lebih dari sekali. Gabungkan aturan yang tumpang tindih menjadi satu instruksi. Lebih suka satu kalimat yang presisi daripada beberapa kalimat yang menyatakan ulang persyaratan yang sama.
Sebelum
Anda adalah asisten yang membantu yang merupakan ahli dalam analisis produk.
Saya membutuhkan Anda untuk menganalisis umpan balik pelanggan berikut dan memberikan
ringkasan yang terperinci. Harap identifikasi tema utama, sentimen keseluruhan,
kutipan penting, dan rekomendasi untuk tim produk kami. Pastikan
respons Anda profesional, jelas, ringkas, dan terstruktur dengan baik.
Sesudah
Analisis umpan balik pelanggan.
Kembalikan: tema utama, sentimen keseluruhan, kutipan penting, dan rekomendasi produk.
Jadilah ringkas dan faktual.
Jangan mengompresi pengecualian, batas kebijakan, definisi domain, aturan keselamatan alat, atau persyaratan bukti hanya karena mereka panjang. Itu sering kali merupakan token bernilai tinggi. Tes yang berguna adalah bertanya: "Jika saya menghapus kalimat ini, dapatkah output yang dapat diterima berubah?" Jika ya, pertahankan kecuali kontrol API atau skema dapat menegakkan perilaku yang sama dengan lebih andal.
Langkah 3: Letakkan konten stabil di awal dan konten dinamis di akhir
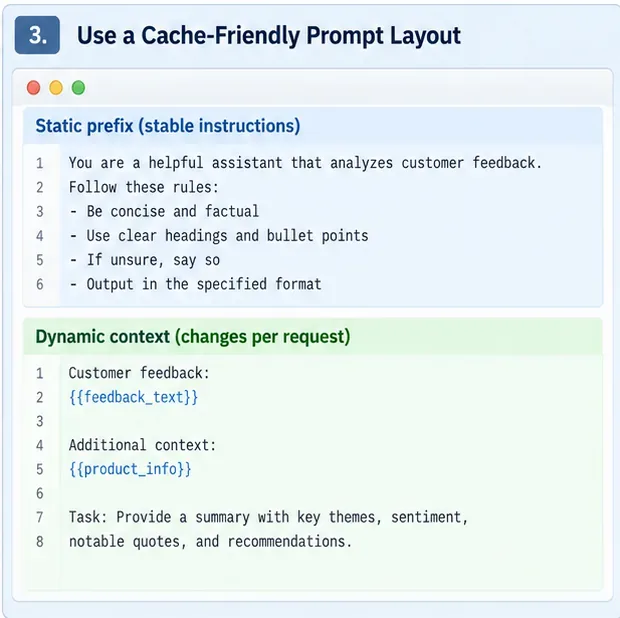
Caption: Tata letak prompt ilustratif menempatkan instruksi stabil dalam awalan yang dapat digunakan ulang dan menambahkan konteks spesifik permintaan kemudian.
Peng-cache-an prompt tidak mengurangi jumlah token mentah, tetapi dapat mengurangi jumlah yang ditagih pada tarif input normal dan menurunkan latensi pemrosesan prompt. Ini membuat tata letak prompt menjadi bagian dari optimasi biaya. Kelompokkan instruksi sistem, contoh bersama, panduan alat, dan konten stabil lainnya bersama-sama. Letakkan fakta spesifik permintaan, bagian yang diambil, data pengguna, dan pertanyaan saat ini di belakang.
Panduan model OpenAI secara eksplisit merekomendasikan untuk menempatkan konten statis di awal dan konten dinamis di akhir untuk meningkatkan penggunaan ulang cache prompt, dan objek penggunaan responsnya mengekspos informasi token yang di-cache untuk pengukuran. Lihat panduan model resmi dan referensi API Responses.
Hindari mengubah spasi yang tidak berbahaya, urutan contoh, stempel waktu, ID acak, atau teks per pengguna di dalam awalan yang seharusnya dapat digunakan ulang kecuali semantik cache penyedia menyatakan bahwa perubahan tersebut aman. Ukur cache hits dari respons API alih-alih mengasumsikan bahwa prompt sedang digunakan ulang.
Langkah 4: Ganti prosa tentang format dengan kontrol output terstruktur
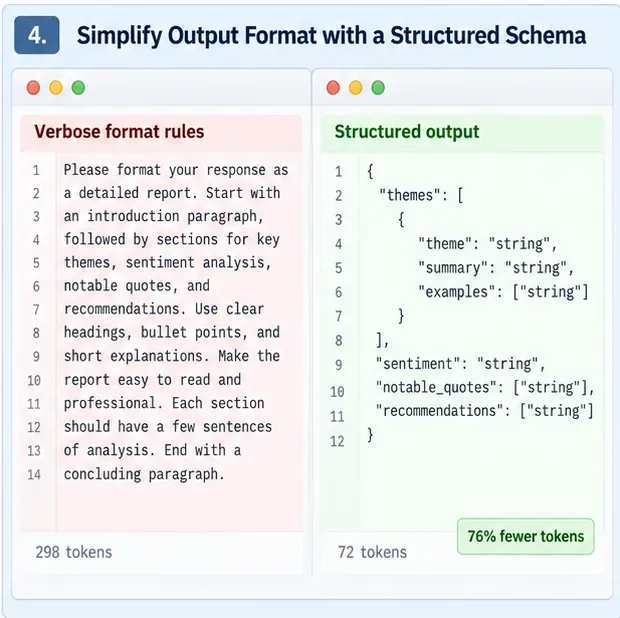
Caption: Tampilan output terstruktur ilustratif menunjukkan bagaimana skema dapat menggantikan banyak baris prosa yang secara berulang menggambarkan bentuk respons yang sama.
Prompt ekstraksi dan klasifikasi sering membuang token dengan mendeskripsikan bidang JSON, nilai yang diizinkan, penestingan, pengurutan, dan aturan validasi dalam bahasa alami. Ketika API mendukung output terstruktur atau argumen alat bertipe, pindahkan sebanyak mungkin kontrak tersebut ke antarmuka terstruktur dan fokuskan instruksi bahasa alami pada makna.
Panduan OpenAI saat ini secara spesifik merekomendasikan untuk menghapus definisi skema output dari prompt jika memungkinkan dan menggunakan Structured Outputs sebagai gantinya. Ini dapat mengurangi teks prompt dan juga mengurangi percobaan ulang output yang tidak valid. Mekanisme pastinya bervariasi berdasarkan penyedia, jadi jangan menyalin format permintaan khusus OpenAI ke API lain tanpa memeriksa dokumentasi penyedia tersebut.
Kompresi lanjutan untuk RAG, dokumen panjang, dan percakapan
Setelah empat langkah dasar stabil, penghematan yang lebih besar biasanya berasal dari pengurangan konteks daripada memoles kata-kata kalimat. Dalam sistem RAG, ambil lebih sedikit tetapi bagian yang lebih relevan, deduplikasi potongan yang hampir identik, dan hindari melampirkan dokumen yang tidak dapat memengaruhi jawaban. Untuk percakapan panjang, pertahankan fakta tahan lama dan keputusan yang belum terselesaikan, tetapi ringkas atau buang giliran yang tidak lagi memengaruhi tugas saat ini. Untuk sistem agen, ekspos hanya alat dan deskripsi alat yang relevan dengan tahap saat ini ketika arsitektur Anda mengizinkannya dengan aman.
Kompresor prompt yang dipelajari adalah opsi lain untuk konteks yang sangat panjang. Proyek open-source Microsoft LLMLingua mengimplementasikan kompresi prompt tingkat token. Makalah LLMLingua asli melaporkan rasio kompresi hingga 20× dengan degradasi benchmark yang terbatas dalam pengaturan yang dievaluasinya. LongLLMLingua menargetkan tugas konteks panjang, sementara LLMLingua-2 menggunakan kompresor yang dipelajari yang tidak bergantung pada tugas. Itu adalah hasil penelitian, bukan janji bahwa rasio yang sama akan mempertahankan kualitas pada data Anda. Lakukan benchmark pada tugas, bahasa, model, dan jenis prompt Anda sendiri sebelum menerapkan kompresi agresif.
Bagaimana membuktikan bahwa optimasi benar-benar lebih baik
Jalankan evaluasi A/B pada permintaan representatif yang sama. Versi baseline dan terkompresi harus menggunakan model, pengaturan penalaran, alat, input pengambilan, dan kriteria keberhasilan yang sama. Ubah satu teknik kompresi pada satu waktu jika memungkinkan sehingga Anda dapat mengidentifikasi apa yang menyebabkan regresi.
| Metrik | Mengapa penting | Interpretasi yang disarankan |
|---|
| Pengurangan token input | Menunjukkan penyusutan prompt mentah | Berguna, tetapi tidak cukup dengan sendirinya |
| Rasio token yang di-cache | Menunjukkan apakah awalan stabil digunakan ulang | Lebih tinggi biasanya lebih baik ketika kualitas tidak berubah |
| Pengurangan token output | Dapat secara material mengubah total biaya | Verifikasi bahwa output ringkas masih menyelesaikan tugas |
| Biaya per tugas yang berhasil | Mencakup percobaan ulang dan kegagalan | Ini adalah metrik bisnis utama |
| Kesuksesan tugas / akurasi | Mendeteksi kehilangan informasi | Tetapkan ambang non-inferioritas yang dapat diterima sebelum pengujian |
| Latensi p50 dan p95 | Menunjukkan dampak nyata pada pengguna | Prapemrosesan kompresi dapat mengimbangi penghematan inferensi |
Jangan menyatakan kemenangan karena prompt 50% lebih pendek. Kondisi penerimaan yang lebih kuat adalah: konfigurasi terkompresi mengurangi biaya terukur dengan kira-kira jumlah target Anda sambil tetap berada dalam toleransi kualitas, latensi, dan keandalan yang telah ditentukan sebelumnya.
Kapan Anda harus berhenti mengompresi?
Berhenti atau mundur ketika pengurangan berikutnya menghapus fakta yang diperlukan untuk keputusan yang benar, meningkatkan halusinasi, menyebabkan kesalahan panggilan alat, melemahkan kepatuhan kebijakan, atau meningkatkan percobaan ulang cukup untuk menghapus penghematan. Kompresi juga dapat menambah latensi jika Anda menjalankan model terpisah untuk mengompresi setiap prompt. Studi 2026 tentang kompresi prompt dalam pengaturan inferensi dunia nyata menemukan bahwa overhead prapemrosesan dapat membatalkan keuntungan inferensi di luar rezim panjang prompt dan perangkat keras yang menguntungkan, yang merupakan alasan lain untuk mengukur kinerja end-to-end daripada hanya jumlah token.
Untuk prompt kecil, pembersihan manual dan organisasi ramah cache biasanya lebih mudah dibenarkan daripada menambahkan model kompresi khusus. Untuk payload RAG besar atau alur kerja multi-dokumen, seleksi konteks dan kompresi yang dipelajari menjadi lebih menarik karena volume token yang dapat dihapus jauh lebih besar.
Daftar periksa implementasi cepat
- Capture baseline produksi dengan input, input yang di-cache, output, latensi, percobaan ulang, dan kesuksesan tugas.
- Hapus instruksi yang diduplikasi, prosa bernilai rendah, dan contoh redundan terlebih dahulu.
- Pertahankan definisi domain, pengecualian, persyaratan bukti, dan batasan keselamatan.
- Letakkan konten prompt stabil sebelum konten spesifik permintaan dinamis ketika semantik cache menghargai awalan yang dapat digunakan ulang.
- Gunakan output terstruktur atau skema alat alih-alih secara berulang mendeskripsikan format respons tetap dalam prosa.
- Untuk RAG, kurangi konteks yang tidak relevan dan duplikat sebelum mencoba kompresi tingkat token.
- Batasi panjang output hanya ketika tugas masih dapat diselesaikan dengan benar.
- Bandingkan biaya per tugas yang berhasil, bukan hanya jumlah token prompt.
- Jalankan tes regresi sebelum dan sesudah setiap perubahan kompresi yang berarti.
- Periksa kembali harga penyedia dan aturan cache setiap kali Anda mengubah model atau versi API.
Kesimpulan
Pengurangan 50% adalah target rekayasa yang wajar untuk beberapa beban kerja yang bertele-tele dan kaya konteks, tetapi harus diperlakukan sebagai hasil untuk divalidasi, bukan ekspektasi default. Jalur yang paling andal adalah mengukur terlebih dahulu, menghapus teks yang secara semantik redundan, memaksimalkan penggunaan ulang cache yang aman, memperpendek kontrak output dengan kontrol terstruktur, dan kemudian menyerang blok konteks terbesar yang tersisa dengan pemangkasan pengambilan, ringkasan, atau kompresor prompt yang teruji. Jika biaya akhir per tugas yang berhasil turun sementara kualitas tetap berada dalam band penerimaan Anda, kompresi tersebut berhasil. Jika kualitas atau percobaan ulang memburuk, pulihkan informasi yang hilang dan optimalkan bagian permintaan yang berbeda.
Referensi utama








