Beranda
» Domain
»
Cara Menjalankan DeepSeek Secara Offline di Windows 11 dengan LM Studio
Cara Menjalankan DeepSeek Secara Offline di Windows 11 dengan LM Studio
Ya—Anda dapat menjalankan DeepSeek sepenuhnya secara offline di Windows 11 dengan LM Studio, tetapi Anda perlu satu kali pengaturan online terlebih dahulu. Instal LM Studio, unduh model DeepSeek yang kompatibel dan runtime yang diperlukan, muat model tersebut satu kali, dan setelah itu Anda dapat memutuskan koneksi internet. Dokumentasi offline resmi LM Studio menyatakan bahwa mengobrol dengan model yang diunduh, mengobrol dengan dokumen lokal, dan menjalankan server lokalnya tidak memerlukan akses internet.
Untuk PC Windows 11 tipikal, titik awal yang paling praktis bukanlah model DeepSeek terbesar saat ini. Model GGUF yang lebih kecil seperti DeepSeek-R1-0528-Qwen3-8B jauh lebih mudah dijalankan secara lokal. LM Studio menerbitkan dukungan untuk model distilasi 8B tersebut pada Mei 2025 dan menyatakan bahwa model tersebut berfungsi dalam format GGUF dengan LM Studio 0.3.16 atau yang lebih baru. Sebaliknya, panduan LM Studio Agustus 2026 untuk DeepSeek V4 Flash menyatakan bahwa penggunaan lokal memerlukan sekitar 156GB memori sistem. Hal ini menjadikan V4 Flash pilihan yang buruk bagi sebagian besar mesin Windows konsumen meskipun lebih baru dan lebih mampu.
Panduan ini diperiksa pada 11 September 2026. Changelog LM Studio mencantumkan versi 0.4.24 bertanggal 9 September 2026. Karena antarmuka LM Studio terus berkembang, sebuah tombol mungkin sedikit berpindah posisi antar build, tetapi alur kerja inti—mengunduh model, memuatnya, mengobrol secara lokal, dan secara opsional mengekspos API localhost—tetap didokumentasikan oleh LM Studio.
Sebelum Memulai: Apakah PC Windows 11 Anda Memenuhi Syarat?
LM Studio saat ini mendukung PC Windows x64 dan sistem Windows berbasis ARM. Untuk x64, CPU harus mendukung AVX2. LM Studio merekomendasikan setidaknya 16GB RAM dan setidaknya 4GB VRAM khusus. Itu adalah rekomendasi tingkat aplikasi, bukan jaminan bahwa setiap model akan muat. Ukuran model, kuantisasi, panjang konteks, dan offload GPU semuanya memengaruhi penggunaan memori.
Yang Anda miliki
Rekomendasi praktis
Alasan
16GB RAM, GPU sederhana atau grafis terintegrasi
Mulai dengan model distilasi DeepSeek 8B atau lebih kecil dalam varian GGUF 4-bit
Ini menjaga jejak model tetap relatif terkendali sambil mempertahankan kemampuan penalaran yang berguna.
RAM lebih besar dan GPU yang lebih kuat
Coba varian distilasi yang lebih besar hanya setelah memeriksa estimasi kecocokan perangkat LM Studio
Model yang lebih besar mungkin meningkatkan kualitas tetapi mengonsumsi jauh lebih banyak memori dan bisa jauh lebih lambat.
PC gaming atau laptop biasa
Jangan mulai dengan DeepSeek V4 Flash
LM Studio menyatakan bahwa model V4 Flash lokal membutuhkan setidaknya 156GB memori sistem.
Dokumentasi pengunduhan model LM Studio menjelaskan bahwa build terkuantisasi menukar beberapa fidelitas demi file yang lebih kecil dan tekanan memori yang lebih rendah. Rekomendasi umumnya adalah memilih opsi 4-bit atau lebih tinggi ketika perangkat keras Anda mampu menanganinya. Jika Anda tidak yakin, versi GGUF 4-bit adalah tes awal yang masuk akal.
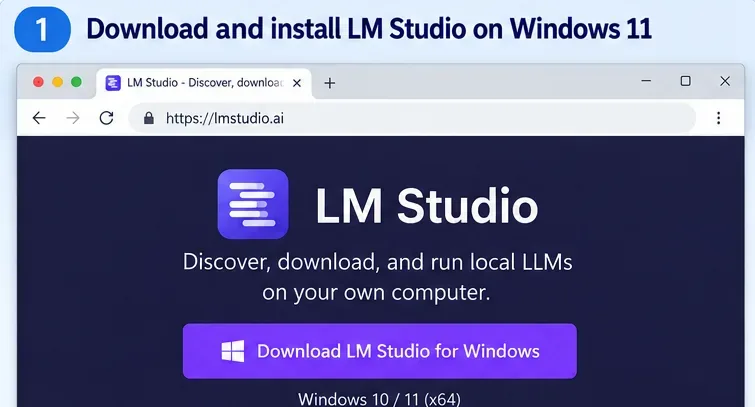
Unduh build Windows stabil terbaru dari halaman unduhan resmi LM Studio. Gunakan installer yang sesuai dengan arsitektur Windows Anda. Pada PC x64, pastikan prosesor Anda mendukung AVX2 sebelum memecahkan masalah kesalahan pemuatan model nanti.
Tampilan unduhan Windows untuk LM Studio. Pilih installer yang sesuai dengan sistem Windows 11 Anda sebelum beralih ke pengunduhan model.
Luncurkan LM Studio saat Anda masih memiliki koneksi internet. Ini penting karena aplikasi mungkin perlu mengunduh atau memperbarui LM Runtime. LM Studio mendeskripsikan runtime sebagai mesin inferensi yang dikemas, seperti runtime berbasis llama.cpp untuk model GGUF. Pengunduhan runtime memerlukan konektivitas meskipun inferensi dapat bekerja secara offline setelahnya.
Langkah 2: Unduh Model DeepSeek yang Cocok untuk PC Anda
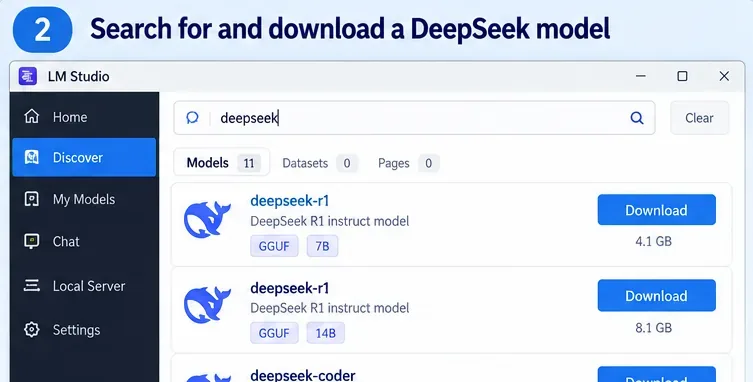
Buka area Discover di LM Studio dan cari DeepSeek. LM Studio dapat mencari model Hugging Face yang didukung berdasarkan kata kunci, pengidentifikasi user/model, atau bahkan URL Hugging Face lengkap.
Cari DeepSeek di Discover, lalu pilih model dan kuantisasi yang sesuai dengan perangkat keras Anda. Entri katalog yang tepat dan ukuran file berubah seiring waktu.
Model DeepSeek mana yang harus Anda pilih?
Bagi kebanyakan orang yang mengikuti panduan ini, mulailah dengan DeepSeek-R1-0528-Qwen3-8B. LM Studio menyatakan bahwa model distilasi 8B ini mendukung penalaran dan penggunaan alat, tersedia sebagai GGUF, dan dapat berjalan dengan jauh lebih sedikit memori daripada model DeepSeek unggulan. Panduan Windows LM Studio masih merekomendasikan 16GB RAM untuk aplikasi secara keseluruhan, jadi jangan perlakukan klaim memori rendah khusus model sebagai target sistem keseluruhan yang nyaman.
DeepSeek juga merilis varian distilasi R1 sebelumnya pada parameter 1,5B, 7B, 8B, 14B, 32B, dan 70B. Varian-varian ini memberi Anda ruang untuk menukar kecepatan dan penggunaan memori dengan kemampuan. Lihat repositori resmi DeepSeek-R1 untuk detail keluarga model dan lisensi, dan catatan eksekusi lokal DeepSeek-R1-0528 LM Studio untuk opsi 8B.
Jika Anda tergoda oleh DeepSeek V4 Flash karena lebih baru, periksa persyaratan perangkat keras terlebih dahulu. Artikel resmi V4 Flash LM Studio menyatakan bahwa model Mixture-of-Experts 284B membutuhkan setidaknya 156GB memori sistem untuk penggunaan lokal. Ini layak dijalankan pada workstation memori tinggi, bukan laptop Windows biasa.
Langkah 3: Muat Model ke Memori
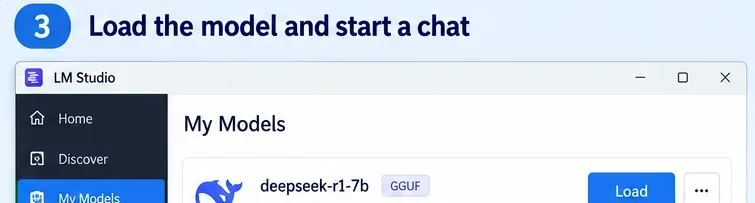
Setelah pengunduhan selesai, buka model yang telah diunduh Anda atau buka pemuat model dari Chat. Pilih model DeepSeek dan muat. LM Studio menjelaskan bahwa memuat model mengalokasikan memori untuk bobot model dan status runtime terkait.
Model GGUF DeepSeek yang telah diunduh siap dimuat. Jika pemuatan gagal, coba model yang lebih kecil atau kuantisasi memori lebih rendah sebelum mengubah pengaturan lanjutan.
Untuk run pertama Anda, pertahankan pengaturan pemuatan yang konservatif. Jendela konteks yang sangat besar dapat mengonsumsi memori tambahan yang signifikan, sehingga tidak ada alasan untuk memaksimalkan konteks segera. Muat model dengan konteks yang sederhana, verifikasi bahwa itu berfungsi, dan perluas hanya ketika beban kerja Anda membutuhkannya.
Jika LM Studio melaporkan bahwa model tidak muat, perbaikan yang paling andal biasanya adalah memilih model yang lebih kecil atau kuantisasi yang lebih ringkas. Menutup aplikasi yang boros memori dapat membantu, tetapi tidak mengubah jejak model fundamental.
Langkah 4: Putuskan Koneksi Internet dan Verifikasi DeepSeek Benar-Benar Berfungsi Offline
Ini adalah langkah yang membedakan “model lokal” dari sekadar “menggunakan klien desktop.” Setelah model dan runtime-nya terinstal, matikan Wi-Fi dan putuskan Ethernet. Kemudian mulai chat baru dan kirim prompt sederhana seperti:
Jelaskan perbedaan antara RAM dan VRAM dalam lima poin.
Jika model merespons saat PC tidak memiliki koneksi jaringan, inferensi bersifat lokal. LM Studio menyatakan bahwa begitu LLM ada di mesin Anda, ia dapat berjalan sepenuhnya secara offline dan bahwa teks yang dimasukkan ke dalam chat LLM lokal tidak meninggalkan perangkat Anda. Dokumentasi offline-nya juga menyatakan bahwa pemrosesan dokumen lokal dan RAG tetap berada di mesin.
Model DeepSeek yang dimuat merespons di LM Studio Chat. Untuk memverifikasi operasi offline sendiri, putuskan akses jaringan setelah model dan runtime sepenuhnya diunduh dan ulangi prompt sederhana.
Ada batas penting: mencari model, mengunduh model baru, mengunduh runtime, dan memeriksa pembaruan aplikasi memerlukan akses internet. Jika Anda kemudian menambahkan model cloud, server MCP jarak jauh, alat web, atau integrasi jaringan lainnya, fitur-fitur tersebut mungkin juga memerlukan konektivitas. Klaim privasi offline berlaku untuk alur kerja lokal, bukan untuk layanan yang Anda hubungkan secara sengaja setelahnya.
Langkah 5: Opsional—Gunakan DeepSeek Melalui API Lokal
Jika Anda ingin aplikasi Windows lain, skrip, ekstensi IDE, atau alat internal memanggil model DeepSeek lokal Anda, LM Studio dapat menjalankan server lokal. Dokumentasi pengembang saat ini menyatakan bahwa Anda dapat memulainya dari halaman Developer atau dengan:
lms server start
Secara default, server tersedia di http://localhost:1234. LM Studio menyediakan endpoint REST native dan endpoint yang kompatibel dengan OpenAI. Server itu sendiri dapat beroperasi secara offline selama model dan runtime sudah lokal. Namun, jika Anda mengekspos server di luar localhost, tinjau pengaturan autentikasi dan akses jaringan terlebih dahulu.
RAM/VRAM tidak cukup, konteks terlalu besar, atau CPU/runtime tidak didukung
Coba model DeepSeek yang lebih kecil, kuantisasi yang lebih kecil, atau panjang konteks yang lebih rendah. Pada Windows x64, konfirmasi dukungan AVX2.
LM Studio berfungsi online tetapi tidak setelah diputuskan
Model atau runtime yang diperlukan tidak sepenuhnya diunduh
Sambungkan kembali sekali, selesaikan semua pengunduhan model/runtime, muat model dengan sukses, lalu ulangi tes offline.
Generasi sangat lambat
Model terlalu besar untuk akselerasi GPU yang tersedia dan sangat bergantung pada CPU/memori sistem
Pilih model atau kuantisasi yang lebih kecil. Model yang lebih besar tidak berguna jika latensi membuat alur kerja tidak praktis.
Anda tidak dapat menemukan model saat offline
Pencarian Discover memerlukan akses jaringan
Unduh model sebelum menjadi offline, atau sideload file model yang diperoleh melalui proses terkendali lainnya.
Anda mengharapkan V4 Flash berjalan di laptop biasa
Persyaratan memori lokalnya adalah kelas workstation
Gunakan model distilasi R1 sebagai gantinya kecuali mesin Anda memiliki sekitar 156GB atau lebih memori sistem.
Kapan Pengaturan Ini Cocok
Menjalankan DeepSeek offline dengan LM Studio sangat cocok ketika Anda menginginkan inferensi lokal privat, biaya yang dapat diprediksi setelah mengunduh model, eksperimen tanpa kunci API, atau API localhost untuk pengembangan. Ini juga berguna ketika mesin Anda harus terus bekerja tanpa akses internet.
Ini kurang cocok ketika Anda membutuhkan model DeepSeek terkuat yang tersedia tetapi hanya memiliki perangkat keras konsumen, ketika Anda membutuhkan throughput yang sangat tinggi, atau ketika beban kerja Anda bergantung pada informasi web langsung. Model lokal hanya mengetahui apa yang ada di bobotnya dan konteks yang Anda berikan kecuali Anda secara sengaja menghubungkan alat eksternal atau sumber data.
Daftar Periksa Cepat
Gunakan sistem Windows 11 yang memenuhi persyaratan LM Studio; CPU x64 memerlukan AVX2.
Pertahankan akses internet untuk pengunduhan awal LM Studio, runtime, dan model.
Mulai dengan model GGUF DeepSeek yang lebih kecil, terutama model distilasi kelas 8B.
Pilih kuantisasi 4-bit atau lebih tinggi jika perangkat keras Anda dapat mendukungnya.
Muat model dengan sukses sebelum memutuskan jaringan.
Matikan Wi-Fi/Ethernet dan jalankan prompt baru untuk memverifikasi inferensi offline.
Kurangi ukuran model atau panjang konteks jika Anda mengalami kesalahan memori.
Gunakan server localhost LM Studio hanya jika Anda memerlukan akses API lokal.
Kesimpulan
Cara termudah untuk menjalankan DeepSeek offline di Windows 11 adalah memasangkan LM Studio dengan model GGUF DeepSeek yang lebih kecil yang benar-benar muat di perangkat keras Anda. Untuk PC biasa, model distilasi R1 kelas 8B adalah titik awal yang jauh lebih realistis daripada DeepSeek V4 Flash. Selesaikan pengunduhan saat online, muat model, putuskan jaringan, dan verifikasi bahwa chat baru masih merespons. Setelah itu berhasil, Anda memiliki pengaturan DeepSeek yang benar-benar lokal, bukan sekadar pembungkus desktop di sekitar API cloud.