CrewAIエージェントによる重複タスクの実行を停止する方法:実践的な重複排除ガイド

タスクの所有権、依存関係、委任、再試行、フローのトリガー、状態の永続性、キャッシュ、冪等性を修正することで、CrewAIエージェントが作業を繰り返すのを防ぎます。
多くのワークロードにおいて、LLM APIの請求額を50%削減することは可能ですが、これは普遍的な保証ではありません。結果は、支出の主な要因がどこにあるかによって異なります。キャッシュされていない入力トークン、キャッシュされた入力トークン、出力トークン、推論トークン、ツール呼び出し、またはリトライなどです。プロンプト圧縮は、長い、あるいは反復的な入力が請求額の大きな割合を占めている場合に最も効果的です。したがって、実用的な目標は「すべてのプロンプトを半分の長さにする」ことではなく、「回答を変えないトークンを削除し、回答を変えるトークンを保持し、実際のトラフィックで削減効果を検証する」ことです。
このガイドでは、4つの実装ステップを使用します。ベースラインの測定、冗長な入力の削除、キャッシュ再利用のためのプロンプト整理、APIがサポートする場合は冗長な出力指示を構造化コントロールへ移行することです。例はベンチマークの主張ではなく、説明のためのものです。プロバイダーの価格設定とキャッシュの挙動は時間とともに変化するため、本番環境での見積もりを行う前に現在の料金を確認してください。
モデルの請求方程式から始めます。シンプルなテキストワークロードの場合、リクエストの総コストは、キャッシュされていない入力コスト、キャッシュされた入力コスト、出力コストの合計にほぼ等しくなります。一部のモデルや機能では、他の課金カテゴリが追加されます。OpenAIの現在のAPIレスポンスは、キャッシュトークンの詳細を含む入力および出力トークンの使用状況を開示しており、モデルページでは入力、キャッシュされた入力、出力の個別の料金を公開しています。
| 説明用のワークロード | 入力トークン | 出力トークン | 相対的な結果 |
|---|---|---|---|
| ベースラインリクエスト | 10,000 | 1,000 | ベースラインコストの100% |
| 入力のみを半分に削減 | 5,000 | 1,000 | 出力が変更されない場合、総削減率は50%未満 |
| 入力と出力の両方を半分に削減 | 5,000 | 500 | 料金が変更されない場合、トークンベースのコストは約50%低減 |
具体的な現在の例として、公式のGPT-5.6 Solモデルページには、2026年9月11日時点で、入力トークン100万あたり4ドル、キャッシュされた入力トークン100万あたり0.40ドル、出力トークン100万あたり20ドルと記載されていました。これらの料金では、入力10,000/出力1,000のリクエストは、他の手数料を除いて約0.06ドルのコストがかかります。入力をのみ5,000トークンに削減すると、この例では約0.04ドルとなり、33%の削減です。入力と出力の両方を半分に削減すると、約0.03ドルとなり、50%の削減です。これらの価格は変動する可能性があるため、この計算は方法論として扱い、永続的な見積もりとして扱わないでください。現在の料金は、公式GPT-5.6 Solモデルページを参照してください。
| 技術 | 最適な適用先 | 主なリスク | 測定すべき項目 |
|---|---|---|---|
| トークン監査 | すべての本番ワークロード | 誤ったコンポーネントの最適化 | 入力、キャッシュされた入力、出力、リトライ、タスク成功あたりのコスト |
| 冗長性の削除 | 長いシステムプロンプト、繰り返されるポリシー、冗長な例 | 実際に重要な制約の削除 | タスクの成功と指示遵守の同等性 |
| キャッシュに優しいレイアウト | 安定した指示やコンテキストを共有する繰り返されるリクエスト | 動的テキストが早すぎる位置にあるため、キャッシュ再利用が低い | キャッシュトークン比率とレイテンシ |
| 構造化出力コントロール | JSON抽出、分類、固定レスポンス形式 | タスクに対してスキーマが厳格すぎる | 出力トークン、解析失敗、リトライ |
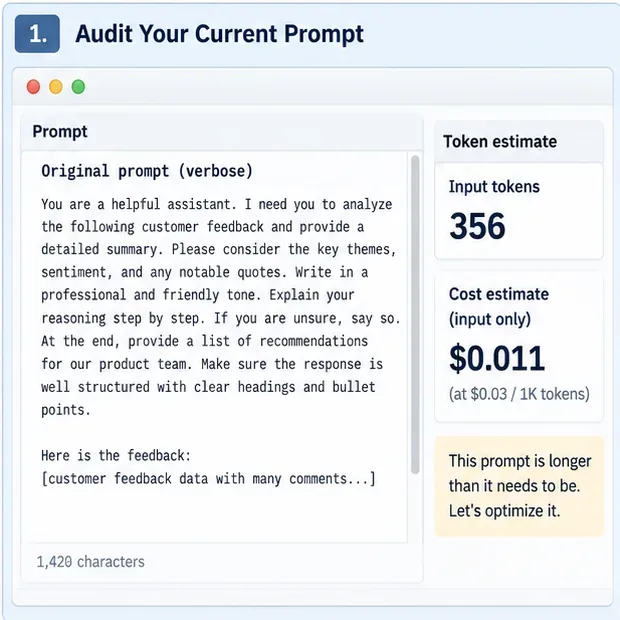
キャプション:説明用のトークン監査インターフェースは、圧縮前の元のプロンプトサイズとサンプルコスト見積もりを記録します。数値は現在のプロバイダー料金ではありません。
手作業で選んだ1つのプロンプトを最適化するのではなく、本番リクエストの代表的なサンプルを収集します。最低限、入力トークン、利用可能な場合はキャッシュされた入力トークン、出力トークン、モデル名、レイテンシ、リトライ、および最終的な回答がビジネス品質チェックを通過したかどうかを記録します。プロバイダーが入力トークンカウントエンドポイントを提供している場合、確定的な予算管理が必要な場合はリクエスト送信前にそれを使用してください。OpenAIは現在、公式APIリファレンスでResponses入力トークンカウントエンドポイントを文書化しています。
API呼び出しあたりのコストだけでなく、タスク成功あたりのコストを計算します。リトライを増やす圧縮プロンプトは、各リクエストが短くても、より高コストになる可能性があります。ベースラインをタスクタイプ別にもセグメント化します。要約、抽出、RAG質問応答、エージェント型ツール使用、長い会話などは、通常異なるトークンプロファイルを持っています。

キャプション:説明用の前後比較プロンプトは、繰り返しの表現と不要なプロセス指示を削除しながら、同じ要求された出力を保持します。
最も安全な最初の圧縮パスは、意味的な重複排除です。繰り返される役割の説明、重複する制約、丁寧なフィラー、明白なフォーマットの説明、同じパターンを複数回教える例を削除します。重複するルールを単一の指示に統合します。同じ要件を繰り返す複数の文よりも、1つの精密な文を優先します。
You are a helpful assistant who is an expert in product analysis.
I need you to analyze the following customer feedback and provide
a detailed summary. Please identify the key themes, overall sentiment,
notable quotes, and recommendations for our product team. Make sure
your response is professional, clear, concise, and well structured.
Analyze the customer feedback.
Return: key themes, overall sentiment, notable quotes, and product recommendations.
Be concise and factual.
例外、ポリシー境界、ドメイン定義、ツール安全ルール、または証拠要件を、単に長いという理由だけで圧縮して削除しないでください。これらはしばしば高価値のトークンです。有用なテストは、「この文を削除すると、許容される出力が変化する可能性があるか?」と尋ねることです。はいの場合、APIコントロールやスキーマで同じ挙動をより確実に強制できない限り、それを保持してください。
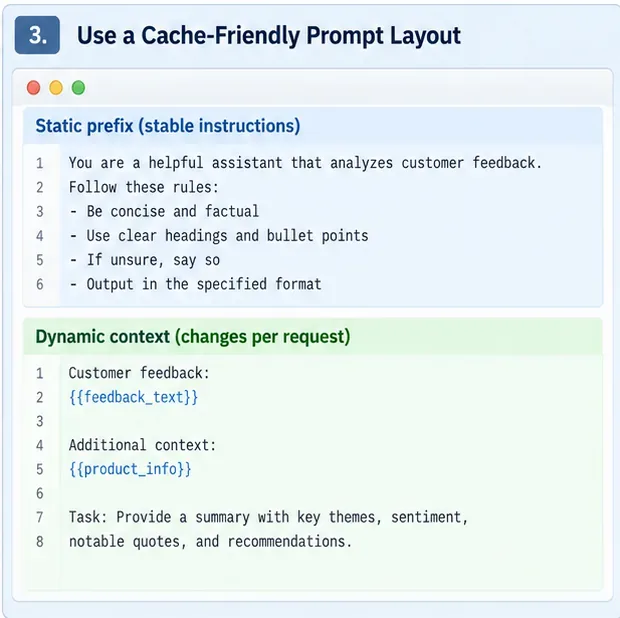
キャプション:説明用のプロンプトレイアウトは、安定した指示を再利用可能なプレフィックスに配置し、リクエスト固有のコンテキストを後方に追加します。
プロンプトキャッシュは生のトークン数を削減しませんが、通常の入力レートで課金される金額を削減し、プロンプト処理のレイテンシを低減できます。これにより、プロンプトレイアウトはコスト最適化の一部となります。システム指示、共有例、ツールガイダンス、その他の安定したコンテンツを一緒にグループ化します。リクエスト固有の事実、取得されたパッセージ、ユーザーデータ、現在の質問を後方に配置します。
OpenAIのモデルガイダンスは、プロンプトキャッシュの再利用を改善するために静的コンテンツを最初に、動的コンテンツを最後に配置することを明示的に推奨しており、そのレスポンス使用状況オブジェクトは測定のためのキャッシュトークン情報を開示します。公式モデルガイダンスとResponses APIリファレンスを参照してください。
プロバイダーのキャッシュセマンティクスがこれらの変更が安全であると述べていない限り、それ以外の場合は再利用可能なプレフィックス内で無害な空白、例の順序、タイムスタンプ、ランダムID、またはユーザーごとのテキストを変更しないでください。プロンプトが再利用されていると仮定するのではなく、APIレスポンスからキャッシュヒットを測定してください。
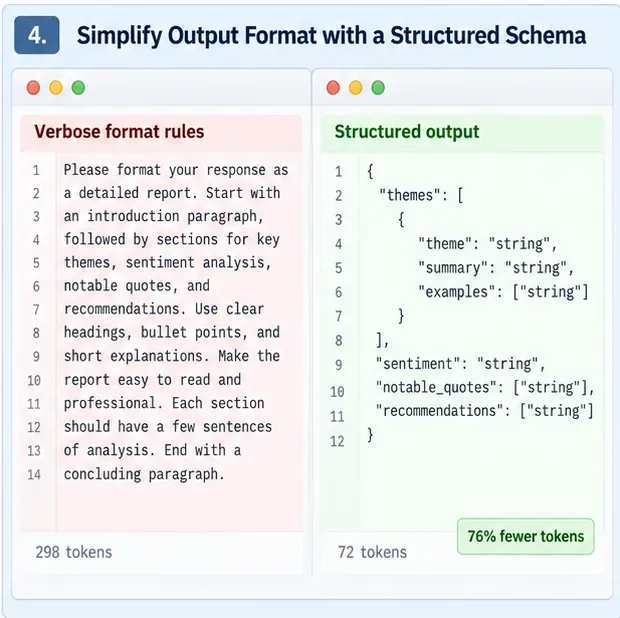
キャプション:説明用の構造化出力ビューは、同じレスポンス形状を繰り返し説明する多くの散文行をスキーマがどのように置き換えるかを示します。
抽出および分類プロンプトは、自然言語でJSONフィールド、許可値、ネスト、順序、検証ルールを説明するためにトークンを無駄にすることがよくあります。APIが構造化出力または型付きツール引数をサポートしている場合、その契約の可能な限り多くを構造化インターフェースに移行し、自然言語の指示は意味に焦点を当ててください。
現在のOpenAIガイダンスは、可能な限りプロンプトから出力スキーマ定義を削除し、代わりに構造化出力を使用することを特に推奨しています。これにより、プロンプトテキストを削減し、不正な出力のリトライを削減することもできます。正確なメカニズムはプロバイダーによって異なるため、そのプロバイダーのドキュメントを確認せずに、OpenAI固有のリクエスト形式を別のAPIにコピーしないでください。
4つの基本ステップが安定した後、より大きな削減は通常、文の言い回しを磨くことよりも、コンテキストを削減することから得られます。RAGシステムでは、より関連性の高いパッセージをより少なく取得し、ほぼ同一のチャンクの重複を排除し、回答に影響を与えられないドキュメントの添付を避けます。長い会話では、永続的な事実と未解決の決定事項を保持しますが、現在のタスクに影響を与えなくなったターンを要約または削除します。エージェントシステムでは、アーキテクチャが安全に許容する場合、現在の段階に関連するツールとツール説明のみを公開します。
学習されたプロンプト圧縮器は、非常に長いコンテキストのための別のオプションです。MicrosoftのオープンソースLLMLinguaプロジェクトは、トークンレベルのプロンプト圧縮を実装しています。元のLLMLingua論文は、評価された設定において限られたベンチマーク劣化で最大20倍の圧縮率を報告しました。LongLLMLinguaは長いコンテキストタスクを対象としており、LLMLingua-2はタスクに依存しない学習された圧縮器を使用します。これらは研究結果であり、同じ比率があなたのデータで品質を維持するという約束ではありません。積極的な圧縮を展開する前に、独自のタスク、言語、モデル、プロンプトタイプでベンチマークを実行してください。
同じ代表的なリクエストでA/B評価を実行します。ベースラインと圧縮バージョンは、同じモデル、推論設定、ツール、検索入力、成功基準を使用する必要があります。退行の原因を特定できるように、可能な限り一度に1つの圧縮技術を変更します。
| 指標 | 重要な理由 | 推奨される解釈 |
|---|---|---|
| 入力トークン削減 | 生のプロンプトの縮小を示す | 有用ですが、それ自体では不十分 |
| キャッシュトークン比率 | 安定したプレフィックスが再利用されているかどうかを示す | 品質が変更されない場合、高いほど通常良い |
| 出力トークン削減 | 総コストを大幅に変える可能性がある | 簡潔な出力が依然としてタスクを完了することを確認する |
| タスク成功あたりのコスト | リトライと失敗を含む | これが主要なビジネス指標です |
| タスクの成功/精度 | 情報の損失を検出する | テスト前に許容される非劣性閾値を設定する |
| p50およびp95レイテンシ | 実際のユーザーへの影響を示す | 圧縮前処理は推論の節約を相殺する可能性がある |
プロンプトが50%短くなったからといって勝利を宣言しないでください。より強い受け入れ条件は、圧縮設定が、事前に定義された品質、レイテンシ、信頼性の許容範囲内に留まりながら、測定されたコストを目標量まで削減することです。
次の削減が正しい決定に必要な事実を削除する場合、幻覚を増やす場合、ツール呼び出しエラーを引き起こす場合、ポリシー遵守を弱める場合、または節約を消し去るほどリトライを増やす場合は、停止またはバックオフしてください。各プロンプトを圧縮するために別のモデルを実行する場合、圧縮はレイテンシを追加することもあります。実際の推論環境におけるプロンプト圧縮に関する2026年の研究は、有利なプロンプト長とハードウェアの領域外では、前処理オーバーヘッドが推論の利得を打ち消す可能性があることを発見しました。これは、トークン数だけでなく、エンドツーエンドのパフォーマンスを測定するもう一つの理由です。
小さなプロンプトの場合、手動のクリーンアップとキャッシュに優しい整理は、専用の圧縮モデルを追加するよりも正当化しやすいことが一般的です。大きなRAGペイロードやマルチドキュメントワークフローの場合、削除可能なトークン量がはるかに大きいため、コンテキスト選択と学習された圧縮がより魅力的になります。
50%の削減は、一部の冗長でコンテキストの多いワークロードにとって合理的なエンジニアリング目標ですが、デフォルトの期待値ではなく、検証すべき結果として扱う必要があります。最も信頼できる道は、最初に測定し、意味的に冗長なテキストを削除し、安全なキャッシュ再利用を最大化し、構造化コントロールで出力契約を短縮し、その後、検索プルーニング、要約、またはテスト済みのプロンプト圧縮器で残りの最大のコンテキストブロックに対処することです。品質が受け入れ帯域内に留まったまま、最終的なタスク成功あたりのコストが低下する場合、圧縮は機能しています。品質またはリトライが悪化する場合、欠落した情報を復元し、リクエストの別の部分を最適化してください。
タスクの所有権、依存関係、委任、再試行、フローのトリガー、状態の永続性、キャッシュ、冪等性を修正することで、CrewAIエージェントが作業を繰り返すのを防ぎます。
米国フリーランス業務向けの個人事業主経費トラッカーを作成します。IRS対応のカテゴリー、領収書記録、2026年のマイル単価、税務レビューフラグを含みます。
労働時間計算機能、深夜シフト用数式、週次合計、品質チェック、明確な制限事項を備えた、Excelで無料の従業員シフト表を作成する方法。
テーブル、ドロップダウン、フォローアップアラート、シンプルなパイプラインサマリーを活用した実用的なExcelリードトラッカーの構築方法と、CRMへ移行すべきタイミングの明確なサインについて解説します。
サービス履歴、期限、ダウンタイム、コスト、検査記録、明確な安全基準を含む、ワークショップ資産のための実用的なエクセル設備保守記録を作成します。
Compare HubSpot Free CRM and Zoho CRM Free for solo real estate agents, including contact limits, pipelines, email, automation, mobile tools, and upgrade tradeoffs.
LM Studioを使ってWindows 11でDeepSeekをローカル実行する方法。通常のPCに最適なモデルの選び方、ダウンロードと読み込み手順、オフライン動作の確認、よくある問題の解決策を解説します。
4つの実践的なプロンプト圧縮技術、キャッシュに優しいレイアウト、構造化出力、品質を維持する評価計画を用いて、LLM APIのコストを削減します。
セルフホスト型のn8nとClaudeを使用して、構造化出力、レビューゲート、現実的なAPIコストガイダンスを備えた、ホスティング無料のAIコンテンツ再利用パイプラインを構築します。
タイムライン、ベンダー管理、見積もりと実際の費用比較、支払い、当日のタスクを含む、Word用の実用的な印刷可能なイベント企画チェックリストと予算テンプレートを活用しましょう。







