CrewAIエージェントによる重複タスクの実行を停止する方法:実践的な重複排除ガイド

タスクの所有権、依存関係、委任、再試行、フローのトリガー、状態の永続性、キャッシュ、冪等性を修正することで、CrewAIエージェントが作業を繰り返すのを防ぎます。
はい、LM Studioを使用すればWindows 11でDeepSeekを完全にオフラインで実行できますが、最初に一度だけオンラインでのセットアップが必要です。LM Studioをインストールし、互換性のあるDeepSeekモデルと必要なランタイムをダウンロードして、一度モデルを読み込めば、その後インターネットから切断できます。LM Studioの公式オフラインドキュメントによると、ダウンロード済みモデルとのチャット、ローカルドキュメントとのチャット、ローカルサーバーの実行にはインターネット接続が必要ありません。
一般的なWindows 11 PCの場合、最も現実的な出発点は、現在の最大のDeepSeekモデルではありません。DeepSeek-R1-0528-Qwen3-8Bのような小型のGGUFモデルの方が、ローカルでの実行がはるかに容易です。LM Studioは2025年5月にこの8B蒸留モデルのサポートを発表し、LM Studio 0.3.16以降でGGUF形式として動作すると述べています。一方、LM Studioの2026年8月のDeepSeek V4 Flashに関するガイダンスでは、ローカル使用には約156GBのシステムメモリが必要だとされています。V4 Flashはより新しく高性能ですが、ほとんどのコンシューマー向けWindowsマシンには適していません。
このガイドは2026年9月11日に確認されました。LM Studioの更新履歴には、2026年9月9日付のバージョン0.4.24が記載されています。LM Studioのインターフェースは進化するため、ビルドによってボタンの位置がわずかに変わる可能性がありますが、モデルのダウンロード、読み込み、ローカルでのチャット、必要に応じてlocalhost APIの公開というコアワークフローは、LM Studioによって継続的にドキュメント化されています。
LM Studioは現在、x64 Windows PCとARMベースのWindowsシステムの両方をサポートしています。x64の場合、CPUはAVX2をサポートしている必要があります。LM Studioは、少なくとも16GBのRAMと、少なくとも4GBの専用VRAMを推奨しています。これらはアプリケーションレベルの推奨事項であり、すべてのモデルが適合する保証ではありません。モデルサイズ、量子化、コンテキスト長、GPUオフロードはすべてメモリ使用量に影響します。
| 現在の環境 | 実用的な推奨事項 | 理由 |
|---|---|---|
| 16GB RAM、中程度のGPUまたは統合グラフィックス | 4ビットGGUFバリアントの8B以下のDeepSeek蒸留モデルから開始する | 有用な推論能力を維持しながら、モデルのフットプリントを比較的 manageable に保つことができます。 |
| より多くのRAMと強力なGPU | LM Studioのデバイス適合性推定値を確認した後にのみ、より大きな蒸留バリアントを試す | より大きなモデルは品質を向上させる可能性がありますが、メモリを大幅に消費し、動作が非常に遅くなる可能性があります。 |
| 通常のゲーミングPCまたはノートPC | DeepSeek V4 Flashから開始しないでください | LM Studioによると、ローカルV4 Flashモデルには少なくとも156GBのシステムメモリが必要です。 |
LM Studioのモデルダウンロードドキュメントでは、量子化ビルドがいくつかの忠実度と引き換えに、より小さなファイルと低いメモリ圧力を実現することを説明しています。ハードウェアが対応できる場合、4ビット以上のオプションを選択することが一般的な推奨事項です。不明な場合は、4ビットGGUFバージョンが妥当な最初のテストです。
公式参照:LM Studioシステム要件、LM Studioモデルダウンロードガイド、およびLM Studio更新履歴。
公式LM Studioダウンロードページから現在の安定版Windowsビルドをダウンロードします。Windowsアーキテクチャに一致するインストーラーを使用してください。x64 PCの場合、後でモデル読み込みエラーのトラブルシューティングを行う前に、プロセッサがAVX2をサポートしていることを確認してください。
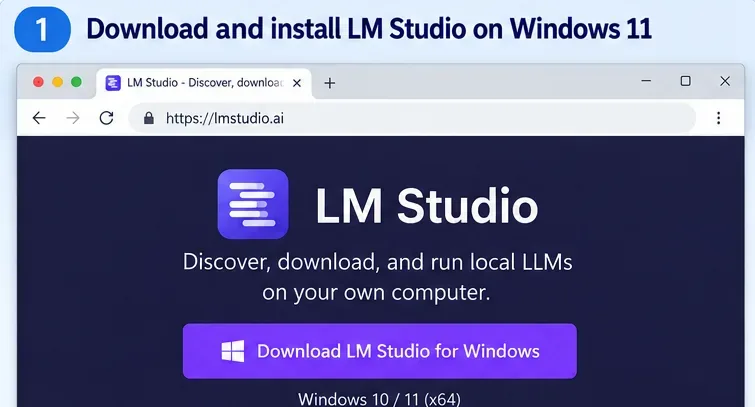
インターネット接続がある状態でLM Studioを起動します。これは、アプリがLM Runtimeをダウンロードまたは更新する必要がある場合があるため重要です。LM Studioは、ランタイムをパッケージ化された推論エンジン(GGUFモデル用のllama.cppベースのランタイムなど)として説明しています。推論はその後オフラインで動作できますが、ランタイムのダウンロードには接続が必要です。
LM StudioのDiscoverエリアを開き、DeepSeekを検索します。LM Studioは、キーワード、user/model識別子、または完全なHugging Face URLによって、サポートされているHugging Faceモデルを検索できます。
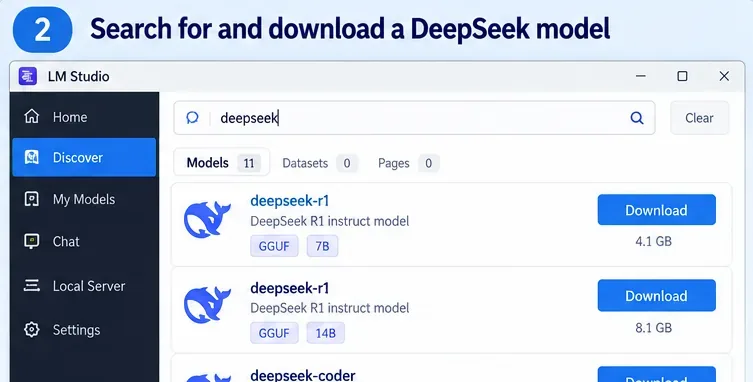
このガイドに従うほとんどの人は、DeepSeek-R1-0528-Qwen3-8Bから開始してください。LM Studioによると、この蒸留8Bモデルは推論とツール使用をサポートし、GGUFとして利用可能で、フラッグシップDeepSeekモデルよりもはるかに少ないメモリで実行できます。LM StudioのWindowsガイダンスでは、アプリケーション全体で16GBのRAMを依然として推奨しているため、モデル固有の低メモリ主張を快適なシステム全体の目標として扱わないでください。
DeepSeekはまた、1.5B、7B、8B、14B、32B、70Bパラメータの以前のR1蒸留バリアントもリリースしています。これらは、速度とメモリ使用量を能力と引き換える余地を提供します。モデルファミリーとライセンスの詳細については公式DeepSeek-R1リポジトリを、8BオプションについてはLM StudioのDeepSeek-R1-0528ローカル実行ノートを参照してください。
DeepSeek V4 Flashが新しいことに惹かれる場合は、まずハードウェア要件を確認してください。LM Studioの公式V4 Flash記事によると、284B Mixture-of-Expertsモデルはローカル使用に少なくとも156GBのシステムメモリが必要です。これは高メモリワークステーションでは実行可能ですが、通常のWindowsノートPCではありません。
ダウンロードが完了したら、ダウンロード済みモデルに移動するか、Chatからモデルローダーを開きます。DeepSeekモデルを選択して読み込みます。LM Studioは、モデルの読み込みがモデル重みと関連するランタイム状態のためのメモリを割り当てることを説明しています。
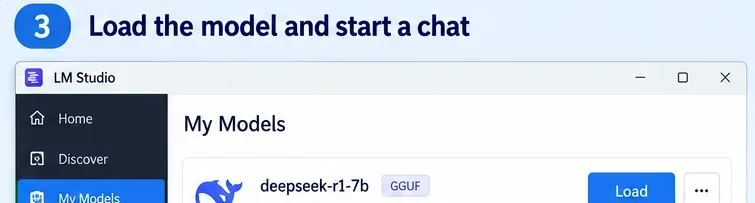
初回実行では、読み込み設定を保守的に保ってください。非常に大きなコンテキストウィンドウは追加のメモリを大量に消費する可能性があるため、すぐにコンテキストを最大化する理由はありません。適度なコンテキストでモデルを読み込み、動作を確認し、ワークロードが必要とする場合にのみ拡張してください。
LM Studioがモデルが適合しないと報告する場合、最も信頼できる修正は通常、より小さなモデルまたはよりコンパクトな量子化を選択することです。メモリを大量に消費するアプリケーションを閉じると役立ちますが、根本的なモデルフットプリントは変わりません。
これは「ローカルモデル」と単なる「デスクトップクライアントの使用」を区別するステップです。モデルとそのランタイムがインストールされたら、Wi-Fiをオフにし、Ethernetを切断します。その後、新しいチャットを開始し、次のような簡単なプロンプトを送信します:
Explain the difference between RAM and VRAM in five bullet points.PCにネットワーク接続がない状態でモデルが応答する場合、推論はローカルです。LM Studioは、LLMがマシン上にあれば完全にオフラインで実行でき、ローカルLLMチャットに入力されたテキストはデバイスから出ないと述べています。そのオフラインドキュメントはまた、ローカルドキュメント処理とRAGがマシン上に留まることも述べています。

重要な境界線があります:モデルの検索、新しいモデルのダウンロード、ランタイムのダウンロード、アプリの更新チェックにはインターネットアクセスが必要です。後でクラウドモデル、リモートMCPサーバー、ウェブツール、またはその他のネットワーク統合を追加する場合、これらの機能も接続を必要とする可能性があります。オフラインプライバシーの主張は、ローカルワークフローに適用され、後で意図的に接続するサービスには適用されません。
LM Studioはこれらの境界線を公式オフライン操作ガイドにドキュメント化しています。
別のWindowsアプリケーション、スクリプト、IDE拡張機能、または内部ツールがローカルDeepSeekモデルを呼び出すようにしたい場合、LM Studioはローカルサーバーを実行できます。現在の開発者ドキュメントによると、Developerページから、または次のコマンドで開始できます:
lms server startデフォルトでは、サーバーはhttp://localhost:1234で利用可能です。LM StudioはネイティブRESTエンドポイントとOpenAI互換エンドポイントを提供します。モデルとランタイムがすでにローカルにある限り、サーバー自体はオフラインで動作できます。ただし、サーバーをlocalhostの外に公開する場合は、まず認証とネットワークアクセス設定を確認してください。
現在のエンドポイントと認証の詳細については、公式LM Studio REST APIクイックスタートを参照してください。
| 問題 | 考えられる原因 | 対処法 |
|---|---|---|
| モデルが読み込まれない | RAM/VRAM不足、過大なコンテキスト、またはサポートされていないCPU/ランタイム | より小さなDeepSeekモデル、より小さな量子化、またはより低いコンテキスト長を試してください。x64 Windowsでは、AVX2サポートを確認してください。 |
| LM Studioはオンラインで動作するが、切断後は動作しない | モデルまたは必要なランタイムが完全にダウンロードされていない | 一度再接続し、すべてのモデル/ランタイムダウンロードを完了し、モデルを正常に読み込んでから、オフラインテストを繰り返してください。 |
| 生成が非常に遅い | モデルが利用可能なGPUアクセラレーションに対して大きすぎ、CPU/システムメモリに大きく依存している | より小さなモデルまたは量子化を選択してください。レイテンシによりワークフローが実用的でなくなる場合、より大きなモデルは有用ではありません。 |
| オフライン中にモデルが見つからない | Discover検索にはネットワークアクセスが必要 | オフラインになる前にモデルをダウンロードするか、別の制御されたプロセスで取得したモデルファイルをサイドロードしてください。 |
| V4 Flashが通常のノートPCで動作すると思っていた | そのローカルメモリ要件はワークステーションクラス | マシンに約156GB以上のシステムメモリがない限り、代わりにR1蒸留モデルを使用してください。 |
LM StudioでDeepSeekをオフラインで実行することは、プライベートなローカル推論、モデルダウンロード後の予測可能なコスト、APIキーなしでの実験、または開発用のlocalhost APIを望む場合に非常に適しています。また、マシンがインターネットアクセスなしで動作し続ける必要がある場合にも有用です。
コンシューマーハードウェアしか持たずに最も強力なDeepSeekモデルが必要な場合、極めて高いスループットが必要な場合、またはワークロードがライブウェブ情報に依存している場合は、適していません。ローカルモデルは、外部ツールやデータソースを意図的に接続しない限り、その重みと提供されたコンテキストにあるもののみを知っています。
Windows 11でDeepSeekをオフラインで実行する最も簡単な方法は、LM Studioと、実際のハードウェアに適合するより小さなGGUF DeepSeekモデルを組み合わせることです。通常のPCの場合、R1蒸留8Bクラスモデルは、DeepSeek V4 Flashよりもはるかに現実的な出発点です。オンライン中にダウンロードを完了し、モデルを読み込み、ネットワークを切断し、新しいチャットがまだ応答することを確認してください。これが機能すれば、クラウドAPIのデスクトップラッパーではなく、真にローカルなDeepSeekセットアップが得られます。
タスクの所有権、依存関係、委任、再試行、フローのトリガー、状態の永続性、キャッシュ、冪等性を修正することで、CrewAIエージェントが作業を繰り返すのを防ぎます。
米国フリーランス業務向けの個人事業主経費トラッカーを作成します。IRS対応のカテゴリー、領収書記録、2026年のマイル単価、税務レビューフラグを含みます。
労働時間計算機能、深夜シフト用数式、週次合計、品質チェック、明確な制限事項を備えた、Excelで無料の従業員シフト表を作成する方法。
テーブル、ドロップダウン、フォローアップアラート、シンプルなパイプラインサマリーを活用した実用的なExcelリードトラッカーの構築方法と、CRMへ移行すべきタイミングの明確なサインについて解説します。
サービス履歴、期限、ダウンタイム、コスト、検査記録、明確な安全基準を含む、ワークショップ資産のための実用的なエクセル設備保守記録を作成します。
Compare HubSpot Free CRM and Zoho CRM Free for solo real estate agents, including contact limits, pipelines, email, automation, mobile tools, and upgrade tradeoffs.
LM Studioを使ってWindows 11でDeepSeekをローカル実行する方法。通常のPCに最適なモデルの選び方、ダウンロードと読み込み手順、オフライン動作の確認、よくある問題の解決策を解説します。
4つの実践的なプロンプト圧縮技術、キャッシュに優しいレイアウト、構造化出力、品質を維持する評価計画を用いて、LLM APIのコストを削減します。
セルフホスト型のn8nとClaudeを使用して、構造化出力、レビューゲート、現実的なAPIコストガイダンスを備えた、ホスティング無料のAIコンテンツ再利用パイプラインを構築します。
タイムライン、ベンダー管理、見積もりと実際の費用比較、支払い、当日のタスクを含む、Word用の実用的な印刷可能なイベント企画チェックリストと予算テンプレートを活用しましょう。







