Mengurangkan bil API LLM sebanyak 50% adalah mungkin dalam banyak beban kerja, tetapi ia bukan jaminan universal. Hasilnya bergantung kepada sumber perbelanjaan anda: token input tanpa cache, token input ber-cache, token output, token penalaran, panggilan alat, atau percubaan semula. Pemampatan prompt paling berkesan apabila input yang panjang atau berulang merupakan bahagian signifikan daripada bil tersebut. Oleh itu, matlamat praktikalnya bukanlah "menjadikan setiap prompt separuh lebih pendek." Sebaliknya, ia adalah "menghapuskan token yang tidak mengubah jawapan, mengekalkan token yang mengubahnya, dan mengesahkan penjimatan tersebut pada trafik sebenar."
Panduan ini menggunakan empat langkah pelaksanaan: mengukur garis dasar, menghapuskan input yang berlebihan, menyusun prompt untuk penggunaan semula cache, dan memindahkan arahan output yang panjang kepada kawalan berstruktur jika API menyokongnya. Contoh yang diberikan adalah bersifat ilustratif dan bukan dakwaan penanda aras. Harga pembekal dan tingkah laku cache berubah dari semasa ke semasa, jadi sahkan kadar semasa sebelum membuat anggaran pengeluaran.
Apakah yang diperlukan untuk pengurangan kos API sebanyak 50%?
Mulakan dengan persamaan pengebilan untuk model anda. Untuk beban kerja teks yang ringkas, jumlah kos permintaan adalah kira-kira kos input tanpa cache ditambah input ber-cache ditambah output. Sesetengah model atau ciri menambah kategori boleh caj lain. Respons API OpenAI semasa mendedahkan penggunaan token input dan output, termasuk butiran token ber-cache, dan halaman model mereka menerbitkan kadar berasingan untuk input, input ber-cache, dan output.
| Beban kerja ilustratif | Token input | Token output | Hasil relatif |
|---|
| Permintaan garis dasar | 10,000 | 1,000 | 100% daripada kos garis dasar |
| Hanya input dipotong separuh | 5,000 | 1,000 | Jimatan jumlah kurang daripada 50% apabila output tidak berubah |
| Input dan output kedua-duanya dipotong separuh | 5,000 | 500 | Kos berasaskan token kira-kira 50% lebih rendah apabila kadar tidak berubah |
Untuk contoh semasa yang konkrit, halaman model rasmi GPT-5.6 Sol menyenaraikan, pada 11 September 2026, $4 setiap juta token input, $0.40 setiap juta token input ber-cache, dan $20 setiap juta token output. Pada kadar tersebut, permintaan dengan 10,000 input/1,000 output menelan kos kira-kira $0.06 sebelum yuran lain. Memotong input sahaja kepada 5,000 token membawa contoh tersebut kepada kira-kira $0.04, iaitu pengurangan 33%. Memotong kedua-dua input dan output sebanyak separuh membawanya kepada kira-kira $0.03, iaitu pengurangan 50%. Harga ini boleh berubah, jadi anggap pengiraan ini sebagai kaedah, bukan sebut harga kekal. Lihat halaman model rasmi GPT-5.6 Sol untuk harga semasa.
Rujukan pantas: empat langkah bernilai tertinggi
| Teknik | Padanan terbaik | Risiko utama | Apa yang perlu diukur |
|---|
| Audit token | Sebarang beban kerja pengeluaran | Mengoptimumkan komponen yang salah | Input, input ber-cache, output, percubaan semula, kos setiap tugas berjaya |
| Penghapusan redundansi | Prompt sistem yang panjang, dasar berulang, contoh yang panjang | Menghapuskan kekangan yang sebenarnya penting | Kejayaan tugas dan kesetaraan pematuhan arahan |
| Susunan atur mesra cache | Permintaan berulang yang berkongsi arahan atau konteks stabil | Penggunaan semula cache rendah kerana teks dinamik muncul terlalu awal | Nisbah token ber-cache dan latensi |
| Kawalan output berstruktur | Pengekstrakan JSON, pengelasan, format respons tetap | Skema terlalu ketat untuk tugas tersebut | Token output, kegagalan penghuraian, percubaan semula |
Langkah 1: Ukur garis dasar token sebenar sebelum mengubah prompt
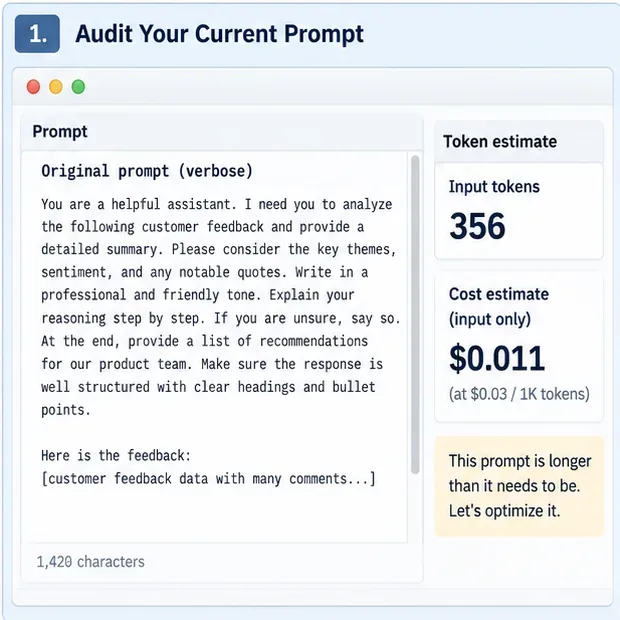
Kapsyen: Antara muka audit token ilustratif merekodkan saiz prompt asal dan anggaran kos sampel sebelum pemampatan; angka tersebut bukan harga pembekal semasa.
Kumpulkan sampel permintaan pengeluaran yang mewakili dan bukan hanya mengoptimumkan satu prompt yang dipilih secara manual. Sekurang-kurangnya, rekodkan token input, token input ber-cache jika tersedia, token output, nama model, latensi, percubaan semula, dan sama ada jawapan akhir lulus pemeriksaan kualiti perniagaan anda. Jika pembekal anda menawarkan hujung pengiraan token input, gunakannya sebelum menghantar permintaan apabila anda memerlukan penganggaran belanjawan yang deterministik. OpenAI kini mendokumentasikan hujung pengiraan token input Respons dalam rujukan API rasminya.
Kira kos setiap tugas berjaya, bukan hanya kos setiap panggilan API. Prompt termampat yang menyebabkan lebih banyak percubaan semula boleh menjadi lebih mahal walaupun setiap permintaan lebih pendek. Segmenkan garis dasar mengikut jenis tugas juga: peringkasan, pengekstrakan, soal jawab RAG, penggunaan alat agen, dan perbualan panjang biasanya mempunyai profil token yang berbeza.
Langkah 2: Hapuskan redundansi tanpa menghapuskan maklumat kritikal keputusan

Kapsyen: Prompt sebelum dan selepas ilustratif mengekalkan output yang diminta sama sambil menghapuskan perkataan berulang dan arahan proses yang tidak perlu.
Laluan pemampatan pertama yang paling selamat ialah penyahpenduplikatan semantik. Hapuskan penerangan peranan yang berulang, kekangan yang diduplikasi, pengisi sopan, penjelasan format yang jelas, dan contoh yang mengajar corak yang sama lebih daripada sekali. Gabungkan peraturan yang bertindih menjadi satu arahan. Utamakan satu ayat yang tepat berbanding beberapa ayat yang menyatakan semula keperluan yang sama.
Sebelum
Anda adalah pembantu yang membantu dan pakar dalam analisis produk.
Saya memerlukan anda menganalisis maklum balas pelanggan berikut dan memberikan
ringkasan terperinci. Sila kenal pasti tema utama, sentimen keseluruhan,
petikan yang ketara, dan cadangan untuk pasukan produk kami. Pastikan
respons anda profesional, jelas, ringkas, dan tersusun dengan baik.
Sepuluh
Analisis maklum balas pelanggan.
Pulangkan: tema utama, sentimen keseluruhan, petikan yang ketara, dan cadangan produk.
Jadilah ringkas dan faktual.
Jangan mampatkan sehingga hilang pengecualian, sempadan dasar, definisi domain, peraturan keselamatan alat, atau keperluan bukti hanya kerana ia panjang. Itu selalunya token bernilai tinggi. Ujian yang berguna ialah bertanya: "Jika saya membuang ayat ini, bolehkah output yang diterima berubah?" Jika ya, kekalkannya melainkan kawalan API atau skema boleh menguatkuasakan tingkah laku yang sama dengan lebih boleh dipercayai.
Langkah 3: Letakkan kandungan stabil dahulu dan kandungan dinamik terakhir
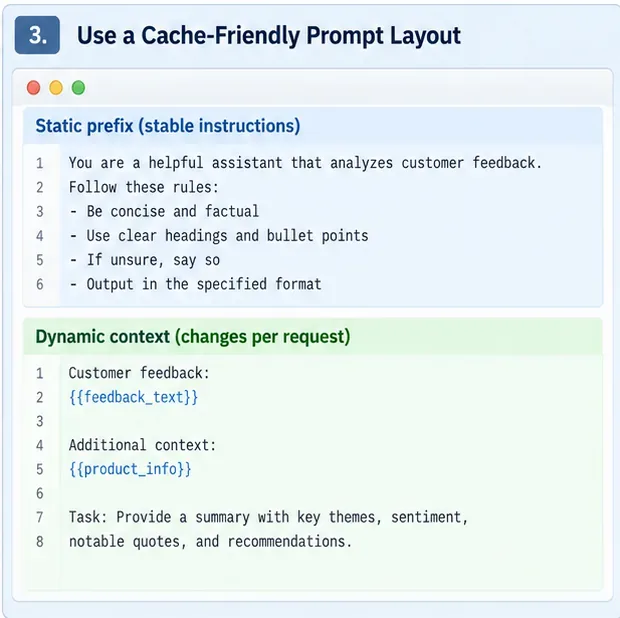
Kapsyen: Susun atur prompt ilustratif meletakkan arahan stabil dalam awalan boleh guna semula dan menambah konteks khusus permintaan kemudian.
Cache prompt tidak mengurangkan bilangan token mentah, tetapi ia boleh mengurangkan jumlah yang dicaj pada kadar input biasa dan menurunkan latensi pemprosesan prompt. Ini menjadikan susun atur prompt sebahagian daripada pengoptimuman kos. Kumpulkan arahan sistem, contoh berkongsi, panduan alat, dan kandungan stabil lain bersama-sama. Letakkan fakta khusus permintaan, petikan yang diperoleh, data pengguna, dan soalan semasa kemudian.
Panduan model OpenAI secara eksplisit mengesyorkan meletakkan kandungan statik dahulu dan kandungan dinamik terakhir untuk meningkatkan penggunaan semula cache prompt, dan objek penggunaan responsnya mendedahkan maklumat token ber-cache untuk pengukuran. Lihat panduan model rasmi dan rujukan API Respons.
Elakkan mengubah ruang kosong yang tidak berbahaya, susunan contoh, cap masa, ID rawak, atau teks setiap pengguna dalam awalan yang boleh digunakan semula melainkan semantik cache pembekal menyatakan bahawa perubahan tersebut selamat. Ukur hit cache daripada respons API dan bukan mengandaikan prompt sedang digunakan semula.
Langkah 4: Gantikan prosa tentang format dengan kawalan output berstruktur
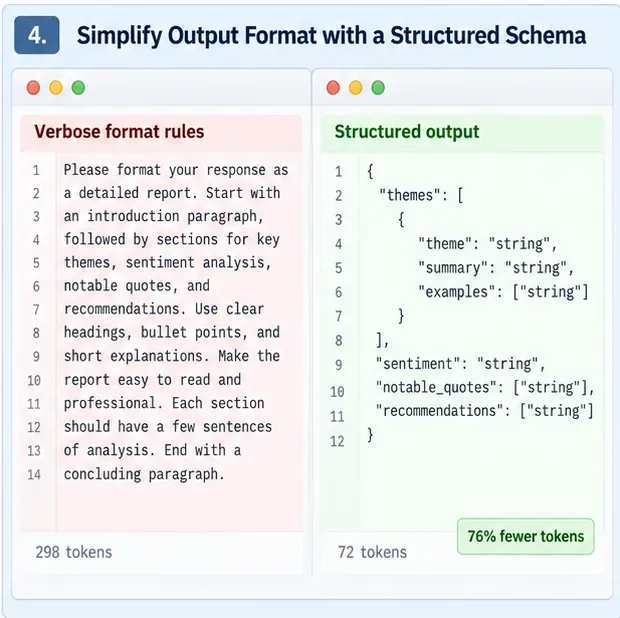
Kapsyen: Paparan output berstruktur ilustratif menunjukkan bagaimana skema boleh menggantikan banyak baris prosa yang berulang kali menerangkan bentuk respons yang sama.
Prompt pengekstrakan dan pengelasan sering membazirkan token dengan menerangkan medan JSON, nilai yang dibenarkan, penyarang, susunan, dan peraturan pengesahan dalam bahasa tabii. Apabila API menyokong output berstruktur atau hujah alat bertipe, pindahkan sebanyak mungkin kontrak tersebut ke antara muka berstruktur dan kekalkan arahan bahasa tabii fokus pada makna.
Panduan OpenAI semasa secara khusus mengesyorkan membuang definisi skema output daripada prompt jika boleh dan menggunakan Output Berstruktur sebaliknya. Ini boleh mengurangkan teks prompt dan juga mengurangkan percubaan semula output tidak betul. Mekanisme tepat berbeza mengikut pembekal, jadi jangan salin format permintaan khusus OpenAI ke API lain tanpa menyemak dokumentasi pembekal tersebut.
Pemampatan lanjutan untuk RAG, dokumen panjang, dan perbualan
Selepas empat langkah asas stabil, penjimatan yang lebih besar biasanya datang daripada mengurangkan konteks dan bukan mengilatkan perkataan ayat. Dalam sistem RAG, dapatkan lebih sedikit tetapi petikan yang lebih relevan, nyahpenduplikasi potongan yang hampir sama, dan elakkan melampirkan dokumen yang tidak boleh mempengaruhi jawapan. Untuk perbualan panjang, kekalkan fakta kekal dan keputusan yang belum selesai, tetapi ringkaskan atau buang giliran yang tidak lagi mempengaruhi tugas semasa. Untuk sistem agen, dedahkan hanya alat dan penerangan alat yang relevan dengan peringkat semasa apabila seni bina anda selamat membenarkannya.
Pemampat prompt yang dipelajari ialah pilihan lain untuk konteks yang sangat panjang. Projek sumber terbuka Microsoft LLMLingua melaksanakan pemampatan prompt peringkat token. Kertas LLMLingua asal melaporkan nisbah pemampatan sehingga 20× dengan degradasi penanda aras yang terhad dalam tetapan yang dinilai. LongLLMLingua menyasarkan tugas konteks panjang, manakala LLMLingua-2 menggunakan pemampat yang dipelajari tanpa mengira tugas. Itu adalah hasil penyelidikan, bukan janji bahawa nisbah yang sama akan mengekalkan kualiti pada data anda. Buat penanda aras untuk tugas, bahasa, model, dan jenis prompt anda sendiri sebelum melaksanakan pemampatan agresif.
Bagaimana membuktikan pengoptimuman itu sebenarnya lebih baik
Jalankan penilaian A/B pada permintaan mewakili yang sama. Versi garis dasar dan termampat harus menggunakan model, tetapan penalaran, alat, input pengambilan, dan kriteria kejayaan yang sama. Ubah satu teknik pemampatan pada satu masa jika boleh supaya anda boleh mengenal pasti apa yang menyebabkan kemunduran.
| Metrik | Mengapa ia penting | Tafsiran yang dicadangkan |
|---|
| Pengurangan token input | Menunjukkan pengecilan prompt mentah | Berguna, tetapi tidak mencukupi dengan sendirinya |
| Nisbah token ber-cache | Menunjukkan sama ada awalan stabil digunakan semula | Lebih tinggi biasanya lebih baik apabila kualiti tidak berubah |
| Pengurangan token output | Boleh mengubah kos jumlah secara material | Sahkan bahawa output ringkas masih menyelesaikan tugas |
| Kos setiap tugas berjaya | Masukkan percubaan semula dan kegagalan | Ini adalah metrik perniagaan utama |
| Kejayaan tugas / ketepatan | Mengesan kehilangan maklumat | Tetapkan ambang bukan inferioriti yang diterima sebelum pengujian |
| Latensi p50 dan p95 | Menunjukkan kesan pengguna sebenar | Prapemprosesan pemampatan boleh mengimbangi penjimatan inferens |
Jangan umumkan kemenangan kerana prompt 50% lebih pendek. Syarat penerimaan yang lebih kuat ialah: konfigurasi termampat mengurangkan kos yang diukur sebanyak jumlah sasaran anda sambil kekal dalam toleransi kualiti, latensi, dan kebolehpercayaan yang telah ditakrifkan sebelumnya.
Bila anda harus berhenti memampatkan?
Berhenti atau kurangkan apabila pengurangan seterusnya menghapuskan fakta yang diperlukan untuk keputusan yang betul, meningkatkan halusinasi, menyebabkan ralat panggilan alat, melemahkan pematuhan dasar, atau meningkatkan percubaan semula sehingga menghapuskan penjimatan. Pemampatan juga boleh menambah latensi jika anda menjalankan model berasingan untuk memampatkan setiap prompt. Kajian 2026 tentang pemampatan prompt dalam tetapan inferens dunia sebenar mendapati bahawa beban prapemprosesan boleh membatalkan keuntungan inferens di luar rejim panjang prompt dan perkakasan yang menguntungkan, yang merupakan sebab lain untuk mengukur prestasi hujung ke hujung dan bukan hanya bilangan token.
Untuk prompt kecil, pembersihan manual dan organisasi mesra cache biasanya lebih mudah dibenarkan daripada menambah model pemampatan khusus. Untuk muatan RAG yang besar atau aliran kerja multi-dokumen, pemilihan konteks dan pemampatan yang dipelajari menjadi lebih menarik kerana jumlah token yang boleh dibuang adalah jauh lebih besar.
Semakan senarai pelaksanaan pantas
- Rekodkan garis dasar pengeluaran dengan input, input ber-cache, output, latensi, percubaan semula, dan kejayaan tugas.
- Hapuskan arahan yang diduplikasi, prosa bernilai rendah, dan contoh redundan terlebih dahulu.
- Kekalkan definisi domain, pengecualian, keperluan bukti, dan kekangan keselamatan.
- Letakkan kandungan prompt stabil sebelum kandungan khusus permintaan dinamik apabila semantik cache memberi ganjaran kepada awalan boleh guna semula.
- Gunakan output berstruktur atau skema alat dan bukan berulang kali menerangkan format respons tetap dalam prosa.
- Untuk RAG, kurangkan konteks tidak relevan dan duplikat sebelum cuba pemampatan peringkat token.
- Hadkan panjang output hanya apabila tugas masih boleh diselesaikan dengan betul.
- Bandingkan kos setiap tugas berjaya, bukan hanya bilangan token prompt.
- Jalankan ujian regresi sebelum dan selepas setiap perubahan pemampatan yang bermakna.
- Semak semula harga pembekal dan peraturan cache setiap kali anda menukar model atau versi API.
Kesimpulan
Pengurangan 50% adalah sasaran kejuruteraan yang munasabah untuk sesetengah beban kerja yang panjang dan sarat konteks, tetapi ia harus dianggap sebagai hasil untuk disahkan, bukan jangkaan lalai. Laluan yang paling boleh dipercayai ialah mengukur dahulu, menghapuskan teks redundan semantik, memaksimumkan penggunaan semula cache yang selamat, memendekkan kontrak output dengan kawalan berstruktur, dan kemudian menyerang blok konteks terbesar yang tinggal dengan pemangkasan pengambilan, peringkasan, atau pemampat prompt yang diuji. Jika kos akhir setiap tugas berjaya jatuh sambil kualiti kekal dalam jalur penerimaan anda, pemampatan itu berfungsi. Jika kualiti atau percubaan semula merosot, pulihkan maklumat yang hilang dan optimumkan bahagian permintaan yang lain.
Rujukan utama








