Halaman Utama
» Domain
»
Cara Menjalankan DeepSeek Secara Luar Talian di Windows 11 dengan LM Studio
Cara Menjalankan DeepSeek Secara Luar Talian di Windows 11 dengan LM Studio
Ya—anda boleh menjalankan DeepSeek sepenuhnya secara luar talian di Windows 11 dengan LM Studio, tetapi anda perlu satu sesi penyediaan dalam talian terlebih dahulu. Pasang LM Studio, muat turun model DeepSeek yang serasi dan masa berjalan yang diperlukan, muatkan model sekali, dan kemudian anda boleh memutuskan sambungan daripada internet. Dokumentasi luar talian rasmi LM Studio menyatakan bahawa berborak dengan model yang dimuat turun, berborak dengan dokumen tempatan, dan menjalankan pelayan tempatannya tidak memerlukan akses internet.
Untuk PC Windows 11 tipikal, titik permulaan yang paling praktikal bukanlah model DeepSeek terbesar semasa. Model GGUF yang lebih kecil seperti DeepSeek-R1-0528-Qwen3-8B jauh lebih mudah dijalankan secara tempatan. LM Studio menerbitkan sokongan untuk model terdistilasi 8B tersebut pada Mei 2025 dan menyatakan ia berfungsi dalam format GGUF dengan LM Studio 0.3.16 atau lebih baru. Sebaliknya, panduan LM Studio pada Ogos 2026 untuk DeepSeek V4 Flash menyatakan penggunaan tempatan memerlukan kira-kira 156GB memori sistem. Ini menjadikan V4 Flash pilihan yang buruk untuk kebanyakan mesin Windows pengguna walaupun ia lebih baru dan lebih mampu.
Panduan ini telah disemak pada 11 September 2026. Log perubahan LM Studio menyenaraikan versi 0.4.24 bertarikh 9 September 2026. Oleh kerana antara muka LM Studio berevolusi, butang mungkin bergerak sedikit antara binaan, tetapi aliran kerja teras—memuat turun model, memuatnya, berborak secara tempatan, dan secara pilihan mendedahkan API localhost—tetap didokumentasikan oleh LM Studio.
Sebelum Anda Mula: Adakah PC Windows 11 Anda Sesuai?
LM Studio pada masa ini menyokong kedua-dua PC Windows x64 dan sistem berasaskan ARM. Untuk x64, CPU mesti menyokong AVX2. LM Studio mengesyorkan sekurang-kurangnya 16GB RAM dan sekurang-kurangnya 4GB VRAM khusus. Ini adalah cadangan peringkat aplikasi, bukan jaminan bahawa setiap model akan muat. Saiz model, kuantisasi, panjang konteks, dan pemindahan beban GPU semuanya mempengaruhi penggunaan memori.
Apa yang anda ada
Cadangan praktikal
Sebab
16GB RAM, GPU sederhana atau grafik bersepadu
Mula dengan model terdistilasi DeepSeek 8B atau lebih kecil dalam varian GGUF 4-bit
Ia mengekalkan jejak model agak terkawal sambil mengekalkan keupayaan penaakulan yang berguna.
Lebih banyak RAM dan GPU yang lebih kuat
Cuba varian terdistilasi yang lebih besar hanya selepas menyemak anggaran kesesuaian peranti LM Studio
Model yang lebih besar mungkin meningkatkan kualiti tetapi menggunakan jauh lebih banyak memori dan boleh menjadi jauh lebih perlahan.
PC permainan atau komputer riba biasa
Jangan mula dengan DeepSeek V4 Flash
LM Studio menyatakan model V4 Flash tempatan memerlukan sekurang-kurangnya 156GB memori sistem.
Dokumentasi muat turun model LM Studio menjelaskan bahawa binaan terkuantisasi menukar sedikit ketepatan untuk fail yang lebih kecil dan tekanan memori yang lebih rendah. Cadangan umumnya ialah memilih pilihan 4-bit atau lebih tinggi apabila perkakasan anda mampu menanganinya. Jika anda tidak pasti, versi GGUF 4-bit adalah ujian pertama yang munasabah.
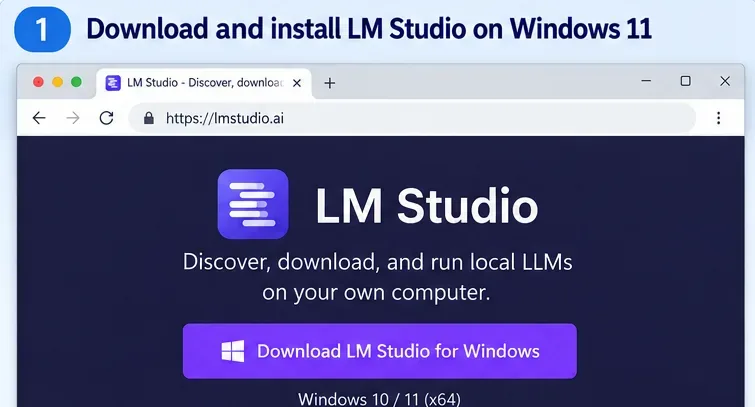
Muat turun binaan Windows stabil semasa dari halaman muat turun rasmi LM Studio. Gunakan pemasang yang sepadan dengan seni bina Windows anda. Pada PC x64, pastikan pemproses anda menyokong AVX2 sebelum menyelesaikan masalah ralat muat model kemudian.
Paparan muat turun Windows untuk LM Studio. Pilih pemasang yang sepadan dengan sistem Windows 11 anda sebelum beralih kepada muat turun model.
Lancarkan LM Studio semasa anda masih mempunyai sambungan internet. Ini penting kerana aplikasi mungkin perlu memuat turun atau mengemas kini LM Runtime. LM Studio menerangkan masa berjalan sebagai enjin inferens yang dibungkus, seperti masa berjalan berasaskan llama.cpp untuk model GGUF. Muat turun masa berjalan memerlukan konektiviti walaupun inferens boleh berfungsi secara luar talian selepas itu.
Langkah 2: Muat Turun Model DeepSeek Yang Sesuai Dengan PC Anda
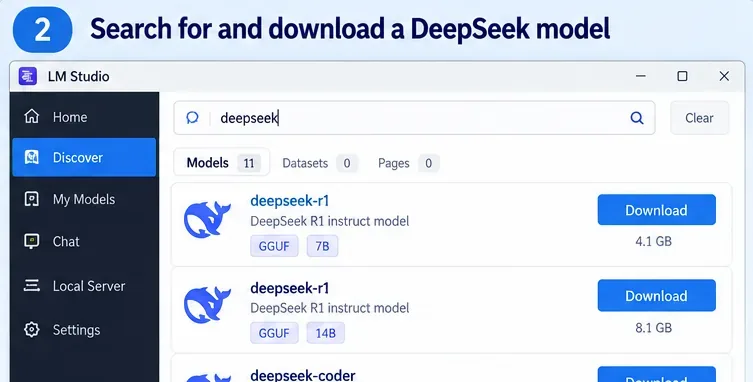
Buka kawasan Discover dalam LM Studio dan cari DeepSeek. LM Studio boleh mencari model Hugging Face yang disokong dengan kata kunci, dengan pengenal user/model, atau bahkan dengan URL Hugging Face penuh.
Cari DeepSeek dalam Discover, kemudian pilih model dan kuantisasi yang sesuai untuk perkakasan anda. Entri katalog tepat dan saiz fail berubah dari masa ke masa.
Model DeepSeek mana yang harus anda pilih?
Untuk kebanyakan orang yang mengikuti panduan ini, mulakan dengan DeepSeek-R1-0528-Qwen3-8B. LM Studio menyatakan model terdistilasi 8B ini menyokong penaakulan dan penggunaan alat, tersedia sebagai GGUF, dan boleh berjalan dengan jauh lebih sedikit memori daripada model utama DeepSeek. Panduan Windows LM Studio masih mengesyorkan 16GB RAM untuk aplikasi secara keseluruhan, jadi jangan anggap dakwaan memori rendah khusus model sebagai sasaran sistem keseluruhan yang selesa.
DeepSeek juga telah mengeluarkan varian terdistilasi R1 awal pada parameter 1.5B, 7B, 8B, 14B, 32B, dan 70B. Ini memberi anda ruang untuk menukar kelajuan dan penggunaan memori terhadap keupayaan. Lihat repositori rasmi DeepSeek-R1 untuk keluarga model dan butiran lesen, dan nota pelaksanaan tempatan DeepSeek-R1-0528 LM Studio untuk pilihan 8B.
Jika anda tergoda oleh DeepSeek V4 Flash kerana ia lebih baru, semak keperluan perkakasan terlebih dahulu. Artikel rasmi V4 Flash LM Studio menyatakan model Mixture-of-Experts 284B memerlukan sekurang-kurangnya 156GB memori sistem untuk penggunaan tempatan. Ia boleh dilaksanakan pada stesen kerja memori tinggi, bukan komputer riba Windows biasa.
Langkah 3: Muatkan Model Ke Dalam Memori
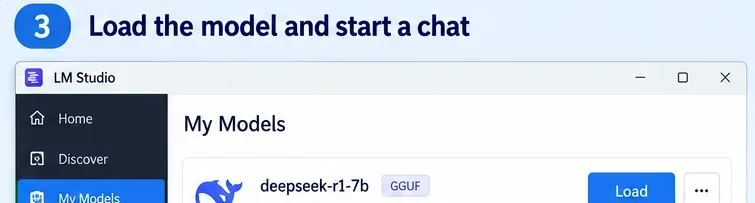
Selepas muat turun selesai, pergi ke model yang dimuat turun anda atau buka pemuat model daripada Chat. Pilih model DeepSeek dan muatkannya. LM Studio menjelaskan bahawa memuatkan model memperuntukkan memori untuk pemberat model dan keadaan masa berjalan yang berkaitan.
Model GGUF DeepSeek yang dimuat turun sedia untuk dimuatkan. Jika pemuatan gagal, cuba model yang lebih kecil atau kuantisasi memori lebih rendah sebelum mengubah tetapan lanjutan.
Untuk larian pertama anda, kekalkan tetapan pemuatan secara konservatif. Tetingkap konteks yang sangat besar boleh menggunakan memori tambahan yang ketara, jadi tiada sebab untuk memaksimumkan konteks serta-merta. Muatkan model dengan konteks sederhana, sahkan bahawa ia berfungsi, dan kembangkan hanya apabila beban kerja anda memerlukannya.
Jika LM Studio melaporkan bahawa model tidak muat, penyelesaian yang paling boleh dipercayai biasanya ialah memilih model yang lebih kecil atau kuantisasi yang lebih padat. Menutup aplikasi yang menggunakan banyak memori boleh membantu, tetapi ia tidak mengubah jejak model asas.
Langkah 4: Putuskan Sambungan Internet dan Sahkan DeepSeek Benar-Benar Berfungsi Secara Luar Talian
Ini adalah langkah yang memisahkan “model tempatan” daripada sekadar “menggunakan klien desktop.” Sebaik sahaja model dan masa berjalannya dipasang, matikan Wi-Fi dan putuskan sambungan Ethernet. Kemudian mulakan sembang baru dan hantar prompt mudah seperti:
Terangkan perbezaan antara RAM dan VRAM dalam lima mata peluru.
Jika model bertindak balas semasa PC tidak mempunyai sambungan rangkaian, inferens adalah tempatan. LM Studio menyatakan bahawa sebaik sahaja LLM berada pada mesin anda, ia boleh berjalan sepenuhnya secara luar talian dan teks yang dimasukkan ke dalam sembang LLM tempatan tidak meninggalkan peranti anda. Dokumentasi luar talian juga menyatakan pemprosesan dokumen tempatan dan RAG kekal pada mesin.
Model DeepSeek yang dimuatkan bertindak balas dalam LM Studio Chat. Untuk mengesahkan operasi luar talian sendiri, putuskan akses rangkaian selepas model dan masa berjalan dimuat turun sepenuhnya dan ulang prompt mudah.
Terdapat sempadan penting: mencari model, memuat turun model baru, memuat turun masa berjalan, dan menyemak kemas kini aplikasi memerlukan akses internet. Jika anda kemudian menambah model awan, pelayan MCP jauh, alat web, atau integrasi rangkaian lain, ciri-ciri tersebut mungkin juga memerlukan konektiviti. Dakwaan privasi luar talian terpakai kepada aliran kerja tempatan, bukan kepada perkhidmatan yang anda sambungkan secara sengaja selepas itu.
Langkah 5: Pilihan—Gunakan DeepSeek Melalui API Tempatan
Jika anda mahu aplikasi Windows lain, skrip, sambungan IDE, atau alat dalaman memanggil model DeepSeek tempatan anda, LM Studio boleh menjalankan pelayan tempatan. Dokumentasi pembangun semasa menyatakan anda boleh memulakannya dari halaman Developer atau dengan:
lms server start
Secara lalai, pelayan tersedia di http://localhost:1234. LM Studio menyediakan hujung REST asli dan hujung serasi OpenAI. Pelayan itu sendiri boleh beroperasi secara luar talian selagi model dan masa berjalan sudah tempatan. Walau bagaimanapun, jika anda mendedahkan pelayan melebihi localhost, semak tetapan pengesahan dan akses rangkaian terlebih dahulu.
Tidak cukup RAM/VRAM, konteks terlalu besar, atau CPU/masa berjalan tidak disokong
Cuba model DeepSeek yang lebih kecil, kuantisasi yang lebih kecil, atau panjang konteks yang lebih rendah. Pada Windows x64, sahkan sokongan AVX2.
LM Studio berfungsi dalam talian tetapi tidak selepas memutuskan sambungan
Model atau masa berjalan yang diperlukan tidak dimuat turun sepenuhnya
Sambung semula sekali, selesaikan semua muat turun model/masa berjalan, muatkan model dengan berjaya, kemudian ulang ujian luar talian.
Penjanaan sangat perlahan
Model terlalu besar untuk pecutan GPU yang tersedia dan bergantung heavily pada CPU/memori sistem
Pilih model atau kuantisasi yang lebih kecil. Model yang lebih besar tidak berguna jika latensi menjadikan aliran kerja tidak praktikal.
Anda tidak dapat mencari model semasa luar talian
Carian Discover memerlukan akses rangkaian
Muat turun model sebelum pergi luar talian, atau muat masuk secara sisi fail model yang diperoleh melalui proses terkawal lain.
Anda menjangkakan V4 Flash berjalan pada komputer riba biasa
Keperluan memori tempatan adalah kelas stesen kerja
Gunakan model terdistilasi R1 sebaliknya melainkan mesin anda mempunyai kira-kira 156GB atau lebih memori sistem.
Apabila Penyediaan Ini Sesuai
Menjalankan DeepSeek secara luar talian dengan LM Studio adalah padanan yang kuat apabila anda mahu inferens tempatan yang privasi, kos yang boleh diramalkan selepas memuat turun model, eksperimen tanpa kunci API, atau API localhost untuk pembangunan. Ia juga berguna apabila mesin anda mesti terus berfungsi tanpa akses internet.
Ia adalah padanan yang lebih lemah apabila anda memerlukan model DeepSeek terkuat yang tersedia tetapi hanya mempunyai perkakasan pengguna, apabila anda memerlukan throughput yang sangat tinggi, atau apabila beban kerja anda bergantung pada maklumat web langsung. Model tempatan hanya tahu apa yang ada dalam pemberatnya dan konteks yang anda berikan melainkan anda secara sengaja menyambungkan alat atau sumber data luar.
Semakan Pantas
Gunakan sistem Windows 11 yang memenuhi keperluan LM Studio; CPU x64 memerlukan AVX2.
Kekalkan akses internet untuk muat turun awal LM Studio, masa berjalan, dan model.
Mula dengan model GGUF DeepSeek yang lebih kecil, terutamanya model terdistilasi kelas 8B.
Pilih kuantisasi 4-bit atau lebih tinggi jika perkakasan anda mampu menyokongnya.
Muatkan model dengan berjaya sebelum memutuskan sambungan rangkaian.
Matikan Wi-Fi/Ethernet dan jalankan prompt baru untuk mengesahkan inferens luar talian.
Kurangkan saiz model atau panjang konteks jika anda menghadapi ralat memori.
Gunakan pelayan localhost LM Studio hanya jika anda memerlukan akses API tempatan.
Kesimpulan
Cara paling mudah untuk menjalankan DeepSeek secara luar talian di Windows 11 ialah menggandingkan LM Studio dengan model GGUF DeepSeek yang lebih kecil yang benar-benar muat pada perkakasan anda. Untuk PC biasa, model terdistilasi R1 kelas 8B adalah titik permulaan yang jauh lebih realistik daripada DeepSeek V4 Flash. Selesaikan muat turun semasa dalam talian, muatkan model, putuskan rangkaian, dan sahkan bahawa sembang baru masih bertindak balas. Sebaik sahaja itu berfungsi, anda mempunyai penyediaan DeepSeek yang benar-benar tempatan dan bukan pembungkus desktop di sekitar API awan.