Strona główna
» Domeny
»
Jak przekonwertować PDF na edytowalny dokument Worda bez utraty formatowania
Jak przekonwertować PDF na edytowalny dokument Worda bez utraty formatowania
Nie istnieje niezawodna metoda jednego kliknięcia, która gwarantuje, że PDF stanie się idealnie edytowalnym plikiem Worda z niezmienioną każdą linią, tabelą, czcionką i podziałem strony. To nie jest nowa ograniczenie w 2026 roku; wynika ono z różnic między tymi dwoma formatami. PDF został zaprojektowany do zachowania stałego wyglądu strony, podczas gdy Word przebudowuje treść na edytowalne akapity, tabele, obrazy i inne obiekty dokumentu. Obecna dokumentacja wsparcia Microsoftu nadal stwierdza, że konwersja PDF działa najlepiej dla plików składających się głównie z tekstu i może nie odwzorować oryginalnego układu strona po stronie.
Praktycznym celem nie jest więc „zero zmian formatowania za wszelką cenę”. Chodzi o wybór właściwej metody konwersji dla danego rodzaju pliku PDF, zachowanie najważniejszej struktury i naprawę tylko tych miejsc, gdzie reflow (przepływ tekstu) jest nieunikniony. Dla wielu zwykłych raportów, umów, instrukcji i dokumentów biznesowych Microsoft Word może to zrobić bezpośrednio. Skanowane lub wizualnie złożone pliki PDF mogą wymagać OCR lub dedykowanego konwertera PDF, takiego jak Adobe Acrobat, przed etapem czyszczenia w Wordzie.
Najpierw zidentyfikuj, jaki rodzaj pliku PDF posiadasz
Przed konwersją czegokolwiek zaznacz zdanie w pliku PDF. Jeśli możesz podświetlić poszczególne słowa i je skopiować, plik jest prawdopodobnie tekstowym plikiem PDF. Jeśli kliknięcie na stronie zachowuje się tak, jakby cała strona była jednym obrazem, jest to prawdopodobnie skanowany plik PDF. OCR, skrót od rozpoznawania optycznego znaków, to proces, który wykrywa litery w obrazach stron i zamienia je na przeszukiwalny, edytowalny tekst.
To rozróżnienie ma znaczenie, ponieważ wbudowana konwersja PDF w Wordzie jest najskuteczniejsza, gdy źródło składa się głównie z tekstu. Microsoft wyraźnie ostrzega, że dokumenty zawierające wiele wykresów lub grafik mogą konwertować się źle, czasem pozostawiając całą stronę jako obraz zamiast edytowalnego tekstu. Wymienia również elementy, takie jak niektóre tabele, obramowania stron, przypisy wielostronicowe, przypisy końcowe, zakładki PDF, komentarze i niektóre efekty czcionek, jako te, które mogą nie konwertować się poprawnie. Zobacz Wsparcie Microsoft: Otwieranie plików PDF w Wordzie.
Jeśli plik jest skanem, nie oceniaj konwersji wyłącznie na podstawie podobieństwa wizualnego. Strona w Wordzie może wyglądać idealnie, podczas gdy tekst nadal jest uwięziony w obrazie. Microsoft dokumentuje przepływ pracy od skanu do PDF, który następnie otwiera PDF w wersji desktopowej Worda do edycji, zauważając jednocześnie, że dokumenty składające się głównie z tekstu konwertują się najlepiej. Zobacz Wsparcie Microsoft: Skanowanie i edycja dokumentu.
Krok 1: Otwórz plik PDF w wersji desktopowej Worda
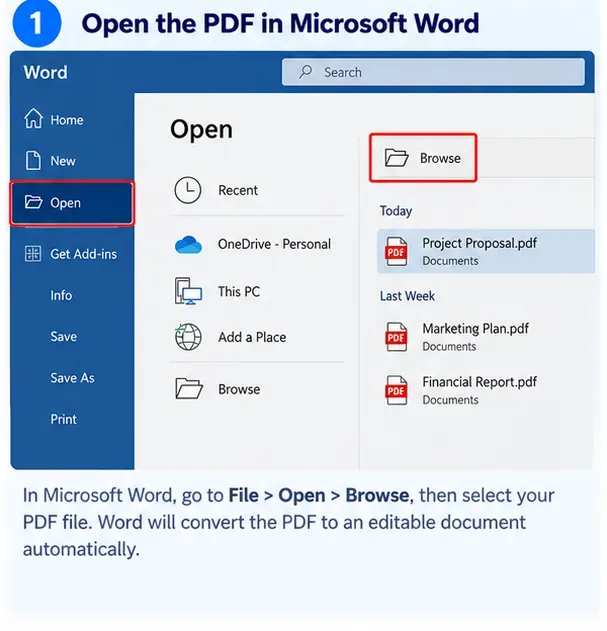
Dla normalnego tekstowego pliku PDF zacznij od najprostszej ścieżki. W obsługiwanej wersji desktopowej Worda wybierz Plik > Otwórz, przejdź do pliku PDF i otwórz go. Word tworzy skopiowaną wersję do edycji; oryginalny plik PDF nie jest zmieniany. Gdy Word wyświetli powiadomienie o konwersji, kontynuuj tylko wtedy, gdy pracujesz na kopii lub wiesz, gdzie przechowywany jest oryginał.
Jest to zazwyczaj najlepsza pierwsza próba dla dokumentów zdominowanych przez akapity, nagłówki, listy i stosunkowo proste tabele. Jest mniej odpowiednia dla broszur, magazynów, układów wielokolumnowych z obiektami pływającymi, formularzy, których dokładne pozycjonowanie jest krytyczne, lub stron zbudowanych głównie z grafik.
Ilustracja wygenerowana przez AI przedstawiająca przepływ pracy Plik > Otwórz w Microsoft Word; nie jest to zrzut ekranu rzeczywistego wyniku konwersji.
Jeśli Word zamieni stronę w pojedynczy obraz, przestań próbować „naprawiać” tekst za pomocą kontrolek formatowania w Wordzie. Problem nie polega na odstępie między akapitami; treść źródłowa nie została rozpoznana jako edytowalny tekst. Zamiast tego użyj ścieżki konwersji obsługującej OCR.
Krok 2: Sprawdź przekonwertowany dokument przed intensywną edycją
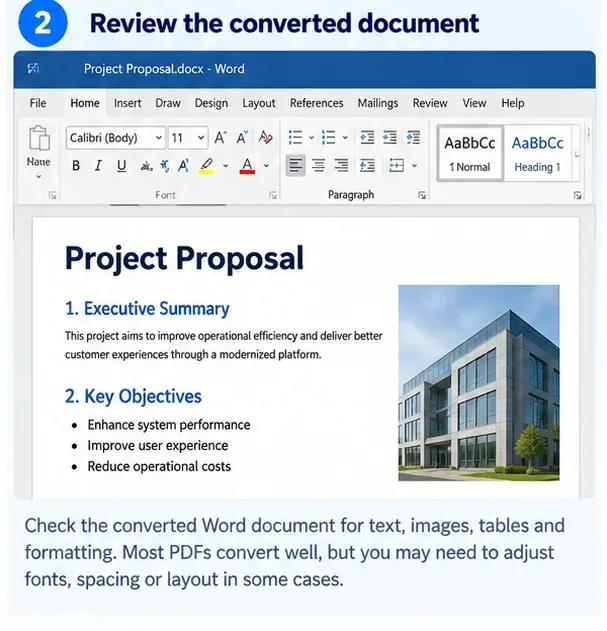
Nie zaczynaj od razu przepisywania tekstu. Najpierw porównaj przekonwertowany plik DOCX z oryginalnym PDF obok siebie. Sprawdź obszary o najwyższym ryzyku: podziały stron, tabele, nagłówki i stopki, listy numerowane, kolumny, rozmieszczenie obrazów, przypisy i nietypowe czcionki. Ta szybka inspekcja powie Ci, czy konwersja w Wordzie jest wystarczająco dobra do naprawy, czy też powinieneś spróbować innej ścieżki konwersji przed zainwestowaniem czasu w ręczne czyszczenie.
Pomocną zasadą jest sprawdzenie pierwszej strony, jednej strony środkowej i ostatniej strony, a następnie zbadanie każdej strony zawierającej złożoną tabelę, diagram, blok podpisu lub sekcję wielokolumnową. Jeśli ten sam problem z układem powtarza się wszędzie, napraw podstawowy styl lub ustawienie sekcji w Wordzie, zamiast poprawiać każdy akapit osobno.
Ilustracja wygenerowana przez AI pokazująca przeglądanie przekonwertowanego dokumentu Worda pod kątem tekstu, obrazów i układu; nie jest to rzeczywisty test konwersji.
Dlaczego formatowanie w ogóle się przesuwa?
PDF zwykle rejestruje, gdzie tekst i grafika pojawiają się na stronie. Word musi wywnioskować relacje, które mogą nie być jawnie przechowywane w pliku PDF: które linie tworzą akapit, który tekst należy do komórki tabeli, gdzie kończy się nagłówek, czy dwa bloki to kolumny i czy element jest przypisem, czy zwykłym tekstem. Microsoft opisuje tę rekonstrukcję jako zbiór reguł próbujących wybrać obiekty Worda, które najlepiej reprezentują oryginalny plik PDF.
To wyjaśnia częste zaskoczenie: plik PDF może wyglądać prosto dla człowieka, ale być strukturalnie trudny dla konwertera. „Tabela” może w rzeczywistości składać się z linii i osobno pozycjonowanego tekstu. Nagłówek może być kilkoma niezależnymi polami tekstowymi. Skanowana strona może zawierać tylko piksele. Jakość konwersji zależy od tej ukrytej struktury, a nie tylko od tego, jak wygląda strona.
Krok 3: Naprawiaj formatowanie we właściwej kolejności
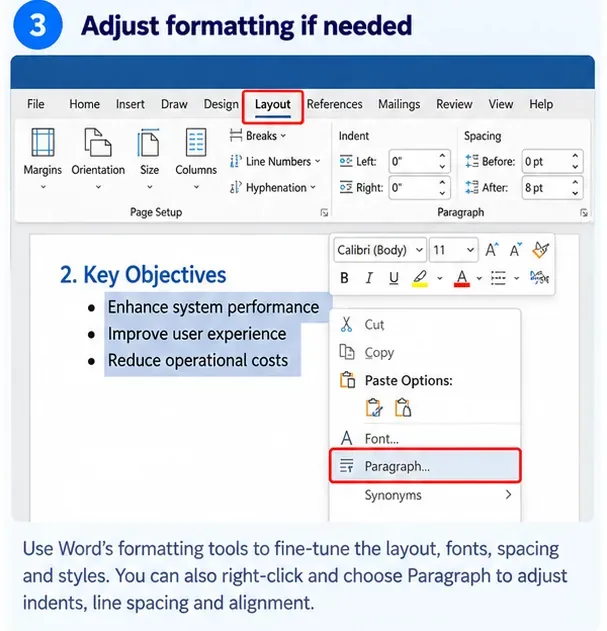
Gdy konwersja jest użyteczna, poprawiaj dokument od dużej struktury do drobnych szczegółów. Zacznij od rozmiaru strony, orientacji, marginesów, sekcji i kolumn. Następnie sprawdź wyrównanie akapitów, wcięcia, interlinię oraz odstępy przed i po akapitach. Po tym popraw czcionki, listy, szerokości tabel i pozycje poszczególnych obrazów. Praca w tej kolejności zmniejsza ryzyko, że późniejsza zmiana na poziomie sekcji cofnie dziesiątki drobnych ręcznych poprawek.
Ilustracja wygenerowana przez AI pokazująca kontrolki układu i akapitów w Wordzie używane do naprawy różnic w konwersji; nie jest to rzeczywisty wynik konwersji Microsoftu.
Używaj stylów zamiast ręcznie formatować każdy nagłówek
Jeśli konwersja PDF wygenerowała nagłówki, które tylko wyglądają na pogrubione i duże, zastosuj style nagłówków Worda tam, gdzie jest to odpowiednie. Style zapewniają spójność powtarzalnego formatowania i są łatwiejsze do globalnego dostosowania. Ta sama zasada dotyczy tekstu głównego: spójny styl Normal jest bezpieczniejszy niż dziesiątki akapitów z nieco innym formatowaniem bezpośrednim.
Zachowaj oryginalną czcionkę tylko wtedy, gdy jest faktycznie dostępna
Jeśli źródłowy plik PDF używa czcionki, która nie jest zainstalowana na Twoim komputerze, Word może podstawić inną czcionkę. Ta podmiana może zmienić długości linii i podziały stron, nawet jeśli czcionka wygląda podobnie. Jeśli masz uprawnienia do używania oryginalnej czcionki i możesz ją legalnie zainstalować, może to poprawić wierność odwzorowania. W przeciwnym razie wybierz jedną czcionkę zastępczą i stosuj ją konsekwentnie, zamiast pozwalać na mieszankę zamienników.
Przebuduj trudne tabele zamiast z nimi walczyć
Tabele są jednym z najczęstszych punktów awarii, ponieważ PDF niekoniecznie zachowuje semantykę tabel. Jeśli przekonwertowana tabela zawiera wiele scalonych komórek, zbędne podziały linii lub osobne pola tekstowe, przebudowanie małej tabeli w Wordzie może być szybsze i stabilniejsze niż naprawianie każdej komórki. Najpierw zachowaj dane; drugorzędnie odtwórz dokładne obramowanie.
Co jeśli plik PDF jest skanowany lub konwersja w Wordzie jest słaba?
Użyj narzędzia PDF obsługującego OCR przed przeprowadzaniem rozległej naprawy formatowania. Obecna dokumentacja Adobe Acrobat, zaktualizowana w 2026 roku, stwierdza, że jej przepływ pracy Eksportuj PDF może konwertować pliki PDF do formatu DOCX i może używać OCR dla dokumentów skanowanych. Adobe zauważa również, że niektóre chronione pliki, Portfele PDF i pewne inne typy plików PDF nie mogą być konwertowane za pomocą tego internetowego przepływu pracy eksportu. Zobacz Adobe Acrobat: Przegląd eksportu PDF oraz Adobe Acrobat: Konwertowanie plików PDF do formatów Worda.
W przypadku OCR wybierz poprawny język dokumentu, gdy konwerter oferuje taką opcję. Wybór języka pomaga w rozpoznawaniu, zwłaszcza w przypadku znaków diakrytycznych i słów, które mogłyby zostać inaczej odczytane. Po OCR nadal porównuj nazwiska, daty, numery kont, równania i inne teksty o wysokim znaczeniu z oryginałem. OCR sprawia, że tekst w obrazie staje się edytowalny; nie gwarantuje jednak, że każdy znak został rozpoznany poprawnie.
Jeśli plik PDF zawiera informacje poufne, prawne, finansowe, medyczne lub własnościowe, postępuj zgodnie z polityką prywatności i obsługi dokumentów swojej organizacji przed przesłaniem go do jakiejkolwiek usługi konwersji online. Lokalny przepływ pracy na komputerze stacjonarnym może być preferowany, gdy przesyłanie do chmury nie jest dozwolone.
Krok 4: Zapisz jako DOCX, a następnie porównaj końcowy plik z PDF
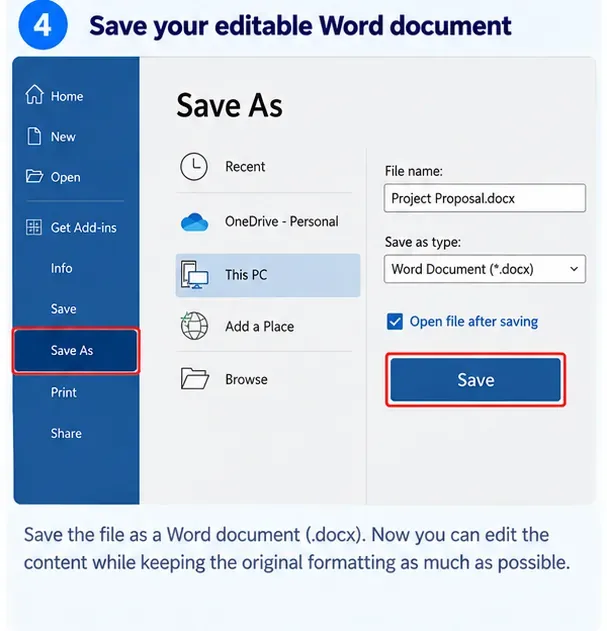
Gdy przekonwertowany dokument jest strukturalnie poprawny, zapisz go jako Dokument programu Word (.docx). DOCX to normalny edytowalny format Worda. Zachowaj oryginalny plik PDF osobno, aby zawsze mieć stały punkt odniesienia do porównań.
Ilustracja wygenerowana przez AI przedstawiająca zapisywanie edytowalnego wyniku jako pliku Word DOCX; nie jest to zrzut ekranu rzeczywistego przekonwertowanego dokumentu.
Teraz wykonaj końcową kontrolę jakości. Otwórz oryginalny plik PDF i plik DOCX przy tym samym poziomie powiększenia i przejrzyj je strona po stronie. Zwróć szczególną uwagę na treść, która może zmienić znaczenie, gdy się przesunie: wiersze tabel, etykiety formularzy, podpisy, numerowane klauzule, przypisy, wyrażenia matematyczne, obszary podpisów i odniesienia specyficzne dla strony, takie jak „zobacz tabelę poniżej”.
Praktyczna lista kontrolna zachowania formatowania
Zachowaj oryginalny plik PDF nietknięty. Traktuj plik Worda jako zrekonstruowaną kopię roboczą.
Używaj najpierw Worda dla plików PDF składających się głównie z tekstu. Jest on wbudowany w obsługiwane wersje desktopowe Worda i jest zwykle najszybszą ścieżką.
Używaj OCR dla stron skanowanych. Jeśli tekst nie może być zaznaczony w źródłowym pliku PDF, zwykłe reflow może nie wystarczyć.
Porównuj przed edycją. Zła konwersja jest tańsza do powtórzenia niż ręczna naprawa przez godzinę.
Naprawiaj strukturę strony przed typografią. Sekcje, marginesy, kolumny i tabele wpływają na wszystko poniżej nich.
Sprawdź czcionki. Brakujące czcionki mogą powodować inne łamanie linii, nawet gdy cały tekst jest obecny.
Weryfikuj krytyczny tekst po OCR. Nazwiska, liczby, kody i sformułowania prawne zasługują na bezpośrednie porównanie ze źródłem.
Zapisz jako DOCX i zachowaj referencyjny plik PDF. Wersja edytowalna i oryginał o stałym układzie służą różnym celom.
Którą metodę powinieneś wybrać?
Rodzaj pliku PDF
Najlepsze pierwsze podejście
Czego się spodziewać
Głównie tekst, prosty układ
Otwórz bezpośrednio w wersji desktopowej Worda
Zazwyczaj najmniej czyszczenia; pewne reflow jest nadal możliwe
Strony skanowane
Konwersja obsługująca OCR, a następnie Word
Edytowalny tekst po rozpoznaniu; zweryfikuj dokładność OCR
Złożona broszura lub projekt wielokolumnowy
Dedykowany konwerter PDF-do-DOCX, a następnie ręczny przegląd
Może lepiej zachować rozmieszczenie wizualne, ale czyszczenie nadal może być znaczące
Tabele z nietypowymi odstępami lub scalonymi komórkami
Spróbuj Worda, a następnie przebuduj problematyczne tabele, jeśli to konieczne
Dane mogą przetrwać, nawet jeśli struktura tabeli nie
Chroniony hasłem lub ograniczony plik PDF
Uzyskaj autoryzowany dostęp lub nieograniczony plik źródłowy
Nie próbuj omijać uprawnień dokumentu
Czy naprawdę można przekonwertować PDF na Worda bez utraty formatowania?
Często można zachować większość formatowania, zwłaszcza gdy plik PDF został utworzony cyfrowo z normalnego dokumentu procesora tekstu. Ale „bez utraty formatowania” należy traktować jako cel jakościowy, a nie gwarancję. Microsoft wyraźnie stwierdza, że przekonwertowany dokument Worda może nie odpowiadać dokładnie plikowi PDF i że linie oraz strony mogą łamać się w innych miejscach.
Najbardziej niezawodny przepływ pracy jest więc prosty: zidentyfikuj, czy plik PDF jest tekstowy czy skanowany, odpowiednio wybierz Worda lub konwerter obsługujący OCR, sprawdź konwersję przed wprowadzaniem dużych zmian, naprawiaj strukturę od góry do dołu i porównaj zapisany plik DOCX z oryginałem. To podejście minimalizuje niepotrzebną ponowną pracę, dając jednocześnie edytowalny dokument Worda, który pozostaje tak blisko formatowania źródłowego, jak pozwala na to podstawowa struktura pliku PDF.