Strona główna
» Domeny
»
Jak automatycznie generować meta tytuły i opisy SEO za pomocą Local Ollama
Jak automatycznie generować meta tytuły i opisy SEO za pomocą Local Ollama
Masz 300 stron produktów, dokumentacji lub blogów gotowych do publikacji, ale kolumna metadanych jest nadal pusta. Ręczne pisanie każdego tytułu i metaopisu jest powolne; kopiowanie jednego wzorca w obrębie witryny daje powtarzalne rezultaty; a zapytanie lokalnego modelu językowego o „tytuł SEO” często zwraca dodatkowe komentarze, zmyślone twierdzenia lub niespójne formatowanie.
Lepszym podejściem jest traktowanie generowania metadanych jako małego strumienia danych: przekaż modelowi tylko dane specyficzne dla strony, wymagaj ustrukturyzowanego wyniku, zwaliduj go w kodzie, a następnie sprawdź wyjątki przed publikacją. Ollama dobrze nadaje się do tego przepływu pracy, ponieważ jej lokalne API jest dostępne po http://localhost:11434/apiinstalacji, a Ollama obsługuje ustrukturyzowane wyniki w schemacie JSON. Dokumentacja Ollama i wyszukiwarki Google, do której się tu odwołuje, została sprawdzona 13 września 2026 r.
Dlaczego automatyczne metadane SEO są nieskuteczne
Większość błędów wynika z przepływu pracy wokół modelu, a nie z pojedynczego „błędnego monitu”. Do najczęstszych przyczyn należą: podanie zbyt małej ilości treści na stronę, pozwolenie modelowi na udzielanie odpowiedzi w formie swobodnej, stosowanie tej samej formuły słów kluczowych do każdego adresu URL oraz publikowanie wyników bez sprawdzania duplikatów na poziomie witryny.
Istnieje również uporczywie błędne przekonanie na temat limitów znaków. Google twierdzi, że nie ma sztywnego limitu długości <title>elementów strony ani metaopisów; linki do tytułów i fragmenty kodu są skracane w razie potrzeby, zazwyczaj w zależności od szerokości urządzenia. Google może również generować inny link do tytułu lub fragment kodu na podstawie treści strony, gdy jego systemy uznają inną reprezentację za bardziej użyteczną. Zapoznaj się z oficjalnymi wytycznymi Google dotyczącymi linków do tytułów , fragmentów kodu i metaopisów .
Oznacza to, że skrypt może narzucić ograniczenia długości tekstu redakcyjnego w celu zapewnienia spójności, ale nie powinien oznaczać tych liczb jako wymagań Google. W poniższym przykładzie 65 znaków dla tytułu i 165 dla opisu to jedynie wewnętrzne ograniczenia. Zmień je, aby dopasować do swojego systemu CMS, marki, potrzeb lokalizacyjnych i procesu weryfikacji.
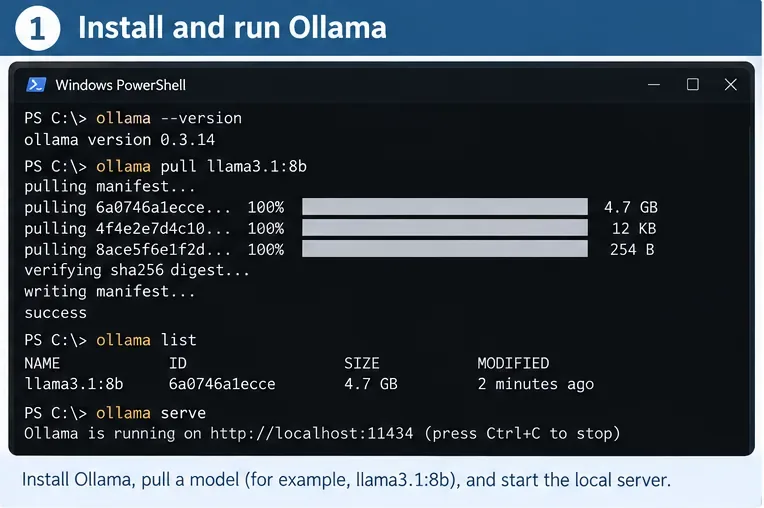
Krok 1: Zainstaluj Ollamę i sprawdź, czy lokalne API działa
Oficjalny przewodnik Ollama zawiera listę obsługi systemów macOS, Windows i Linux. Po instalacji należy pobrać model lokalny. Aktualna dokumentacja Ollama często korzysta gemma3z przykładów API, więc jest to wygodny, neutralny przykład do tego samouczka:
ollama pull gemma3
Następnie przetestuj lokalny punkt końcowy:
curl http://localhost:11434/api/generate -d '{"model":"gemma3","prompt":"Reply with the word ready.","stream":false}'
Dokumentacja API Ollama stwierdza , że lokalne API jest obsługiwane pod adresem http://localhost:11434/api. Ollama informuje również, że lokalny dostęp pod tym adresem nie wymaga uwierzytelniania. Jeśli usługa lokalna nie jest uruchomiona, ollama servenależy użyć udokumentowanego polecenia CLI, aby ją uruchomić. Unikaj zastępowania -cloudmodelu, jeśli Twoim celem jest wnioskowanie lokalne.
Przepływ pracy terminala na etapie konfiguracji: weryfikacja Ollama, pobranie modelu lokalnego, potwierdzenie jego obecności na liście modeli lokalnych i upewnienie się, że usługa jest dostępna na hoście lokalnym. Podane wartości nazwy i długości modelu to przykładowe wartości przepływu pracy, a nie wymagania SEO.
Wybierz model odpowiedni do Twojego sprzętu
Niniejszy artykuł celowo nie twierdzi, że jeden model jest uniwersalnie najlepszy dla metadanych SEO. Dostępność modelu i dopasowanie sprzętowe zmieniają się z czasem, a większe modele wymagają więcej pamięci i generalnie wolniej reagują. Zacznij od modelu, który Twój komputer może komfortowo obsługiwać, wygeneruj mały zestaw recenzji, a następnie porównaj dokładność faktów, unikalność, opóźnienia i spójność, zanim przetworzysz tysiące stron.
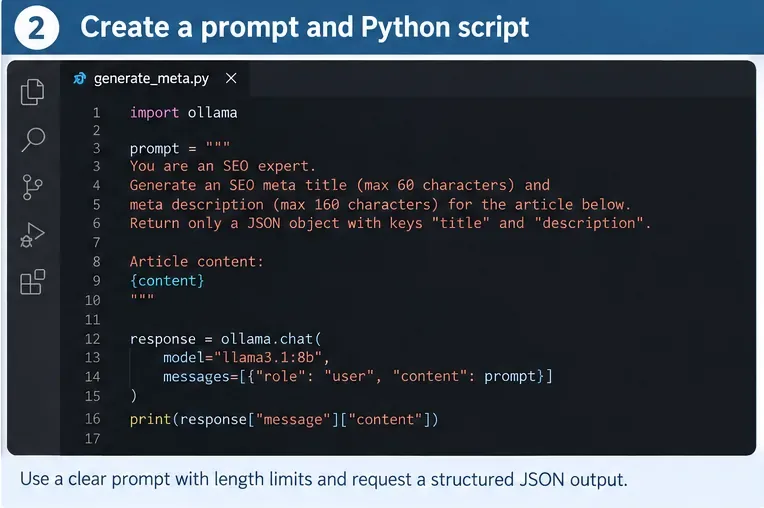
Krok 2: Wymuś ustrukturyzowane dane wyjściowe zamiast analizować prozę
Tekst swobodny jest podatny na automatyzację. Odpowiedź taka jak „Oto trzy świetne opcje…” zmusza program do zgadywania, gdzie zaczyna się właściwy tytuł. Dokumentacja strukturalnych wyników Ollama obsługuje przekazywanie schematu JSON w formatterenie. Dokumentacja zaleca również stosowanie schematów wielokrotnego użytku za pośrednictwem Pydantic w Pythonie i zaznacza, że niska temperatura, taka jak 0, może poprawić determinizm.
Zainstaluj dwa pakiety Pythona użyte w tym przykładzie:
python -m pip install -U ollama pydantic
Następnie utwórz generate_meta.py:
from ollama import Client
from pydantic import BaseModel, Field

MODEL = "gemma3"
client = Client(host="http://localhost:11434")

class SeoMeta(BaseModel):
    title: str = Field(min_length=10, max_length=65)
    description: str = Field(min_length=70, max_length=165)

SYSTEM = """
You create SEO metadata from the page content supplied by the user.

Rules:
- Accurately describe only what is present in the page content.
- Write a concise, descriptive title.
- Write a useful meta description that distinguishes this page from other pages.
- Do not repeat keywords unnaturally.
- Keep the same primary language as the page.
- Do not invent prices, dates, features, guarantees, statistics, or claims.
- The length bounds in the JSON schema are our editorial limits, not Google rules.
- Return only the structured result required by the schema.
"""

def generate_meta(url: str, source_title: str, h1: str, body_text: str) -> SeoMeta:
    prompt = f"""
URL: {url}
Current title: {source_title}
H1: {h1}

Page text:
{body_text[:12000]}

Create one meta title and one meta description for this page.
"""
    response = client.chat(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        format=SeoMeta.model_json_schema(),
        options={"temperature": 0},
    )
    return SeoMeta.model_validate_json(response.message.content)

if __name__ == "__main__":
    result = generate_meta(
        url="https://example.com/guides/clean-cast-iron",
        source_title="Cast Iron Guide",
        h1="How to Clean a Cast-Iron Skillet Without Damaging the Seasoning",
        body_text=(
            "This guide explains how to remove stuck food, wash a cast-iron "
            "skillet, dry it thoroughly, and apply a thin layer of oil..."
        ),
    )
    print(result.model_dump_json(indent=2))
Generator powinien wyraźnie określać dowody na stronie, pola wyjściowe i ograniczenia redakcyjne. W środowisku produkcyjnym należy preferować strukturalne dane wyjściowe oparte na schemacie JSON i walidację po stronie aplikacji Ollama zamiast polegać wyłącznie na sformułowaniach podpowiedzi.
Dlaczego monit zawiera aktualny tytuł i nagłówek H1
Google twierdzi, że jego system linków tytułowych uwzględnia główny tytuł wizualny strony <title>, nagłówki, takie jak <h1>, og:title, tekst eksponowany, tekst zakotwiczenia i inne sygnały. Twój lokalny generator nie musi odtwarzać systemu Google, ale podanie tytułu źródłowego, nagłówka H1, adresu URL i reprezentatywnego tekstu głównego pomaga zachować spójność proponowanych metadanych ze stroną, którą czytelnicy faktycznie zobaczą.
Nie podawaj niepowiązanych list słów kluczowych i poproś model o ich „dopasowanie”. Google wyraźnie zaleca opisowe, zwięzłe tytuły i ostrzega przed upychaniem słów kluczowych i powtarzaniem szablonów. W przypadku opisów, Google twierdzi, że programowe generowanie opisów dla konkretnych stron jest odpowiednie dla dużych witryn opartych na bazach danych, gdy opisy są dokładne, czytelne dla człowieka i zróżnicowane.
Krok 3: Uruchom jedną stronę, a następnie przeprowadź walidację przed skalowaniem
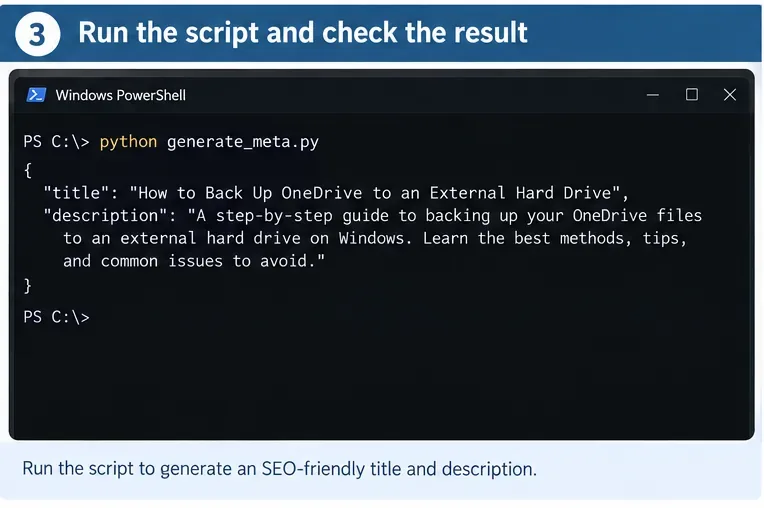
Uruchom skrypt:
python generate_meta.py
Pomyślny wynik powinien być obiektem JSON, który Pydantic może zweryfikować. Co ważniejsze, recenzent powinien być w stanie porównać go ze stroną źródłową i szybko odpowiedzieć na cztery pytania:
Czy tytuł opisuje tę konkretną stronę, czy też całą witrynę?
Czy opis pomija stwierdzenia, daty, ceny lub funkcje, których nie ma w treści źródłowej?
Czy te metadane miałyby nadal sens, gdyby czytać je bez treści strony?
Czy różnią się one od metadanych już używanych na pobliskich stronach?
Najpierw przetestuj jedną reprezentatywną stronę i sprawdź ustrukturyzowany wynik przed rozpoczęciem zadania wsadowego. Wymagana jest parsowalna odpowiedź JSON, ale poprawność merytoryczna i trafność na poziomie strony nadal wymagają walidacji.
Dodaj ponowne próby w przypadku błędów redakcyjnych, a nie tylko błędów API
Schemat może ograniczać typy i długość danych, ale nie gwarantuje, że zdanie jest prawdziwe lub wystarczająco szczegółowe. Zbuduj logikę ponawiania prób wokół kontroli, które można zmierzyć. Na przykład, odrzuć puste pole, zduplikowany tytuł, zabroniony szablon lub opis, który powtarza tytuł niemal słowo w słowo. Jeśli strona zawiera regulowane lub ryzykowne twierdzenia, wymagaj weryfikacji przez człowieka, zamiast próbować zautomatyzować proces weryfikacji.
Zachowaj zwięzłość komunikatów o ponownych próbach. Zamiast generować wszystko od nowa, pisząc „ulepsz”, wskaż modelowi, co się nie powiodło: „Proponowany tytuł duplikuje inną stronę. Przepisz go, używając unikalnego tematu w nagłówku H1, jednocześnie opierając każde stwierdzenie na dostarczonej treści”. Ułatwi to audyt błędów.
Krok 4: Przesyłanie stron w partiach do pliku CSV w celu przeglądu i publikacji
Gdy test jednostronicowy okaże się wiarygodny, zapisz dane wejściowe w pliku CSV z kolumnami takimi jak url, source_title, h1i content. Pole treści powinno zawierać uporządkowany tekst strony, a nie menu nawigacyjne, powiadomienia o plikach cookie ani tysiące niepowiązanych linków w stopce.
Dodaj tę logikę wsadową poniżej funkcji generatora lub umieść ją w osobnym skrypcie:
import csv

rows = []
seen_titles = set()

with open("pages.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        meta = generate_meta(
            url=row["url"],
            source_title=row.get("source_title", ""),
            h1=row.get("h1", ""),
            body_text=row["content"],
        )

        flags = []
        normalized = meta.title.casefold().strip()
        if normalized in seen_titles:
            flags.append("duplicate_title")
        seen_titles.add(normalized)

        rows.append({
            **row,
            "generated_title": meta.title,
            "generated_description": meta.description,
            "title_length": len(meta.title),
            "description_length": len(meta.description),
            "qa_flags": ",".join(flags),
        })

with open("seo_meta_output.csv", "w", newline="", encoding="utf-8") as f:
    fieldnames = list(rows[0].keys())
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(rows)
Wyjściowy plik CSV można przeglądać w programie Excel, LibreOffice, narzędziu do importu baz danych lub w przepływie pracy CMS. Nie nadpisuj automatycznie aktywnych metadanych przy pierwszym uruchomieniu. Zachowaj oryginalny tytuł i opis obok wygenerowanej oferty, aby recenzenci mogli je porównać, a co za tym idzie, wycofanie zmian było proste.
Kolejka przeglądu arkusza kalkulacyjnego ułatwia audyt generowania danych zbiorczych: przed opublikowaniem zmian zachowywany jest identyfikator strony źródłowej, wygenerowany tytuł, wygenerowany opis, długości i flagi kontroli jakości.
Zwiększ bezpieczeństwo procesu wsadowego
Sprawdzać
Co zgłosić
Dlaczego to ważne
Walidacja schematu
Brakujące lub nieprawidłowe pola
Zapobiega przedostawaniu się błędnych danych wyjściowych do CMS.
Sprawdzanie duplikatu tytułu
Ten sam znormalizowany tytuł w dwóch adresach URL
Pomaga zachować rozróżnialność stron.
Sprawdzanie języka
Język metadanych różni się od języka strony
Google zaleca dopasowanie języka głównego i systemu pisma strony.
Sprawdzenie dowodów
Brak danych o liczbach, cenach, datach, markach lub gwarancjach ze źródła
Zmniejsza liczbę halucynogennych roszczeń.
Sprawdzenie szablonu
Długie, powtarzające się frazy w całej witrynie
Google odradza stosowanie szablonowych tytułów.
Sprawdzenie długości redakcyjnej
Poza wybranym przez Ciebie zakresem domu
Zapewnia spójność wyników CMS. Nie jest to reguła Google dotycząca limitu znaków.
Recenzja ludzka
Strony strategiczne, wrażliwe, o dużym ruchu lub niejednoznaczne
Automatyzacja powinna ujawniać wyjątki, a nie je ukrywać.
Typowe problemy – od najłatwiejszego do najtrudniejszego rozwiązania
Połączenie API nie powiodło się
Najpierw sprawdź, czy Ollama jest uruchomiona i http://localhost:11434dostępna. Oficjalna dokumentacja uwierzytelniania stwierdza, że uwierzytelnianie nie jest wymagane dla lokalnego interfejsu API. Jeśli Twój skrypt przypadkowo wskazuje na https://ollama.com/api, jest to inny hostowany punkt końcowy i wymaga uwierzytelnienia.
Odpowiedź zawiera prozę wokół JSON
Używaj schematu format=SeoMeta.model_json_schema()zamiast prosić o JSON tylko w języku naturalnym. Ustrukturyzowane dane wyjściowe to właściwa warstwa kontrolna dla potoku produkcyjnego.
Wszystkie tytuły brzmią tak samo
Wprowadź tekst H1 specyficzny dla strony i treści, usuń globalne zakłócenia nawigacji i wyraźnie poproś o opis specyficzny dla strony. Następnie przeprowadź międzystronną kontrolę duplikatów i podobieństw. Powtarzanie często jest problemem wejściowym, zanim stanie się problemem modelu.
Model wymyśla cechy lub statystyki
Ogranicz ilość danych wejściowych do autorytatywnego tekstu na stronie i wzmocnij podstawową zasadę: brak twierdzeń faktycznych wykraczających poza dostarczoną treść. W przypadku ważnych stron, przed zatwierdzeniem porównuj wygenerowane twierdzenia ze strukturalnymi polami źródłowymi. Jeśli samo źródło jest niejednoznaczne, przekaż wiersz do weryfikacji przez człowieka, zamiast wielokrotnie kazać modelowi zgadywać.
Model jest zbyt wolny dla tysięcy stron
Zmierz przed zmianą architektury. Zmierz czas generowania logów na stronę, rozmiar danych wejściowych, nazwę modelu i wskaźnik awaryjności. Skróć nieistotny tekst, przetwórz stabilne sekcje strony i przetestuj mniejszy model lokalny, jeśli jakość pozostaje akceptowalna. Najszybszy model nie jest przydatny, jeśli jego metadane generują więcej pracy weryfikacyjnej niż oszczędzają.
Opcjonalnie: użyj istniejącej integracji w stylu OpenAI
Jeśli masz już kod napisany dla klienta zgodnego z OpenAI, Ollama dokumentuje częściową zgodność z API OpenAI w [ http://localhost:11434/v1/brakuje informacji]. Może to zmniejszyć nakład pracy związany z migracją. W przypadku nowego narzędzia do metadanych, działającego wyłącznie lokalnie, natywny klient Ollama Python jest prostszy i udostępnia przykłady ustrukturyzowanego wyniku bezpośrednio w dokumentacji Ollama.
Jak samodzielnie sprawdzić gotowy system
Zanim uznasz automatyzację za zakończoną, utwórz zestaw recenzji zawierający różne typy treści: krótki artykuł, długi poradnik, stronę produktu, stronę kategorii, stronę z liczbami oraz stronę w każdym obsługiwanym języku. Uruchom ten sam model i monit dla wszystkich z nich, a następnie zweryfikuj poniższą listę kontrolną.
Lokalny punkt końcowy to localhost, a wybrany model jest modelem lokalnym, a nie modelem oznaczonym w chmurze.
Każda odpowiedź jest weryfikowana pod kątem schematu bez konieczności ręcznego czyszczenia JSON.
Żaden wygenerowany tytuł nie powtarza się w zestawie recenzji.
Wszystkie stwierdzenia faktyczne pojawiają się w treści strony.
Metadane korzystają z tego samego języka podstawowego i systemu pisma, co strona.
Tytuł jest opisowy i zwięzły, bez powtarzania słów kluczowych.
Opis podsumowuje konkretną stronę, a nie witrynę jako całość.
Wewnętrzne ograniczenia długości barierek ochronnych są oznaczone jako zasady redakcyjne, a nie wymagania Google.
Stare metadane, wygenerowana propozycja, flagi QA, nazwa modelu i wersja monitu są zapisywane w celu przeprowadzenia audytu i wycofania.
Recenzent wie, które flagi wymagają ręcznego zatwierdzenia przed publikacją.
Na koniec pamiętajmy, co automatyzacja może, a czego nie może kontrolować. Dobry <title>metaopis dostarcza wyszukiwarkom użytecznych sygnałów na poziomie strony, ale Google może generować linki do tytułów i fragmenty kodu z innych treści strony. Celem nie jest zatem wymuszenie konkretnego renderowania wyników wyszukiwania. Celem jest generowanie dokładnych, odrębnych i użytecznych metadanych na dużą skalę, przy jednoczesnym zachowaniu wystarczającej liczby walidacji i weryfikacji, aby wychwycić błędy przed ich dotarciem do produkcji.