Strona główna
» Domeny
»
Jak skonfigurować prywatną lokalną bazę wiedzy AI dla dokumentów osobistych
Jak skonfigurować prywatną lokalną bazę wiedzy AI dla dokumentów osobistych
Najprostsza praktyczna odpowiedź: uruchom model języka, model osadzania, indeks dokumentów i interfejs czatu na swoim komputerze. Prostym stosem jest Ollama do obsługi modeli lokalnych oraz samodzielnie hostowany AnythingLLM do pobierania dokumentów, generowania rozszerzonego wyszukiwania (RAG) i czatu. Utrzymuj lokalną bazę danych wektorowych, korzystaj z trwałej pamięci masowej, unikaj dostawców modeli w chmurze i sprawdź, czy odpowiedzi są rzeczywiście oparte na Twoich plikach.
Przykład ilustrujący: w tym przewodniku wyobraź sobie, że Jordan organizuje prywatną kolekcję, która zawiera instrukcje dotyczące gospodarstwa domowego, pliki PDF z ubezpieczeniami, notatki ze spotkań, materiały dotyczące finansów osobistych oraz kilka raportów z projektów. Jordan jest postacią fikcyjną. Pliki, pytania, odpowiedzi i wyniki opisane poniżej to przykłady objaśniające przepływ pracy, a nie wyniki testów ani rekomendacje.
W tym przewodniku zastosowano czteroetapową konfigurację, dzięki czemu granice prywatności pozostają zrozumiałe. Jest on odpowiedni dla jednej osoby lub małego, zaufanego gospodarstwa domowego, które chce lokalnie wyszukiwać dokumenty i odpowiadać na pytania. Jeśli potrzebujesz kontroli tożsamości w przedsiębiorstwie, dostępności wielowęzłowej, scentralizowanego audytu lub gwarancji regulacyjnych, powinieneś traktować to jako architekturę startową, a nie kompletne rozwiązanie zapewniające zgodność z przepisami.
Co tak naprawdę oznacza „prywatna lokalna baza wiedzy o sztucznej inteligencji”
Lokalna baza wiedzy to nie to samo, co trenowanie modelu na dokumentach. W typowym procesie RAG system wyodrębnia tekst z plików, dzieli go na fragmenty, konwertuje te fragmenty na osadzenia numeryczne, zapisuje je w wektorowej bazie danych, pobiera odpowiednie fragmenty dla każdego pytania i wysyła tylko te fragmenty do modelu języka jako kontekst.
Aktualna dokumentacja AnythingLLM opisuje zarówno przepływy pracy z dokumentami dołączonymi, jak i osadzonymi. Załączone dokumenty mogą umieszczać pełny tekst w czacie, gdy pozwala na to okno kontekstowe, podczas gdy RAG pobiera mniejsze, istotne fragmenty z dokumentów osadzonych. Aktualna lokalna dokumentacja LanceDB stwierdza również, że domyślna instancyjna baza danych LanceDB przechowuje tekst dokumentu i osadzenia w aplikacji AnythingLLM. Zobacz dokumentację przepływu pracy z dokumentami AnythingLLM oraz dokumentację AnythingLLM LanceDB .
Część
Rola w stosie lokalnym
Wybór uwzględniający prywatność
Ollama
Uruchamia model czatu i opcjonalnie model osadzania na Twoim komputerze
Użyj lokalnego modelu, a nie punktu końcowego modelu hostowanego w chmurze
AnythingLLM
Zapewnia interfejs użytkownika, zarządzanie dokumentami, dzielenie na części, RAG i organizację przestrzeni roboczej
Uruchom go lokalnie i zachowaj trwały katalog przechowywania
Model osadzania
Zamienia fragmenty dokumentów i zapytania w wektory w celu wyszukiwania semantycznego
Jeśli dokumentów nie można wysyłać do usługi zewnętrznej, należy użyć lokalnego modułu osadzającego
LanceDB
Przechowuje wektory używane do znajdowania odpowiednich fragmentów
Zachowaj domyślną lokalną instancję, chyba że celowo potrzebujesz zdalnej bazy danych
Oryginalne pliki i kopie zapasowe
Pozostań autorytatywnym źródłem
Chroń je, stosując standardowe kontrole dostępu do systemu operacyjnego, szyfrowanie i kopie zapasowe
Zanim zaczniesz: określ granicę prywatności
Kluczowe pytanie nie brzmi: „Czy aplikacja jest lokalna?”, lecz: „Które komponenty mogą wysyłać tekst dokumentu lub komunikaty z komputera?”. Lokalny interfejs użytkownika nadal można skonfigurować tak, aby wywoływał chmurowy LLM, interfejs API do osadzania w chmurze, wyszukiwarkę internetową lub narzędzia zdalne. W przypadku konfiguracji prywatnej, należy pozostawić lokalny LLM, moduł osadzania i bazę danych wektorów, chyba że świadomie zaakceptowano implikacje udostępniania danych przez zewnętrznego dostawcę.
Platforma AnythingLLM dokumentuje anonimową telemetrię i umożliwia jej wyłączenie. Dokumentacja dotycząca prywatności odróżnia również usunięcie dokumentu z jednego obszaru roboczego od całkowitego usunięcia go z biblioteki dokumentów. Aby w pełni usunąć dokument w ramach platformy AnythingLLM, aktualna dokumentacja zaleca usunięcie go z Moich Dokumentów , co powoduje usunięcie przeanalizowanego kodu źródłowego i osadzonych elementów z pamięci podręcznej, a także odwołań do obszarów roboczych. Przed dodaniem poufnych informacji należy zapoznać się z dokumentacją dotyczącą prywatności i przetwarzania danych w platformie AnythingLLM .
Potrzebujesz również wystarczającej ilości pamięci dla wybranego modelu lokalnego. Nie ma jednego, prawidłowego rozmiaru modelu, ponieważ użyteczna prędkość zależy od procesora, karty graficznej, pamięci RAM lub VRAM, kwantyzacji, długości kontekstu i liczby pobieranych dokumentów. Zacznij od modelu, który będzie dla Ciebie wygodny, zamiast wybierać największy model, którego Twój komputer ledwo załaduje.
Krok 1: Zainstaluj Ollamę i przygotuj lokalne modele czatu i osadzania
Zainstaluj Ollamę, korzystając z aktualnych instrukcji dla swojego systemu operacyjnego. Ollama jest dostępna dla systemów macOS, Windows i Linux, a jej lokalne API jest domyślnie obsługiwane na porcie 11434. Oficjalny przewodnik szybkiego startu Ollama to najlepsze źródło informacji o aktualnej instalacji i składni poleceń.
Po instalacji wybierz model czatu, który pasuje do Twojego sprzętu. Dokładny model nie jest tutaj celowo ustalony, ponieważ katalog modeli ulega zmianom, a wymagania sprzętowe są różne. Typowe polecenie ma następującą postać:
ollama pull <chat-model-name>
W przypadku RAG potrzebny jest również model osadzania. Aktualna dokumentacja osadzania Ollama, sprawdzona we wrześniu 2026 roku, wymienia modele takie jak embeddinggemma, qwen3-embeddingi all-minilmjako zalecane opcje osadzania. Aktualną listę można znaleźć w dokumentacji osadzania Ollama . Na przykład:
ollama pull embeddinggemma
Nie używaj normalnego modelu czatu jako modelu osadzanego tylko dlatego, że pojawia się on na liście rozwijanej modeli. Aktualna dokumentacja modułu Ollama w AnythingLLM wyraźnie ostrzega, że Ollama może udostępniać zarówno modele czatu, jak i modele osadzane na tej samej liście. Użyj rzeczywistego modelu osadzanego do indeksowania dokumentów. Zobacz konfigurację modułu Ollama w AnythingLLM .
Ilustracyjny schemat działania terminala do pobierania modelu lokalnego za pomocą Ollama. Numer wersji widoczny w tym przykładzie nie jest rekomendacją aktualnej wersji; sprawdź zainstalowaną wersję w oficjalnej dokumentacji Ollama.
W przypadku fikcyjnej konfiguracji Jordana cel na tym etapie jest prosty: zarówno generowanie, jak i osadzanie powinno być możliwe bez konieczności wysyłania dokumentów domowych do zdalnego interfejsu API.
Krok 2: Uruchom AnythingLLM lokalnie z trwałym magazynem i połącz go z Ollamą
AnythingLLM oferuje opcje desktopowe i hostowane samodzielnie. W tym przewodniku wykorzystano ścieżkę Dockera, ponieważ granica pamięci masowej jest jasno określona i łatwa do utworzenia kopii zapasowej. Aktualna lokalna dokumentacja Dockera instruuje użytkowników, aby pobrali obraz i podkreśla, że wymagana jest trwała pamięć masowa, w przeciwnym razie dane aplikacji mogą zostać utracone podczas ponownego tworzenia kontenera. Stwierdzono również, że aplikacja internetowa jest dostępna pod adresem http://localhost:3001. Skorzystaj z oficjalnego lokalnego przewodnika Dockera AnythingLLM, zamiast kopiować stare polecenie z forum.
docker pull mintplexlabs/anythingllm:latest
Po uruchomieniu kontenera zachowaj pamięć masową AnythingLLM, montując katalog hosta w /app/server/storage. Dokumentacja dostawcy wyraźnie wskazuje na konieczność trwałego montowania. Zachowaj ten katalog pamięci masowej na dysku uwzględnionym w planie tworzenia kopii zapasowych.
Następnie skonfiguruj dostawcę LLM jako Ollama. Jeśli AnythingLLM działa bezpośrednio na hoście, udokumentowany domyślny adres Ollama to http://127.0.0.1:11434. Jeśli AnythingLLM działa w Dockerze, a Ollama na hoście, nie należy używać go localhostz kontenera. Dokumentacja sieciowa AnythingLLM dotycząca Dockera zaleca korzystanie z niego http://host.docker.internal:11434na obsługiwanych platformach desktopowych; w systemie Linux dokumentacja 172.17.0.1dotyczy tego wzorca połączenia z hostem. Zapoznaj się z notatką sieciową AnythingLLM dotyczącą hosta lokalnego i konfiguracją Ollama LLM .
W ustawieniach wybierz Ollamę jako dostawcę LLM oraz, w razie potrzeby, dostawcę osadzania. Wybierz model czatu do generowania i model osadzania do indeksowania. Rozdzielenie tych ról zapobiega częstym błędom konfiguracji.
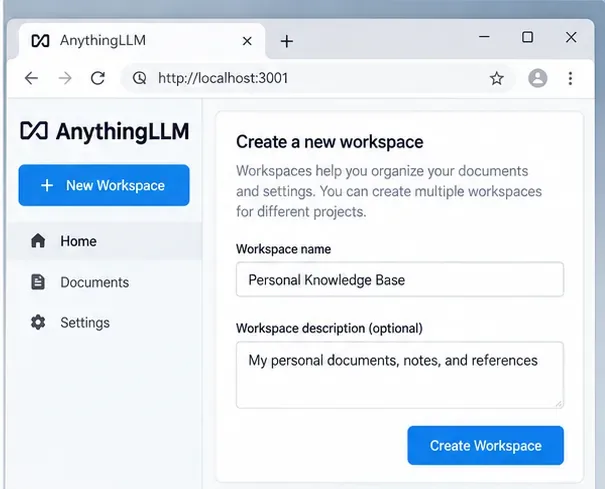
Dokumentacja dotycząca samodzielnie hostowanego systemu AnythingLLM zakłada, że działa on pod adresem localhost:3001. Dedykowana przestrzeń robocza nadaje jednemu zbiorowi dokumentów jasno określony cel i wyklucza niepowiązane materiały z puli pobierania.
Jordan tworzy przestrzeń roboczą o nazwie „Osobista Baza Wiedzy” i unika łączenia się z dostawcami modeli chmurowych. Dzięki temu zamierzone granice można łatwo zweryfikować później: lokalny interfejs użytkownika, lokalny LLM, lokalne osadzenia, lokalne wektory.
Krok 3: Dodaj dokumenty, wybierz opcję RAG lub załącznik pełnotekstowy i zweryfikuj pobranie
Nie zaczynaj od przesyłania całego dysku. Zacznij od małego, reprezentatywnego zestawu dokumentów, których zawartość dobrze znasz. To pozwoli Ci w kontrolowany sposób wykryć problemy z ekstrakcją lub pobieraniem, zanim indeks się rozrośnie.
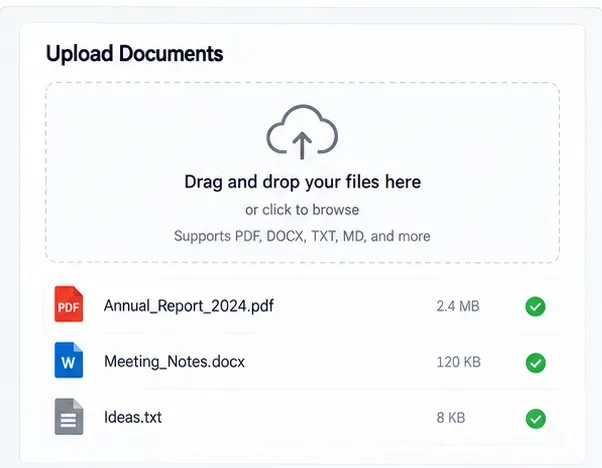
W przykładzie Jordana, użyteczna pierwsza partia mogłaby zawierać jeden przeszukiwalny plik PDF, jeden plik DOCX i jedną notatkę w formacie zwykłego tekstu lub Markdown. Jeśli zeskanowane pliki PDF zawierają obrazy zamiast tekstu do zaznaczenia, należy sprawdzić, czy wybrana ścieżka przetwarzania dokumentów faktycznie wyodrębnia potrzebny tekst; plik, który wydaje się czytelny, nadal może wygenerować pustą lub niepełną reprezentację tekstową dla RAG.
AnythingLLM obsługuje obecnie dwa ogólne zachowania dokumentów:
Dołączone dokumenty: przydatne, gdy cały tekst mieści się w oknie kontekstowym modelu i chcesz, aby model widział cały plik dla danego wątku.
Osadzone dokumenty z RAG: przydatne w przypadku większych kolekcji lub kolekcji wielokrotnego użytku. System dzieli treść na fragmenty, osadza ją i pobiera odpowiednie fragmenty dla danego pytania.
W aktualnym przewodniku po dokumentach AnythingLLM zaznaczono, że dokumenty osadzone w obszarze roboczym stają się dostępne we wszystkich wątkach w tym obszarze. Jest to wygodne, ale oznacza również, że członkostwo w obszarze roboczym jest częścią modelu prywatności we wdrożeniach wielodostępnych. Oddzielaj osobiste obszary robocze od współdzielonych.
Przykładowy widok pobierania z kilkoma typami dokumentów. Najpierw użyj małej, znanej i dobrej partii, a następnie zweryfikuj ekstrakcję i indeksowanie przed dodaniem dużego archiwum.
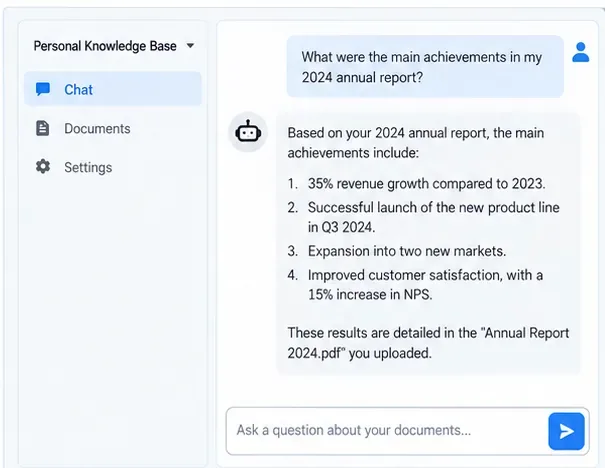
Po osadzeniu, zadaj pytanie, na które odpowiedź znajduje się tylko w jednym pliku. Następnie poproś o szczegół, który nie znajduje się w żadnym pliku. Pierwsze pytanie testuje wyszukiwanie; drugie sprawdza, czy model dopuszcza niepewność zamiast wymyślać odpowiedź.
Co dostroić, jeśli pobieranie jest słabe
AnythingLLM udostępnia funkcje kontroli RAG na poziomie obszaru roboczego, takie jak preferencje wyszukiwania, maksymalna liczba fragmentów kontekstu i próg podobieństwa dokumentów. Dokumentacja zaleca rozpoczęcie od ustawień obszaru roboczego, zamiast zakładać, że problem leży w modelu bazowym. Zwiększenie ilości pobieranego kontekstu może pomóc, gdy odpowiedź obejmuje kilka sekcji, ale wysyłanie zbyt wielu fragmentów może również dodać nieistotny tekst i wyczerpać pojemność okna kontekstowego.
Jeśli zmienisz modele osadzania po indeksowaniu, ponownie osadź dokumenty, których to dotyczy, tak aby zapisane wektory i wektory zapytań pochodziły z tej samej przestrzeni osadzania. Mieszanie osadzeń z różnych modeli nie jest sensowną strategią pobierania.
Krok 4: Przetestuj sprawdzone odpowiedzi, zadbaj o prywatność i utwórz kopię zapasową bazy wiedzy
Baza wiedzy jest przydatna tylko wtedy, gdy potrafisz wykryć błędy. Stwórz krótką listę ewaluacyjną opartą na faktach, które możesz bezpośrednio zweryfikować. Na przykład:
Poproś o datę, kwotę, model produktu lub klauzulę polisy, które pojawiają się dosłownie w jednym dokumencie.
Zadaj pytanie obejmujące wiele dokumentów, wymagające podania faktów z dwóch plików.
Zadaj celowo pytanie, na które nie ma odpowiedzi i sprawdź, czy odpowiedź nie jest zmyślona.
Zadaj to samo pytanie, używając innych sformułowań, aby sprawdzić, czy pobieranie jest stabilne.
Otwórz dokument źródłowy i ręcznie potwierdź każde roszczenie o wysokiej stawce.
Hipotetyczna odpowiedź oparta na dokumencie, użyta do zilustrowania etapu weryfikacji. Przedstawione liczby to fikcyjne przykładowe treści; w rzeczywistej bazie wiedzy zweryfikuj ważne twierdzenia względem oryginalnego pliku.
Dla Jordana dobra reguła akceptacji nie polega na tym, że „odpowiedź brzmi dobrze”. Chodzi o to, że „odpowiedź jest zgodna ze źródłem, zawiera niezbędny kontekst i nie daje się bezpiecznie odczytać, gdy źródło nie zawiera informacji”. Ta reguła ma szczególne znaczenie w przypadku podatków, ubezpieczeń, dokumentów prawnych, dokumentacji medycznej czy decyzji finansowych.
Po zakończeniu konfiguracji zachowaj ją jako prywatną
Lokalne wnioskowanie zmniejsza ryzyko ujawnienia danych, ale prywatność nadal zależy od konfiguracji. Użyj tych opcji jako praktycznej listy kontrolnej:
Usługę AnythingLLM należy powiązać z komputerem lokalnym lub zaufaną siecią prywatną, chyba że dostęp zdalny jest celowo zabezpieczony.
Nie dodawaj integracji LLM w chmurze, osadzania w chmurze, wyszukiwania internetowego, przeglądarki ani agenta do obszaru roboczego zawierającego poufne materiały, jeśli nie rozumiesz, co przesyłają te integracje.
Wyłącz anonimową telemetrię, jeśli Twoja polityka prywatności wymaga braku telemetrii produktu.
Użyj szyfrowania dysku i uprawnień konta w systemie operacyjnym. Lokalna baza danych wektorowych nadal będzie zawierać dane możliwe do odczytu, jeśli atakujący uzyska dostęp do komputera.
Usuń poufne pliki z biblioteki dokumentów, a nie tylko z jednego obszaru roboczego, jeśli zamierzasz przeprowadzić pełne usuwanie plików w programie AnythingLLM.
Załataj Ollamę, AnythingLLM, Dockera i system operacyjny hosta. „Offline” nie powinno oznaczać „nigdy niekonserwowany”.
Wykonaj kopię zapasową części, które trudno odtworzyć
Oryginalne dokumenty pozostają Twoim źródłem prawdy, ale katalog pamięci masowej AnythingLLM zawiera bazę danych aplikacji, przeanalizowane dokumenty, dane wektorowe i konfigurację niezbędną do uniknięcia odbudowy wszystkiego po awarii dysku. Utwórz kopię zapasową zarówno oryginalnego folderu dokumentów, jak i trwałej pamięci masowej AnythingLLM. Jeśli używasz woluminów Docker zamiast katalogu hosta zamontowanego w systemie bind, postępuj zgodnie z oficjalną dokumentacją dotyczącą tworzenia kopii zapasowych i przywracania woluminów Dockera .
Testuj przywracanie, a nie tylko tworzenie kopii zapasowej. Kopia zapasowa jest potwierdzona tylko wtedy, gdy można ją przywrócić do innego katalogu lub na inny komputer, uruchomić stos lokalny, otworzyć obszar roboczy i poprawnie pobrać znany fakt.
Kiedy ta konfiguracja jest odpowiednia, a kiedy nie
Ta architektura doskonale sprawdza się, gdy priorytetem jest przechowywanie dokumentów osobistych na kontrolowanym przez Ciebie sprzęcie, nie przeszkadza Ci uruchamianie lokalnego oprogramowania i zależy Ci na wyszukiwaniu semantycznym i odpowiedziach w języku naturalnym w ramach niewielkiej biblioteki dokumentów. Jest również przydatna, gdy dostęp do internetu jest zawodny lub gdy chcesz uzyskać przewidywalne koszty lokalne po pobraniu modeli.
Rozwiązanie to jest mniej odpowiednie, jeśli Twój komputer nie obsługuje odpowiedniego modelu lokalnego, potrzebujesz bezproblemowego dostępu z wielu urządzeń spoza sieci domowej lub potrzebujesz tożsamości klasy korporacyjnej, audytu, zabezpieczeń prawnych, scentralizowanego zarządzania kluczami lub gwarantowanego wsparcia. W takich przypadkach właściwym rozwiązaniem może być zarządzane wdrożenie prywatne lub platforma RAG dla przedsiębiorstw, a nie konfiguracja z jednym komputerem.
Kompaktowa lista kontrolna konfiguracji
Zainstaluj Ollamę i sprawdź wnioskowanie lokalnego modelu.
Zainstaluj dedykowany model osadzania, taki jak ten wymieniony w aktualnej dokumentacji Ollama dotyczącej osadzania.
Uruchom AnythingLLM lokalnie z trwałym magazynem danych.
Połącz AnythingLLM z lokalnym punktem końcowym Ollama, używając prawidłowego adresu hosta dla wybranej metody wdrożenia.
Jeśli chcesz pobierać wyłącznie dokumenty lokalne, użyj lokalnej bazy danych wektorowych, takiej jak domyślna baza danych LanceDB firmy AnythingLLM.
Utwórz przestrzeń roboczą o wąskim zakresie.
Zacznij od kilku znanych dokumentów i zweryfikuj ich wyodrębnienie.
Używaj RAG w przypadku dużych kolekcji wielokrotnego użytku i dołączaj pełne teksty tylko wtedy, gdy dokument pasuje do kontekstu modelu.
Zanim zaufasz systemowi, sprawdź pytania, na które można odpowiedzieć, i te, na które nie można odpowiedzieć.
Wyłącz niepotrzebne integracje zewnętrzne i telemetrię zgodnie ze swoimi wymaganiami dotyczącymi prywatności.
Wykonaj kopię zapasową dokumentów źródłowych i trwałego magazynu aplikacji, a następnie przetestuj przywracanie.