Strona główna
» Domeny
»
Jak naprawić błąd „Przekroczone okno kontekstowe” w analizie długiego dokumentu bez utraty kluczowych dowodów
Jak naprawić błąd „Przekroczone okno kontekstowe” w analizie długiego dokumentu bez utraty kluczowych dowodów
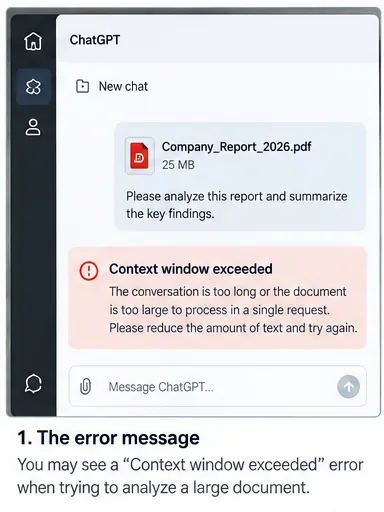
Przesyłasz długi raport, prosisz o szczegółową analizę, a zamiast odpowiedzi otrzymujesz komunikat w rodzaju „Przekroczono limit okna kontekstowego”, „Przekroczono maksymalną długość kontekstu” lub kolejne ostrzeżenie, że żądanie jest zbyt duże. Frustrujące jest to, że plik mógł zostać przesłany pomyślnie, a ten sam dokument mógł nawet zadziałać w przypadku węższego pytania.
Powód jest prosty, ale łatwy do przeoczenia: limit przesyłania i okno kontekstowe modelu to nie to samo. Model musi zmieścić materiał, który aktywnie analizuje, w skończonym budżecie tokenów. Budżet ten może obejmować instrukcje, historię konwersacji, tekst pobrany z plików, definicje narzędzi, pobrane fragmenty, tokeny rozumowania i miejsce na odpowiedź. Dokument może zatem nadawać się do przesłania, ale jednocześnie być zbyt duży, aby przeanalizować go w jednym przejściu.
Najlepszym rozwiązaniem jest zazwyczaj unikanie ciągłego powtarzania tego samego, ogromnego monitu. Zacznij od zmian najmniej uciążliwych, a następnie przejdź do fragmentacji, pobierania lub przepływu pracy z szerszym kontekstem tylko wtedy, gdy prostsze podejście nadal zawodzi.
Najpierw sprawdź, czy błąd rzeczywiście dotyczy okna kontekstowego
Przed zmianą dokumentu należy odróżnić błąd kontekstu od limitu przesyłania lub przechowywania. Aktualne wytyczne OpenAI dotyczące przesyłania plików mówią, że pliki przesyłane do ChatGPT lub GPT mają sztywny limit 512 MB na plik, podczas gdy pliki tekstowe i dokumenty mają limit 2 milionów tokenów na plik. Są to limity przesyłania, a nie obietnica, że cały tekst zostanie umieszczony w aktywnym kontekście modelu jednocześnie.
FAQ dotyczące przesyłania plików OpenAI to wiarygodne źródło informacji o aktualnych limitach przesyłania. Dokładne limity różnią się w zależności od produktu, planu, modelu i dostawcy, więc nie zakładaj, że limit skopiowany ze starego artykułu nadal obowiązuje.
Co widzisz
Prawdopodobne wąskie gardło
Najlepszy pierwszy ruch
Plik jest odrzucany przed rozpoczęciem analizy
Rozmiar pliku, typ pliku, miejsce na dane lub limit przesyłania
Sprawdź aktualne zasady przesyłania
Plik został przesłany, ale długi monit kończy się błędem kontekstowym
Aktywne żądanie przekracza budżet kontekstowy modelu
Skróć żądanie i zmniejsz aktywny kontekst
Odpowiedź obejmuje początkowe strony, ale pomija późniejsze sekcje
Nie wszystkie materiały zostały umieszczone bezpośrednio w kontekście lub wyszukiwanie pominęło istotne fragmenty
Zadaj węższe pytania lub podziel je według sekcji
Rozmowa działała wcześniej, ale po wielu turach kończy się niepowodzeniem
Zgromadzona historia czatów pochłania kontekst
Rozpocznij nowy wątek analizy z podsumowaniem przekazania w formie kompaktowej
Po pomyślnym przesłaniu dokumentu może pojawić się błąd okna kontekstowego, ponieważ aktywne żądanie musi nadal mieścić się w budżecie tokenów modelu.
Krok 1: Zmierz dokument przed jego zmianą
Liczba stron i megabajty to przydatne wskazówki, ale tokeny to miara, która ma znaczenie dla kontekstu tekstu. Tokenizacja zależy od języka, formatowania, interpunkcji i kodowania modelu, więc 100-stronicowy podręcznik techniczny może wymagać zupełnie innej liczby tokenów niż 100-stronicowy pokaz slajdów.
Wskazówki OpenAI dotyczące liczenia tokenów zalecają sprawdzenie okna kontekstowego modelu docelowego i pozostawienie miejsca na dane wyjściowe, a w przypadku modeli wnioskowania – na tokeny wnioskowania. Wskazują również, że struktura wiadomości, narzędzia, pliki, obrazy i schematy mogą dodawać tokeny wykraczające poza zwykły tekst, który jest liczony.
Aby szybko dokonać selekcji, zanotuj liczbę stron pliku, przybliżoną liczbę słów, liczbę głównych sekcji oraz to, czy zawiera on dodatki, powtarzające się sformułowania prawnicze, surowe zapisy, transkrypcje, tabele lub odniesienia, których tak naprawdę nie potrzebujesz do wykonania zadania.
Przed przystąpieniem do rozwiązywania problemów sprawdź skalę dokumentu. Rozmiar pliku i liczba stron to tylko wartości przybliżone; użycie tokenów jest bardziej istotnym ograniczeniem w analizie tekstu.
Krok 2: Skróć aktywną konwersację przed dotknięciem pliku
Jeśli dokument nie jest wyjątkowo duży, najtańszym rozwiązaniem może być usunięcie nagromadzonego kontekstu zamiast dzielenia pliku. Rozpocznij nową rozmowę lub prośbę i przenieś tylko te instrukcje, które są istotne. Zastąp długą wymianę zdań krótkim poleceniem, na przykład: „Przeanalizuj załączony raport pod kątem czynników generujących przychody, istotnych ryzyk i wytycznych dla kierownictwa. Zwróć pięć wniosków wraz z odnośnikami do stron lub sekcji”.
Usuń również powtarzające się materiały tła, niepotrzebne przykłady, duplikaty wklejonego tekstu i wcześniejsze wersje robocze. Jeśli korzystasz z przepływu pracy API, licz całe żądanie, a nie tylko dokument. Żądanie, które ledwo się mieści, pozostawia niewiele miejsca na odpowiedź i może nieprzewidywalnie zakończyć się niepowodzeniem wraz z rozrastaniem się instrukcji lub schematów narzędzi.
Znak sukcesu: ten sam plik działa w nowym wątku z zawężonym monitem. Jeśli tak, problem stanowił przynajmniej częściowo nagromadzony kontekst, a nie sam dokument.
Krok 3: Zawęż pytanie i żądany wynik
„Przeanalizuj wszystko w tym 400-stronicowym dokumencie i napisz kompleksowy raport” zmusza system do rozważenia wielu tematów jednocześnie. Zamiast tego zadawaj jedno pytanie na raz. Na przykład, najpierw zapytaj o główne ryzyka dokumentu, następnie o założenia finansowe, a na końcu o sprzeczności między twierdzeniami kierownictwa a danymi je potwierdzającymi.
Zachowaj ograniczony format odpowiedzi. Prośba o 20-stronicowy wynik pochłania znacznie większy budżet niż prośba o 10-wierszową tabelę dowodów. Zawsze możesz rozszerzyć ostateczną odpowiedź po zebraniu dowodów.
Przydatny, ukierunkowany temat brzmi: „Korzystając tylko z tego dokumentu, zidentyfikuj maksymalnie osiem twierdzeń dotyczących odejścia klientów. Dla każdego twierdzenia podaj numer sekcji lub strony, jednozdaniowe wyjaśnienie oraz wszelkie podane ograniczenia. Jeśli dokument nie zawiera wystarczających dowodów, poinformuj o tym”.
Kiedy przejść dalej: jeśli pytanie szczegółowe nadal powoduje ten sam błąd lub jeśli potrzebujesz wiarygodnego omówienia całego dokumentu, a nie tylko jednego tematu, podziel źródło.
Krok 4: Podziel dokument według znaczenia, a nie tylko według równej liczby stron
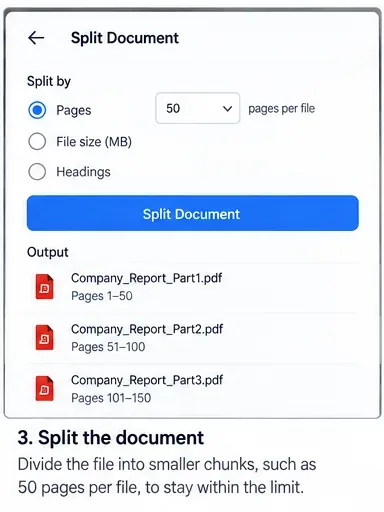
Podział na fragmenty to najskuteczniejsze, uniwersalne rozwiązanie w przypadku bardzo długich dokumentów. Podziel plik wzdłuż naturalnych granic, takich jak rozdziały, sekcje raportu, kontrakty, załączniki, zakresy dat lub kolejność mówców. Logiczne fragmenty zachowują kontekst lepiej niż arbitralne cięcia co 50 stron.
Jeśli sekcja jest silnie zależna od poprzedniej, należy dodać niewielki fragment lub krótką notatkę łączącą, opisującą poprzednią sekcję. Należy wyraźnie nazwać części, na przykład 01_Executive_Summary.pdf, 02_Financial_Results.pdf, i 03_Risk_Factors.pdf. W miarę możliwości należy zachować numerację stron oryginału, aby umożliwić weryfikację ostatecznej syntezy.
Podziel bardzo długi tekst źródłowy na logiczne, jasno nazwane sekcje. Zachowaj odniesienia do oryginalnych stron lub sekcji, aby późniejsza synteza mogła zostać zweryfikowana ze źródłem.
Krok 5: Przeanalizuj każdy fragment, korzystając z tego samego schematu dowodów
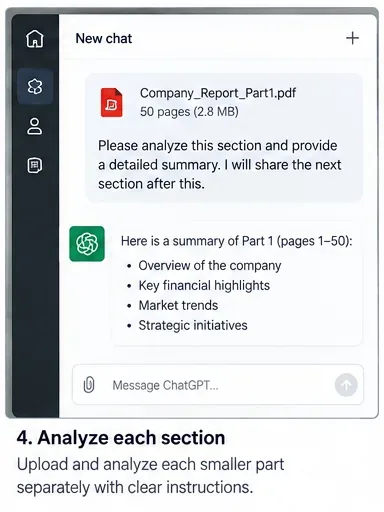
Nie proś jedynie o swobodne podsumowanie każdej części. Użyj tej samej struktury dla każdego fragmentu, aby umożliwić scalanie wyników bez utraty istotnych różnic. Praktyczny schemat może zawierać nazwę sekcji, kluczowe ustalenia, dowody, odniesienie do strony lub nagłówka, wątpliwości i pytania otwarte.
Na przykład: „Przeanalizuj tylko część 3. Zwróć: (1) pięć lub mniej istotnych ustaleń, (2) dowody dla każdego ustalenia, (3) oryginalną stronę lub odniesienie do sekcji, (4) wszelkie zastrzeżenia autora oraz (5) pytania, które należy sprawdzić w innej sekcji. Nie wyciągaj wniosków z faktów, które nie zostały ujęte w tej części”.
Takie podejście ułatwia również ocenę jakości. Jeśli podsumowanie fragmentu zawiera twierdzenia bez lokalizacji źródeł, popraw ten fragment przed kontynuacją, zamiast liczyć na to, że ostateczna synteza to naprawi.
Analizuj jedną sekcję na raz, stosując ustalony format wyjściowy, dzięki czemu wszystkie częściowe wyniki można później połączyć i prześledzić do źródła.
Krok 6: Utwórz podsumowanie podsumowań zamiast przeładowywać każdy pełny fragment
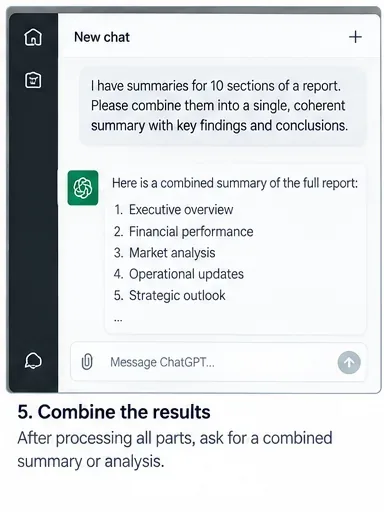
Po przeanalizowaniu części, stwórz zwarty pakiet dowodów z wyników fragmentów i dokonaj syntezy. Nie wysyłaj automatycznie każdego oryginalnego fragmentu i każdego podsumowania w jednym, ostatecznym żądaniu; może to spowodować ten sam problem kontekstowy.
Polecenie syntezy powinno nakazać modelowi zachowanie rozbieżności i luk. Na przykład: „Połącz analizy tych sekcji w jeden raport. Scal zduplikowane ustalenia, zachowaj sprzeczne dowody jako oddzielne punkty, zachowaj wszystkie odniesienia źródłowe i oznacz wszelkie pytania, których nie można rozstrzygnąć na podstawie podsumowań”.
Ta hierarchiczna metoda jest szczególnie przydatna w przypadku książek, dokumentów regulacyjnych, zestawów odkryć, długich zbiorów wywiadów i badań wielodokumentowych. Jej głównym ograniczeniem jest kompresja informacji: szczegóły pominięte w podsumowaniu fragmentu nie mogą magicznie pojawić się ponownie później. Dlatego schemat dowodów i odniesienia do źródeł są tak ważne.
Łącz zwarte analizy sekcji, zamiast ponownie ładować cały tekst źródłowy. Zachowaj cytowania, rozbieżności i nierozstrzygnięte pytania podczas syntezy.
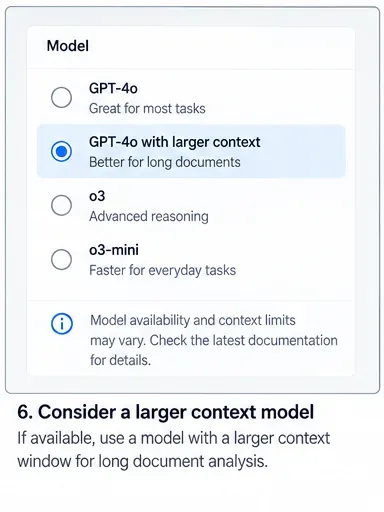
Krok 7: Rozważ model szerszego kontekstu, ale nie traktuj go jako kompletnego rozwiązania
Model z większym oknem kontekstowym może zmniejszyć agresywność potrzebną do fragmentacji. Aktualna dokumentacja modelu OpenAI zawiera listę limitów okna kontekstowego i maksymalnej wartości wyjściowej dla modeli API, a wartości te mogą ulec zmianie wraz z aktualizacją modeli.
Jednak rozmiar kontekstu nagłówka modelu niekoniecznie odpowiada rozmiarowi przesłanego pliku, który produkt umieszcza bezpośrednio w monicie. Wskazówki OpenAI dotyczące plików dla przedsiębiorstw opisują obecnie oddzielny proces „upychania kontekstu” dla przesłanych dokumentów tekstowych: do 110 000 tokenów z przesłanych dokumentów może zostać umieszczonych bezpośrednio w kontekście, a dodatkowy materiał będzie dostępny za pośrednictwem prywatnego indeksu wyszukiwania. OpenAI wyraźnie zaznacza, że to rozwiązanie jest w fazie rozwoju i może ulec zmianie. Zobacz Optymalizacja przesyłania plików w ChatGPT Enterprise .
Praktyczna lekcja polega na tym, aby wybrać model szerszego kontekstu, gdy znacząco upraszcza to przepływ pracy, ale jednocześnie sprawdzać, czy odpowiednie sekcje są rzeczywiście uwzględniane. Szerszy kontekst nie eliminuje potrzeby dobrego określenia zakresu, odniesień do źródeł ani weryfikacji.
Model obejmujący szerszy kontekst może okazać się pomocny, jednak zamiast opierać się na ogólnych wartościach, zweryfikuj limity dla konkretnego modelu i powierzchni produktu.
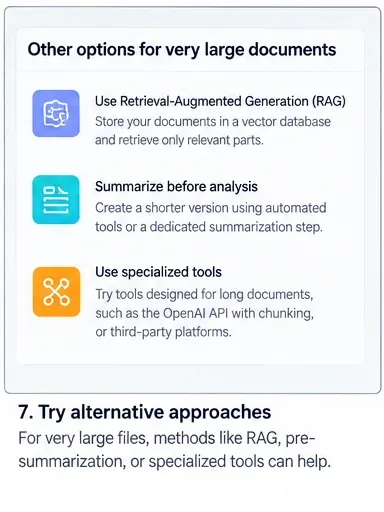
Krok 8: W przypadku bardzo dużych korpusów przejdź z trybu „wypełnij wszystko” na tryb pobierania
Jeśli zadanie obejmuje setki lub tysiące stron, wyszukiwanie jest zazwyczaj lepszym rozwiązaniem niż próba umieszczenia całego korpusu w jednym poleceniu. Systemy wyszukiwania indeksują źródło, wyszukują fragmenty istotne dla bieżącego pytania i umieszczają tylko te fragmenty w aktywnym kontekście.
Dokumentacja wyszukiwania plików OpenAI opisuje hostowane narzędzie do wyszukiwania przesłanych plików w bazach wektorowych. Wyszukiwanie działa szczególnie dobrze w przypadku pytań ukierunkowanych, takich jak „Które sekcje definiują terminację dla wygody?” lub „Gdzie raport omawia koncentrację łańcucha dostaw?”.
Wyszukiwanie jest mniej niezawodne, gdy zadanie rzeczywiście wymaga jednoczesnego śledzenia każdego fragmentu, na przykład gdy trzeba udowodnić, że dany temat nigdy się nie pojawia, porównać każdą komórkę tabeli w ogromnej kolekcji lub przeprowadzić wyczerpującą transformację wiersz po wierszu. W takich przypadkach, oprócz wyszukiwania, należy zastosować systematyczne przetwarzanie wsadowe lub wstępne przetwarzanie oparte na kodzie.
W przypadku korpusów, które po podziale na fragmenty pozostają zbyt duże, wyszukiwanie może spowodować umieszczenie w aktywnym kontekście dla każdego pytania tylko najistotniejszych fragmentów.
Programiści korzystający z interfejsu API OpenAI Responses mają dodatkową możliwość wyboru. Dokumentacja API opisuje truncationustawienie: z disabled, które jest udokumentowaną wartością domyślną, żądanie, które przekraczałoby okno kontekstowe modelu, kończy się niepowodzeniem; z auto, wcześniejsze elementy konwersacji można usunąć, aby żądanie pasowało. Zobacz dokumentację API Responses .
Automatyczne obcinanie może zapobiec poważnej awarii, ale zmienia informacje dostępne dla modelu. W przypadku analizy dokumentów, ciche usunięcie wczesnego kontekstu może być bardziej szkodliwe niż otrzymanie błędu. Używaj tej funkcji tylko wtedy, gdy aplikacja jest zaprojektowana w taki sposób, że starsze elementy konwersacji są zbędne lub zostały już podsumowane gdzie indziej.
Jak sprawdzić, czy poprawka faktycznie zadziałała
Skuteczne zgłoszenie nie wystarczy. Celem jest analiza, która da się obronić, obejmująca odpowiedni materiał, bez utraty dowodów. Przetestuj wynik, zanim uznasz problem za rozwiązany.
Weryfikacja zakresu: potwierdź, czy każdy wymagany rozdział, zakres dat lub plik źródłowy pojawia się w planie analizy lub tabeli dowodów końcowych.
Weryfikacja identyfikowalności: pobierz próbki ważnych roszczeń i zweryfikuj ich odnośniki do stron, sekcji lub plików w oparciu o oryginalne źródło.
Sprawdzanie granic: sprawdź ustalenia w pobliżu granic fragmentów, aby upewnić się, że koncepcja nie została podzielona lub sprzeczna w różnych częściach.
Kontrola negatywna: zadaj jedno pytanie, na które wiadomo, że nie ma odpowiedzi. Dobry obieg pracy powinien zakładać brak dowodów, a nie je wymyślać.
Kontrola powtarzalności: powtórz kilka reprezentatywnych pytań. Duże zmiany w cytowanych dowodach mogą wskazywać na słabe wyszukiwanie lub zbyt szeroki zakres pytań.
Kontrola budżetu: jeśli używasz interfejsu API, sprawdź faktyczne wykorzystanie tokenów wejściowych i wyjściowych zamiast polegać wyłącznie na szacunkach dotyczących liczby słów.
Ostatnim krokiem jest weryfikacja: sprawdź zasięg, odniesienia do źródeł, granice fragmentów i niepotwierdzone twierdzenia, zanim zaufasz połączonej analizie.
Czego nie robić
Nie przesyłaj ponownie tego samego, przewymiarowanego żądania i nie oczekuj innego limitu tokenów. Nie usuwaj odniesień do źródeł podczas dzielenia na fragmenty. Nie zakładaj, że akceptacja pliku oznacza, że każda strona jest aktywna w kontekście. I nie rozwiązuj błędu, skracając odpowiedź tak agresywnie, że analiza nie będzie już w stanie spełnić zadania.
Unikaj również traktowania automatycznego obcinania jako niewidzialnej magii. Jeśli system usunie starsze elementy, żądanie może zostać zrealizowane, ale utracić instrukcje lub dowody, które miały znaczenie. W przypadku analiz o wysokiej stawce, jawne grupowanie i pobieranie danych są zazwyczaj łatwiejsze do audytu.
Praktyczna zasada decyzyjna
Jeśli nowy wątek i węższe pytanie działają, zachowaj prostotę przepływu pracy. Jeśli zadanie wymaga szerokiego omówienia jednego długiego dokumentu, podziel go na logiczne sekcje i syntetyzuj ustrukturyzowane analizy fragmentów. Jeśli wielokrotnie przeszukujesz bardzo dużą kolekcję dokumentów, użyj pobierania. Jeśli kontrolujesz API i nadal zbliżasz się do limitu, zmierz tokeny, zarezerwuj miejsce na dane wyjściowe, wybierz odpowiedni model i spraw, aby obcinanie było wyraźną decyzją projektową.
Najsilniejszy wynik to nie ten, który zawiera najwięcej tekstu w jednym żądaniu. To taki, który obejmuje wymagane dowody, zapewnia identyfikowalność i pozwala na jednoznaczne wskazanie, gdy informacje nie są dostępne.