Strona główna
» Domeny
»
Jak skrócić czas renderowania w ComfyUI dla przepływu pracy SDXL
Jak skrócić czas renderowania w ComfyUI dla przepływu pracy SDXL
Najszybszym sposobem na skrócenie czasu renderowania w przepływie pracy ComfyUI SDXL jest zazwyczaj zmniejszenie ilości pracy dyfuzyjnej przed zmianą flag uruchamiania niskiego poziomu: testuj w rozsądnej rozdzielczości SDXL, utrzymuj rozmiar partii na poziomie 1 podczas strojenia, wykonuj mniej kroków próbkowania, gdy jakość nadal jest stabilna, i tymczasowo pomiń kosztowne dodatki, takie jak rafinery, gałęzie ControlNet, przebiegi upscale lub preprocesory. Dopiero potem dostosuj działanie pamięci VRAM, uwagi, podglądu i pamięci podręcznej.
Ta kolejność ma znaczenie, ponieważ flagi startowe nie są w stanie zrekompensować przepływu pracy, który po prostu wymaga od GPU wykonania dwa lub trzy razy więcej pracy niż jest to konieczne. Aktualna dokumentacja ComfyUI zaleca również najpierw obniżenie rozdzielczości lub rozmiaru partii, gdy generowanie jest wolne, a następnie w razie potrzeby optymalizację pamięci i uwagi. Poniższe wskazówki zostały sprawdzone pod kątem aktualnej dokumentacji ComfyUI i PyTorch 13 września 2026 r.
Dlaczego przepływy pracy SDXL stają się wolniejsze w ComfyUI
Renderowanie SDXL może być realizowane w kilku różnych procesach: ładowaniu lub przenoszeniu wag modelu, kodowaniu tekstu CLIP, wielokrotnym odszumianiu w KSampler, ControlNet lub innym procesie kondycjonowania, dekodowaniu VAE, skalowaniu w górę oraz dowolnym etapie drugiego przejścia lub rafinacji. Jeśli pamięć VRAM jest ograniczona, dodatkowe transfery z procesora do karty graficznej mogą zwiększyć opóźnienie.
Oznacza to, że dwóch użytkowników korzystających z tego samego procesora graficznego (GPU) może mieć bardzo różne czasy renderowania. Podstawowy graf tekst-obraz klasy 1024 nie jest porównywalny z procesem, który wymaga użycia rafinera, dwóch sieci ControlNets, drugiego przebiegu o wysokiej rozdzielczości i dużej partii danych. Celem jest zidentyfikowanie, która część wykresu jest kosztowna, a następnie usunięcie lub zoptymalizowanie tej części bez utraty jakości wydruku, na której Ci naprawdę zależy.
1. Przed zmianą czegokolwiek zmierz czystą linię bazową
Użyj jednego stałego monitu, jednego stałego ziarna, rozmiaru partii 1 i tej samej rozdzielczości wyjściowej. Uruchom przepływ pracy co najmniej dwa razy. Pierwsze uruchomienie może obejmować ładowanie punktów kontrolnych, kompilację, wejście/wyjście dysku lub transfer modelu; późniejsze uruchomienie jest lepszym miernikiem szybkości generowania w stanie ustalonym.
Sprawdź również, czy GPU faktycznie wykonuje zadanie. W systemach NVIDIA nvidia-smimoże pokazać użycie pamięci VRAM i obciążenie GPU. Jeśli użycie GPU pozostaje niskie, podczas gdy system stale przesyła dane lub ładuje modele, wąskim gardłem może być obciążenie pamięci lub wejście/wyjście, a nie sam sampler.
Sprawdź zachowanie GPU i pamięci VRAM przed dostrojeniem ComfyUI. Pokazane wartości należy traktować jako przykładowy układ, a nie cel testu porównawczego.
2. Zacznij od najmniejszego wykresu SDXL, który generuje potrzebny Ci wynik
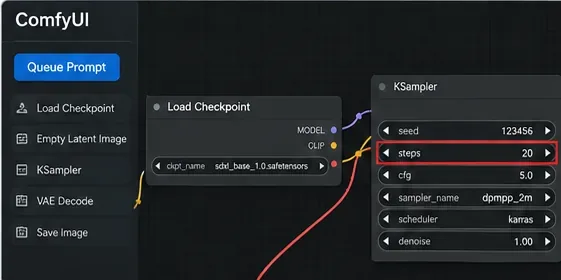
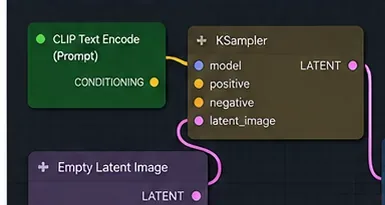
Przed optymalizacją złożonego przepływu pracy porównaj go z minimalną ścieżką: ładowanie punktów kontrolnych, warunkowanie podpowiedzi, pusty obraz utajony, KSampler, dekodowanie VAE i zapisywanie obrazu. Oficjalne przykłady ComfyUI pokazują, że podstawowy punkt kontrolny SDXL może być używany jak zwykły punkt kontrolny. Jeśli ten podstawowy graf jest szybki, a graf produkcyjny jest wolny, problemem są dodatkowe gałęzie.
Na potrzeby projektu tymczasowo pomiń komponenty, które nie są niezbędne do podjęcia bieżącej decyzji. Przykładami mogą być: rafiner, drugi przebieg skalowania, preprocesory obrazu, wiele sieci ControlNet lub opcjonalne gałęzie stylów. Włączaj je ponownie pojedynczo po zaakceptowaniu obrazu bazowego.
Mały wykres SDXL to najlepszy punkt odniesienia. Dodaj kosztowne gałęzie dopiero po ustaleniu, ile czasu zajmuje każda z nich.
3. Zmniejsz liczbę kroków KSamplera przed rozpoczęciem poszukiwań egzotycznych ustawień prędkości
Kroki próbkowania są jednym z najwyraźniejszych narzędzi, ponieważ każdy dodatkowy krok odszumiania dodaje pracy. Zmniejszenie liczby kroków z wyższej wartości do niższej spowoduje skrócenie czasu próbkowania renderowania, chociaż całkowity czas zegara ściennego nie skróci się dokładnie o tę samą wartość procentową, ponieważ ładowanie modelu, kodowanie podpowiedzi, dekodowanie VAE i inne węzły nadal zajmują czas.
Nie kopiuj uniwersalnej „najlepszej” liczby kroków od kogoś innego. Prawidłowa liczba zależy od punktu kontrolnego, samplera, harmonogramu, monitu, CFG i celu jakości. Praktyczną metodą jest utrzymanie stałego poziomu początkowego i przetestowanie małej drabiny – na przykład bieżącego ustawienia, następnie niewielkiej redukcji, a potem kolejnej. Zatrzymaj się, gdy tekstury, anatomia, typografia lub wierność monitu ulegną pogorszeniu bardziej, niż jesteś gotów zaakceptować.
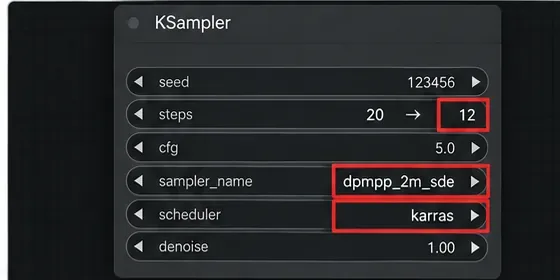
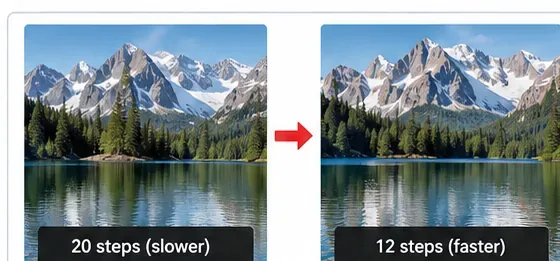
Obniżenie liczby kroków KSampler może skrócić czas odszumiania. Podane wartości mają charakter poglądowy; sprawdź jakość za pomocą własnego punktu kontrolnego i ustalonego ziarna.
4. Kontroluj rozdzielczość testów i wielkość partii
W przypadku SDXL, oficjalne przykłady SDXL ComfyUI zalecają rozdzielczość 1024×1024 lub inne proporcje obrazu o mniej więcej tej samej liczbie pikseli, takie jak 896×1152 lub 1536×640, dla optymalnego działania modelu bazowego. Znaczne przekroczenie tego limitu pikseli zwiększa rozmiar obrazu, a tym samym zużycie pamięci i zasobów obliczeniowych.
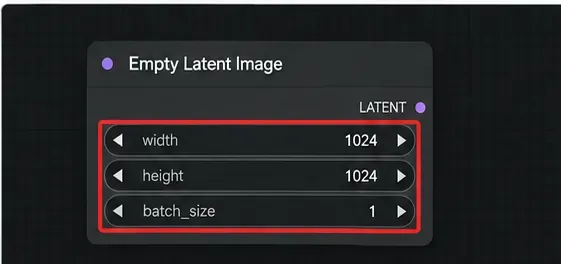
Podczas dostrajania szybkości i przepływu pracy należy zachować batch_sizewartość 1, chyba że jest to konieczne do przeprowadzenia testów przepustowości. Partia czterech obrazów wymaga od potoku wygenerowania czterech obrazów w jednym wykonaniu; może to poprawić przepustowość w niektórych konfiguracjach, ale nie minimalizuje czasu do wygenerowania pierwszego obrazu i zwiększa zapotrzebowanie na pamięć.
Jeśli ostateczny produkt musi być większy niż standardowa rozdzielczość bazowa SDXL, rozważ oddzielenie „testowania kompozycji” od końcowego etapu w wysokiej rozdzielczości. Najpierw zadbaj o odpowiedni prompt, seed, kondycjonowanie i kompozycję, a następnie zapłać za kosztowne, rozszerzone lub drugie przejście tylko dla wybranych kandydatów.
Utajony sygnał klasy 1024 z rozmiarem partii 1 stanowi rozsądną bazę dostrajania SDXL przed przebiegami o wyższej rozdzielczości lub wieloma obrazami.
5. Porównuj próbniki i harmonogramy zamiast zakładać, że jeden z nich jest zawsze najszybszy
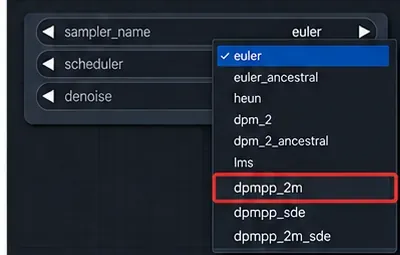
ComfyUI udostępnia wiele opcji samplera i harmonogramu w KSampler. Różne kombinacje pozwalają osiągnąć akceptowalną jakość w różnej liczbie kroków, więc „najszybszy” powinien oznaczać najszybszy przy wymaganej jakości , a nie tylko najkrótszy pojedynczy przebieg.
Porównując, użyj tego samego punktu kontrolnego, monitu, ziarna, rozdzielczości i CFG. Zmień tylko sampler lub harmonogram, a następnie porównaj czas renderowania i jakość widoczną. Jeśli jedna kombinacja wymaga znacznie mniej kroków dla punktu kontrolnego, zachowując jednocześnie pożądany rezultat, to prawdziwy zysk na szybkości. Jeśli odzyskanie szczegółów wymaga dodatkowych kroków, pozorna przewaga może zniknąć.
Zmieniaj jedną zmienną samplera na raz i porównuj ją z ustalonym ziarnem. Nie zakładaj, że sampler jest szybszy dla każdego punktu kontrolnego SDXL lub celu jakościowego.
6. Usuń zbędne obliczenia graficzne i wykorzystaj model wykonania ComfyUI na swoją korzyść
ComfyUI został zaprojektowany do wykonywania tylko tych części grafu, które wymagają uruchomienia. Dokumentacja projektu stwierdza, że niezmienione fragmenty mogą być ponownie wykorzystywane między uruchomieniami, a obecny backend zawiera konfigurowalne buforowanie wyników węzłów. Jest to przydatne, gdy zmieniasz tylko wartość podrzędną, zamiast przebudowywać cały przepływ pracy.
W miarę możliwości dbaj o stabilność węzłów ładujących i kosztownego przetwarzania nadrzędnego. Jeśli ciągle zmieniasz punkty kontrolne, wielokrotnie zmieniasz rozmiar dużych obrazów lub unieważniasz węzły nadrzędne, tracisz korzyści płynące z buforowania.
ComfyUI posiada również udokumentowaną funkcję Partial Execution , która może uruchomić tylko część przepływu pracy wymaganą dla wybranego węzła wyjściowego. Użyj jej, gdy testujesz gałąź podrzędną i nie potrzebujesz regenerować każdego wyjścia w dużym grafie.
Uproszczony wykres ułatwia dostrzeżenie wąskich gardeł. Wykorzystaj buforowanie i częściowe wykonywanie, aby uniknąć niepotrzebnego powtarzania niezmienionych zadań w górnym biegu strumienia.
7. Dostrój podglądy, buforowanie, tryb pamięci VRAM i uwagę dopiero po osiągnięciu wydajności wykresu
Obecne opcje wiersza poleceń ComfyUI udostępniają kilka opcji kontroli wydajności. Ich działanie zależy od sprzętu i dostępnej pamięci, dlatego należy traktować je jako opcje testowe, a nie jako obowiązkowe przełączniki.
Ustawienie
Kiedy może pomóc
Główny kompromis
--preview-method none
Jeśli podglądy samplera są włączone i interesuje Cię tylko wynik końcowy
Tracisz podglądy na żywo. Obecny interfejs CLI domyślnie nie używa podglądów.
--highvram
Jeśli masz wystarczająco dużo pamięci VRAM, a wielokrotne rozładowywanie/ponowne ładowanie modelu zabiera czas
Utrzymuje modele w pamięci GPU i może powodować błędy braku pamięci w przypadku kart o mniejszej pojemności.
--lowvram
Jeśli w inny sposób przepływ pracy nie mieści się w pamięci VRAM
Jest to przede wszystkim tryb oszczędzania pamięci, a nie tryb szybkości; obciążenie procesora lub transfery mogą zwiększać opóźnienie.
--use-pytorch-cross-attention
Warto przeprowadzić test porównawczy na nowoczesnych kombinacjach PyTorch/GPU
Nie należy łączyć bezmyślnie wzajemnie wykluczających się flag trybu uwagi.
--use-flash-attention
Warto przetestować, gdy Twój stos sprzętowy/programowy obsługuje zoptymalizowaną ścieżkę
Dostępność i korzyści zależą od obsługiwanych danych wejściowych i jąder.
--cache-classicLub--cache-lru N
Powtarzające się przepływy pracy, w których dodatkowa pamięć podręczna jest akceptowalna
Można używać więcej pamięci RAM/VRAM.
--cache-none
Tylko wtedy, gdy redukcja pamięci podręcznej jest ważniejsza niż szybkość
Interfejs wiersza poleceń ComfyUI mówi, że każdy węzeł będzie wykonywany przy każdym przebiegu, więc zwykle jest to gorsze pod względem czasu renderowania.
Obecny interfejs CLI udostępnia również asynchroniczne odciążanie wag, a w tekście pomocy podano, że jest ono domyślnie włączone w systemie NVIDIA. Oznacza to, że dodanie większej liczby flag nie jest automatycznie optymalizacją; najpierw sprawdź bieżące polecenie uruchamiania i logi.
Skalowana funkcja uwagi iloczynu skalarnego w PyTorchu może automatycznie wybierać zoptymalizowane implementacje CUDA, takie jak FlashAttention lub pamięćooszczędna, gdy pozwalają na to wejścia i sprzęt. Właśnie dlatego nowoczesne ścieżki uwagi mogą mieć znaczenie, ale dokładne wzmocnienie zależy od sprzętu. Unikaj podawania ogólnych wartości procentowych, jakby dotyczyły one Twojego procesu pracy z SDXL.
8. Utrzymuj kolejkowanie i zachowanie partii zgodne z Twoim celem
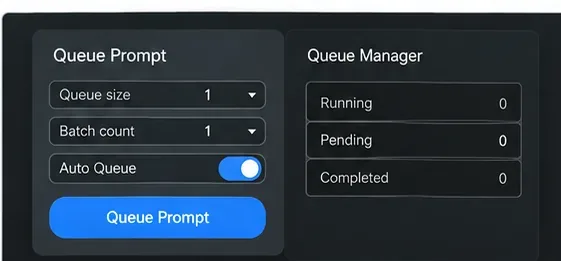
Jeśli priorytetem jest najszybsza pętla sprzężenia zwrotnego, dodawaj obrazy do kolejki po jednym obrazie na raz podczas strojenia. Duża liczba kolejek i partii jest przydatna, gdy znasz już ustawienia i zależy Ci na przepustowości, ale nie sprawi, że pierwszy obraz dotrze szybciej.
Po sfinalizowaniu przepływu pracy można oddzielnie porównać przepustowość. W tym momencie większy pakiet może mieć sens, jeśli pozwala na to pamięć VRAM i jeśli łączna liczba obrazów na minutę ma większe znaczenie niż opóźnienie dla każdego obrazu.
Użyj jednego obrazu w kolejce i rozmiaru partii 1 do interaktywnego dostrajania; większe partie przetestuj później, gdy celem będzie przepustowość.
Jak stwierdzić, czy optymalizacja faktycznie zadziałała
Szybsze uruchomienie jest przydatne tylko wtedy, gdy obraz nadal spełnia wymagania. Porównaj stan przed i po, używając tego samego ziarna i tego samego monitu. Sprawdź obszary, które jako pierwsze nie sprawdzają się przy zbyt agresywnych ustawieniach: mały tekst, dłonie i twarze, powtarzające się wzory, delikatne materiały, detale krawędzi oraz zgodność z atrybutami specyficznymi dla monitu.
Zanotuj co najmniej te cztery elementy dla każdego testu: całkowity czas wykonania, kroki próbkowania, rozdzielczość oraz informację, czy nastąpiło załadowanie modelu. Jeśli pierwsze uruchomienie trwa 30 sekund, a drugie 12 sekund, nie przypisuj automatycznie zmiany próbnika – pierwsze uruchomienie mogło po prostu pokryć koszt załadowania punktu kontrolnego.
Użyj równoległych porównań z ustalonym ziarnem, aby zdecydować, czy niższa liczba kroków jest akceptowalna. Etykiety na ilustracjach ilustrują metodę i nie stanowią wyników porównawczych.
Praktyczny porządek optymalizacji
Przeprowadź test porównawczy rozgrzanego biegu. Zachowaj stałe parametry seed, prompt, rozdzielczość i partię.
Usuń niepotrzebne gałęzie. Przetestuj ścieżkę bazową SDXL bez rafinera, ControlNet, upscale'a ani opcjonalnych preprocesorów.
Zmniejsz liczbę kroków. Znajdź najniższą liczbę kroków, która nadal spełnia Twoje wymagania jakościowe.
Zachowaj rozsądną rozdzielczość. Przed dokończeniem pracy w wysokiej rozdzielczości dostosuj budżet SDXL do 1024 pikseli.
Podczas iteracji utrzymuj partię na poziomie 1. Optymalizuj przepustowość dopiero po ustabilizowaniu przepływu pracy.
Porównaj dostępne opcje próbnika/planisty. Oceń prędkość przy akceptowalnej jakości.
Używaj buforowania i częściowego wykonywania. Unikaj ponownego uruchamiania niezmienionej pracy w strumieniu.
Następnie flagi startowe testu porównawczego. Testuj podgląd, pamięć VRAM, pamięć podręczną i zmiany uwagi pojedynczo.
Kiedy zamiast intensywniejszej optymalizacji należy zmienić strategię
Jeśli po wprowadzeniu tych zmian przepływ pracy SDXL nadal trwa zbyt długo, sprawdź, co tak naprawdę dzieje się w trakcie zadania. Graf produkcyjny z wieloma kontrolerami, rafinerami i rozbudowaną skalowalnością może być po prostu mocno obciążający obliczeniowo. W takim przypadku masz trzy rozsądne opcje: zaakceptować dłuższe renderowanie obrazów końcowych, użyć prostszego, roboczego przepływu pracy do iteracji lub przenieść obciążenie na szybszy sprzęt.
Podobnie, jeśli stale brakuje pamięci VRAM, wymuszenie „szybszego” trybu rezydentnego GPU to niewłaściwe rozwiązanie. Stabilne działanie w domyślnym dynamicznym zarządzaniu pamięcią lub konfiguracji z niższą pamięcią VRAM jest lepsze niż powtarzające się awarie z powodu braku pamięci. Ustawienia oszczędzania pamięci mogą wydłużyć czas renderowania, ale wolniejsze, udane renderowanie jest nadal bardziej przydatne niż szybkie zawieszenie.