Una buona configurazione Ollama–Obsidian non è semplicemente quella in cui una casella di chat restituisce testo. Per la gestione personale della conoscenza, il test migliore è verificare se il sistema può utilizzare le note desiderate, preservare il controllo sul vault, rispondere a una velocità accettabile e ammettere quando le note non contengono la risposta. Se queste condizioni non sono soddisfatte, cambiare il modello, la configurazione del recupero o quella del plugin è più utile che ritoccare ripetutamente i prompt.
A settembre 2026, l'API locale di Ollama è ancora servita di default su http://localhost:11434, con rotte API sotto /api, e l'accesso locale non richiede autenticazione. Ollama fornisce anche embedding per la ricerca semantica e la generazione aumentata dal recupero (RAG), che è la parte che rende la risposta alle domande sull'intero vault sostanzialmente diversa dalla chat ordinaria. Consulta l'introduzione ufficiale all'API di Ollama, la documentazione sull'autenticazione locale e la documentazione sugli embedding.
Questa guida utilizza Copilot for Obsidian come esempio di plugin della community perché il suo progetto supporta attualmente i modelli locali Ollama e i flussi di lavoro orientati al vault. La formulazione esatta delle impostazioni può cambiare tra le release del plugin, quindi usa il repository attuale di Copilot for Obsidian e la sua guida alla configurazione del modello locale se un'etichetta nella tua installazione differisce dagli screenshot o dai passaggi seguenti.
Cosa dovrebbe effettivamente ottenere una configurazione PKM locale di successo?
Prima di installare qualsiasi cosa, definisci il risultato desiderato. Una configurazione locale utile dovrebbe superare quattro test pratici:
- Connessione: Obsidian può raggiungere un modello che Ollama sta effettivamente servendo sulla tua macchina.
- Grounding: quando chiedi informazioni su una nota o sul tuo vault, la risposta riflette il contenuto rilevante della nota invece di basarsi solo sull'addestramento generale del modello.
- Prestazioni: i tempi di risposta e l'uso della memoria sono abbastanza accettabili da usare realisticamente il flusso di lavoro.
- Controllo: sai quale plugin può leggere o modificare le note, quale endpoint del modello utilizza e se sono abilitate funzionalità web o cloud opzionali.
Questi criteri sono importanti perché "modello locale connesso" e "buona gestione personale della conoscenza" non sono la stessa cosa. La chat può funzionare perfettamente mentre il recupero del vault è debole, e un modello forte può comunque produrre risposte scadenti se vengono recuperate le note sbagliate.
Passaggio 1: Installa Ollama, scarica un modello e verifica l'API locale
Installa Ollama utilizzando le istruzioni ufficiali per il tuo sistema operativo. Ollama supporta attualmente macOS, Windows e Linux; l'avvio rapido ufficiale è il punto di partenza più sicuro perché l'installazione e le raccomandazioni sui modelli cambiano nel tempo.
Scarica un modello di chat prima di aprire Obsidian. Ad esempio:
ollama pull gemma3
ollama ls
Non è necessario usare gemma3. La parte importante è che il nome del modello che inserirai successivamente in Obsidian deve corrispondere a un modello che Ollama può elencare localmente. Inizia con un modello che il tuo computer può eseguire comodamente piuttosto che scegliere automaticamente il modello più grande disponibile.
Successivamente, verifica l'API indipendentemente da Obsidian:
curl http://localhost:11434/api/tags
Se quel comando restituisce un elenco JSON contenente il tuo modello, il servizio Ollama di base sta funzionando. Puoi anche eseguire ollama ps mentre un modello è attivo. Ollama documenta questo comando come un modo per vedere se un modello è caricato nella memoria CPU, nella memoria GPU o in un mix di entrambe. Se le risposte sono dolorosamente lente o la macchina diventa non reattiva, è un segnale per passare a un modello più piccolo o ridurre i requisiti di contesto piuttosto che presumere che il problema sia Obsidian.
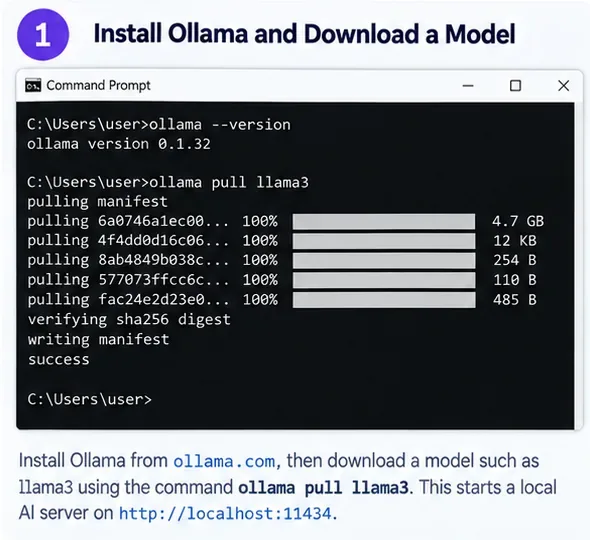
Illustrazione generata da AI del passaggio di installazione di Ollama e download del modello. I numeri di versione e i dettagli del download del modello mostrati nell'immagine sono illustrativi, non un record di release attuale.
Passaggio 2: Installa il plugin Obsidian e collega il suo modello di chat a Ollama
Obsidian tratta i plugin della community come codice di terze parti. La sua documentazione ufficiale avverte che questi plugin eseguono codice per tuo conto, quindi rivedi il codice sorgente e le autorizzazioni del plugin se il tuo vault contiene materiale sensibile. Per installarne uno, apri Impostazioni → Plugin della community, attiva i plugin della community se necessario, scegli Sfoglia, quindi installa e abilita il plugin. Il processo esatto è documentato nella pagina di aiuto ufficiale sui plugin della community di Obsidian.
Per questa guida, installa Copilot dalla directory della community e conferma che il plugin punti al progetto verificato Copilot for Obsidian collegato sopra. Evita di scegliere un plugin con nome simile solo perché appare per primo nei risultati di ricerca.
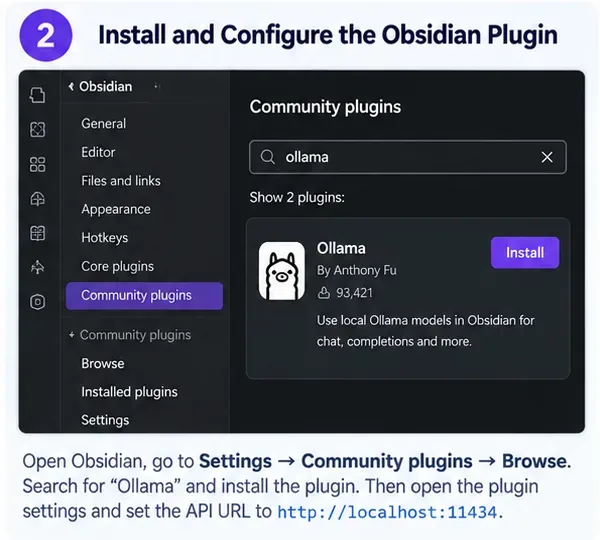
Illustrazione concettuale generata da AI del browser dei plugin della community. La scheda del plugin, il nome dell'autore e il conteggio dei download mostrati sono illustrativi e non devono essere trattati come dati verificati della directory; usa il progetto Copilot verificato collegato in questo articolo.
Apri le impostazioni di Copilot e cerca l'area di configurazione del modello, attualmente organizzata sotto le impostazioni Modelli. Aggiungi un modello di chat personalizzato con questi valori:
- Provider: Ollama.
- Modello: il nome esatto del modello locale riportato da
ollama ls.
- URL di base:
http://localhost:11434.
- Chiave API: Ollama stesso non ne richiede una per l'accesso localhost. Se un campo del plugin richiede un segnaposto, segui le istruzioni attuali di quel plugin piuttosto che inventare una chiave cloud.
C'è un facile errore di URL da evitare. Quando testi Ollama manualmente, gli endpoint API sembrano http://localhost:11434/api/chat. Il provider Ollama nativo di Copilot, tuttavia, si aspetta l'indirizzo del server di base e costruisce l'endpoint internamente, quindi usa http://localhost:11434 a meno che il plugin attuale non richieda specificamente un endpoint completo. Allo stesso modo, non aggiungere /v1 quando si usa il provider Ollama nativo. L'API compatibile con OpenAI separata di Ollama usa /v1, ma è un percorso di integrazione diverso.
Passaggio 3: Testa il grounding a livello di nota prima di indicizzare l'intero vault
Non iniziare indicizzando migliaia di note. Prima, dimostra che la connessione di chat di base funziona con un test piccolo e controllato. Crea una nota temporanea contenente tre fatti facili da verificare, come un nome di progetto, una scadenza e una decisione. Quindi allega o menziona quella nota in Copilot e chiedi al modello di riassumere solo ciò che dice la nota.
Un buon risultato dovrebbe riprodurre accuratamente quei fatti, evitare di aggiungere affermazioni non supportate e restare nell'ambito richiesto. Un risultato scadente potrebbe rispondere dalla conoscenza generale ignorando la nota, inventare dettagli o omettere un fatto importante che è chiaramente presente.
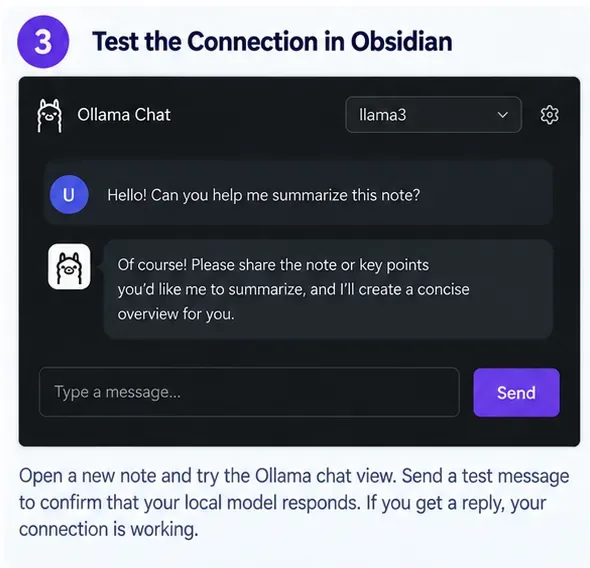
Illustrazione concettuale generata da AI di un test di chat locale in Obsidian. Dimostra il tipo di risultato da controllare, non uno screenshot reale di una specifica release del plugin.
Se non c'è risposta, risolvi i problemi dal basso verso l'alto. Prima riesegui curl http://localhost:11434/api/tags. Se fallisce, il problema è Ollama, non Obsidian. Se l'API funziona ma Copilot no, ricontrolla il nome del modello e l'URL di base. Solo dopo questi controlli dovresti indagare su un problema di origine/CORS. Il codice attuale di Copilot include un percorso di richiesta destinato a gestire l'accesso locale a Ollama, mentre la sua guida alla configurazione locale documenta anche OLLAMA_ORIGINS per configurazioni che richiedono l'accesso diretto con origine Obsidian. Usa il metodo documentato per la tua versione di Copilot installata invece di applicare automaticamente vecchie soluzioni alternative con variabili d'ambiente.
Passaggio 4: Aggiungi il recupero consapevole del vault solo se la chat a livello di nota supera il test
Per la gestione personale della conoscenza, il maggiore miglioramento della qualità spesso deriva dal recupero piuttosto che dal passaggio a un modello di chat più grande. RAG significa che il sistema prima recupera frammenti delle tue note che sembrano rilevanti, quindi dà quei frammenti al modello linguistico come contesto. Questo permette a un modello locale di rispondere a domande su informazioni su cui non è mai stato addestrato.
Per rendere locale anche il recupero, usa un modello di embedding Ollama. La documentazione attuale di Ollama raccomanda modelli come embeddinggemma, qwen3-embedding e all-minilm. Ad esempio:
ollama pull embeddinggemma
Configura quel modello nelle impostazioni di ricerca nel vault o di embedding QA di Copilot usando il provider Ollama, quindi costruisci o ricostruisci l'indice locale. Usa lo stesso modello di embedding per l'indicizzazione e le query; Ollama lo raccomanda esplicitamente perché i vettori prodotti da modelli diversi non sono direttamente intercambiabili.

Illustrazione concettuale generata da AI di un flusso di lavoro di note alimentato da Ollama. I nomi dei comandi e il layout del menu sono esempi, non un'affermazione sull'UI esatta della release attuale di Copilot.
Una volta terminata l'indicizzazione, testa il recupero con domande le cui risposte conosci già. Chiedi un fatto che appare in una nota, poi una relazione che richiede due note. Infine, chiedi qualcosa che non è nel vault. Il risultato migliore non è la risposta più fluente; è quella che usa le prove giuste e rifiuta di inventare fatti mancanti.
Come giudicare se il risultato è abbastanza buono
| Controllo di qualità | Segnale di superamento | Quando cambiare approccio |
|---|
| Connessione locale | /api/tags funziona e lo stesso modello risponde in Obsidian | Se curl fallisce, correggi prima Ollama; se solo Obsidian fallisce, ispeziona le impostazioni del modello/URL del plugin |
| Grounding della nota | I fatti noti dalla nota allegata sono riprodotti accuratamente | Se la chat ignora la nota, correggi la selezione del contesto prima di cambiare modelli |
| Recupero del vault | Le note rilevanti sono costantemente presentate per domande con risposta nota | Se il recupero è debole, migliora gli embedding/l'indicizzazione o restringi l'ambito indicizzato |
| Qualità della generazione | Il modello separa i fatti supportati dall'incertezza | Se il recupero è buono ma le risposte sono deboli, prova un modello di chat più forte |
| Latenza | Puoi interagire senza ripetuti lunghi arresti | Se Ollama è principalmente legato alla CPU o alla memoria, usa un modello più piccolo o meno contesto |
| Privacy | L'endpoint configurato è localhost e le funzionalità cloud/web opzionali sono disabilitate | Se un endpoint remoto o uno strumento web è attivo, il flusso di lavoro non è più completamente locale |
Quando un modello più grande non è la soluzione giusta
Se le risposte sono sbagliate perché il sistema recupera le note sbagliate, aggiornare il modello di chat potrebbe migliorare la prosa senza correggere le prove. Migliora prima il recupero. Al contrario, se i passaggi corretti vengono recuperati ma il modello non riesce a sintetizzarli in modo affidabile, allora un modello di chat migliore può aiutare.
Anche l'hardware stabilisce un limite pratico. Ollama nota che i file dei modelli possono consumare spazio di archiviazione sostanziale e contesti più grandi consumano più memoria. Usa ollama ps per vedere come viene caricato il modello attuale. Un flusso di lavoro che tecnicamente funziona ma richiede così tanto tempo da smettere di usarlo non è un sistema PKM di successo.
Limiti di privacy e sicurezza dell'AI "locale" di Obsidian
L'API localhost di Ollama stessa non richiede autenticazione, il che è comodo su una macchina ma significa anche che non dovresti esporre casualmente la porta 11434 a una rete. Mantienila vincolata localmente a meno che tu non protegga deliberatamente una configurazione remota.
Ricorda anche che "Ollama è locale" non significa automaticamente che "l'intero flusso di lavoro di Obsidian è offline". I plugin della community possono contenere integrazioni con provider cloud, ricerca web, telemetria o strumenti agentici. Rivedi le impostazioni attuali del plugin e disabilita le funzionalità che non intendi usare. Se il tuo obiettivo è l'elaborazione rigorosamente offline, testa con la rete disconnessa dopo che tutti i modelli e i plugin sono già installati.
Autocontrollo finale
La tua configurazione è pronta per la gestione personale quotidiana della conoscenza quando tutte queste affermazioni sono vere: l'API di Ollama risponde localmente; Obsidian usa esattamente il modello locale che intendevi; un test controllato della nota restituisce i fatti corretti; il recupero del vault trova le note giuste per domande con risposta nota; le domande non supportate non innescano invenzioni sicure; e le prestazioni sono abbastanza veloci da usare effettivamente il flusso di lavoro.
Se solo le prime due affermazioni sono vere, hai connesso con successo Ollama a Obsidian, ma non hai ancora un assistente affidabile per la gestione della conoscenza. Tratta la qualità del recupero, il comportamento del modello e la configurazione della privacy come parti separate del sistema, e cambia la parte che sta effettivamente fallendo.









