Home
» domini
»
Come eseguire DeepSeek offline su Windows 11 con LM Studio
Come eseguire DeepSeek offline su Windows 11 con LM Studio
Sì, puoi eseguire DeepSeek completamente offline su Windows 11 con LM Studio, ma è necessaria una prima configurazione online. Installa LM Studio, scarica un modello DeepSeek compatibile e il runtime richiesto, carica il modello una volta e poi puoi disconnetterti da Internet. La documentazione ufficiale offline di LM Studio afferma che chattare con i modelli scaricati, chattare con documenti locali e eseguire il suo server locale non richiedono l'accesso a Internet.
Per un tipico PC Windows 11, il punto di partenza più pratico non è il più grande modello DeepSeek attuale. Un modello GGUF più piccolo come DeepSeek-R1-0528-Qwen3-8B è molto più facile da eseguire localmente. LM Studio ha pubblicato il supporto per quel modello distillato da 8B nel maggio 2025 e afferma che funziona in formato GGUF con LM Studio 0.3.16 o versioni successive. Al contrario, le linee guida di LM Studio dell'agosto 2026 per DeepSeek V4 Flash affermano che l'uso locale richiede circa 156GB di memoria di sistema. Ciò rende V4 Flash una scelta inadatta per la maggior parte delle macchine Windows consumer, anche se è più recente e più capace.
Questa guida è stata verificata l'11 settembre 2026. Il changelog di LM Studio elenca la versione 0.4.24 datata 9 settembre 2026. Poiché l'interfaccia di LM Studio evolve, un pulsante potrebbe spostarsi leggermente tra le build, ma il flusso di lavoro principale—scaricare un modello, caricarlo, chattare localmente ed eventualmente esporre un'API localhost—rimane documentato da LM Studio.
Prima di iniziare: il tuo PC Windows 11 è adatto?
LM Studio supporta attualmente sia i PC Windows x64 che i sistemi Windows basati su ARM. Per x64, la CPU deve supportare AVX2. LM Studio raccomanda almeno 16GB di RAM e almeno 4GB di VRAM dedicata. Queste sono raccomandazioni a livello di applicazione, non una garanzia che ogni modello si adatti. La dimensione del modello, la quantizzazione, la lunghezza del contesto e l'offload sulla GPU influenzano tutti l'uso della memoria.
Cosa hai
Raccomandazione pratica
Perché
16GB di RAM, GPU modesta o grafica integrata
Inizia con un modello distillato DeepSeek da 8B o inferiore in una variante GGUF a 4 bit
Mantiene l'impronta del modello relativamente gestibile preservando una capacità di ragionamento utile.
Più RAM e una GPU più potente
Prova varianti distillate più grandi solo dopo aver controllato la stima di compatibilità del dispositivo di LM Studio
I modelli più grandi possono migliorare la qualità ma consumano sostanzialmente più memoria e possono essere molto più lenti.
PC da gioco o laptop ordinario
Non iniziare con DeepSeek V4 Flash
LM Studio afferma che il modello V4 Flash locale richiede almeno 156GB di memoria di sistema.
La documentazione sul download dei modelli di LM Studio spiega che le build quantizzate scambiano una certa fedeltà per file più piccoli e una minore pressione sulla memoria. La sua raccomandazione generale è di scegliere un'opzione a 4 bit o superiore quando l'hardware può gestirla. Se non sei sicuro, una versione GGUF a 4 bit è un primo test sensato.
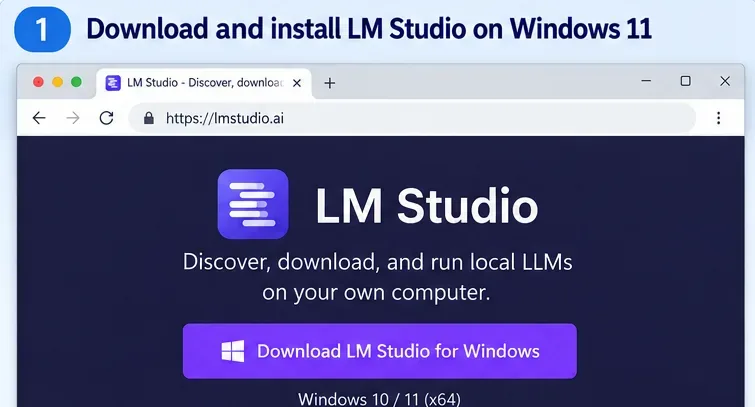
Scarica la build stabile attuale per Windows dalla pagina di download ufficiale di LM Studio. Usa l'installer che corrisponde all'architettura del tuo Windows. Su un PC x64, assicurati che il tuo processore supporti AVX2 prima di risolvere gli errori di caricamento del modello in seguito.
La vista di download per Windows di LM Studio. Scegli l'installer che corrisponde al tuo sistema Windows 11 prima di passare al download del modello.
Avvia LM Studio mentre hai ancora una connessione Internet. Questo è importante perché l'app potrebbe dover scaricare o aggiornare un LM Runtime. LM Studio descrive i runtime come motori di inferenza pacchettizzati, come il suo runtime basato su llama.cpp per i modelli GGUF. I download dei runtime richiedono connettività anche se l'inferenza può funzionare offline in seguito.
Passaggio 2: Scarica un modello DeepSeek adatto al tuo PC
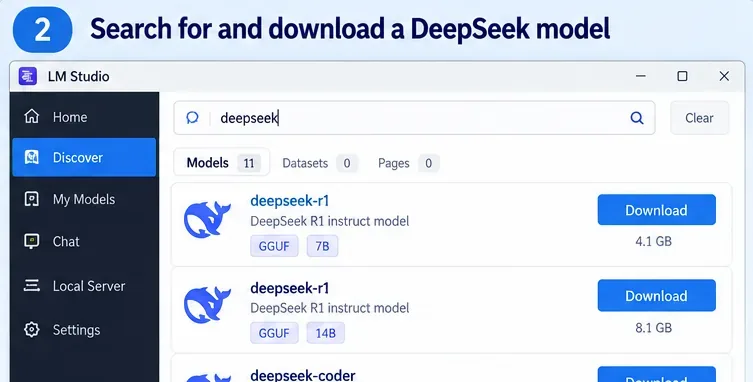
Apri l'area Discover in LM Studio e cerca DeepSeek. LM Studio può cercare i modelli supportati su Hugging Face per parola chiave, per un identificatore user/model o anche per un URL completo di Hugging Face.
Cerca DeepSeek in Discover, poi scegli un modello e una quantizzazione appropriati per il tuo hardware. Le voci esatte del catalogo e le dimensioni dei file cambiano nel tempo.
Quale modello DeepSeek dovresti scegliere?
Per la maggior parte delle persone che seguono questa guida, inizia con DeepSeek-R1-0528-Qwen3-8B. LM Studio afferma che questo modello distillato da 8B supporta il ragionamento e l'uso degli strumenti, è disponibile come GGUF e può funzionare con molta meno memoria rispetto ai modelli DeepSeek di punta. Le linee guida di LM Studio per Windows raccomandano ancora 16GB di RAM per l'applicazione complessiva, quindi non trattare un'affermazione di bassa memoria specifica del modello come un obiettivo confortevole per l'intero sistema.
DeepSeek ha anche rilasciato precedenti varianti distillate R1 con 1,5B, 7B, 8B, 14B, 32B e 70B parametri. Queste ti danno spazio per scambiare velocità e uso della memoria contro capacità. Vedi il repository ufficiale DeepSeek-R1 per la famiglia di modelli e i dettagli della licenza, e la nota sull'esecuzione locale di DeepSeek-R1-0528 di LM Studio per l'opzione da 8B.
Se sei tentato da DeepSeek V4 Flash perché è più recente, controlla prima il requisito hardware. L'articolo ufficiale su V4 Flash di LM Studio afferma che il modello Mixture-of-Experts da 284B richiede almeno 156GB di memoria di sistema per l'uso locale. È fattibile su workstation ad alta memoria, non su un normale laptop Windows.
Passaggio 3: Carica il modello in memoria
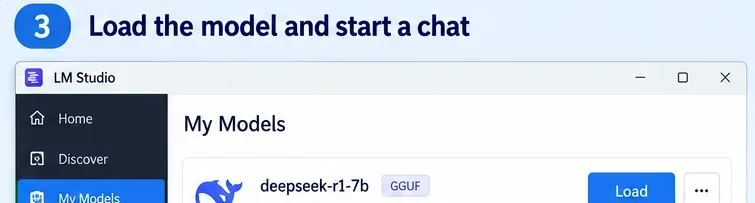
Dopo che il download è terminato, vai ai tuoi modelli scaricati o apri il caricatore di modelli da Chat. Seleziona il modello DeepSeek e caricalo. LM Studio spiega che il caricamento di un modello alloca memoria per i pesi del modello e lo stato del runtime correlato.
Un modello DeepSeek GGUF scaricato pronto per essere caricato. Se il caricamento fallisce, prova un modello più piccolo o una quantizzazione a memoria inferiore prima di modificare le impostazioni avanzate.
Per la tua prima esecuzione, mantieni le impostazioni di caricamento conservative. Una finestra di contesto molto grande può consumare memoria aggiuntiva significativa, quindi c'è poco motivo per massimizzare il contesto immediatamente. Carica il modello con un contesto modesto, verifica che funzioni ed espandi solo quando il tuo carico di lavoro lo richiede.
Se LM Studio riporta che il modello non si adatta, la soluzione più affidabile è solitamente scegliere un modello più piccolo o una quantizzazione più compatta. Chiudere applicazioni pesanti in termini di memoria può aiutare, ma non cambia l'impronta fondamentale del modello.
Passaggio 4: Disconnetti Internet e verifica che DeepSeek funzioni davvero offline
Questo è il passaggio che separa "modello locale" dal semplice "uso di un client desktop". Una volta che il modello e il suo runtime sono installati, spegni il Wi-Fi e disconnetti Ethernet. Quindi inizia una nuova chat e invia un prompt semplice come:
Spiega la differenza tra RAM e VRAM in cinque punti elenco.
Se il modello risponde mentre il PC non ha connessione di rete, l'inferenza è locale. LM Studio afferma che una volta che un LLM è sulla tua macchina, può funzionare interamente offline e che il testo inserito nelle chat LLM locali non lascia il tuo dispositivo. La sua documentazione offline afferma anche che l'elaborazione di documenti locali e RAG rimangono sulla macchina.
Un modello DeepSeek caricato che risponde in LM Studio Chat. Per verificare tu stesso l'operazione offline, disconnetti l'accesso alla rete dopo che il modello e il runtime sono completamente scaricati e ripeti un prompt semplice.
C'è un confine importante: la ricerca di modelli, il download di nuovi modelli, il download dei runtime e il controllo degli aggiornamenti dell'app richiedono l'accesso a Internet. Se in seguito aggiungi modelli cloud, server MCP remoti, strumenti web o altre integrazioni di rete, quelle funzionalità potrebbero anche richiedere connettività. Le affermazioni sulla privacy offline si applicano al flusso di lavoro locale, non ai servizi a cui ti connetti deliberatamente in seguito.
Passaggio 5: Opzionale—Usa DeepSeek tramite un'API locale
Se vuoi che un'altra applicazione Windows, script, estensione IDE o strumento interno chiami il tuo modello DeepSeek locale, LM Studio può eseguire un server locale. La documentazione attuale per sviluppatori afferma che puoi avviarlo dalla pagina Developer o con:
lms server start
Per impostazione predefinita, il server è disponibile su http://localhost:1234. LM Studio fornisce endpoint REST nativi ed endpoint compatibili con OpenAI. Il server stesso può funzionare offline purché il modello e il runtime siano già locali. Tuttavia, se esponi il server oltre localhost, rivedi prima le impostazioni di autenticazione e accesso alla rete.
RAM/VRAM insufficiente, contesto troppo grande o CPU/runtime non supportati
Prova un modello DeepSeek più piccolo, una quantizzazione più piccola o una lunghezza del contesto inferiore. Su Windows x64, conferma il supporto AVX2.
LM Studio funziona online ma non dopo la disconnessione
Il modello o il runtime richiesto non sono stati scaricati completamente
Riconnetti una volta, completa tutti i download di modelli/runtime, carica il modello con successo, poi ripeti il test offline.
La generazione è molto lenta
Il modello è troppo grande per l'accelerazione GPU disponibile e fa molto affidamento sulla CPU/memoria di sistema
Scegli un modello o una quantizzazione più piccoli. Un modello più grande non è utile se la latenza rende il flusso di lavoro impraticabile.
Non riesci a trovare un modello mentre sei offline
La ricerca Discover ha bisogno di accesso alla rete
Scarica i modelli prima di andare offline, o carica manualmente un file modello ottenuto tramite un altro processo controllato.
Aspettavi che V4 Flash funzionasse su un laptop normale
Il suo requisito di memoria locale è di classe workstation
Usa invece un modello distillato R1 a meno che la tua macchina non abbia circa 156GB o più di memoria di sistema.
Quando questa configurazione è adatta
Eseguire DeepSeek offline con LM Studio è una scelta forte quando si desidera inferenza locale privata, costi prevedibili dopo il download del modello, sperimentazione senza chiavi API o un'API localhost per lo sviluppo. È anche utile quando la tua macchina deve continuare a funzionare senza accesso a Internet.
È una scelta meno adatta quando hai bisogno del modello DeepSeek più potente disponibile ma hai solo hardware consumer, quando hai bisogno di una produttività estremamente elevata, o quando il tuo carico di lavoro dipende da informazioni web in tempo reale. I modelli locali conoscono solo ciò che è nei loro pesi e nel contesto che fornisci, a meno che tu non colleghi deliberatamente strumenti esterni o fonti di dati.
Elenco di controllo rapido
Usa un sistema Windows 11 che soddisfi i requisiti di LM Studio; le CPU x64 necessitano di AVX2.
Mantieni l'accesso a Internet attivo per i download iniziali di LM Studio, runtime e modelli.
Inizia con un modello GGUF DeepSeek più piccolo, specialmente un modello distillato di classe 8B.
Scegli una quantizzazione a 4 bit o superiore se il tuo hardware può supportarla.
Carica il modello con successo prima di disconnettere la rete.
Spegni Wi-Fi/Ethernet ed esegui un nuovo prompt per verificare l'inferenza offline.
Riduci la dimensione del modello o la lunghezza del contesto se incontri errori di memoria.
Usa il server localhost di LM Studio solo se hai bisogno di accesso API locale.
In sintesi
Il modo più semplice per eseguire DeepSeek offline su Windows 11 è abbinare LM Studio a un modello GGUF DeepSeek più piccolo che si adatta effettivamente al tuo hardware. Per un PC normale, un modello distillato R1 di classe 8B è un punto di partenza molto più realistico rispetto a DeepSeek V4 Flash. Completa i download mentre sei online, carica il modello, disconnetti la rete e verifica che una nuova chat risponda ancora. Una volta che funziona, hai una configurazione DeepSeek genuinamente locale piuttosto che un wrapper desktop attorno a un'API cloud.