Ridurre la fattura di un'API LLM del 50% è possibile in molti carichi di lavoro, ma non è una garanzia universale. Il risultato dipende da dove proviene la tua spesa: token di input non in cache, token di input in cache, token di output, token di ragionamento, chiamate a strumenti o tentativi ripetuti. La compressione dei prompt funziona meglio quando gli input lunghi o ripetitivi rappresentano una parte significativa della fattura. L'obiettivo pratico non è quindi "rendere ogni prompt metà della lunghezza". È "rimuovere i token che non cambiano la risposta, preservare i token che lo fanno e verificare i risparmi sul traffico reale".
Questa guida utilizza quattro passaggi di implementazione: misurare la linea di base, rimuovere l'input ridondante, organizzare i prompt per il riutilizzo della cache e spostare le istruzioni di output verbose in controlli strutturati dove l'API li supporta. Gli esempi sono illustrativi e non affermazioni di benchmark. I prezzi dei fornitori e il comportamento della cache cambiano nel tempo, quindi verifica le tariffe attuali prima di effettuare una stima di produzione.
Cosa richiede realmente una riduzione dei costi API del 50%?
Inizia con l'equazione di fatturazione per il tuo modello. Per un semplice carico di lavoro di testo, il costo totale della richiesta è approssimativamente il costo dell'input non in cache più l'input in cache più l'output. Alcuni modelli o funzionalità aggiungono altre categorie fatturabili. Le attuali risposte API di OpenAI espongono l'utilizzo dei token di input e output, inclusi i dettagli dei token in cache, e le sue pagine dei modelli pubblicano tariffe separate per input, input in cache e output.
| Carico di lavoro illustrativo | Token di input | Token di output | Risultato relativo |
|---|
| Richiesta di base | 10.000 | 1.000 | 100% del costo di base |
| Solo l'input è dimezzato | 5.000 | 1.000 | Meno del 50% di risparmio totale quando l'output rimane invariato |
| Sia l'input che l'output sono dimezzati | 5.000 | 500 | Costo basato sui token inferiore di circa il 50% quando le tariffe sono invariate |
Per un esempio concreto attuale, la pagina ufficiale del modello GPT-5.6 Sol elencava, l'11 settembre 2026, 4 $ per milione di token di input, 0,40 $ per milione di token di input in cache e 20 $ per milione di token di output. A queste tariffe, una richiesta con 10.000 input/1.000 output costa circa 0,06 $ prima di altre commissioni. Ridurre solo l'input a 5.000 token porta quell'esempio a circa 0,04 $, una riduzione del 33%. Dimezzare sia l'input che l'output lo porta a circa 0,03 $, una riduzione del 50%. Questi prezzi possono cambiare, quindi tratta l'aritmetica come un metodo, non come un preventivo permanente. Consulta la pagina ufficiale del modello GPT-5.6 Sol per i prezzi attuali.
Riferimento rapido: le quattro mosse di maggior valore
| Tecnica | Migliore adattabilità | Rischio principale | Cosa misurare |
|---|
| Audit dei token | Qualsiasi carico di lavoro di produzione | Ottimizzare il componente sbagliato | Input, input in cache, output, tentativi ripetuti, costo per attività riuscita |
| Rimozione della ridondanza | Prompt di sistema lunghi, politiche ripetute, esempi verbose | Eliminare un vincolo che conta davvero | Successo dell'attività e parità nel seguire le istruzioni |
| Layout adatto alla cache | Richieste ripetute che condividono istruzioni o contesti stabili | Basso riutilizzo della cache perché il testo dinamico appare troppo presto | Rapporto dei token in cache e latenza |
| Controlli di output strutturato | Estrazione JSON, classificazione, formati di risposta fissi | Schema troppo rigido per l'attività | Token di output, errori di analisi, tentativi ripetuti |
Passaggio 1: Misurare la vera linea di base dei token prima di modificare i prompt
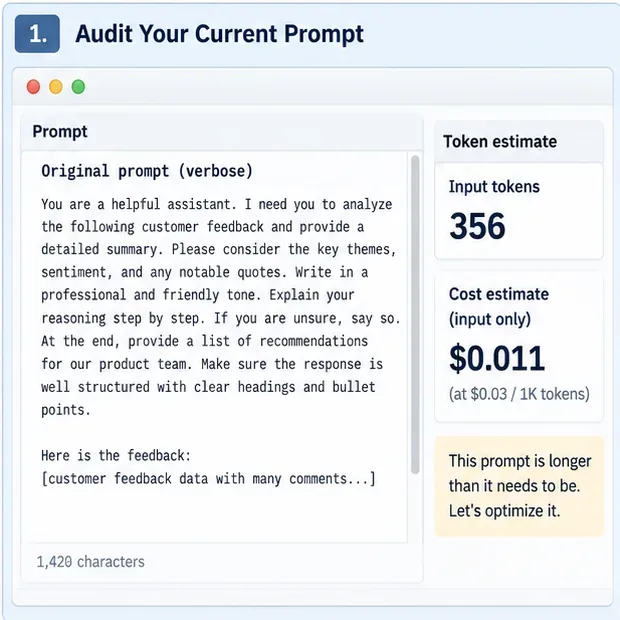
Didascalia: Un'interfaccia di audit dei token illustrativa registra la dimensione originale del prompt e una stima dei costi del campione prima della compressione; le cifre non sono i prezzi attuali del fornitore.
Raccogli un campione rappresentativo di richieste di produzione piuttosto che ottimizzare un singolo prompt scelto a mano. Al minimo, registra i token di input, i token di input in cache quando disponibili, i token di output, il nome del modello, la latenza, i tentativi ripetuti e se la risposta finale ha superato il tuo controllo di qualità aziendale. Se il tuo fornitore offre un endpoint di conteggio dei token di input, usalo prima di inviare le richieste quando hai bisogno di un budgeting deterministico. OpenAI documenta attualmente un endpoint di conteggio dei token di input delle Risposte nella sua riferimento API ufficiale.
Calcola il costo per attività riuscita, non solo il costo per chiamata API. Un prompt compresso che causa più tentativi ripetuti può essere più costoso anche se ogni richiesta è più corta. Segmenta anche la linea di base per tipo di attività: riassunto, estrazione, risposta alle domande RAG, uso di strumenti agentici e conversazioni lunghe hanno solitamente profili di token diversi.
Passaggio 2: Rimuovere la ridondanza senza eliminare informazioni critiche per le decisioni

Didascalia: Un prompt prima e dopo illustrativo mantiene gli stessi output richiesti rimuovendo parole ripetute e istruzioni di processo non necessarie.
La prima passata di compressione più sicura è la deduplicazione semantica. Elimina descrizioni di ruolo ripetute, vincoli duplicati, riempitivi educati, spiegazioni di formattazione ovvia ed esempi che insegnano lo stesso modello più di una volta. Unisci regole sovrapposte in un'unica istruzione. Preferisci una frase precisa a diverse frasi che riformulano lo stesso requisito.
Prima
Sei un assistente utile che è un esperto in analisi dei prodotti.
Ho bisogno che tu analizzi il seguente feedback dei clienti e fornisca
un riassunto dettagliato. Identifica i temi chiave, il sentiment generale,
le citazioni notevoli e le raccomandazioni per il nostro team di prodotto.
Assicurati che la tua risposta sia professionale, chiara, concisa e ben strutturata.
Dopo
Analizza il feedback dei clienti.
Restituisci: temi chiave, sentiment generale, citazioni notevoli e raccomandazioni di prodotto.
Sii conciso e fattuale.
Non comprimere via eccezioni, confini di politica, definizioni di dominio, regole di sicurezza degli strumenti o requisiti di prove semplicemente perché sono lunghi. Questi sono spesso token di alto valore. Un test utile è chiedere: "Se rimuovo questa frase, può cambiare l'output accettabile?" Se sì, mantienilo a meno che un controllo API o uno schema non possa imporre lo stesso comportamento in modo più affidabile.
Passaggio 3: Metti il contenuto stabile per primo e il contenuto dinamico per ultimo
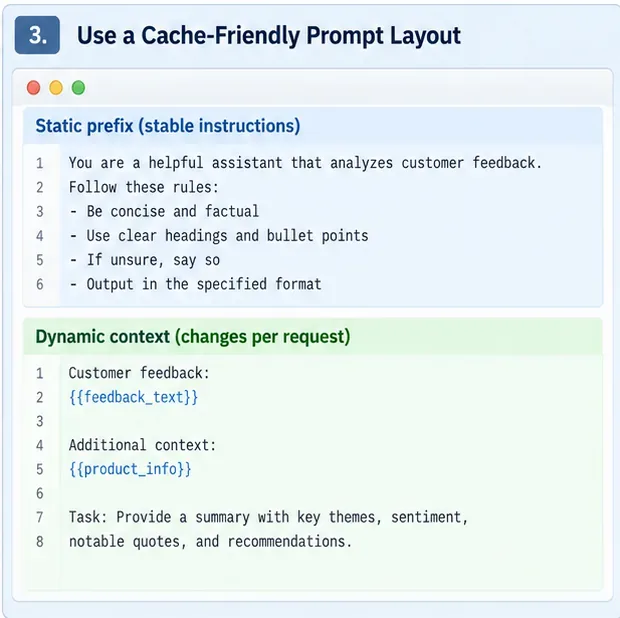
Didascalia: Un layout del prompt illustrativo posiziona le istruzioni stabili in un prefisso riutilizzabile e aggiunge il contesto specifico della richiesta in seguito.
La memorizzazione nella cache dei prompt non riduce il conteggio grezzo dei token, ma può ridurre l'importo fatturato alla normale tariffa di input e abbassare la latenza di elaborazione del prompt. Questo rende il layout del prompt parte dell'ottimizzazione dei costi. Raggruppa le istruzioni di sistema, gli esempi condivisi, la guida agli strumenti e altro contenuto stabile insieme. Metti i fatti specifici della richiesta, i passaggi recuperati, i dati utente e la domanda attuale in seguito.
La guida ai modelli di OpenAI raccomanda esplicitamente di mettere il contenuto statico per primo e il contenuto dinamico per ultimo per migliorare il riutilizzo della cache dei prompt, e il suo oggetto di utilizzo della risposta espone le informazioni sui token in cache per la misurazione. Consulta la guida ufficiale ai modelli e il riferimento API delle Risposte.
Evita di modificare spazi bianchi innocui, ordine degli esempi, timestamp, ID casuali o testo per utente all'interno di un prefisso altrimenti riutilizzabile a meno che la semantica della cache del fornitore non dica che quelle modifiche sono sicure. Misura i successi della cache dalla risposta API invece di presumere che un prompt venga riutilizzato.
Passaggio 4: Sostituire la prosa sul formato con controlli di output strutturato
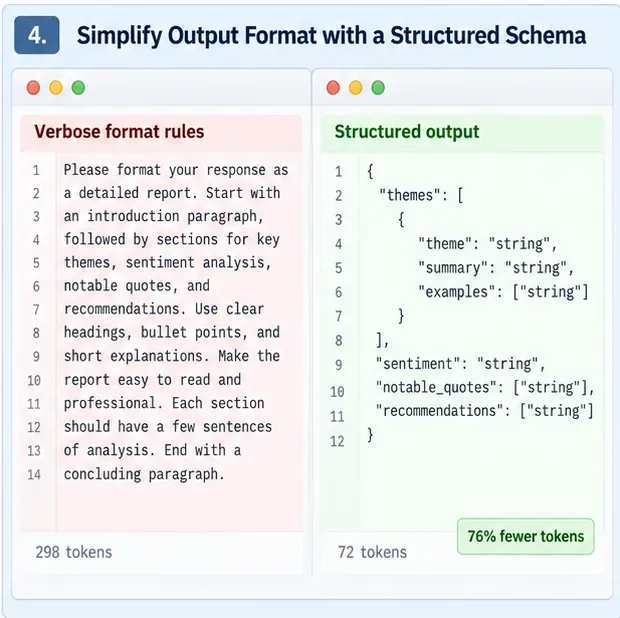
Didascalia: Una vista di output strutturato illustrativa mostra come uno schema può sostituire molte righe di prosa che descrivono ripetutamente la stessa forma di risposta.
I prompt di estrazione e classificazione spesso sprecano token descrivendo campi JSON, valori consentiti, annidamento, ordinamento e regole di validazione in linguaggio naturale. Quando l'API supporta output strutturati o argomenti di strumenti tipizzati, sposta quanto più possibile di quel contratto nell'interfaccia strutturata e mantieni l'istruzione in linguaggio naturale focalizzata sul significato.
L'attuale guida di OpenAI raccomanda specificamente di rimuovere le definizioni dello schema di output dal prompt dove possibile e di utilizzare invece gli Output Strutturati. Questo può ridurre il testo del prompt e anche ridurre i tentativi ripetuti di output malformato. Il meccanismo esatto varia per fornitore, quindi non copiare un formato di richiesta specifico di OpenAI in un'altra API senza controllare la documentazione di quel fornitore.
Compressione avanzata per RAG, documenti lunghi e conversazioni
Dopo che i quattro passaggi di base sono stabili, i risparmi maggiori derivano solitamente dalla riduzione del contesto piuttosto che dal perfezionamento delle parole della frase. Nei sistemi RAG, recupera meno passaggi ma più rilevanti, deduplica chunk quasi identici ed evita di allegare documenti che non possono influenzare la risposta. Per le conversazioni lunghe, mantieni fatti durevoli e decisioni irrisolte, ma riassumi o scarta i turni che non influenzano più l'attività attuale. Per i sistemi agentici, esponi solo gli strumenti e le descrizioni degli strumenti rilevanti per la fase attuale quando la tua architettura lo consente in sicurezza.
I compressori di prompt appresi sono un'altra opzione per contesti molto lunghi. Il progetto open-source di Microsoft LLMLingua implementa la compressione dei prompt a livello di token. Il paper originale LLMLingua ha riportato rapporti di compressione fino a 20× con degrado limitato dei benchmark nelle sue impostazioni valutate. LongLLMLingua mira a compiti a contesto lungo, mentre LLMLingua-2 utilizza un compressore appreso indipendente dal compito. Questi sono risultati di ricerca, non una promessa che gli stessi rapporti preserveranno la qualità sui tuoi dati. Esegui il benchmark dei tuoi compiti, lingue, modelli e tipi di prompt prima di distribuire una compressione aggressiva.
Come dimostrare che l'ottimizzazione è effettivamente migliore
Esegui una valutazione A/B sulle stesse richieste rappresentative. Le versioni di base e compresse dovrebbero utilizzare lo stesso modello, impostazioni di ragionamento, strumenti, input di recupero e criteri di successo. Cambia una tecnica di compressione alla volta quando possibile in modo da poter identificare cosa ha causato una regressione.
| Metrica | Perché conta | Interpretazione suggerita |
|---|
| Riduzione dei token di input | Mostra la contrazione grezza del prompt | Utile, ma non sufficiente da sola |
| Rapporto dei token in cache | Mostra se i prefissi stabili sono riutilizzati | Più alto è solitamente meglio quando la qualità è invariata |
| Riduzione dei token di output | Può cambiare materialmente il costo totale | Verifica che l'output conciso completi ancora l'attività |
| Costo per attività riuscita | Include tentativi ripetuti e fallimenti | Questa è la metrica aziendale primaria |
| Successo dell'attività / accuratezza | Rileva la perdita di informazioni | Imposta una soglia di non inferiorità accettabile prima del test |
| Latenza p50 e p95 | Mostra l'impatto reale sull'utente | La pre-elaborazione della compressione può compensare i risparmi di inferenza |
Non dichiarare vittoria perché un prompt è il 50% più corto. La condizione di accettazione più forte è: la configurazione compressa riduce il costo misurato di circa il tuo importo target rimanendo entro le tue tolleranze predefinite di qualità, latenza e affidabilità.
Quando dovresti smettere di comprimere?
Smetti o fai marcia indietro quando la prossima riduzione rimuove fatti necessari per decisioni corrette, aumenta le allucinazioni, causa errori di chiamata agli strumenti, indebolisce la conformità alle politiche o aumenta i tentativi ripetuti abbastanza da cancellare i risparmi. La compressione può anche aggiungere latenza se esegui un modello separato per comprimere ogni prompt. Uno studio del 2026 sulla compressione dei prompt in impostazioni di inferenza reali ha scoperto che l'overhead di pre-elaborazione può annullare i guadagni di inferenza al di fuori di regimi favorevoli di lunghezza del prompt e hardware, il che è un'altra ragione per misurare le prestazioni end-to-end piuttosto che solo il conteggio dei token.
Per prompt piccoli, la pulizia manuale e l'organizzazione adatta alla cache sono solitamente più facili da giustificare rispetto all'aggiunta di un modello di compressione dedicato. Per payload RAG grandi o flussi di lavoro multi-documento, la selezione del contesto e la compressione appresa diventano più attraenti perché il volume di token rimovibile è molto più grande.
Lista di controllo rapida per l'implementazione
- Cattura una linea di base di produzione con input, input in cache, output, latenza, tentativi ripetuti e successo dell'attività.
- Rimuovi prima istruzioni duplicate, prosa di basso valore ed esempi ridondanti.
- Preserva definizioni di dominio, eccezioni, requisiti di prove e vincoli di sicurezza.
- Metti il contenuto stabile del prompt prima del contenuto dinamico specifico della richiesta quando la semantica della cache premia i prefissi riutilizzabili.
- Usa output strutturati o schemi di strumenti invece di descrivere ripetutamente formati di risposta fissi in prosa.
- Per RAG, riduci il contesto irrilevante e duplicato prima di provare la compressione a livello di token.
- Limita la lunghezza dell'output solo quando l'attività può ancora essere completata correttamente.
- Confronta il costo per attività riuscita, non solo il conteggio dei token del prompt.
- Esegui test di regressione prima e dopo ogni modifica significativa della compressione.
- Ricontrolla i prezzi del fornitore e le regole della cache ogni volta che cambi modelli o versioni API.
In conclusione
Una riduzione del 50% è un obiettivo ingegneristico ragionevole per alcuni carichi di lavoro verbose e pesanti di contesto, ma dovrebbe essere trattata come un risultato da validare, non come un'aspettativa predefinita. Il percorso più affidabile è misurare prima, rimuovere testo semanticamente ridondante, massimizzare il riutilizzo sicuro della cache, accorciare i contratti di output con controlli strutturati e poi attaccare i blocchi di contesto rimanenti più grandi con potatura del recupero, riassunto o un compressore di prompt testato. Se il costo finale per attività riuscita scende mentre la qualità rimane all'interno della tua fascia di accettazione, la compressione sta funzionando. Se la qualità o i tentativi ripetuti peggiorano, ripristina le informazioni mancanti e ottimizza una parte diversa della richiesta.
Riferimenti primari








