Home
» domini
»
Guida passo dopo passo: automatizzare il monitoraggio settimanale dei concorrenti utilizzando agenti AI
Guida passo dopo passo: automatizzare il monitoraggio settimanale dei concorrenti utilizzando agenti AI
Il monitoraggio dei concorrenti spesso fallisce per una ragione semplice: la ricerca è frammentata tra troppe schede, troppe persone e troppe definizioni di ciò che costituisce un cambiamento significativo. Una persona controlla le pagine dei prezzi, un’altra osserva le note di rilascio, qualcun altro scansiona le notizie del settore e, entro venerdì, il team ha una pila di link ma nessuna risposta affidabile alla domanda che conta: cosa è cambiato questa settimana e ha importanza?
Un agente AI può ridurre quel lavoro manuale, ma l’agente è solo una parte del sistema. Un flusso di lavoro settimanale affidabile richiede anche un elenco di fonti, un formato di prova, una baseline della settimana precedente, uno scheduler e un passaggio di revisione umana. Se salti questi elementi, puoi automatizzare il rumore con la stessa efficienza con cui automatizzi le intuizioni.
Questa guida costruisce il flusso di lavoro dalle decisioni più semplici a quelle più tecniche. L’implementazione concreta utilizza l’attuale OpenAI Agents SDK e GitHub Actions perché la loro documentazione ufficiale supporta la ricerca web, gli output strutturati, il tracing e i flussi di lavoro pianificati. L’architettura stessa è neutrale rispetto al fornitore: puoi sostituire entrambi i componenti se un altro runtime di agenti o scheduler si adatta meglio al tuo stack.
Cosa dovrebbe fare effettivamente un agente di monitoraggio settimanale dei concorrenti?
Al minimo, il sistema dovrebbe rispondere a quattro domande: cosa è cambiato, da dove proviene la prova, come il cambiamento differisce dall’ultimo stato noto e se una persona dovrebbe prestarvi attenzione. “Agente AI” qui significa un flusso di lavoro basato su LLM che ha istruzioni e strumenti e può eseguire una sequenza di azioni verso un obiettivo. L’attuale Agents SDK di OpenAI descrive gli agenti nello stesso modo generale: un modello configurato con istruzioni, strumenti e comportamento runtime opzionale come guardrail e output strutturati. Vedi la documentazione ufficiale di OpenAI Agents SDK.
Non progettare la prima versione per “monitorare tutto”. Inizia con un ambito ristretto che puoi ancora auditarne manualmente. Una volta che ti fidi della pipeline, ampliala.
Passaggio 1: Definire i concorrenti, i segnali e le domande settimanali
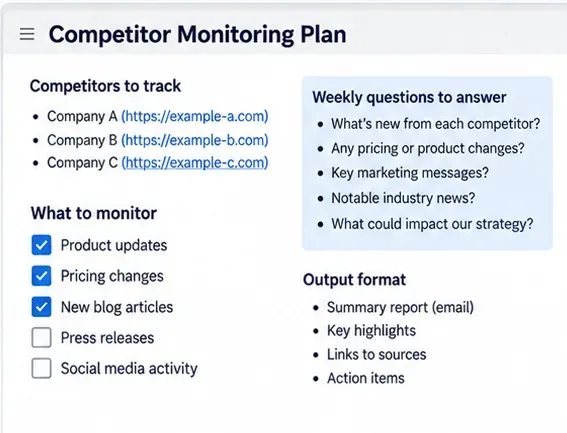
Crea un brief di monitoraggio prima di scrivere qualsiasi codice dell’agente. Per ogni concorrente, decidi quali cambiamenti vale la pena segnalare. I segnali tipici includono modifiche ai prezzi pubblici, lanci di prodotti, note di rilascio, nuove integrazioni, cambiamenti di posizionamento, aggiornamenti importanti della documentazione, partnership pubbliche, annunci esecutivi e principali modelli di assunzione. L’elenco esatto dovrebbe corrispondere alle decisioni che il tuo team prende effettivamente.
Un brief utile separa i segnali dalle domande. “La pagina dei prezzi è cambiata” è un segnale. “Il nuovo piano rende il concorrente più attraente per i piccoli team?” è una domanda analitica. L’agente dovrebbe raccogliere il primo e ragionare sulla seconda solo dopo aver raccolto prove.
Illustrazione concettuale generata da AI di un brief di monitoraggio; non è uno screenshot di un prodotto reale.
Per una prima esecuzione settimanale, scrivi una frase che definisca il successo. Ad esempio: “Entro lunedì mattina, produci un riepilogo con link alle fonti dei cambiamenti materiali degli ultimi sette giorni per cinque concorrenti nominati, senza affermazioni non supportate.” Quella frase diventa un test di accettazione pratico in seguito.
Passaggio 2: Costruire un registro delle fonti invece di affidarsi alla ricerca aperta
La ricerca web è utile per la scoperta, ma un sistema di monitoraggio non dovrebbe dipendere solo dalle classifiche di ricerca. Costruisci un piccolo registro delle fonti con campi come concorrente, tipo di fonte, URL, priorità, frequenza di aggiornamento prevista e quale domanda la fonte può rispondere.
Segnale
Fonte preferita
Perché è utile
Prezzi
Pagine ufficiali di prezzi e piani
Fonte più vicina all’offerta commerciale attuale
Modifiche al prodotto
Note di rilascio, changelog, blog del prodotto
Di solito fornisce date e contesto delle funzionalità
Posizionamento
Homepage, pagine prodotto, pagine delle campagne
Mostra come l’azienda presenta il prodotto
Notizie aziendali
Sala stampa e blog aziendale
Utile per partnership, finanziamenti, leadership e lanci
Contesto di mercato
Fonti di notizie pubbliche affidabili
Aggiunge contesto indipendente alle affermazioni di prima parte
Preferisci pagine pubbliche, feed ufficiali, API documentate e fonti a cui sei autorizzato ad accedere. Non progettare l’agente per bypassare login, paywall, restrizioni robots o controlli di accesso. Per le piattaforme social, preferisci API ufficiali o feed pubblici dove disponibili piuttosto che scraping fragile.
Illustrazione concettuale generata da AI di un registro delle fonti; usa solo fonti a cui ti è permesso accedere.
L’attuale Agents SDK di OpenAI include un WebSearchTool ospitato per gli agenti che utilizzano i modelli OpenAI Responses. La documentazione ufficiale dello strumento distingue anche la ricerca web ospitata dagli strumenti di funzione locali, il che è utile se vuoi che l’agente chiami il tuo fetcher di URL, database, lettore RSS o servizio di rilevamento delle modifiche. Vedi la guida ufficiale agli strumenti Agents SDK.
Passaggio 3: Definire lo schema delle prove prima di chiedere al modello di riassumere
Il modo più semplice per ottenere report settimanali incoerenti è chiedere “un riassunto delle notizie sui concorrenti”. Invece, definisci un risultato strutturato. Al minimo, ogni risultato dovrebbe contenere il concorrente, la categoria, la data osservata, un breve riassunto, l’URL della fonte, un estratto di prova o nota della fonte e un flag di confidenza o revisione.
Aggiungi campi per previous_state e current_state quando il segnale può essere confrontato direttamente, come il prezzo di un piano, la disponibilità di una funzionalità, un titolo o un’integrazione documentata. Questo rende il report incentrato sul cambiamento piuttosto che su ciò che il modello ha trovato per caso quella settimana.
L’output strutturato rende anche il flusso di lavoro più facile da testare. L’Agents SDK supporta attualmente un output_type su un agente e la documentazione ufficiale raccomanda tipi Python normali come modelli Pydantic o dataclass per risultati strutturati. Vedi la guida ufficiale alla configurazione dell’agente.
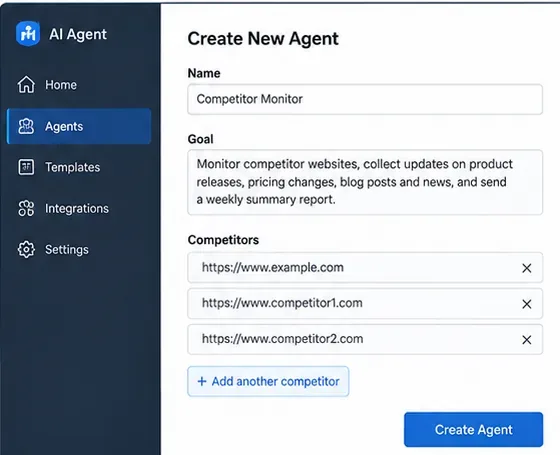
Illustrazione concettuale generata da AI delle istruzioni dell’agente e della pianificazione; non è un’interfaccia di prodotto reale.
L’ultimo campo è importante. Un buon sistema di monitoraggio dovrebbe essere in grado di dire “nessun cambiamento materiale trovato” invece di inventare un aggiornamento per riempire lo spazio.
Passaggio 4: Eseguire un pilota manuale prima di automatizzare qualsiasi cosa
Esegui il flusso di lavoro manualmente per un periodo di reporting e confronta il risultato con la tua revisione delle stesse fonti. Questo pilota rivela problemi più difficili da notare dopo la pianificazione: risultati di ricerca obsoleti, storie duplicate, una tassonomia di categorie poco chiara, inferenze non supportate, URL di fonte mancanti e risultati tecnicamente nuovi ma strategicamente irrilevanti.
Per ogni risultato proposto, chiedi: la fonte è di prima parte o indipendentemente affidabile, il cambiamento è all’interno della finestra di date prevista, posso indicare la prova esatta e lo stesso elemento verrebbe segnalato di nuovo la prossima settimana se nulla cambia? Se la risposta all’ultima domanda è sì, hai ancora bisogno di una baseline o di una regola di deduplicazione.
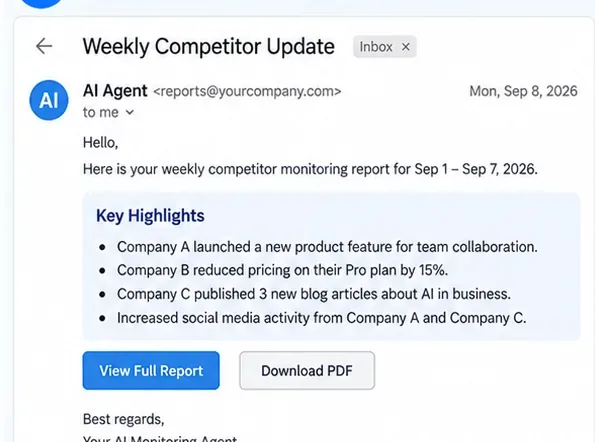
Illustrazione concettuale generata da AI di un report pilota manuale con link alle prove.
Non trattare gli snippet di ricerca come il record di prova. Archivia l’URL della fonte e, dove i tuoi termini e diritti di accesso lo consentono, uno snapshot normalizzato o il testo estratto utilizzato per il confronto. La ricerca dovrebbe aiutare a localizzare le prove; non dovrebbe diventare un sostituto delle prove.
Passaggio 5: Implementare l’agente con ricerca web, output strutturato e una baseline
Una volta che il pilota manuale produce risultati utili, integra l’agente nel codice. A settembre 2026, l’Agents SDK Python di OpenAI può combinare un Agent, un WebSearchTool ospitato e un output_type strutturato. L’esempio seguente è intenzionalmente piccolo: dimostra il livello dell’agente, non il livello di archiviazione.
from pydantic import BaseModel
from agents import Agent, Runner, WebSearchTool

class Finding(BaseModel):
    competitor: str
    category: str
    summary: str
    source_url: str
    evidence: str
    observed_at: str
    needs_human_review: bool

class WeeklyReport(BaseModel):
    findings: list[Finding]
    executive_summary: str

agent = Agent(
    name="Weekly competitor monitor",
    instructions=(
        "Monitor only the competitors and topics in the input. "
        "Use public web sources. Every finding must include a source URL "
        "and evidence. Prefer first-party sources for product and pricing claims. "
        "Do not invent a change when no material change is supported."
    ),
    tools=[WebSearchTool()],
    output_type=WeeklyReport,
)

result = Runner.run_sync(
    agent,
    "Review the configured competitors for the reporting window and return the report."
)

report = result.final_output
L’installazione del pacchetto e il pattern del runner sono documentati nella guida rapida ufficiale di Agents SDK. L’SDK documenta anche Runner.run_sync() come wrapper sincrono attorno alla normale esecuzione dell’agente.
Illustrazione concettuale generata da AI di un flusso di lavoro dell’agente; i dettagli di implementazione dipendono dal tuo stack.
Aggiungi il rilevamento deterministico delle modifiche dove possibile
Non chiedere al modello di riscoprire ogni vecchio stato dalla memoria. Persisti una baseline. Per ogni fonte, archivia l’ultima osservazione riuscita: testo normalizzato, un hash del contenuto, campi selezionati come prezzo o nome del piano, il timestamp dell’osservazione e l’URL della fonte. Alla prossima esecuzione, confronta prima la nuova osservazione con la baseline. Poi dai all’agente la differenza da interpretare.
Questo design ibrido è più affidabile di “AI confronta due interi siti web” perché il codice deterministico gestisce il confronto esatto mentre il modello gestisce la classificazione, la rilevanza e la spiegazione. Se una pagina cambia solo il suo footer o i parametri di tracciamento, il tuo normalizzatore può rimuovere quel rumore prima che l’agente lo veda.
Passaggio 6: Pianificare il flusso di lavoro settimanalmente e tenere le credenziali fuori dal codice
Puoi eseguire il monitor da qualsiasi scheduler che si adatti al tuo ambiente. GitHub Actions è un’opzione pratica per un flusso di lavoro basato su repository. L’attuale documentazione di GitHub afferma che i flussi di lavoro pianificati usano la sintassi cron POSIX, vengono eseguiti sul branch predefinito, sono impostati su UTC per impostazione predefinita e possono specificare opzionalmente un fuso orario IANA. GitHub avverte anche che le esecuzioni possono essere ritardate durante i periodi di alto carico, specialmente intorno all’inizio dell’ora, quindi un minuto come 17 è preferibile a 00 quando l’esecuzione esatta all’inizio dell’ora non è necessaria. Vedi la documentazione ufficiale della pianificazione di GitHub Actions.
Archivia le chiavi API come segreti crittografati piuttosto che committarli nel repository. La guida ufficiale sui segreti di GitHub spiega i segreti di repository, ambiente e organizzazione e raccomanda di evitare la divulgazione accidentale nei log dei flussi di lavoro.
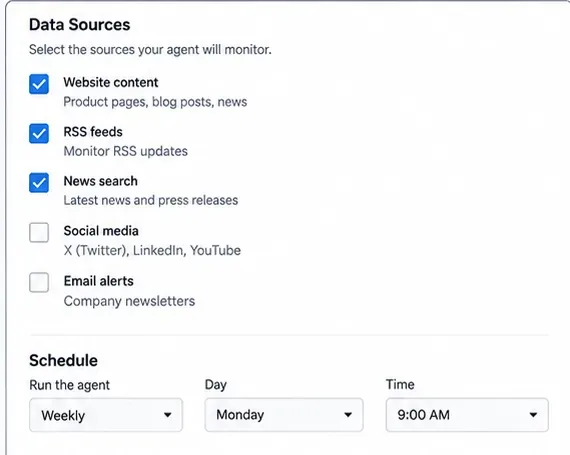
Illustrazione concettuale generata da AI di un livello di pianificazione; l’articolo usa GitHub Actions come esempio concreto.
Un dettaglio operativo facile da trascurare: GitHub afferma che i flussi di lavoro pianificati nei repository pubblici vengono automaticamente disabilitati dopo 60 giorni senza attività nel repository. Se questo flusso di lavoro è critico per la missione, monitora il monitor: registra l’ora dell’ultima esecuzione riuscita e avvisa quando il lavoro settimanale previsto non viene completato.
Passaggio 7: Mettere una porta di revisione umana tra “risultato” e “decisione”
Il monitoraggio settimanale dei concorrenti è un flusso di lavoro di lettura e riassunto, quindi non dovrebbe modificare automaticamente i prezzi, pubblicare contenuti o alterare una roadmap di prodotto. Una persona dovrebbe rivedere le affermazioni materiali prima che influenzino una decisione. La revisione può essere leggera: approva, rifiuta, unisci con un altro risultato o segna come “osserva la prossima settimana”.
Richiedi una revisione più rigorosa per categorie ad alto impatto come prezzi, affermazioni legali, incidenti di sicurezza, licenziamenti, acquisizioni o dichiarazioni che si basano su report di terze parti. Per i cambiamenti di prodotto e prezzi, preferisci la pagina del concorrente stesso come prova primaria anche se una notizia ti ha aiutato a scoprirlo.
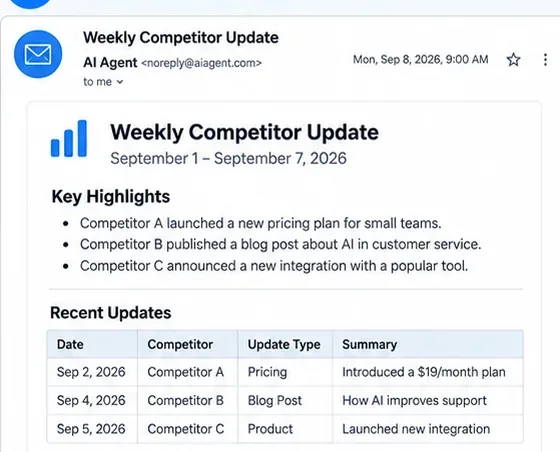
Illustrazione concettuale generata da AI della fase di revisione umana prima che i risultati siano condivisi o su cui si agisca.
Se la tua implementazione aggiunge successivamente strumenti che possono intraprendere azioni, l’Agents SDK include guardrail e meccanismi di approvazione umana-in-the-loop. La documentazione ufficiale sui guardrail descrive i guardrail di input, output e strumento, mentre la guida umana-in-the-loop spiega come mettere in pausa le chiamate di strumento sensibili per l’approvazione.
Passaggio 8: Tracciare le tendenze, tracciare i fallimenti e auto-verificare il sistema
Un report settimanale utile diventa più prezioso dopo diverse esecuzioni perché puoi distinguere eventi isolati da pattern. Archivia ogni risultato approvato in una semplice tabella o database con concorrente, categoria, data, fonte e stato di revisione. Poi puoi rispondere a domande come quale concorrente ha cambiato i prezzi più spesso, quali temi ricorrono nelle note di rilascio o quali fonti monitorate non producono più segnali utili.
Illustrazione concettuale generata da AI del tracciamento delle tendenze e dell’auto-verifica su più esecuzioni settimanali.
Per l’agente stesso, mantieni l’osservabilità. L’Agents SDK di OpenAI include un tracing integrato che registra le generazioni del modello, le chiamate agli strumenti, gli handoff, i guardrail e gli eventi personalizzati. La guida ufficiale al tracing descrive come tracce e span possono essere usati per il debug e il monitoraggio dei flussi di lavoro. Sii deliberato riguardo ai dati sensibili perché i payload delle tracce possono includere input/output del modello e degli strumenti a seconda della configurazione.
Auto-verifica prima di fidarti del report settimanale
Ogni risultato materiale ha un URL di fonte funzionante e una data all’interno della finestra di reporting.
Le affermazioni di prodotto e prezzi di prima parte sono supportate da prove di prima parte ogni volta che possibile.
Il sistema confronta contro l’ultimo stato noto invece di ripetere semplicemente vecchie notizie.
“Nessun cambiamento materiale” è un risultato accettabile per qualsiasi concorrente.
Le storie duplicate da più testate sono unite piuttosto che contate come cambiamenti separati.
Il lavoro pianificato ha un timestamp di successo registrato e le esecuzioni mancate sono rilevabili.
Le chiavi API e altre credenziali sono archiviate come segreti e non appaiono nei log o nei report.
Un umano rivede i risultati ad alto impatto prima che il team agisca su di essi.
Errori comuni che rendono il monitoraggio dei concorrenti con AI inaffidabile
Monitorare solo tramite query di ricerca
La ricerca è eccellente per la scoperta ma instabile come baseline storica. Mantieni URL di fonte espliciti e persisti le osservazioni precedenti.
Chiedere al modello “notizie importanti” senza uno schema
L’importanza è soggettiva. Definisci categorie, requisiti di prova e un flag di revisione in modo che l’output possa essere audito.
Lasciare che l’agente riassuma senza date
Un risultato può essere rilevante ma vecchio. Includi sempre la finestra di reporting e richiedi una data osservata o pubblicata quando la fonte ne fornisce una.
Inviare ogni elemento scoperto agli stakeholder
Separa la raccolta dal reporting. Il livello di raccolta può trovare molti elementi candidati; il report finale dovrebbe contenere solo cambiamenti supportati da prove, deduplicati, che soddisfano le tue regole di rilevanza.
Automatizzare le azioni troppo presto
La prima versione più sicura è in sola lettura: raccogli, confronta, riassumi e richiedi revisione. Aggiungi azioni di scrittura solo dopo che puoi misurare i falsi positivi e comprendere le modalità di fallimento.
Un’architettura semplice che puoi riutilizzare
Il pattern durevole è: registro delle fonti → raccolta → normalizzazione → confronto baseline → analisi dell’agente → risultati strutturati → revisione umana → report settimanale → archivio delle tendenze. L’agente AI è più forte nelle fasi di interpretazione, mentre il codice ordinario è solitamente migliore per la pianificazione esatta, l’archiviazione dello stato, l’hashing, i retry e i confronti deterministici.
Se il flusso di lavoro supera l’auto-verifica per diverse esecuzioni consecutive, puoi espandere con cautela: aggiungi più concorrenti, aggiungi agenti specializzati per i cambiamenti di prezzi o prodotti, aggiungi un database o instrada i report approvati a email, Slack o la tua base di conoscenza interna. L’obiettivo non è creare l’agente più autonomo. È creare il sistema ripetibile più piccolo che dia al tuo team cambiamenti nei concorrenti tempestivi e supportati da fonti ogni settimana.