Het is mogelijk om de LLM API-rekening in veel workloads met 50% te verlagen, maar dit is geen universele garantie. Het resultaat hangt af van waar uw uitgaven vandaan komen: niet-gecachte invoertokens, gecachte invoertokens, outputtokens, redeneertokens, toolaanroepen of retries. Promptcompressie werkt het beste wanneer lange of repetitieve invoeren een aanzienlijk deel van de rekening uitmaken. Het praktische doel is daarom niet "maak elke prompt half zo lang". Het is "verwijder tokens die het antwoord niet veranderen, behoud de tokens die dat wel doen, en verifieer de besparingen op echt verkeer".
Deze gids gebruikt vier implementatiestappen: meet de baseline, verwijder redundante invoer, organiseer prompts voor cachehergebruik, en verplaats uitgebreide outputinstructies naar gestructureerde besturingselementen waar de API dit ondersteunt. De voorbeelden zijn illustratief en geen benchmarkclaims. Providerprijzen en cachegedrag veranderen in de loop van de tijd, dus controleer de huidige tarieven voordat u een productieschatting maakt.
Wat vereist een API-kostenreductie van 50% eigenlijk?
Begin met de factureringvergelijking voor uw model. Voor een eenvoudige tekstworkload zijn de totale aanvraagkosten ongeveer de kosten van niet-gecachte invoer plus gecachte invoer plus output. Sommige modellen of functies voegen andere facturabele categorieën toe. De huidige API-responses van OpenAI tonen het gebruik van invoer- en outputtokens, inclusief details over gecachte tokens, en de modellijsten publiceren afzonderlijke tarieven voor invoer, gecachte invoer en output.
| Illustratieve workload | Invoertokens | Outputtokens | Relatief resultaat |
|---|
| Baseline-aanvraag | 10.000 | 1.000 | 100% van de baseline-kosten |
| Alleen invoer gehalveerd | 5.000 | 1.000 | Minder dan 50% totale besparing wanneer output onveranderd blijft |
| Invoer en output beide gehalveerd | 5.000 | 500 | Ongeveer 50% lagere tokengebaseerde kosten wanneer tarieven onveranderd blijven |
Voor een concreet huidig voorbeeld vermeldde de officiële GPT-5.6 Sol-modellijst op 11 september 2026 $4 per miljoen invoertokens, $0,40 per miljoen gecachte invoertokens en $20 per miljoen outputtokens. Bij die tarieven kost een aanvraag met 10.000 invoer/1.000 output ongeveer $0,06 exclusief andere kosten. Het terugbrengen van alleen de invoer naar 5.000 tokens brengt dit voorbeeld terug naar ongeveer $0,04, een reductie van 33%. Het halveren van zowel invoer als output brengt het terug naar ongeveer $0,03, een reductie van 50%. Deze prijzen kunnen veranderen, dus beschouw de berekening als een methode, niet als een permanente offerte. Zie de officiële GPT-5.6 Sol-modellijst voor actuele prijzen.
Snelreferentie: de vier waardevolste stappen
| Techniek | Beste fit | Hoofdrisico | Wat te meten |
|---|
| Tokenaudit | Elke productieworkload | Optimaliseren van de verkeerde component | Invoer, gecachte invoer, output, retries, kosten per succesvolle taak |
| Verwijdering van redundantie | Lange systeemprompts, herhaalde beleid, uitgebreide voorbeelden | Verwijderen van een beperking die er echt toe doet | Taaksucces en pariteit in instructieopvolging |
| Cachevriendelijke lay-out | Herhaalde aanvragen die stabiele instructies of context delen | Lage cachehergebruik omdat dynamische tekst te vroeg verschijnt | Verhouding gecachte tokens en latentie |
| Gestructureerde outputbesturing | JSON-extractie, classificatie, vaste antwoordformaten | Schema te rigide voor de taak | Outputtokens, parse-fouten, retries |
Stap 1: Meet de echte tokenbaseline voordat u prompts wijzigt
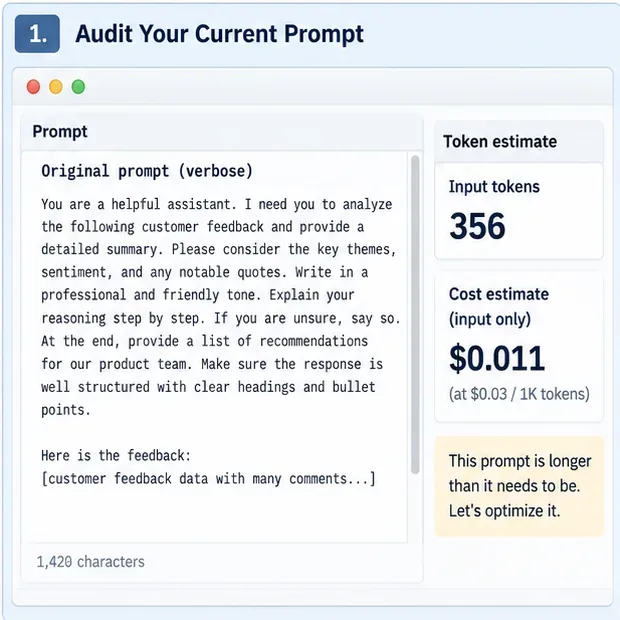
Bijschrift: Een illustratieve tokenauditinterface registreert de oorspronkelijke promptgrootte en een steekproefkostenschatting vóór compressie; de cijfers zijn geen actuele providerprijzen.
Verzamel een representatieve steekproef van productiewerkverzoeken in plaats van één handmatig gekozen prompt te optimaliseren. Leg minimaal vast: invoertokens, gecachte invoertokens (indien beschikbaar), outputtokens, modelnaam, latentie, retries en of het eindantwoord uw bedrijfskwaliteitscontrole heeft doorstaan. Als uw provider een endpoint voor het tellen van invoertokens aanbiedt, gebruik dit dan vóór het verzenden van aanvragen wanneer u deterministische budgettering nodig heeft. OpenAI documenteert momenteel een Responses-invoertoken-tellingsendpoint in zijn officiële API-referentie.
Bereken de kosten per succesvolle taak, niet alleen de kosten per API-aanroep. Een gecomprimeerde prompt die meer retries veroorzaakt, kan duurder zijn, zelfs als elke aanvraag korter is. Segmenteer de baseline ook op taaktype: samenvatting, extractie, RAG-vraagbeantwoording, agentisch toolgebruik en lange gesprekken hebben meestal verschillende tokenprofielen.
Stap 2: Verwijder redundantie zonder beslissingskritieke informatie te verwijderen

Bijschrift: Een illustratieve voor-en-na-prompt behoudt dezelfde gevraagde outputs terwijl herhaalde formuleringen en onnodige procesinstructies worden verwijderd.
De veiligste eerste compressiepas is semantische deduplicatie. Verwijder herhaalde rolbeschrijvingen, gedupliceerde beperkingen, beleefde vulwoorden, uitleg over voor de hand liggende opmaak en voorbeelden die hetzelfde patroon meer dan één keer onderwijzen. Voeg overlappende regels samen tot één instructie. Geef de voorkeur aan één precieze zin boven meerdere zinnen die dezelfde eis herhalen.
Vóór
Je bent een behulpzame assistent die expert is in productanalyse.
Ik heb je nodig om de volgende klantfeedback te analyseren en een
gedetailleerde samenvatting te geven. Identificeer de belangrijkste thema's,
het algemene sentiment, opmerkelijke citaten en aanbevelingen voor ons productteam.
Zorg ervoor dat je antwoord professioneel, duidelijk, beknopt en goed gestructureerd is.
Na
Analyseer de klantfeedback.
Retourneer: belangrijkste thema's, algemeen sentiment, opmerkelijke citaten en productaanbevelingen.
Wees beknopt en feitelijk.
Comprimeer geen uitzonderingen, beleidsgrenzen, domeindefinities, toolveiligheidsregels of bewijsvereisten weg alleen omdat ze lang zijn. Dat zijn vaak hoogwaardige tokens. Een nuttige test is om te vragen: "Als ik deze zin verwijder, kan dan het aanvaardbare antwoord veranderen?" Zo ja, behoud het tenzij een API-besturingselement of schema hetzelfde gedrag betrouwbaarder kan afdwingen.
Stap 3: Plaats stabiele inhoud eerst en dynamische inhoud als laatste
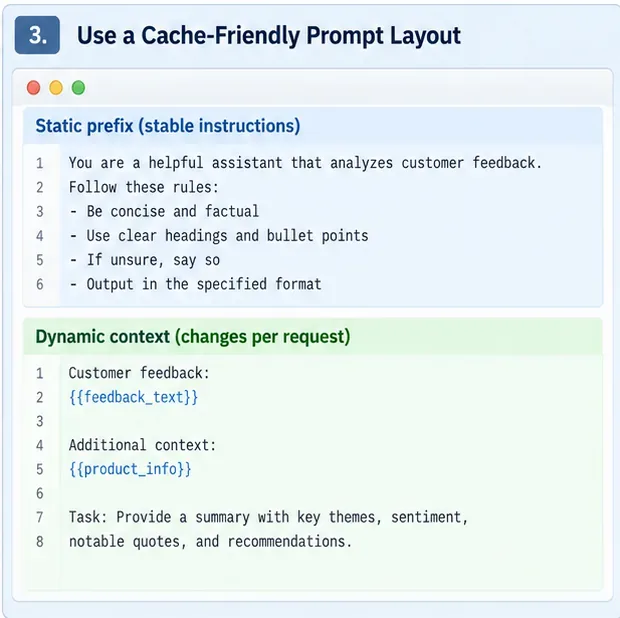
Bijschrift: Een illustratieve promptlay-out plaatst stabiele instructies in een herbruikbaar voorvoegsel en voegt aanvraagspecifieke context later toe.
Promptcaching verlaagt niet het ruwe aantal tokens, maar kan wel het bedrag dat tegen het normale invoertarief wordt gefactureerd verlagen en de promptverwerkingslatentie verminderen. Dit maakt promptlay-out onderdeel van kostenoptimalisatie. Groepeer systeeminstructies, gedeelde voorbeelden, toolbegeleiding en andere stabiele inhoud bij elkaar. Plaats aanvraagspecifieke feiten, opgehaalde passages, gebruikersgegevens en de huidige vraag later.
De modelrichtlijnen van OpenAI raden expliciet aan om statische inhoud eerst en dynamische inhoud als laatste te plaatsen om promptcachehergebruik te verbeteren, en het response-usage-object exposeert informatie over gecachte tokens voor meting. Zie de officiële modelrichtlijnen en de Responses API-referentie.
Vermijd het wijzigen van onschadelijke witruimte, voorbeeldvolgorde, tijdstempels, willekeurige ID's of per-gebruiker tekst binnen een anders herbruikbaar voorvoegsel, tenzij de cache-semantiek van de provider aangeeft dat die wijzigingen veilig zijn. Meet cachehits uit de API-respons in plaats van aan te nemen dat een prompt wordt hergebruikt.
Stap 4: Vervang proza over formaat door gestructureerde outputbesturingselementen
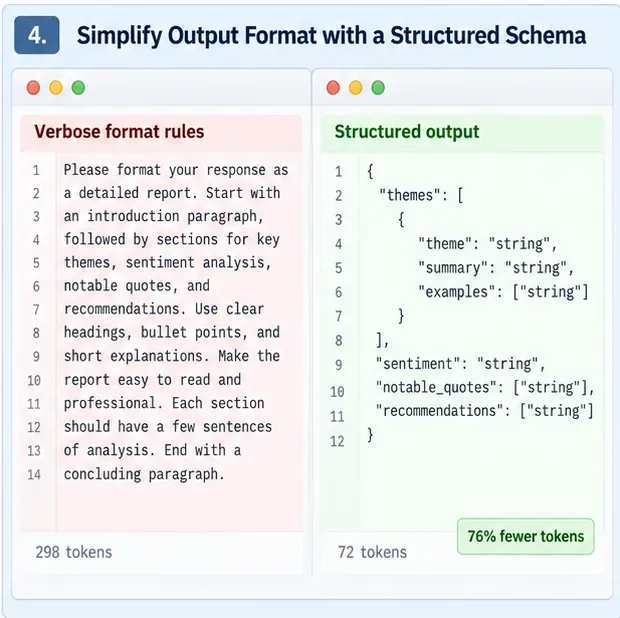
Bijschrift: Een illustratieve gestructureerde outputweergave toont hoe een schema veel regels proza kan vervangen die steeds dezelfde responsvorm beschrijven.
Extractie- en classificatieprompts verspillen vaak tokens door JSON-velden, toegestane waarden, nesting, volgorde en validatieregels in natuurlijke taal te beschrijven. Wanneer de API gestructureerde outputs of getypte toolargumenten ondersteunt, verplaats dan zoveel mogelijk van dat contract naar de gestructureerde interface en houd de natuurlijke taal-instructie gericht op betekenis.
De huidige richtlijnen van OpenAI raden specifiek aan om output-schema-definities uit de prompt te verwijderen waar mogelijk en in plaats daarvan Structured Outputs te gebruiken. Dit kan prompttekst verminderen en ook retries voor onjuiste output verminderen. Het exacte mechanisme verschilt per provider, dus kopieer geen OpenAI-specifiek aanvraagformaat naar een andere API zonder de documentatie van die provider te controleren.
Geavanceerde compressie voor RAG, lange documenten en gesprekken
Nadat de vier basisstappen stabiel zijn, komen grotere besparingen meestal voort uit het verminderen van context in plaats van het polijsten van zinsformuleringen. In RAG-systemen, haal minder maar relevantere passages op, dedupliceer bijna identieke chunks en vermijd het koppelen van documenten die het antwoord niet kunnen beïnvloeden. Voor lange gesprekken, behoud duurzame feiten en onopgeloste beslissingen, maar vat samen of laat beurtjes weg die geen invloed meer hebben op de huidige taak. Voor agentsystemen, exposeer alleen de tools en toolbeschrijvingen die relevant zijn voor de huidige fase wanneer uw architectuur dit veilig toelaat.
Geleerde promptcompressors zijn een andere optie voor zeer lange contexten. Het open-source LLMLingua-project van Microsoft implementeert tokenniveau-promptcompressie. Het originele LLMLingua-paper rapporteerde compressieverhoudingen tot 20× met beperkte benchmarkdegradatie in de geëvalueerde instellingen. LongLLMLingua richt zich op taken met lange context, terwijl LLMLingua-2 een taakagnostische geleerde compressor gebruikt. Dit zijn onderzoeksresultaten, geen belofte dat dezelfde verhoudingen de kwaliteit op uw gegevens behouden. Benchmark uw eigen taken, talen, modellen en prompttypes voordat u agressieve compressie implementeert.
Hoe bewijst u dat de optimalisatie daadwerkelijk beter is?
Voer een A/B-evaluatie uit op dezelfde representatieve aanvragen. De baseline- en gecomprimeerde versies moeten hetzelfde model, dezelfde redeneerinstellingen, tools, retrieval-invoeren en succescriteria gebruiken. Verander waar mogelijk één compressietechniek tegelijk, zodat u kunt identificeren wat een regressie heeft veroorzaakt.
| Metriek | Waarom het ertoe doet | Suggestieve interpretatie |
|---|
| Reductie invoertokens | Toont ruwe promptkrimp | Nuttig, maar op zichzelf niet voldoende |
| Verhouding gecachte tokens | Toont of stabiele voorvoegsels worden hergebruikt | Hoger is meestal beter wanneer kwaliteit onveranderd blijft |
| Reductie outputtokens | Kan totale kosten wezenlijk veranderen | Verifieer dat beknopte output de taak nog steeds voltooit |
| Kosten per succesvolle taak | Inclusief retries en fouten | Dit is de primaire bedrijfsmetriek |
| Taaksucces / nauwkeurigheid | Detecteert informatieverlies | Stel een aanvaardbare niet-ondergeschiktheidsgrens in vóór testen |
| p50 en p95 latentie | Toont echte gebruikersimpact | Compressievoorverwerking kan inferentiewinsten tenietdoen |
Verklaar geen overwinning omdat een prompt 50% korter is. De sterkere acceptatievoorwaarde is: de gecomprimeerde configuratie verlaagt de gemeten kosten met ongeveer uw doelbedrag terwijl het binnen uw vooraf gedefinieerde toleranties voor kwaliteit, latentie en betrouwbaarheid blijft.
Wanneer moet u stoppen met comprimeren?
Stop of schaal terug wanneer de volgende reductie feiten verwijdert die nodig zijn voor correcte beslissingen, hallucinaties verhoogt, toolaanroepfouten veroorzaakt, beleidsnaleving verzwakt of retries genoeg verhoogt om de besparingen teniet te doen. Compressie kan ook latentie toevoegen als u een apart model draait om elke prompt te comprimeren. Een 2026-studie naar promptcompressie in echte inferentieomgevingen ontdekte dat voorverwerkingskosten inferentiewinsten buiten gunstige promptlengte- en hardware-regimes kunnen tenietdoen, wat een andere reden is om end-to-end prestaties te meten in plaats van alleen het aantal tokens.
Voor kleine prompts zijn handmatige opschoning en cachevriendelijke organisatie meestal makkelijker te rechtvaardigen dan het toevoegen van een speciale compressiemodel. Voor grote RAG-payloads of multi-document workflows worden contextselectie en geleerde compressie aantrekkelijker omdat het verwijderbare tokenvolume veel groter is.
Snelle implementatiechecklist
- Leg een productiewaarde vast met invoer, gecachte invoer, output, latentie, retries en taaksucces.
- Verwijder eerst gedupliceerde instructies, waardevolle proza en redundante voorbeelden.
- Behoud domeindefinities, uitzonderingen, bewijsvereisten en veiligheidsbeperkingen.
- Plaats stabiele promptinhoud vóór dynamische aanvraagspecifieke inhoud wanneer cache-semantiek herbruikbare voorvoegsels beloont.
- Gebruik gestructureerde outputs of toolschema's in plaats van steeds vaste antwoordformaten in proza te beschrijven.
- Verminder voor RAG irrelevante en dubbele context voordat u tokenniveau-compressie probeert.
- Beperk de outputlengte alleen wanneer de taak nog correct kan worden voltooid.
- Vergelijk kosten per succesvolle taak, niet alleen het aantal prompttokens.
- Voer regressietests uit vóór en na elke betekenisvolle compressiewijziging.
- Controleer providerprijzen en cacheregels opnieuw wanneer u modellen of API-versies wijzigt.
Eindconclusie
Een reductie van 50% is een redelijk engineeringdoel voor sommige uitgebreide, contextrijke workloads, maar het moet worden behandeld als een resultaat dat moet worden gevalideerd, niet als een standaardverwachting. Het meest betrouwbare pad is om eerst te meten, semantisch redundante tekst te verwijderen, veilig cachehergebruik te maximaliseren, outputcontracten te verkorten met gestructureerde besturingselementen, en vervolgens de grootste resterende contextblokken aan te vallen met retrieval-pruning, samenvatting of een geteste promptcompressor. Als de uiteindelijke kosten per succesvolle taak dalen terwijl de kwaliteit binnen uw acceptatieband blijft, werkt de compressie. Als de kwaliteit of retries verslechteren, stel dan de ontbrekende informatie weer in en optimaliseer een ander deel van de aanvraag.
Primaire referenties








