Home
» Domeinen
»
DeepSeek offline uitvoeren op Windows 11 met LM Studio
DeepSeek offline uitvoeren op Windows 11 met LM Studio
Ja, je kunt DeepSeek volledig offline uitvoeren op Windows 11 met LM Studio, maar je hebt eerst één online installatie nodig. Installeer LM Studio, download een compatibel DeepSeek-model en de vereiste runtime, laad het model één keer, en daarna kun je de internetverbinding verbreken. De officiële offline documentatie van LM Studio stelt dat chatten met gedownloade modellen, chatten met lokale documenten en het uitvoeren van de lokale server geen internettoegang vereisen.
Voor een typische Windows 11-pc is het meest praktische startpunt niet het grootste huidige DeepSeek-model. Een kleiner GGUF-model zoals DeepSeek-R1-0528-Qwen3-8B is veel eenvoudiger lokaal uit te voeren. LM Studio heeft in mei 2025 ondersteuning gepubliceerd voor dat 8B-distilled model en zegt dat het werkt in GGUF-formaat met LM Studio 0.3.16 of nieuwer. Ter vergelijking: de richtlijnen van LM Studio uit augustus 2026 voor DeepSeek V4 Flash stellen dat lokaal gebruik ongeveer 156GB systeemgeheugen vereist. Dit maakt V4 Flash een slechte keuze voor de meeste consumenten-Windows-machines, ondanks dat het nieuwer en krachtiger is.
Deze gids is gecontroleerd op 11 september 2026. De changelog van LM Studio vermeldt versie 0.4.24 gedateerd 9 september 2026. Omdat de interface van LM Studio evolueert, kan een knop tussen builds iets verplaatsen, maar de kernworkflow—een model downloaden, laden, lokaal chatten en optioneel een localhost-API blootstellen—blijft gedocumenteerd door LM Studio.
Voor je begint: past je Windows 11-pc?
LM Studio ondersteunt momenteel zowel x64 Windows-pc's als ARM-gebaseerde Windows-systemen. Voor x64 moet de CPU AVX2 ondersteunen. LM Studio adviseert minimaal 16GB RAM en minimaal 4GB dedicated VRAM. Dit zijn aanbevelingen op applicatieniveau, geen garantie dat elk model past. Modelgrootte, kwantisatie, contextlengte en GPU-offload hebben allemaal invloed op het geheugengebruik.
Wat je hebt
Praktische aanbeveling
Waarom
16GB RAM, bescheiden GPU of geïntegreerde graphics
Begin met een 8B of kleiner DeepSeek distilled model in een 4-bit GGUF-variant
Het houdt de modelvoetafdruk relatief beheersbaar terwijl nuttige redeneerkracht behouden blijft.
Meer RAM en een sterkere GPU
Probeer grotere distilled varianten pas nadat je de apparaatgeschiktheidsschatting van LM Studio hebt gecontroleerd
Grotere modellen kunnen de kwaliteit verbeteren, maar verbruiken aanzienlijk meer geheugen en kunnen veel langzamer zijn.
Gewone gaming-pc of laptop
Begin niet met DeepSeek V4 Flash
LM Studio zegt dat het lokale V4 Flash-model minimaal 156GB systeemgeheugen nodig heeft.
De documentatie voor modeldownloads van LM Studio legt uit dat gekwantiseerde builds enige trouw inruilen voor kleinere bestanden en lagere geheugendruk. De algemene aanbeveling is om een 4-bit optie of hoger te kiezen als je hardware dit aankan. Als je twijfelt, is een 4-bit GGUF-versie een verstandige eerste test.
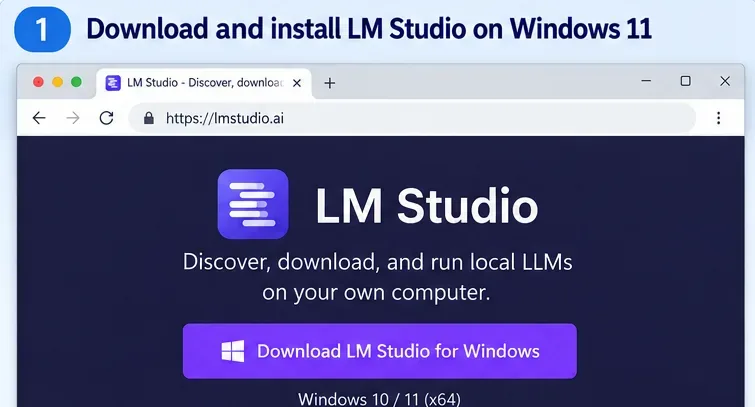
Download de huidige stabiele Windows-build van de officiële LM Studio downloadpagina. Gebruik het installatieprogramma dat overeenkomt met je Windows-architectuur. Op een x64-pc, zorg ervoor dat je processor AVX2 ondersteunt voordat je later fouten bij het laden van modellen gaat oplossen.
De Windows downloadweergave voor LM Studio. Kies het installatieprogramma dat overeenkomt met je Windows 11-systeem voordat je doorgaat naar de modeldownload.
Start LM Studio terwijl je nog een internetverbinding hebt. Dit is belangrijk omdat de app mogelijk een LM Runtime moet downloaden of bijwerken. LM Studio beschrijft runtimes als verpakte inferentie-engines, zoals zijn llama.cpp-gebaseerde runtime voor GGUF-modellen. Runtime-downloads vereisen connectiviteit, hoewel inferentie daarna offline kan werken.
Stap 2: Download een DeepSeek-model dat past bij je pc
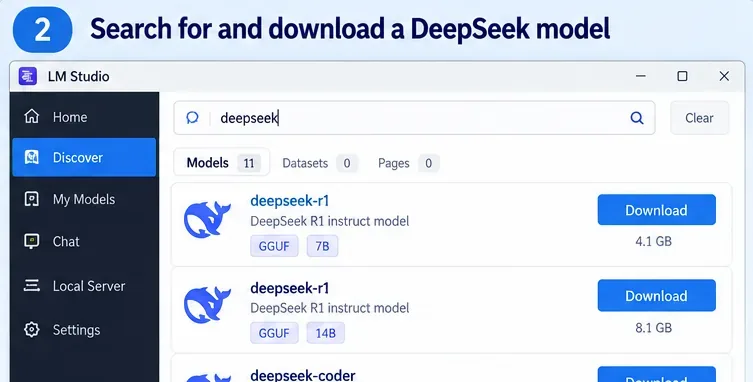
Open het Discover-gebied in LM Studio en zoek op DeepSeek. LM Studio kan ondersteunde Hugging Face-modellen zoeken op trefwoord, op een user/model-identifier, of zelfs op een volledige Hugging Face-URL.
Zoek naar DeepSeek in Discover, kies vervolgens een model en kwantisatie die geschikt zijn voor je hardware. Exacte catalogusvermeldingen en bestandsgroottes veranderen na verloop van tijd.
Welk DeepSeek-model moet je kiezen?
Voor de meeste mensen die deze gids volgen, begin met DeepSeek-R1-0528-Qwen3-8B. LM Studio zegt dat dit distilled 8B-model redeneren en toolgebruik ondersteunt, beschikbaar is als GGUF, en kan draaien met veel minder geheugen dan de vlaggenschip DeepSeek-modellen. De Windows-richtlijnen van LM Studio adviseren nog steeds 16GB RAM voor de applicatie als geheel, dus beschouw een model-specifieke claim over laag geheugengebruik niet als een comfortabel doel voor het hele systeem.
DeepSeek heeft ook eerdere R1 distilled varianten uitgebracht met 1,5B, 7B, 8B, 14B, 32B en 70B parameters. Deze geven je ruimte om snelheid en geheugengebruik af te wegen tegen capaciteit. Zie de officiële DeepSeek-R1 repository voor de modelfamilie en licentiedetails, en de DeepSeek-R1-0528 notitie over lokaal uitvoeren van LM Studio voor de 8B-optie.
Als je verleid wordt door DeepSeek V4 Flash omdat het nieuwer is, controleer dan eerst de hardwarevereisten. Het officiële V4 Flash-artikel van LM Studio zegt dat het 284B Mixture-of-Experts-model minimaal 156GB systeemgeheugen nodig heeft voor lokaal gebruik. Het is levensvatbaar op werkstations met veel geheugen, niet op een normale Windows-laptop.
Stap 3: Laad het model in het geheugen
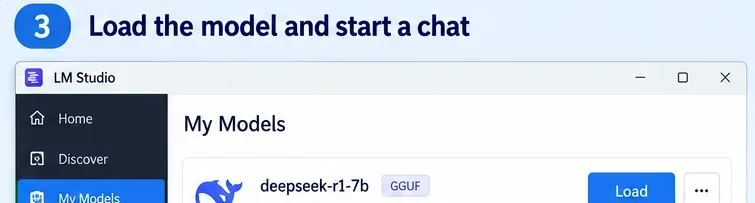
Nadat de download is voltooid, ga naar je gedownloade modellen of open de modelloader vanuit Chat. Selecteer het DeepSeek-model en laad het. LM Studio legt uit dat het laden van een model geheugen toewijst voor de modelgewichten en gerelateerde runtime-status.
Een gedownload DeepSeek GGUF-model klaar om te laden. Als het laden mislukt, probeer dan een kleiner model of een kwantisatie met minder geheugen voordat je geavanceerde instellingen wijzigt.
Houd bij je eerste run de laadinstellingen conservatief. Een zeer groot contextvenster kan aanzienlijk extra geheugen verbruiken, dus er is weinig reden om de context onmiddellijk te maximaliseren. Laad het model met een bescheiden context, verifieer dat het werkt, en breid alleen uit wanneer je workload dit vereist.
Als LM Studio meldt dat het model niet past, is de meest betrouwbare oplossing meestal het kiezen van een kleiner model of een compactere kwantisatie. Het sluiten van geheugenhongerige applicaties kan helpen, maar verandert de fundamentele modelvoetafdruk niet.
Stap 4: Verbreek de internetverbinding en verifieer dat DeepSeek echt offline werkt
Dit is de stap die "lokaal model" scheidt van slechts "een desktopclient gebruiken". Zodra het model en de runtime zijn geïnstalleerd, schakel je Wi-Fi uit en verbreek je de Ethernet-verbinding. Start vervolgens een nieuwe chat en stuur een eenvoudige prompt zoals:
Leg het verschil uit tussen RAM en VRAM in vijf bullet points.
Als het model reageert terwijl de pc geen netwerkverbinding heeft, is de inferentie lokaal. LM Studio stelt dat zodra een LLM op je machine staat, deze volledig offline kan draaien en dat tekst die in lokale LLM-chats wordt ingevoerd je apparaat niet verlaat. De offline documentatie zegt ook dat lokale documentverwerking en RAG op de machine blijven.
Een geladen DeepSeek-model dat reageert in LM Studio Chat. Om offline werking zelf te verifiëren, verbreek je de netwerktoegang nadat het model en de runtime volledig zijn gedownload en herhaal je een eenvoudige prompt.
Er is een belangrijke grens: zoeken naar modellen, nieuwe modellen downloaden, runtimes downloaden en controleren op app-updates vereisen internettoegang. Als je later cloudmodellen, externe MCP-servers, webtools of andere netwerkintegraties toevoegt, kunnen die functies ook connectiviteit vereisen. Offline privacyclaims zijn van toepassing op de lokale workflow, niet op diensten die je achteraf bewust verbindt.
Stap 5: Optioneel—Gebruik DeepSeek via een lokale API
Als je wilt dat een andere Windows-applicatie, script, IDE-extensie of intern tool je lokale DeepSeek-model aanroept, kan LM Studio een lokale server draaien. De huidige ontwikkelaarsdocumentatie zegt dat je deze kunt starten vanaf de Developer-pagina of met:
lms server start
Standaard is de server beschikbaar op http://localhost:1234. LM Studio biedt native REST-endpoints en OpenAI-compatibele endpoints. De server zelf kan offline werken zolang het model en de runtime al lokaal zijn. Als je de server echter buiten localhost blootstelt, controleer dan eerst de instellingen voor authenticatie en netwerktoegang.
Niet genoeg RAM/VRAM, te grote context, of niet-ondersteunde CPU/runtime
Probeer een kleiner DeepSeek-model, een kleinere kwantisatie, of een kortere contextlengte. Op x64 Windows, bevestig AVX2-ondersteuning.
LM Studio werkt online maar niet na verbreken van de verbinding
Het model of de vereiste runtime is niet volledig gedownload
Verbind één keer opnieuw, voltooi alle model/runtime-downloads, laad het model succesvol, en herhaal de offline test.
Generatie is zeer traag
Het model is te groot voor de beschikbare GPU-versnelling en leunt zwaar op CPU/systeemgeheugen
Kies een kleiner model of kwantisatie. Een groter model is niet nuttig als latentie de workflow onpraktisch maakt.
Je kunt geen model vinden terwijl je offline bent
Discover-zoeken vereist netwerktoegang
Download modellen voordat je offline gaat, of sideload een modelbestand dat via een ander gecontroleerd proces is verkregen.
Je verwachtte dat V4 Flash op een normale laptop zou draaien
De lokale geheugeneis is van workstationklasse
Gebruik in plaats daarvan een R1 distilled model, tenzij je machine ongeveer 156GB of meer systeemgeheugen heeft.
Wanneer deze setup goed past
DeepSeek offline uitvoeren met LM Studio is een sterke keuze als je privé lokale inferentie wilt, voorspelbare kosten na het downloaden van het model, experimenteren zonder API-sleutels, of een localhost-API voor ontwikkeling. Het is ook nuttig wanneer je machine zonder internettoegang moet blijven werken.
Het is een zwakkere keuze als je het sterkste beschikbare DeepSeek-model nodig hebt maar alleen consumentenhardware hebt, als je extreem hoge doorvoer nodig hebt, of als je workload afhangt van live webinformatie. Lokale modellen weten alleen wat in hun gewichten staat en de context die je verstrekt, tenzij je bewust externe tools of databronnen verbindt.
Snelle checklist
Gebruik een Windows 11-systeem dat voldoet aan de vereisten van LM Studio; x64 CPU's hebben AVX2 nodig.
Houd internettoegang aan voor de initiële downloads van LM Studio, runtime en modellen.
Begin met een kleiner DeepSeek GGUF-model, vooral een 8B-klasse distilled model.
Kies een 4-bit of hogere kwantisatie als je hardware dit kan ondersteunen.
Laad het model succesvol voordat je het netwerk verbreekt.
Schakel Wi-Fi/Ethernet uit en voer een nieuwe prompt uit om offline inferentie te verifiëren.
Verklein de modelgrootte of contextlengte als je geheugenfouten tegenkomt.
Gebruik de localhost-server van LM Studio alleen als je lokale API-toegang nodig hebt.
Conclusie
De eenvoudigste manier om DeepSeek offline uit te voeren op Windows 11 is door LM Studio te koppelen aan een kleiner GGUF DeepSeek-model dat daadwerkelijk past bij je hardware. Voor een normale pc is een R1 distilled 8B-klasse model een veel realistischer startpunt dan DeepSeek V4 Flash. Voltooi de downloads terwijl je online bent, laad het model, verbreek het netwerk, en verifieer dat een nieuwe chat nog steeds reageert. Zodra dat werkt, heb je een echt lokale DeepSeek-setup in plaats van een desktop-wrapper rond een cloud-API.