Home
» Domeinen
»
Hoe je een gratis AI-contenthergebruikpijplijn bouwt met n8n en Claude (Wat echt gratis is)
Hoe je een gratis AI-contenthergebruikpijplijn bouwt met n8n en Claude (Wat echt gratis is)
Je kunt de automatiseringslaag van een AI-contenthergebruikpijplijn gratis maken door n8n Community Edition zelf te hosten, maar een n8n-workflow aangedreven door Claude is niet gegarandeerd eind-tot-eind kosteloos. Dat onderscheid is belangrijk. n8n stelt dat de zelfgehoste Community Edition onbeperkt gratis kan worden gebruikt, terwijl de Claude API van Anthropic een betaalde ontwikkelaarsdienst is. Het gratis Claude-chatplan op de Claude-website is niet hetzelfde als API-gebruik binnen n8n.
Per 11 september 2026 documenteert n8n de Community Edition als een gratis zelfgehoste editie met bijna de volledige kernfunctieset. De huidige API-prijzen van Anthropic vermelden Claude Sonnet 5 tegen $2 per miljoen invoertokens en $10 per miljoen uitvoertokens, en Claude Haiku 4.5 tegen $1 per miljoen invoertokens en $5 per miljoen uitvoertokens. Prijzen en modellen kunnen veranderen, dus controleer ze voordat je implementeert. Zie de documentatie van n8n's Community Edition en de huidige prijslijst van Anthropic.
De praktische versie van “gratis” is dus: gratis n8n-software op infrastructuur die jij beheert, plus het Claude API-gebruik dat je workflow genereert. Als je al infrastructuur en API-credits hebt, kunnen je incrementele kosten tijdelijk nul zijn. Zo niet, reken dan op minstens modelgebruikskosten en mogelijk hostingkosten.
Wat deze pijplijn zal doen
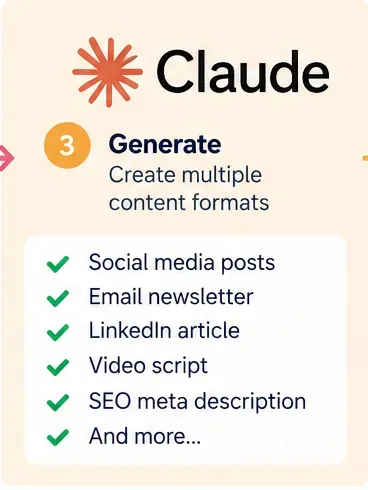
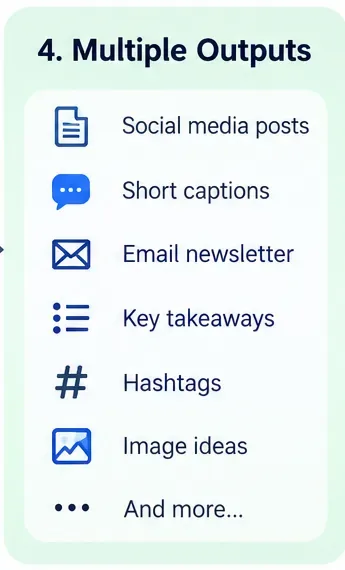
De onderstaande workflow neemt één bronitem—zoals een blogpost, nieuwsbriefconcept, podcasttranscript, webinartranscript of langdurige notitie—en zet dit om in meerdere gestructureerde conceptassets. Een nuttige startoutput is:
Eén LinkedIn-stijl post
Drie korte sociale posts
Eén e-mailonderwerpregel en introductie
Eén korte videohook en script
Vijf belangrijkste leerpunten
Een reviewvlag wanneer de bron niet voldoende informatie bevat
De pijplijn produceert bewust eerst concepten. Automatische publicatie kan later worden toegevoegd, maar het is meestal veiliger om contentkwaliteit, opmaak, brontrouw en bestemmingsrechten te bewijzen voordat je een AI-workflow zonder review laat publiceren.
Is deze aanpak geschikt voor jou?
Situatie
Aanbeveling
Waarom
Je hergebruikt je eigen artikelen of goedgekeurde bedrijfscontent
Geschikt
De bron is gecontroleerd en het transformatiedoel is voorspelbaar.
Je hebt consistente concepten nodig voor meerdere kanalen
Geschikt
n8n kan dezelfde transformatie herhaaldelijk orkestreren.
Je wilt een permanent kosteloze Claude API
Niet geschikt zoals gesteld
Claude API-gebruik is metered; het gratis Claude-chatplan maakt API-automatisering niet gratis.
Je hebt live feitelijke research nodig die aan elk concept wordt toegevoegd
Gebruik een aparte research/verificatiefase
Hergebruik mag niet stilzwijgend veranderen in feitgeneratie.
Je verwerkt niet-vertrouwde webpagina's of documenten van derden
Voeg sterkere inputisolatie en review toe
Externe content kan instructies bevatten die de workflow niet mogen sturen.
Je hebt complexe toolselectie en autonome beslissingen nodig
Overweeg een AI Agent
Een Basic LLM Chain is eenvoudiger wanneer de taak een voorspelbare teksttransformatie is.
De aanbevolen architectuur
Begin bij een eerste versie niet met een autonome agent. De Basic LLM Chain van n8n is ontworpen om een prompt naar een verbonden taalmodel te sturen en kan een outputparser koppelen. Dat is genoeg voor een deterministische “bron erin, opgemaakte concepten eruit” workflow. Zie de documentatie van n8n's Basic LLM Chain.
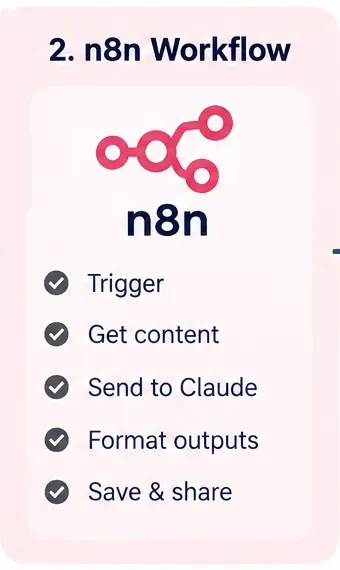
AI-gegenereerde illustratie van een n8n-workflowfase; dit is geen echte n8n-screenshot.
De huidige documentatie van n8n ondersteunt zelfhosting met Docker en beschrijft de Community Edition als gratis. Docker is een goed startpunt omdat het de n8n-instantie eenvoudig reproduceerbaar maakt en je een persistent volume geeft voor workflow- en credentialgegevens.
De officiële Docker-gids maakt een n8n_data volume aan, exposeert poort 5678, stelt tijdzone-gerelateerde omgevingsvariabelen in en mount de persistente datamap. Voor n8n 2.x merkt de documentatie op dat N8N_RUNNERS_ENABLED verouderd is en niet meer ingesteld hoeft te worden. Gebruik het huidige commando uit de Docker-installatiegids van n8n in plaats van een oud commando uit een tutorial te kopiëren.
Voor een lokale proof of concept is het openen van http://localhost:5678 voldoende. Voor een internetgerichte productie-instantie mag je de lokale poort niet zomaar publiek exposeren. Volg de hosting- en beveiligingsrichtlijnen van n8n voor HTTPS, authenticatie, back-ups en reverse-proxy-configuratie.
Gebruik deze stap als: je comfortabel bent met het onderhouden van je eigen Docker-host. Als je geen server wilt patchen, beveiligen, back-uppen en monitoren, is n8n Cloud eenvoudiger, maar dit is niet de permanent gratis optie die hier wordt beschreven.
Stap 2: Kies hoe de workflow start
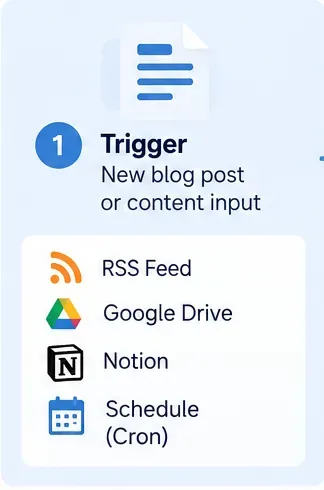
AI-gegenereerde illustratie van mogelijke workflowtriggers en contentbronnen; de daadwerkelijke beschikbaarheid en configuratie van n8n-nodes moet in je instantie worden gecontroleerd.
Gebruik een Webhook wanneer een andere app content on-demand naar n8n moet sturen. Gebruik een Schedule Trigger wanneer n8n op een vast tijdstip of interval content moet controleren.
De Webhook-node van n8n biedt aparte test- en productie-URL's. De test-URL is ontworpen voor ontwikkeling; de productie-URL wordt geregistreerd wanneer de workflow wordt gepubliceerd. De Webhook-node ondersteunt ook authenticatieopties, waaronder Basic auth, Header auth en JWT auth. Zie de Webhook-documentatie van n8n.
Voor gepland hergebruik draait de Schedule Trigger van n8n op vaste tijden of intervallen, en n8n stelt dat de workflow moet worden opgeslagen en gepubliceerd voor geplande triggering. Zie de Schedule Trigger-documentatie van n8n.
Voorbeeld: als je CMS een webhook kan aanroepen nadat een redacteur een artikel heeft goedgekeurd, gebruik dan de webhook. Als je goedgekeurde broncontent in een map bewaart en elke werkdagochtend een batch wilt, kan een schema eenvoudiger zijn.
Stap 3: Definieer één schoon inputcontract
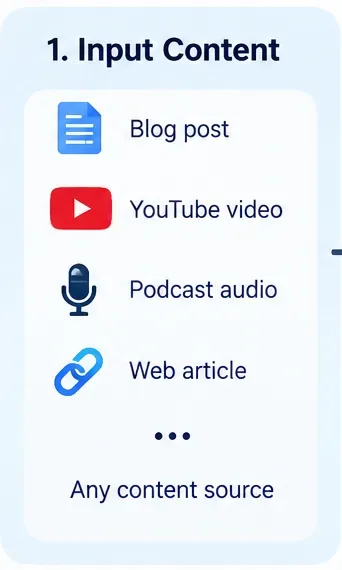
AI-gegenereerde illustratie van broncontenttypes die een hergebruikworkflow kunnen voeden; dit toont geen echt n8n-scherm.
Laat niet elke bron in een andere vorm binnenkomen. Normaliseer inputs naar één interne structuur voordat je Claude aanroept. Een praktische JSON-payload is:
Geef de daadwerkelijke brontekst door waar mogelijk. Een URL op zich is niet hetzelfde als geverifieerde broncontent. Het ophalen en parsen van een pagina voegt een ander faalpunt toe en kan navigatie, cookies, advertenties of ongerelateerde tekst in de prompt introduceren.
Houd instructies ook gescheiden van bronmateriaal. Als je pagina's, e-mails of geüploade documenten van derden verwerkt, behandel hun inhoud dan als niet-vertrouwde gegevens in plaats van workflowcommando's. De beveiligingsrichtlijnen van Anthropic beschrijven expliciet indirecte prompt-injectie als kwaadaardige instructies ingebed in content die het model leest. Zie de richtlijnen van Anthropic voor het mitigeren van prompt-injectie.
Stap 4: Valideer en normaliseer vóór de modelaanroep
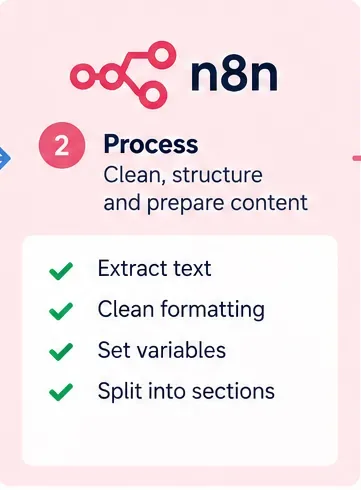
AI-gegenereerde illustratie van een voorverwerkingsfase; dit is geen echte n8n-workflow-screenshot.
Voordat je tokens uitgeeft, wijs je slechte input af. Controleer minimaal dat source_id, title en source_text bestaan en dat source_text niet leeg is. Normaliseer duidelijke opmaakruis, maar behoud feiten, citaten, URL's, koppen en andere brondetails die Claude mogelijk nodig heeft.
Een nuttige voorverwerkingsfase kan:
Leidende en afsluitende spaties verwijderen
Herhaalde lege regels omzetten naar een consistente opmaak
Standaarddoelgroep- en stemwaarden instellen
Brontekst onder een minimale nuttige lengte afwijzen
Een stabiele source_id aanmaken voor ontdubbelen
De gevraagde outputtypes registreren
Splits een normaal artikel niet in veel modelaanroepen tenzij je dat echt nodig hebt. Meerdere aanroepen verhogen de orkestratiecomplexiteit en kunnen inconsistente toon opleveren. Overweeg bij groot bronmateriaal bewust te samenvatten of in stukken te verdelen in plaats van input per ongeluk af te kappen.
Stap 5: Sluit Claude correct aan—en begrijp de kosten
AI-gegenereerde illustratie van de rol van Claude in de workflow; dit is geen Anthropic Console- of n8n-screenshot.
n8n biedt een Anthropic Chat Model-node en Anthropic-credentials die een API-sleutel gebruiken. De credential-documentatie van n8n verwijst gebruikers naar het aanmaken van een sleutel in de Anthropic Console en het opslaan ervan in de n8n-credential in plaats van het hard te coderen in workflowtekst. Zie de Anthropic credential-documentatie van n8n en de Anthropic Chat Model-documentatie van n8n.
Voor deze pijplijn verbind je het Anthropic Chat Model met een Basic LLM Chain. Een praktische modelkeuze hangt af van je kwaliteits- en kostendoel:
Modelkeuze
Wanneer het zinvol is
Huidige API-prijzen gecontroleerd op 11 sep. 2026
Claude Haiku 4.5
Hoogvolume, eenvoudigere herschrijvingen en eerste concepten
$1/MTok input; $5/MTok output
Claude Sonnet 5
Sterkere standaard voor genuanceerd multi-format hergebruik
$2/MTok input; $10/MTok output
Claude Opus 5
Alleen wanneer de taak echt diepere redenering nodig heeft
$5/MTok input; $25/MTok output
De bovenstaande prijzen komen van de huidige prijslijst van Anthropic en kunnen veranderen. Vermijd ook het kopiëren van oude model-ID's uit oudere tutorials. Anthropic onderhoudt een modeldeprecatiepagina omdat modellen periodiek worden gedeprecieerd en uitgefaseerd. Controleer de modeldeprecatiedocumentatie van Anthropic voordat je een modelnaam hard codeert.
Stap 6: Gebruik één prompt die brontrouw behoudt
AI-gegenereerde illustratie van multi-format contentgeneratie; de genoemde outputs zijn voorbeelden, geen gegarandeerde productfuncties.
De prompt moet de transformatiegrens expliciet maken: Claude mag de bron herformuleren en comprimeren, maar mag geen feiten verzinnen die niet aanwezig zijn. De huidige promptbegeleiding van Anthropic beveelt duidelijke instructies en gestructureerde tags aan voor complexe inputs. Zie de best practices-documentatie voor prompten van Anthropic.
Een praktisch systeembericht is:
You are a content repurposing editor.
Use only factual claims supported by the supplied source.
Do not invent statistics, quotes, customer results, dates, or product capabilities.
Preserve the original meaning while adapting format and tone.
If an output requires information not present in the source, set needs_review to true
and explain the missing information in review_notes.
Return the requested structured fields only.
Bouw vervolgens het gebruikersbericht op uit n8n-expressies:
Voorbeeld: als de bron zegt dat een product in mei is gelanceerd maar nooit klantenaantallen geeft, mag Claude het lanceerfeit omzetten in een kortere post, maar mag het niet “10.000 klanten” toevoegen om de post sterker te laten klinken.
Stap 7: Forceer gestructureerde output in plaats van proza te parsen
AI-gegenereerde illustratie van gestructureerde contentoutputs; dit is geen screenshot van het API-antwoord van Claude.
Vrije tekst is lastig te routeren. Als Claude koppen teruggeeft die van de ene uitvoering naar de andere veranderen, worden downstream-nodes breekbaar. De Structured Output Parser van n8n kan velden teruggeven op basis van een JSON Schema, en de Basic LLM Chain kan een specifiek outputformat afdwingen. Zie de Structured Output Parser-documentatie van n8n.
Als je ervoor kiest om de Claude Messages API rechtstreeks aan te roepen met de HTTP Request-node van n8n in plaats van de Anthropic Chat Model-integratie te gebruiken, ondersteunt Anthropic ook native gestructureerde outputs via output_config.format op ondersteunde modellen. Zie de Structured Outputs-documentatie van Anthropic en de Claude Messages API-referentie.
Stap 8: Sla concepten op, review ze en automatiseer publicatie
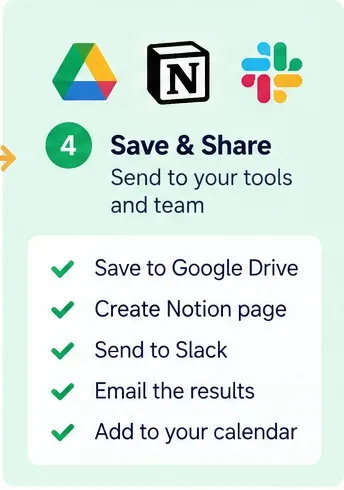
AI-gegenereerde illustratie van conceptbestemmingen; dit is geen screenshot van een live-integratie of bewijs dat een account is verbonden.
Bewaar voor de eerste productieversie de gegenereerde velden op een reviewlocatie in plaats van ze direct naar publieke kanalen te sturen. Veelvoorkomende bestemmingen zijn een database, Google Drive, Google Sheets, Notion, een CMS-concept of een interne reviewbericht.
Gebruik needs_review als een harde poort. Overweeg ook een menselijke reviewstap voor alles dat een extern bericht verzendt of een productiesysteem wijzigt. n8n ondersteunt momenteel human-in-the-loop goedkeuring voor AI-toolcalls, waarbij een reviewer geselecteerde acties kan goedkeuren of weigeren. Zie de human-in-the-loop-documentatie van n8n.
Aanbevolen uitrol:
Week 1: genereer alleen concepten.
Week 2: vergelijk outputs met de bron en los prompt/schema-fouten op.
Week 3: sta toe dat goedgekeurde concepten automatisch naar conceptmappen van bestemmingen verhuizen.
Pas nadat de workflow stabiel is: overweeg automatische publicatie voor risicovrije formaten.
Een concrete end-to-end n8n workflow
Voor een eenvoudige webhook-gestuurde versie maak je deze nodes in volgorde:
#
Node
Doel
1
Webhook
Ontvang het goedgekeurde bronitem.
2
Edit Fields / Code
Normaliseer veldnamen en standaardwaarden.
3
If
Wijs ontbrekende of lege brontekst af.
4
Basic LLM Chain
Bewaar de hergebruikinstructies en dynamische broncontent.
5
Anthropic Chat Model
Genereer de hergebruikte concepten.
6
Structured Output Parser
Forceer stabiele JSON-velden.
7
If
Routeer needs_review=true naar handmatige review.
8
Destination node
Sla goedgekeurde output op als concepten.
9
Respond to Webhook
Geef status en gegenereerd record-ID terug aan de aanroeper.
Als je een geplande pijplijn verkiest, vervang dan de Webhook door een Schedule Trigger en voeg een bronnode toe die goedgekeurde, onbewerkte items ophaalt.
Hoe je voorkomt dat dezelfde bron twee keer wordt hergebruikt
Voeg een onveranderlijke source_id toe aan elk item en bewaar verwerkte ID's. Controleer voordat Claude draait of die ID al succesvol is voltooid. Dit is basis-idempotentie: het herhalen van dezelfde trigger mag geen dubbele concepten aanmaken tenzij je expliciet om een nieuwe versie vraagt.
Gebruik voor revisies een samengestelde sleutel zoals source_id + source_revision. Dat stelt versie 2 van een artikel in staat nieuwe concepten te genereren zonder voor te doen dat het dezelfde bron is als versie 1.
Hoe je Claude API-kosten verlaagt
Modelkeuze is slechts één hefboom. De grootste vermijdbare kosten zijn vaak het verzenden van onnodige tekst of het genereren van onnodig lange outputs.
Verwijder navigatie, boilerplate en ongerelateerde HTML vóór de modelaanroep.
Vraag alleen om formaten die je echt nodig hebt.
Stel redelijke outputlengtebeperkingen in de prompt in.
Gebruik Haiku 4.5 voor eenvoudige hoogvolume transformaties wanneer de kwaliteit voldoende is.
Gebruik Sonnet 5 wanneer de bron meer nuance of sterkere cross-format aanpassing vereist.
Stuur niet bij elke aanroep dezelfde lange merkrichtlijn als je deze kunt vertegenwoordigen met beknopte stabiele instructies.
Meet tokengebruik en kosten in plaats van aan te nemen dat een korte workflow goedkoop is.
Anthropic biedt ook prompt caching en batchverwerking voor toepasselijke workloads, maar die functies hebben hun eigen vereisten en prijzen. Voeg ze niet toe aan de eerste workflow tenzij herhaalde context of niet-urgent hoogvolume verwerking de extra complexiteit rechtvaardigt.
Drie faalmodi om te testen vóór publicatie
1. Gehallucineerde feiten
Voer de workflow een bron in die bewust een statistiek weglaat. Het verwachte gedrag is dat de output er geen verzint. Als dat wel gebeurt, versterk dan de brontrouw-instructies en de reviewpoort.
2. Gebroken gestructureerde output
Test elk verplicht veld, lege arrays, ongebruikelijk lange brontekst en speciale tekens. Een pijplijn is niet betrouwbaar alleen omdat één aantrekkelijke demo-output correct leek.
3. Dubbele uitvoeringen
Stuur dezelfde source_id twee keer. De tweede run moet stoppen, het bestaande record bijwerken of intentioneel een revisie aanmaken volgens je ontwerp—niet stilzwijgend elk concept dupliceren.
Heb je een AI Agent hiervoor nodig?
Meestal niet. Een AI Agent is nuttig wanneer het model moet beslissen welke tools het moet aanroepen of verschillende acties moet ondernemen op basis van een open-ended doel. Contenthergebruik is normaal gesproken een voorspelbare transformatie, dus een chain is eenvoudiger te inspecteren, testen en besturen.
Ga pas over naar een agent wanneer je een concrete behoefte hebt, zoals dynamisch kiezen van researchtools, beslissen welke bestemming een concept ontvangt, of een mens vragen om ontbrekende informatie. Houd zelfs dan onomkeerbare publicatieacties achter expliciete review totdat de workflow goed is getest.
Definitieve bouwchecklist
Host n8n Community Edition zelf als je de n8n-softwarelaag gratis wilt houden.
Beschrijf Claude API-gebruik niet als permanent gratis.
Gebruik een Webhook voor on-demand verwerking of Schedule Trigger voor getimede batches.
Normaliseer elke bron naar één inputcontract.
Geef brontekst door, niet alleen een URL.
Bewaar de Anthropic API-sleutel in n8n-credentials.
Gebruik een actief Claude-model en controleer periodiek de deprecatiepagina.
Gebruik een Basic LLM Chain voor voorspelbaar hergebruik.
Vereis een gestructureerd outputschema.
Voeg needs_review en reviewnotities toe aan het schema.
Ontdubbel met een stabiele bron-ID.
Sla concepten op voordat je automatische publicatie inschakelt.
Test hallucinaties, misvormde inputs, dubbele triggers en faalpaden.
Monitor tokengebruik en kosten van externe diensten.
De beste eerste versie is bewust saai: één schone input, één gecontroleerde Claude-aanroep, één gevalideerd JSON-antwoord en één conceptbestemming. Die architectuur is eenvoudig te debuggen en goedkoop te exploiteren. Zodra het betrouwbaar werkt op echte bronmateriaal, kun je meer kanalen, planning, menselijke goedkeuringen, analytics of publicatie-integraties toevoegen zonder de kernpijplijn opnieuw op te bouwen.