Een goede Ollama-Obsidian-opstelling is niet slechts een opstelling waarbij een chatvenster tekst retourneert. Voor persoonlijk kennisbeheer is de betere test of het systeem de notities kan gebruiken die je bedoelde, jouw controle over de vault behoudt, reageert met een aanvaardbare snelheid, en toegeeft wanneer je notities het antwoord niet bevatten. Als aan deze voorwaarden niet is voldaan, is het wijzigen van het model, de retrieval-setup of de pluginconfiguratie nuttiger dan het herhaaldelijk bijsturen van prompts.
Per september 2026 wordt de lokale API van Ollama nog steeds standaard bediend op http://localhost:11434, met API-routes onder /api, en lokale toegang vereist geen authenticatie. Ollama biedt ook embeddings voor semantisch zoeken en retrieval-augmented generation (RAG), wat het deel is dat het beantwoorden van vragen over de hele vault wezenlijk anders maakt dan gewone chat. Zie de officiële Ollama API-introductie, documentatie over lokale authenticatie, en documentatie over embeddings.
Deze gids gebruikt Copilot for Obsidian als voorbeeld community-plugin omdat het project momenteel lokale Ollama-modellen en vault-gerichte workflows ondersteunt. De exacte formulering van instellingen kan veranderen tussen plugin-releases, dus gebruik de huidige Copilot for Obsidian-repository en de bijbehorende gids voor lokale modelinstallatie als een label in je installatie afwijkt van de onderstaande screenshots of stappen.
Wat moet een succesvolle lokale PKM-opstelling daadwerkelijk bereiken?
Voordat je iets installeert, definieer je het resultaat dat je wilt. Een nuttige lokale opstelling moet vier praktische tests doorstaan:
- Verbinding: Obsidian kan een model bereiken dat Ollama daadwerkelijk op je machine bedient.
- Verankering: wanneer je vraagt over een notitie of je vault, weerspiegelt het antwoord de relevante notitie-inhoud in plaats van alleen te vertrouwen op de algemene training van het model.
- Prestaties: reactietijd en geheugengebruik zijn acceptabel genoeg dat je de workflow realistisch zult gebruiken.
- Controle: je weet welke plugin notities kan lezen of wijzigen, welk model-endpoint deze gebruikt, en of optionele web- of cloudfuncties zijn ingeschakeld.
Deze criteria zijn belangrijk omdat "lokaal model verbonden" en "goed persoonlijk kennisbeheer" niet hetzelfde zijn. Chat kan perfect werken terwijl vault-retrieval zwak is, en een sterk model kan nog steeds slechte antwoorden produceren als de verkeerde notities worden opgehaald.
Stap 1: Installeer Ollama, haal een model op en verifieer de lokale API
Installeer Ollama met behulp van de officiële instructies voor je besturingssysteem. Ollama ondersteunt momenteel macOS, Windows en Linux; de officiële quickstart is het veiligste startpunt omdat installatie- en modelaanbevelingen in de loop van de tijd veranderen.
Haal een chatmodel op voordat je Obsidian opent. Bijvoorbeeld:
ollama pull gemma3
ollama ls
Je hoeft niet gemma3 te gebruiken. Het belangrijke deel is dat de modelnaam die je later in Obsidian invoert, moet overeenkomen met een model dat Ollama lokaal kan weergeven. Begin met een model dat je computer comfortabel kan uitvoeren, in plaats van automatisch het grootste beschikbare model te kiezen.
Verifieer vervolgens de API onafhankelijk van Obsidian:
curl http://localhost:11434/api/tags
Als die opdracht een JSON-lijst retourneert die je model bevat, werkt de basis Ollama-service. Je kunt ook ollama ps uitvoeren terwijl een model actief is. Ollama documenteert deze opdracht als een manier om te zien of een model in CPU-geheugen, GPU-geheugen of een combinatie van beide is geladen. Als reacties pijnlijk traag zijn of de machine reageert niet meer, is dat een signaal om over te schakelen naar een kleiner model of contextvereisten te verminderen, in plaats van aan te nemen dat Obsidian het probleem is.
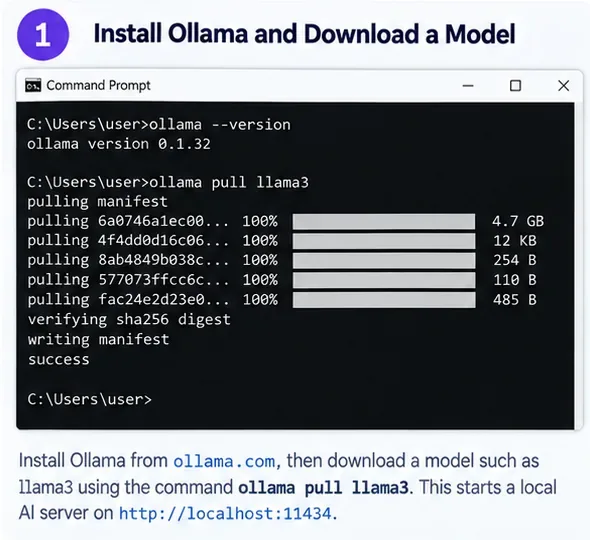
AI-gegenereerde illustratie van de Ollama-installatie en het ophalen van het model. Versienummers en details over modeldownloads die in de afbeelding worden getoond, zijn illustratief en geen actuele release-record.
Stap 2: Installeer de Obsidian-plugin en verbind het chatmodel met Ollama
Obsidian beschouwt community-plugins als code van derden. De officiële documentatie waarschuwt dat deze plugins code namens jou uitvoeren, dus bekijk de pluginbron en machtigingen als je vault gevoelige materialen bevat. Om er een te installeren, open je Instellingen → Community plugins, schakel je community-plugins in indien nodig, kies je Bladeren, en installeer en activeer je de plugin. Het exacte proces is gedocumenteerd op de officiële Obsidian Community plugins-hulppagina.
Installeer voor deze gids Copilot vanuit de community-directory en bevestig dat de plugin verwijst naar het geverifieerde Copilot for Obsidian-project dat hierboven is gelinkt. Vermijd het kiezen van een vergelijkbaar genoemde plugin alleen omdat deze als eerste verschijnt in zoekresultaten.
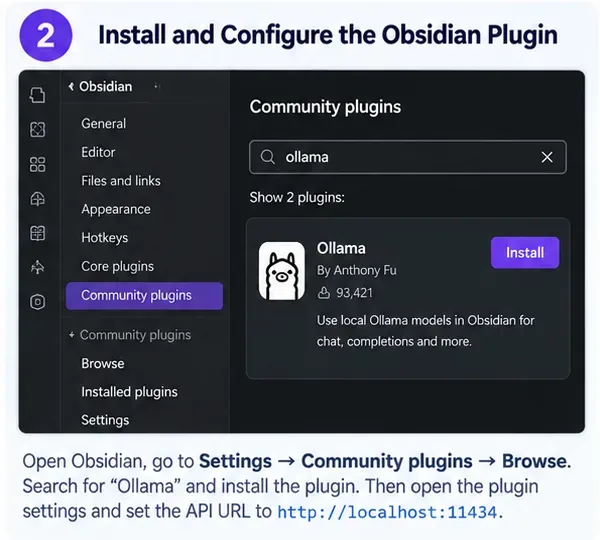
AI-gegenereerde conceptuele illustratie van de Community plugins-browser. De pluginkaart, auteursnaam en downloadaantallen die worden getoond, zijn illustratief en moeten niet worden behandeld als geverifieerde directorygegevens; gebruik het geverifieerde Copilot-project dat in dit artikel is gelinkt.
Open de instellingen van Copilot en zoek naar het configuratiegebied voor modellen, momenteel georganiseerd onder de Models-instellingen. Voeg een aangepast chatmodel toe met deze waarden:
- Provider: Ollama.
- Model: de exacte lokale modelnaam zoals gerapporteerd door
ollama ls.
- Base URL:
http://localhost:11434.
- API-sleutel: Ollama zelf vereist geen sleutel voor localhost-toegang. Als een pluginveld een placeholder vereist, volg dan de huidige instructies van die plugin in plaats van een cloud-sleutel te verzinnen.
Er is een eenvoudige URL-fout die je kunt vermijden. Wanneer je Ollama handmatig test, zien API-endpoints eruit als http://localhost:11434/api/chat. De native Ollama-provider van Copilot verwacht echter het basisserveradres en construeert het endpoint intern, dus gebruik http://localhost:11434 tenzij de huidige plugin specifiek om een volledig endpoint vraagt. Voeg ook geen /v1 toe bij gebruik van de native Ollama-provider. De aparte OpenAI-compatibele API van Ollama gebruikt /v1, maar dat is een ander integratiepad.
Stap 3: Test notitie-niveau verankering voordat je je hele vault indexeert
Begin niet met het indexeren van duizenden notities. Bewijs eerst dat de basis chatverbinding werkt met een kleine, gecontroleerde test. Maak een tijdelijke notitie met drie feiten die eenvoudig te verifiëren zijn, zoals een projectnaam, een deadline en een beslissing. Voeg die notitie vervolgens toe aan of vermeld die notitie in Copilot en vraag het model om alleen samen te vatten wat de notitie zegt.
Een goed resultaat zou die feiten nauwkeurig moeten reproduceren, onondersteunde claims moeten vermijden en binnen de gevraagde scope moeten blijven. Een slecht resultaat zou kunnen antwoorden vanuit algemene kennis terwijl de notitie wordt genegeerd, details verzinnen of een belangrijk feit weglaten dat duidelijk aanwezig is.
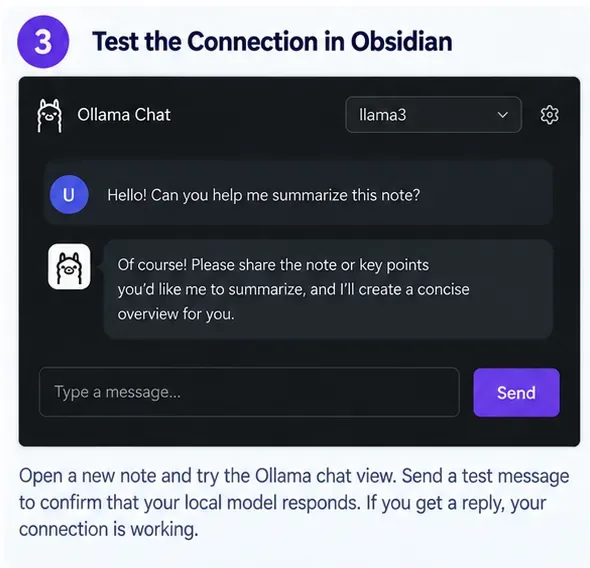
AI-gegenereerde conceptuele illustratie van een lokale chat-test in Obsidian. Het demonstreert het soort resultaat dat je moet controleren, geen echte screenshot van een specifieke plugin-release.
Als er geen reactie is, los je problemen op van onder naar boven. Voer eerst opnieuw curl http://localhost:11434/api/tags uit. Als dat faalt, is het probleem Ollama, niet Obsidian. Als de API werkt maar Copilot niet, controleer dan opnieuw de modelnaam en base URL. Pas na die controles moet je een origin/CORS-probleem onderzoeken. Huidige Copilot-code bevat een aanvraagpad dat bedoeld is om lokale Ollama-toegang te verwerken, terwijl de lokale installatiegids ook OLLAMA_ORIGINS documenteert voor configuraties die directe toegang vanaf Obsidian-origin vereisen. Gebruik de methode die gedocumenteerd is voor je geïnstalleerde Copilot-versie in plaats van automatisch oude workarounds voor omgevingsvariabelen toe te passen.
Stap 4: Voeg vault-bewuste retrieval alleen toe als notitie-niveau chat slaagt
Voor persoonlijk kennisbeheer komt de grootste kwaliteitsverbetering vaak van retrieval in plaats van van overstappen naar een groter chatmodel. RAG betekent dat het systeem eerst stukken van je notities ophaalt die relevant lijken, en die stukken vervolgens als context aan het taalmodel geeft. Dit stelt een lokaal model in staat om vragen te beantwoorden over informatie waar het nooit op getraind is.
Om retrieval ook lokaal te maken, gebruik je een Ollama embedding-model. De huidige documentatie van Ollama beveelt modellen aan zoals embeddinggemma, qwen3-embedding en all-minilm. Bijvoorbeeld:
ollama pull embeddinggemma
Configureer dat model in de vault-search of QA embedding-instellingen van Copilot met behulp van de Ollama-provider, bouw of herbouw vervolgens de lokale index. Gebruik hetzelfde embedding-model voor indexeren en queryen; Ollama beveelt dit expliciet aan omdat vectoren die door verschillende modellen zijn geproduceerd, niet direct uitwisselbaar zijn.

AI-gegenereerde conceptuele illustratie van een Ollama-aangedreven notitieworkflow. De opdrachtnamen en menu-indeling zijn voorbeelden, geen bewering over de exacte UI van de huidige Copilot-release.
Zodra het indexeren klaar is, test je retrieval met vragen waarvan je de antwoorden al kent. Vraag om een feit dat in één notitie voorkomt, en vervolgens om een relatie die twee notities vereist. Vraag tenslotte om iets dat niet in de vault staat. Het beste resultaat is niet het meest vloeiende antwoord; het is het antwoord dat het juiste bewijs gebruikt en weigert ontbrekende feiten te verzinnen.
Hoe te beoordelen of het resultaat goed genoeg is
| Kwaliteitscontrole | Signaal voor slagen | Wanneer aanpak wijzigen |
|---|
| Lokale verbinding | /api/tags werkt en hetzelfde model reageert in Obsidian | Als curl faalt, repareer dan eerst Ollama; als alleen Obsidian faalt, inspecteer dan de plugin model/URL-instellingen |
| Notitie-verankering | Bekende feiten uit de toegevoegde notitie worden nauwkeurig gereproduceerd | Als chat de notitie negeert, repareer dan contextselectie voordat je modellen wijzigt |
| Vault-retrieval | Relevante notities worden consistent boven gehaald voor vragen met bekende antwoorden | Als retrieval zwak is, verbeter dan embeddings/indexering of beperk de geïndexeerde scope |
| Generatiekwaliteit | Het model scheidt ondersteunde feiten van onzekerheid | Als retrieval goed is maar antwoorden zwak, probeer dan een sterker chatmodel |
| Latentie | Je kunt interacteren zonder herhaalde lange vertragingen | Als Ollama voornamelijk CPU-gebonden of geheugenhongerig is, gebruik dan een kleiner model of minder context |
| Privacy | Het geconfigureerde endpoint is localhost en optionele cloud/webfuncties zijn uitgeschakeld | Als een remote endpoint of webtool actief is, is de workflow niet langer volledig lokaal |
Wanneer een groter model niet de juiste oplossing is
Als antwoorden fout zijn omdat het systeem de verkeerde notities ophaalt, kan het upgraden van het chatmodel de tekst verbeteren zonder het bewijs te repareren. Verbeter eerst retrieval. Omgekeerd, als de juiste passages worden opgehaald maar het model ze niet betrouwbaar kan synthetiseren, kan een beter chatmodel helpen.
Hardware stelt ook een praktisch plafond. Ollama merkt op dat modelbestanden aanzienlijke opslag kunnen verbruiken, en grotere contexten meer geheugen verbruiken. Gebruik ollama ps om te zien hoe het huidige model wordt geladen. Een workflow die technisch draait maar zo lang duurt dat je stopt met het gebruik ervan, is geen succesvol PKM-systeem.
Privacy- en veiligheidsbeperkingen van "lokale" Obsidian AI
De localhost API van Ollama zelf vereist geen authenticatie, wat handig is op één machine, maar betekent ook dat je poort 11434 niet nonchalant naar een netwerk moet blootstellen. Houd het lokaal gebonden tenzij je bewust een remote configuratie beveiligt.
Vergeet ook niet dat "Ollama is lokaal" niet automatisch betekent dat "de hele Obsidian-workflow offline is". Community-plugins kunnen cloud-provider integraties, websearch, telemetrie of agent-tools bevatten. Bekijk de huidige instellingen van de plugin en schakel functies uit die je niet wilt gebruiken. Als je doel strikte offline verwerking is, test dan met het netwerk losgekoppeld nadat alle modellen en plugins al zijn geïnstalleerd.
Definitieve zelfcontrole
Je opstelling is klaar voor dagelijks persoonlijk kennisbeheer wanneer al deze stellingen waar zijn: de API van Ollama reageert lokaal; Obsidian gebruikt het exacte lokale model dat je bedoelde; een gecontroleerde notitietest retourneert de juiste feiten; vault-retrieval vindt de juiste notities voor vragen met bekende antwoorden; onondersteunde vragen triggers geen zelfverzekerde verzinsels; en de prestaties zijn snel genoeg dat je de workflow daadwerkelijk zult gebruiken.
Als alleen de eerste twee stellingen waar zijn, heb je Ollama succesvol verbonden met Obsidian, maar heb je nog geen betrouwbare kennisbeheer-assistent. Behandel retrievalkwaliteit, modelgedrag en privacyconfiguratie als afzonderlijke delen van het systeem, en verander het deel dat daadwerkelijk faalt.









