Home
» Domeinen
»
Stap-voor-stap handleiding: Wekelijkse concurrentiebewaking automatiseren met AI-agents
Stap-voor-stap handleiding: Wekelijkse concurrentiebewaking automatiseren met AI-agents
Concurrentiebewaking faalt vaak om een eenvoudige reden: het onderzoek is verspreid over te veel tabbladen, te veel mensen en te veel definities van wat als een betekenisvolle verandering telt. De ene persoon controleert prijslijsten, een ander volgt release notes, weer iemand anders scant het branchenieuws, en tegen vrijdag heeft het team een stapel links maar geen betrouwbaar antwoord op de vraag die er echt toe doet: wat is er deze week veranderd, en doet het ertoe?
Een AI-agent kan dat handmatige werk verminderen, maar de agent is slechts één onderdeel van het systeem. Een betrouwbare wekelijkse workflow heeft ook een bronlijst, een bewijsformat, een baseline van de vorige week, een planner en een stap voor menselijke review nodig. Als je die onderdelen overslaat, kun je net zo efficiënt ruis automatiseren als inzicht.
Deze handleiding bouwt de workflow op van de makkelijkste beslissingen naar de meer technische keuzes. De concrete implementatie maakt gebruik van de huidige OpenAI Agents SDK en GitHub Actions, omdat hun officiële documentatie websearch, gestructureerde outputs, tracing en geplande workflows ondersteunt. De architectuur zelf is leveranciersneutraal: je kunt elk component vervangen als een andere agent-runtime of planner beter bij je stack past.
Wat moet een wekelijkse concurrentiebewakingsagent eigenlijk doen?
Op minimaal niveau moet het systeem vier vragen beantwoorden: wat is er veranderd, waar komt het bewijs vandaan, hoe verschilt de verandering van de laatst bekende staat, en moet een persoon zich er zorgen over maken? "AI-agent" betekent hier een op LLM gebaseerde workflow met instructies en tools die een reeks acties naar een doel kan uitvoeren. De huidige Agents SDK van OpenAI beschrijft agents op dezelfde algemene manier: een model geconfigureerd met instructies, tools en optionele runtime-gedrag zoals guardrails en gestructureerde outputs. Zie de officiële OpenAI Agents SDK-documentatie.
Ontwerp de eerste versie niet om "alles te bewaken". Begin met een kleine scope die je nog handmatig kunt auditen. Zodra je vertrouwen hebt in de pipeline, kun je deze verbreden.
Stap 1: Definieer de concurrenten, signalen en wekelijkse vragen
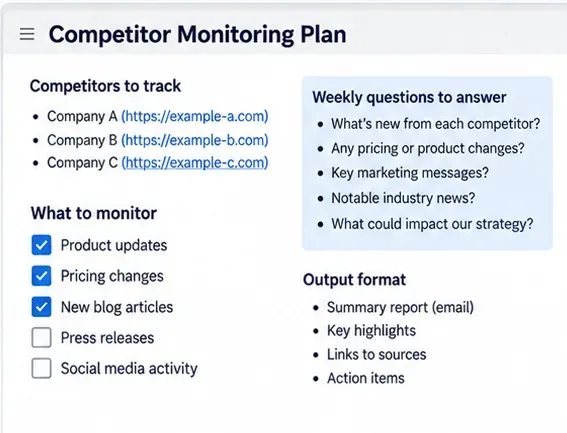
Maak een bewakingsbrief voordat je enige agentcode schrijft. Bepaal voor elke concurrent welke veranderingen het rapporteren waard zijn. Typische signalen zijn openbare prijswijzigingen, productlanceringen, release notes, nieuwe integraties, positioneringswijzigingen, belangrijke documentatie-updates, openbare partnerschappen, aankondigingen van leiderschap en grote aanwervingspatronen. De exacte lijst moet aansluiten bij de beslissingen die je team daadwerkelijk neemt.
Een nuttige brief scheidt signalen van vragen. "Prijslijst gewijzigd" is een signaal. "Maakt het nieuwe plan de concurrent aantrekkelijker voor kleine teams?" is een analytische vraag. De agent moet het eerste verzamelen en pas over het tweede redeneren nadat het bewijs heeft.
AI-gegenereerde conceptuele illustratie van een bewakingsbrief; geen screenshot van een echt product.
Schrijf voor een eerste wekelijkse run één zin die succes definieert. Bijvoorbeeld: "Tegen maandagochtend, produceer een bron-gelinkte samenvatting van materiële veranderingen uit de afgelopen zeven dagen voor vijf genoemde concurrenten, zonder onondersteunde claims." Die zin wordt later een praktische acceptatietest.
Stap 2: Bouw een bronregister in plaats van te vertrouwen op open-ended search
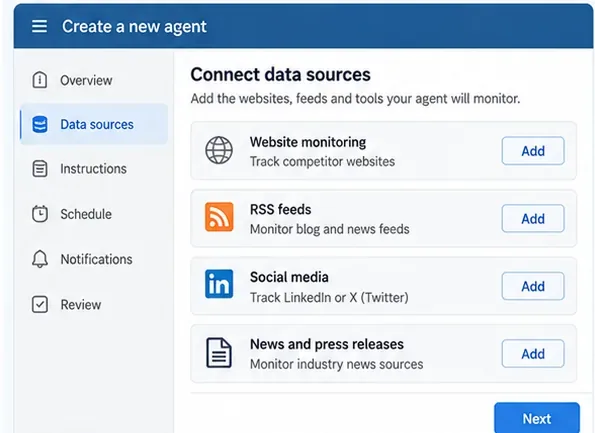
Websearch is nuttig voor ontdekking, maar een bewakingssysteem mag niet alleen afhankelijk zijn van zoekresultaten. Bouw een klein bronregister met velden zoals concurrent, brontype, URL, prioriteit, verwachte updatefrequentie en welke vraag de bron kan beantwoorden.
Signaal
Voorkeursbron
Waarom het nuttig is
Prijzen
Officiële prijs- en planningspagina's
Dichtstbijzijnde bron bij het huidige commerciële aanbod
Productwijzigingen
Release notes, changelog, productblog
Geeft meestal data en featurecontext
Positionering
Startpagina, productpagina's, campagnepagina's
Toont hoe het bedrijf het product presenteert
Bedrijfsnieuws
Perskamer en bedrijfsblog
Nuttig voor partnerschappen, financiering, leiderschap en lanceringen
Marktkontext
Reputabele openbare nieuwsbronnen
Voegt onafhankelijke context toe aan first-party claims
Geef de voorkeur aan openbare pagina's, officiële feeds, gedocumenteerde API's en bronnen waartoe je geautoriseerd bent. Ontwerp de agent niet om logins, paywalls, robots-beperkingen of toegangscontroles te omzeilen. Voor sociale platforms geef je de voorkeur aan officiële API's of openbare feeds waar beschikbaar, in plaats van breekbare scraping.
AI-gegenereerde conceptuele illustratie van een bronregister; gebruik alleen bronnen waartoe je toegang hebt.
De huidige Agents SDK van OpenAI bevat een gehoste WebSearchTool voor agents die OpenAI Responses-modellen gebruiken. De officiële tool-documentatie onderscheidt ook gehoste websearch van lokale functietools, wat nuttig is als je wilt dat de agent je eigen URL-fetcher, database, RSS-reader of veranderingdetectieservice aanroept. Zie de officiële Agents SDK tools-gids.
Stap 3: Definieer het bewisschema voordat je het model vraagt om samen te vatten
De makkelijkste manier om inconsistente wekelijkse rapporten te krijgen, is vragen om "een samenvatting van concurrentnieuws". Definieer in plaats daarvan een gestructureerde bevinding. Op minimaal niveau moet elke bevinding de concurrent, categorie, waarnemingsdatum, korte samenvatting, bron-URL, bewijsuittreksel of bronnotitie en een vertrouwens- of reviewvlag bevatten.
Voeg velden toe voor previous_state en current_state wanneer het signaal direct vergeleken kan worden, zoals een planprijs, featurebeschikbaarheid, kop of gedocumenteerde integratie. Dit maakt het rapport over verandering in plaats van over wat het model die week toevallig vond.
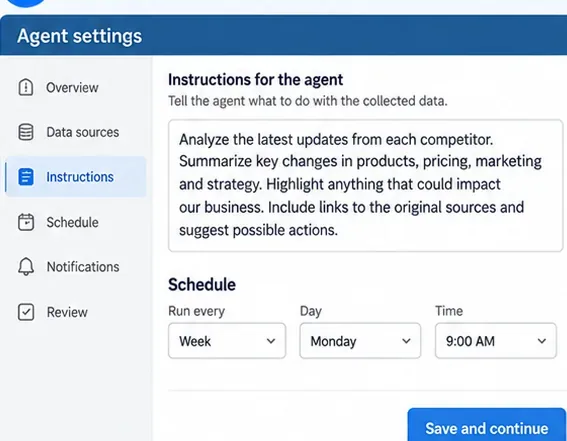
Gestructureerde output maakt de workflow ook makkelijker te testen. De Agents SDK ondersteunt momenteel een output_type op een agent, en de officiële documentatie beveelt normale Python-types aan zoals Pydantic-modellen of dataclasses voor gestructureerde resultaten. Zie de officiële agentconfiguratiegids.
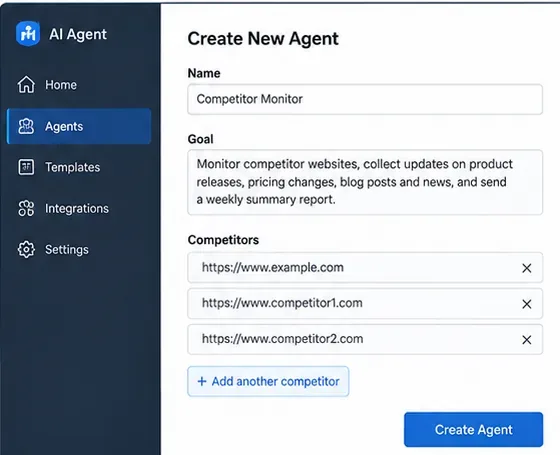
AI-gegenereerde conceptuele illustratie van agentinstructies en planning; geen echte productinterface.
Het laatste veld is belangrijk. Een goed bewakingssysteem moet in staat zijn "geen materiële verandering gevonden" te zeggen in plaats van een update te fabriceren om ruimte te vullen.
Stap 4: Voer een handmatige pilot uit voordat je iets automatiseert
Voer de workflow handmatig uit voor één rapportageperiode en vergelijk het resultaat met je eigen review van dezelfde bronnen. Deze pilot onthult problemen die moeilijker op te merken zijn na planning: verouderde zoekresultaten, dubbele verhalen, een onduidelijke categorietaxonomie, onondersteunde inferenties, ontbrekende bron-URL's en bevindingen die technisch nieuw zijn maar strategisch irrelevant.
Vraag bij elke voorgestelde bevinding: is de bron first-party of onafhankelijk reputabel, valt de verandering binnen het beoogde datumvenster, kan ik wijzen op het exacte bewijs, en zou hetzelfde item volgende week opnieuw gerapporteerd worden als er niets verandert? Als het antwoord op de laatste vraag ja is, heb je nog steeds een baseline of deduplicatieregel nodig.
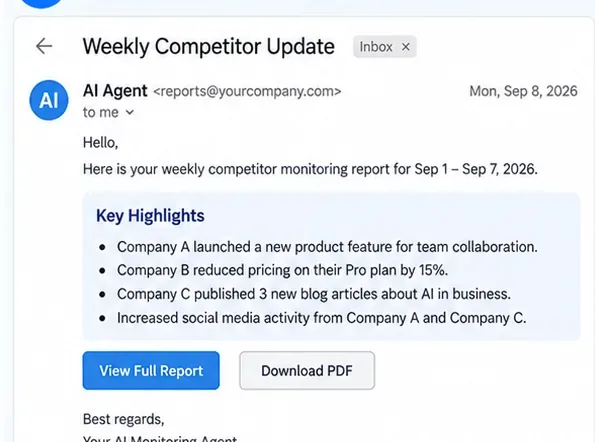
AI-gegenereerde conceptuele illustratie van een handmatige pilotrapport met bewijslinks.
Behandel zoeksnippets niet als het bewijsrecord. Sla de bron-URL op en, waar je voorwaarden en toegangsrechten dit toestaan, een genormaliseerde snapshot of geëxtraheerde tekst die voor vergelijking wordt gebruikt. Zoeken moet helpen bij het lokaliseren van bewijs; het mag geen vervanging voor bewijs worden.
Stap 5: Implementeer de agent met websearch, gestructureerde output en een baseline
Zodra de handmatige pilot nuttige bevindingen oplevert, sluit je de agent aan op code. Per september 2026 kan OpenAI's Python Agents SDK een Agent, gehoste WebSearchTool en gestructureerde output_type combineren. Het volgende voorbeeld is bewust klein: het demonstreert de agentlaag, niet de opslaglaag.
from pydantic import BaseModel
from agents import Agent, Runner, WebSearchTool

class Finding(BaseModel):
    competitor: str
    category: str
    summary: str
    source_url: str
    evidence: str
    observed_at: str
    needs_human_review: bool

class WeeklyReport(BaseModel):
    findings: list[Finding]
    executive_summary: str

agent = Agent(
    name="Weekly competitor monitor",
    instructions=(
        "Monitor only the competitors and topics in the input. "
        "Use public web sources. Every finding must include a source URL "
        "and evidence. Prefer first-party sources for product and pricing claims. "
        "Do not invent a change when no material change is supported."
    ),
    tools=[WebSearchTool()],
    output_type=WeeklyReport,
)

result = Runner.run_sync(
    agent,
    "Review the configured competitors for the reporting window and return the report."
)

report = result.final_output
De pakketinstallatie en runner-patronen zijn gedocumenteerd in de officiële Agents SDK quickstart. De SDK documenteert ook Runner.run_sync() als de synchrone wrapper rond de normale agentrun.
AI-gegenereerde conceptuele illustratie van een agentworkflow; implementatiedetails hangen af van je stack.
Voeg deterministische veranderingdetectie toe waar mogelijk
Vraag het model niet om elke oude staat opnieuw uit het geheugen te ontdekken. Bewaar een baseline. Sla voor elke bron de laatste succesvolle waarneming op: genormaliseerde tekst, een content hash, geselecteerde velden zoals prijs of plannaam, de waarnemingstimestamp en de bron-URL. Vergelijk bij de volgende run de nieuwe waarneming eerst met de baseline. Geef de agent vervolgens het verschil om te interpreteren.
Dit hybride ontwerp is betrouwbaarder dan "AI vergelijkt twee volledige websites" omdat deterministische code de exacte vergelijking afhandelt terwijl het model classificatie, relevantie en uitleg afhandelt. Als een pagina alleen zijn footer of trackingparameters verandert, kan je normalizer die ruis verwijderen voordat de agent het ziet.
Stap 6: Plan de workflow wekelijks en houd credentials uit code
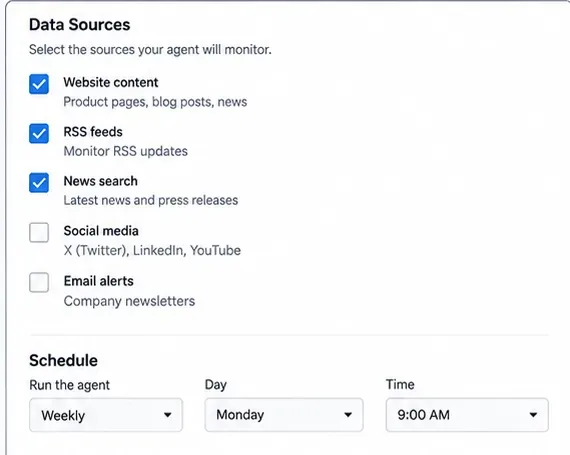
Je kunt de monitor draaien vanaf elke planner die bij je omgeving past. GitHub Actions is een praktische optie voor een repository-gebaseerde workflow. De huidige documentatie van GitHub zegt dat geplande workflows POSIX cron-syntax gebruiken, op de standaardtak draaien, standaard UTC zijn en optioneel een IANA-tijdzone kunnen specificeren. GitHub waarschuwt ook dat runs vertraagd kunnen worden tijdens periodes met hoge belasting, vooral rond het begin van het uur, dus een minuut zoals 17 is verkiesbaar boven 00 als exacte uitvoering op het hele uur niet nodig is. Zie de officiële GitHub Actions schedule-documentatie.
Sla API-sleutels op als versleutelde secrets in plaats van ze naar de repository te committen. De officiële secrets-gids van GitHub legt repository-, omgeving- en organisatie-secrets uit en beveelt aan om onbedoelde openbaarmaking in workflowlogs te vermijden.
AI-gegenereerde conceptuele illustratie van een planningslaag; het artikel gebruikt GitHub Actions als concreet voorbeeld.
Een operationeel detail is makkelijk te missen: GitHub zegt dat geplande workflows in openbare repositories automatisch worden uitgeschakeld na 60 dagen zonder repositoryactiviteit. Als deze workflow missiekritiek is, bewaak dan de monitor—registreer de laatste succesvolle runtijd en waarschuw wanneer de verwachte wekelijkse taak niet voltooid wordt.
Stap 7: Plaats een menselijke reviewpoort tussen "bevinding" en "beslissing"
Wekelijkse concurrentiebewaking is een lees-en-samenvat-workflow, dus het mag niet automatisch prijzen wijzigen, content publiceren of een productroadmap aanpassen. Een persoon moet materiële claims reviewen voordat ze een beslissing beïnvloeden. De review kan lichtgewicht zijn: goedkeuren, afwijzen, samenvoegen met een andere bevinding, of markeren als "volgende week in de gaten houden".
Vereis een sterkere review voor categorieën met hoge impact zoals prijzen, juridische claims, beveiligingsincidenten, ontslagen, overnames of verklaringen die afhankelijk zijn van third-party reporting. Voor product- en prijswijzigingen geef je de voorkeur aan de eigen pagina van de concurrent als primair bewijs, zelfs als een nieuwsartikel je hielp het te ontdekken.
AI-gegenereerde conceptuele illustratie van de menselijke reviewfase voordat bevindingen worden gedeeld of erop gehandeld wordt.
Als je implementatie later tools toevoegt die acties kunnen ondernemen, bevat de Agents SDK guardrails en human-in-the-loop goedkeuringsmechanismen. De officiële guardrails-documentatie beschrijft input-, output- en tool-guardrails, terwijl de human-in-the-loop gids uitlegt hoe gevoelige toolaanroepen gepauzeerd kunnen worden voor goedkeuring.
Stap 8: Volg trends, traceer fouten en controleer het systeem zelf
Een nuttig wekelijks rapport wordt waardevoller na meerdere runs omdat je geïsoleerde evenementen van patronen kunt onderscheiden. Sla elke goedgekeurde bevinding op in een eenvoudige tabel of database met concurrent, categorie, datum, bron en reviewstatus. Dan kun je vragen beantwoorden zoals welke concurrent prijzen het vaakst wijzigde, welke thema's terugkeren in release notes, of welke bewaakte bronnen geen nuttige signalen meer produceren.
AI-gegenereerde conceptuele illustratie van trendtracking en zelfcontrole over meerdere wekelijkse runs.
Voor de agent zelf, houd observability. OpenAI's Agents SDK bevat ingebouwde tracing die modelgeneraties, toolaanroepen, handoffs, guardrails en aangepaste evenementen registreert. De officiële tracing-gids beschrijft hoe traces en spans gebruikt kunnen worden om workflows te debuggen en monitoren. Wees bewust van gevoelige gegevens omdat trace-payloads model- en toolinputs/outputs kunnen bevatten afhankelijk van de configuratie.
Zelfcontrole voordat je het wekelijkse rapport vertrouwt
Elke materiële bevinding heeft een werkende bron-URL en een datum binnen het rapportagevenster.
First-party product- en prijsclaims worden waar mogelijk ondersteund door first-party bewijs.
Het systeem vergelijkt met de vorige bekende staat in plaats van simpelweg oud nieuws te herhalen.
"Geen materiële verandering" is een aanvaardbaar resultaat voor elke concurrent.
Dubbele verhalen van meerdere outlets worden samengevoegd in plaats van geteld als afzonderlijke veranderingen.
De geplande taak heeft een geregistreerde succes-timestamp, en gemiste runs zijn detecteerbaar.
API-sleutels en andere credentials worden opgeslagen als secrets en verschijnen niet in logs of rapporten.
Een persoon reviewt bevindingen met hoge impact voordat het team erop handelt.
Veelgemaakte fouten die AI-concurrentiebewaking onbetrouwbaar maken
Bewaken alleen via zoekopdrachten
Zoeken is uitstekend voor ontdekking maar instabiel als historische baseline. Houd expliciete bron-URLs aan en bewaar eerdere waarnemingen.
Het model vragen om "belangrijk nieuws" zonder schema
Belangrijkheid is subjectief. Definieer categorieën, bewijsvereisten en een reviewvlag zodat de output geaudit kan worden.
De agent laten samenvatten zonder data
Een resultaat kan relevant maar oud zijn. Neem altijd het rapportagevenster op en vereis een waarnemings- of publicatiedatum wanneer de bron die biedt.
Elk ontdekt item naar stakeholders sturen
Scheid verzameling van rapportage. De verzamellaag kan veel kandidaat-items vinden; het eindrapport moet alleen bewijs-ondersteunde, gededupliceerde veranderingen bevatten die aan je relevantieregels voldoen.
Acties te vroeg automatiseren
De veiligste eerste versie is read-only: verzamelen, vergelijken, samenvatten en review aanvragen. Voeg schrijfacties pas toe nadat je false positives kunt meten en faalmodi begrijpt.
Een eenvoudige architectuur die je kunt hergebruiken
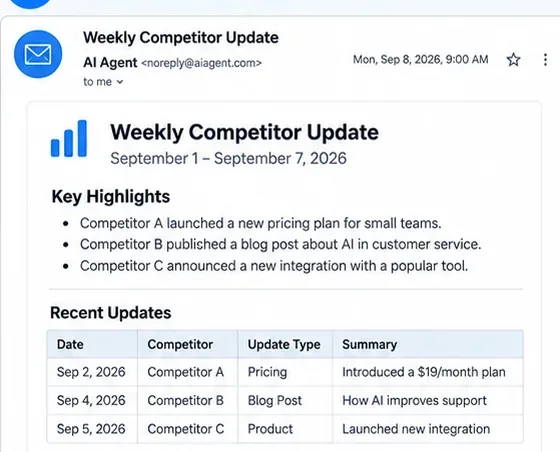
Het duurzame patroon is: bronregister → verzameling → normalisatie → baseline-vergelijking → agentanalyse → gestructureerde bevindingen → menselijke review → wekelijks rapport → trendopslag. De AI-agent is het sterkst in de interpretatiefasen, terwijl gewone code meestal beter is voor exacte planning, state-opslag, hashing, retries en deterministische vergelijkingen.
Als de workflow de zelfcontrole voor meerdere opeenvolgende runs doorstaat, kun je voorzichtig uitbreiden: voeg meer concurrenten toe, voeg gespecialiseerde agents toe voor prijs- of productwijzigingen, voeg een database toe, of routeer goedgekeurde rapporten naar e-mail, Slack of je interne kennisbank. Het doel is niet om de meest autonome agent te creëren. Het is om het kleinste herhaalbare systeem te creëren dat je team tijdige, bron-ondersteunde concurrentieveranderingen elke week geeft.