Uma boa configuração Ollama–Obsidian não é apenas aquela em que uma caixa de chat retorna texto. Para a gestão de conhecimento pessoal, o melhor teste é verificar se o sistema consegue usar as notas pretendidas, preservar seu controle sobre o cofre, responder em uma velocidade aceitável e admitir quando suas notas não contêm a resposta. Se essas condições não forem atendidas, mudar o modelo, a configuração de recuperação ou a configuração do plugin é mais útil do que ajustar prompts repetidamente.
Em setembro de 2026, a API local do Ollama ainda é servida por padrão em http://localhost:11434, com rotas de API sob /api, e o acesso local não requer autenticação. O Ollama também fornece embeddings para busca semântica e geração aumentada por recuperação (RAG), que é a parte que torna a resposta a perguntas em todo o cofre materialmente diferente do chat comum. Consulte a introdução oficial à API do Ollama, a documentação de autenticação local e a documentação de embeddings.
Este guia usa o Copilot for Obsidian como exemplo de plugin da comunidade porque seu projeto atualmente suporta modelos locais do Ollama e fluxos de trabalho orientados ao cofre. A redação exata das configurações pode mudar entre as versões do plugin, então use o repositório atual do Copilot for Obsidian e seu guia de configuração de modelo local se um rótulo em sua instalação diferir das capturas de tela ou etapas abaixo.
O que uma configuração local bem-sucedida de PKM deve realmente alcançar?
Antes de instalar qualquer coisa, defina o resultado desejado. Uma configuração local útil deve passar por quatro testes práticos:
- Conexão: O Obsidian consegue acessar um modelo que o Ollama está realmente servindo em sua máquina.
- Fundamentação: quando você pergunta sobre uma nota ou seu cofre, a resposta reflete o conteúdo relevante da nota em vez de depender apenas do treinamento geral do modelo.
- Desempenho: o tempo de resposta e o uso de memória são aceitáveis o suficiente para que você use o fluxo de trabalho na prática.
- Controle: você sabe qual plugin pode ler ou modificar notas, qual endpoint de modelo ele usa e se algum recurso opcional da web ou nuvem está habilitado.
Esses critérios importam porque "modelo local conectado" e "boa gestão de conhecimento pessoal" não são a mesma coisa. O chat pode funcionar perfeitamente enquanto a recuperação do cofre é fraca, e um modelo forte ainda pode produzir respostas ruins se as notas erradas forem recuperadas.
Etapa 1: Instale o Ollama, baixe um modelo e verifique a API local
Instale o Ollama usando as instruções oficiais para seu sistema operacional. O Ollama atualmente suporta macOS, Windows e Linux; o início rápido oficial é o ponto de partida mais seguro porque as recomendações de instalação e modelos mudam com o tempo.
Baixe um modelo de chat antes de abrir o Obsidian. Por exemplo:
ollama pull gemma3
ollama ls
Você não precisa usar o gemma3. A parte importante é que o nome do modelo que você inserir posteriormente no Obsidian deve corresponder a um modelo que o Ollama pode listar localmente. Comece com um modelo que seu computador possa executar confortavelmente, em vez de escolher automaticamente o maior modelo disponível.
Em seguida, verifique a API independentemente do Obsidian:
curl http://localhost:11434/api/tags
Se esse comando retornar uma lista JSON contendo seu modelo, o serviço básico do Ollama está funcionando. Você também pode executar ollama ps enquanto um modelo está ativo. O Ollama documenta este comando como uma forma de ver se um modelo está carregado na memória da CPU, memória da GPU ou uma mistura de ambas. Se as respostas forem dolorosamente lentas ou a máquina ficar sem resposta, isso é um sinal para mudar para um modelo menor ou reduzir os requisitos de contexto, em vez de assumir que o Obsidian é o problema.
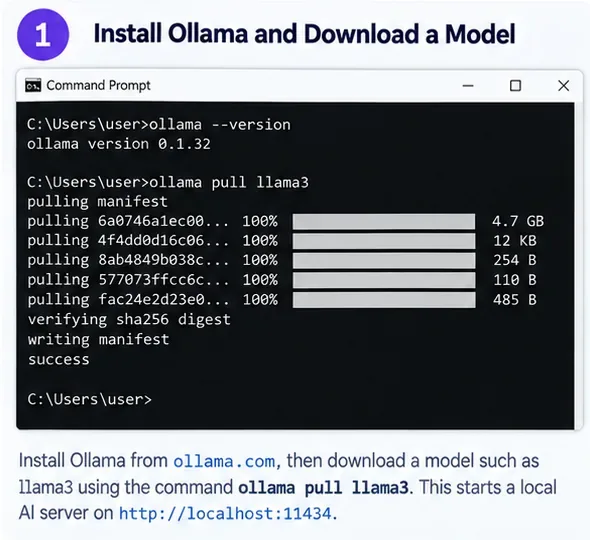
Ilustração gerada por IA da etapa de instalação do Ollama e download do modelo. Os números de versão e detalhes do download do modelo mostrados na imagem são ilustrativos, não um registro de lançamento atual.
Etapa 2: Instale o plugin do Obsidian e conecte seu modelo de chat ao Ollama
O Obsidian trata os plugins da comunidade como código de terceiros. Sua documentação oficial alerta que esses plugins executam código em seu nome, então revise o código-fonte e as permissões do plugin se seu cofre contiver material sensível. Para instalar um, abra Configurações → Plugins da comunidade, ative os plugins da comunidade se necessário, escolha Procurar, depois instale e habilite o plugin. O processo exato está documentado na página de ajuda oficial do Obsidian sobre Plugins da comunidade.
Para este guia, instale o Copilot do diretório da comunidade e confirme que o plugin aponta para o projeto verificado do Copilot for Obsidian vinculado acima. Evite escolher um plugin com nome semelhante apenas porque aparece primeiro nos resultados da busca.
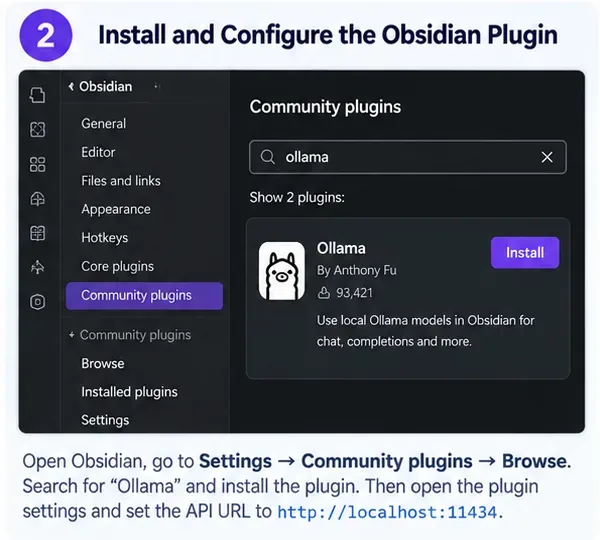
Ilustração conceitual gerada por IA do navegador de plugins da comunidade. O cartão do plugin, o nome do autor e a contagem de downloads mostrados são ilustrativos e não devem ser tratados como dados verificados do diretório; use o projeto Copilot verificado vinculado neste artigo.
Abra as configurações do Copilot e procure a área de configuração do modelo, atualmente organizada sob suas configurações de Modelos. Adicione um modelo de chat personalizado com estes valores:
- Provedor: Ollama.
- Modelo: o nome exato do modelo local reportado por
ollama ls.
- URL Base:
http://localhost:11434.
- Chave de API: O Ollama em si não requer uma para acesso localhost. Se um campo do plugin exigir um placeholder, siga as instruções atuais desse plugin em vez de inventar uma chave de nuvem.
Há um erro fácil de URL a evitar. Quando você testa o Ollama manualmente, os endpoints da API parecem com http://localhost:11434/api/chat. O provedor Ollama nativo do Copilot, no entanto, espera o endereço base do servidor e constrói o endpoint internamente, então use http://localhost:11434 a menos que o plugin atual solicite especificamente um endpoint completo. Da mesma forma, não adicione /v1 ao usar o provedor Ollama nativo. A API compatível com OpenAI separada do Ollama usa /v1, mas esse é um caminho de integração diferente.
Etapa 3: Teste a fundamentação em nível de nota antes de indexar todo o cofre
Não comece indexando milhares de notas. Primeiro, prove que a conexão básica de chat funciona com um teste pequeno e controlado. Crie uma nota temporária contendo três fatos fáceis de verificar, como um nome de projeto, um prazo e uma decisão. Em seguida, anexe ou mencione essa nota no Copilot e peça ao modelo para resumir apenas o que a nota diz.
Um bom resultado deve reproduzir esses fatos com precisão, evitar adicionar afirmações não suportadas e permanecer dentro do escopo solicitado. Um resultado ruim pode responder a partir do conhecimento geral ignorando a nota, inventar detalhes ou omitir um fato importante que está claramente presente.
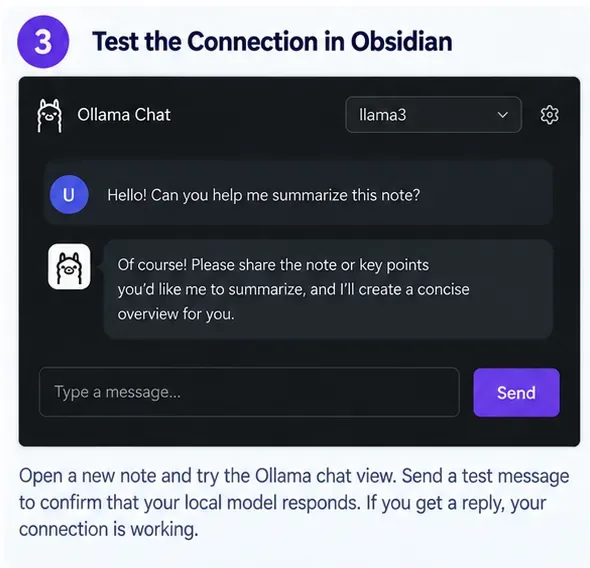
Ilustração conceitual gerada por IA de um teste de chat local no Obsidian. Ela demonstra o tipo de resultado a verificar, não uma captura de tela real de uma versão específica do plugin.
Se não houver resposta, faça a solução de problemas de baixo para cima. Primeiro, execute novamente curl http://localhost:11434/api/tags. Se isso falhar, o problema é o Ollama, não o Obsidian. Se a API funcionar, mas o Copilot não, verifique novamente o nome do modelo e a URL base. Somente após essas verificações você deve investigar um problema de origem/CORS. O código atual do Copilot inclui um caminho de solicitação destinado a lidar com o acesso local ao Ollama, enquanto seu guia de configuração local também documenta OLLAMA_ORIGINS para configurações que exigem acesso direto de origem do Obsidian. Use o método documentado para sua versão instalada do Copilot em vez de aplicar automaticamente soluções alternativas antigas de variáveis de ambiente.
Etapa 4: Adicione recuperação consciente do cofre apenas se o chat em nível de nota passar
Para a gestão de conhecimento pessoal, a maior melhoria de qualidade geralmente vem da recuperação, e não da mudança para um modelo de chat maior. RAG significa que o sistema primeiro recupera fragmentos de suas notas que parecem relevantes, depois fornece esses fragmentos ao modelo de linguagem como contexto. Isso permite que um modelo local responda a perguntas sobre informações nas quais nunca foi treinado.
Para tornar a recuperação local também, use um modelo de embedding do Ollama. A documentação atual do Ollama recomenda modelos como embeddinggemma, qwen3-embedding e all-minilm. Por exemplo:
ollama pull embeddinggemma
Configure esse modelo nas configurações de busca no cofre ou embeddings de QA do Copilot usando o provedor Ollama, depois construa ou reconstrua o índice local. Use o mesmo modelo de embedding para indexação e consulta; o Ollama recomenda explicitamente isso porque os vetores produzidos por modelos diferentes não são diretamente intercambiáveis.

Ilustração conceitual gerada por IA de um fluxo de trabalho de notas alimentado pelo Ollama. Os nomes dos comandos e o layout do menu são exemplos, não uma afirmação sobre a UI exata da versão atual do Copilot.
Depois que a indexação terminar, teste a recuperação com perguntas cujas respostas você já conhece. Peça um fato que aparece em uma nota, depois um relacionamento que requer duas notas. Finalmente, peça algo que não está no cofre. O melhor resultado não é a resposta mais fluente; é aquela que usa a evidência correta e se recusa a inventar fatos ausentes.
Como julgar se o resultado é bom o suficiente
| Verificação de qualidade | Sinal de aprovação | Quando mudar a abordagem |
|---|
| Conexão local | /api/tags funciona e o mesmo modelo responde no Obsidian | Se o curl falhar, corrija o Ollama primeiro; se apenas o Obsidian falhar, inspecione as configurações de modelo/URL do plugin |
| Fundamentação em nota | Fatos conhecidos da nota anexada são reproduzidos com precisão | Se o chat ignorar a nota, corrija a seleção de contexto antes de mudar de modelos |
| Recuperação do cofre | Notas relevantes são consistentemente apresentadas para perguntas com respostas conhecidas | Se a recuperação for fraca, melhore os embeddings/indexação ou reduza o escopo indexado |
| Qualidade da geração | O modelo separa fatos suportados da incerteza | Se a recuperação for boa, mas as respostas forem fracas, tente um modelo de chat mais forte |
| Latência | Você pode interagir sem longas pausas repetidas | Se o Ollama estiver principalmente limitado pela CPU ou com falta de memória, use um modelo menor ou menos contexto |
| Privacidade | O endpoint configurado é localhost e os recursos opcionais de nuvem/web estão desativados | Se um endpoint remoto ou ferramenta web estiver ativo, o fluxo de trabalho não é mais totalmente local |
Quando um modelo maior não é a solução certa
Se as respostas estiverem erradas porque o sistema recupera as notas erradas, atualizar o modelo de chat pode melhorar a prosa sem corrigir a evidência. Melhore a recuperação primeiro. Inversamente, se as passagens corretas forem recuperadas, mas o modelo não conseguir sintetizá-las de forma confiável, então um modelo de chat melhor pode ajudar.
O hardware também define um limite prático. O Ollama observa que os arquivos de modelo podem consumir armazenamento substancial, e contextos maiores consomem mais memória. Use ollama ps para ver como o modelo atual está sendo carregado. Um fluxo de trabalho que tecnicamente roda, mas leva tanto tempo que você para de usá-lo, não é um sistema PKM bem-sucedido.
Limites de privacidade e segurança da IA "local" do Obsidian
A própria API localhost do Ollama não requer autenticação, o que é conveniente em uma máquina, mas também significa que você não deve expor casualmente a porta 11434 a uma rede. Mantenha-a vinculada localmente, a menos que você proteja deliberadamente uma configuração remota.
Lembre-se também de que "Ollama é local" não significa automaticamente que "todo o fluxo de trabalho do Obsidian está offline". Os plugins da comunidade podem conter integrações de provedores de nuvem, busca na web, telemetria ou ferramentas de agentes. Revise as configurações atuais do plugin e desative os recursos que você não pretende usar. Se seu objetivo é o processamento estritamente offline, teste com a rede desconectada depois que todos os modelos e plugins já estiverem instalados.
Autoverificação final
Sua configuração está pronta para a gestão de conhecimento pessoal diária quando todas estas afirmações forem verdadeiras: a API do Ollama responde localmente; o Obsidian usa o modelo local exato que você pretendia; um teste controlado de nota retorna os fatos corretos; a recuperação do cofre encontra as notas certas para perguntas com respostas conhecidas; perguntas não suportadas não desencadeiam invenções confiantes; e o desempenho é rápido o suficiente para que você realmente use o fluxo de trabalho.
Se apenas as duas primeiras afirmações forem verdadeiras, você conectou com sucesso o Ollama ao Obsidian, mas ainda não tem um assistente confiável de gestão de conhecimento. Trate a qualidade da recuperação, o comportamento do modelo e a configuração de privacidade como partes separadas do sistema, e mude a parte que está realmente falhando.









