Início
» Domínios
»
Como criar um pipeline gratuito de reaproveitamento de conteúdo com IA usando n8n e Claude (o que é realmente gratuito)
Como criar um pipeline gratuito de reaproveitamento de conteúdo com IA usando n8n e Claude (o que é realmente gratuito)
Você pode tornar a camada de automação de um pipeline de reaproveitamento de conteúdo com IA gratuita auto-hospedando a Community Edition do n8n, mas um fluxo de trabalho do n8n alimentado pelo Claude não é garantido que seja de custo zero de ponta a ponta. Essa distinção é importante. O n8n afirma que sua Community Edition auto-hospedada pode ser usada gratuitamente indefinidamente, enquanto a API Claude da Anthropic é um serviço de desenvolvedor medido. O plano de chat Claude gratuito no site da Claude não é a mesma coisa que o uso da API dentro do n8n.
Em 11 de setembro de 2026, o n8n documenta a Community Edition como uma edição auto-hospedada gratuita com quase o conjunto completo de recursos principais. O preço atual da API da Anthropic lista o Claude Sonnet 5 a $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída, e o Claude Haiku 4.5 a $1 por milhão de tokens de entrada e $5 por milhão de tokens de saída. Os preços e modelos podem mudar, então verifique-os antes de implantar. Veja a documentação da Community Edition do n8n e a página de preços atual da Anthropic.
Portanto, a versão prática de “gratuito” é: software n8n gratuito em infraestrutura que você controla, mais qualquer uso da API Claude que seu fluxo de trabalho gerar. Se você já possui infraestrutura e créditos de API, seu custo incremental pode ser temporariamente zero. Caso contrário, espere pelo menos o custo de uso do modelo e possivelmente o custo de hospedagem.
O que este pipeline fará
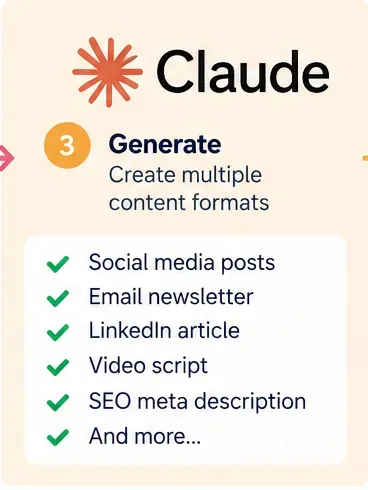
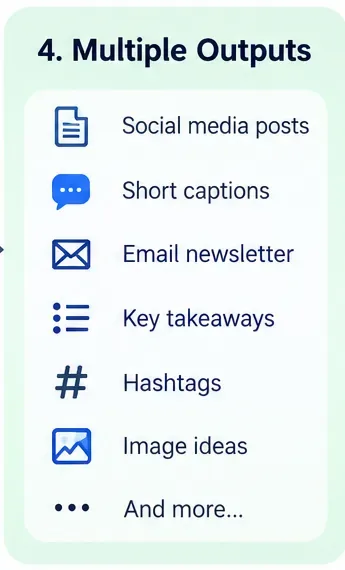
O fluxo de trabalho abaixo pega um item de origem—como um post de blog, rascunho de newsletter, transcrição de podcast, transcrição de webinar ou nota longa—e o transforma em vários ativos de rascunho estruturados. Uma saída inicial útil é:
Um post estilo LinkedIn
Três posts curtos para redes sociais
Uma linha de assunto de e-mail e introdução
Um gancho de vídeo curto e roteiro
Cinco pontos principais
Um sinalizador de revisão quando a origem não contém informações suficientes
O pipeline produz intencionalmente rascunhos primeiro. A publicação automática pode ser adicionada mais tarde, mas geralmente é mais seguro provar a qualidade do conteúdo, a formatação, a fidelidade à fonte e as permissões de destino antes de permitir que um fluxo de trabalho de IA publique sem revisão.
Esta abordagem é adequada para você?
Situação
Recomendação
Por quê
Você reaproveita seus próprios artigos ou conteúdo aprovado da empresa
Bom ajuste
A fonte é controlada e o objetivo de transformação é previsível.
Você precisa de rascunhos consistentes para vários canais
Bom ajuste
O n8n pode orquestrar a mesma transformação repetidamente.
Você deseja uma API Claude permanentemente de custo zero
Não é um ajuste como declarado
O uso da API Claude é medido; o plano de chat Claude gratuito não torna a automação da API gratuita.
Você precisa de pesquisa factual ao vivo adicionada a cada rascunho
Use um estágio separado de pesquisa/verificação
O reaproveitamento não deve silenciosamente se transformar em geração de fatos.
Você está processando páginas web não confiáveis ou documentos de terceiros
Adicione isolamento de entrada mais forte e revisão
O conteúdo externo pode conter instruções que não devem controlar o fluxo de trabalho.
Você precisa de seleção complexa de ferramentas e decisões autônomas
Considere um Agente de IA
Uma Cadeia LLM Básica é mais simples quando o trabalho é uma transformação de texto previsível.
A arquitetura recomendada
Para uma primeira versão, não comece com um agente autônomo. A Cadeia LLM Básica do n8n é projetada para passar um prompt para um modelo de linguagem conectado e pode anexar um analisador de saída. Isso é suficiente para um fluxo de trabalho determinístico “fonte entra, rascunhos formatados saem”. Veja a documentação da Cadeia LLM Básica do n8n.
Um pipeline limpo se parece com isto:
Gatilho → Validar entrada → Normalizar origem → Cadeia LLM Básica → Modelo de Chat Anthropic → Analisador de Saída Estruturada → Portão de revisão → Salvar rascunhos
Passo 1: Auto-hospede a Community Edition do n8n
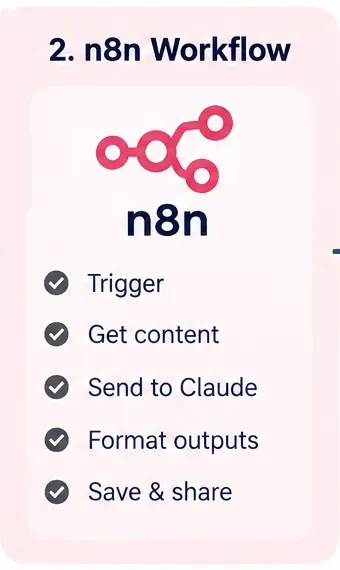
Ilustração gerada por IA de um estágio de fluxo de trabalho n8n; não é uma captura de tela real do n8n.
A documentação atual do n8n suporta a auto-hospedagem com Docker e descreve a Community Edition como gratuita. O Docker é um bom ponto de partida porque torna a instância do n8n fácil de reproduzir e fornece um volume persistente para dados de fluxo de trabalho e credenciais.
O guia oficial do Docker cria um volume n8n_data, expõe a porta 5678, define variáveis de ambiente relacionadas ao fuso horário e monta o diretório de dados persistente. Para o n8n 2.x, a documentação observa que N8N_RUNNERS_ENABLED está obsoleto e não precisa mais ser definido. Use o comando atual do guia de instalação do Docker do n8n em vez de copiar um comando antigo de um tutorial.
Para uma prova de conceito local, abrir http://localhost:5678 é suficiente. Para uma instância de produção voltada para a internet, não exponha simplesmente a porta local publicamente. Siga as orientações de hospedagem e segurança do n8n para HTTPS, autenticação, backups e configuração de proxy reverso.
Use esta etapa se: você estiver confortável mantendo seu próprio host Docker. Se você não quiser corrigir, proteger, fazer backup e monitorar um servidor, o n8n Cloud é mais fácil, mas não é a opção permanentemente gratuita descrita aqui.
Passo 2: Escolha como o fluxo de trabalho começa
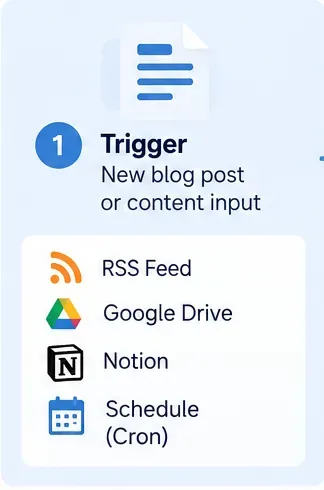
Ilustração gerada por IA de possíveis gatilhos de fluxo de trabalho e fontes de conteúdo; a disponibilidade e configuração reais dos nós do n8n devem ser verificadas em sua instância.
Use um Webhook quando outro aplicativo deve enviar conteúdo para o n8n sob demanda. Use um Gatilho de Agenda quando o n8n deve verificar conteúdo em um horário ou intervalo fixo.
O nó Webhook do n8n fornece URLs de teste e produção separadas. A URL de teste é projetada para desenvolvimento; a URL de produção é registrada quando o fluxo de trabalho é publicado. O nó Webhook também suporta opções de autenticação, incluindo autenticação básica, autenticação de cabeçalho e autenticação JWT. Veja a documentação do Webhook do n8n.
Para reaproveitamento agendado, o Gatilho de Agenda do n8n executa em horários ou intervalos fixos, e o n8n afirma que o fluxo de trabalho deve ser salvo e publicado para que o gatilho agendado funcione. Veja a documentação do Gatilho de Agenda do n8n.
Exemplo: se seu CMS pode chamar um webhook após um editor aprovar um artigo, use o webhook. Se você mantém conteúdo de origem aprovado em uma pasta e deseja um lote toda manhã de dia útil, uma agenda pode ser mais simples.
Passo 3: Defina um contrato de entrada limpo
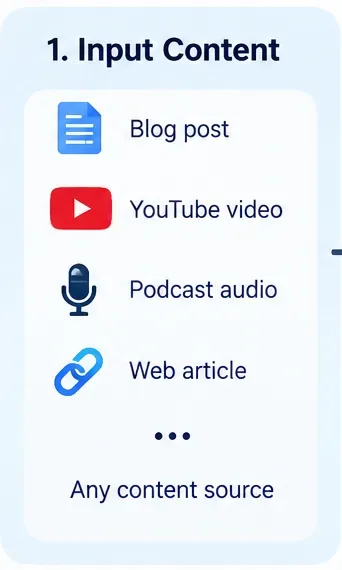
Ilustração gerada por IA de tipos de conteúdo de origem que podem alimentar um fluxo de trabalho de reaproveitamento; não retrata uma tela real do n8n.
Não deixe cada origem chegar em uma forma diferente. Normalize as entradas para uma estrutura interna antes de chamar o Claude. Um payload JSON prático é:
{
  "source_id": "post-2026-0911-001",
  "title": "Título do artigo original",
  "source_text": "Texto completo da origem aprovada...",
  "source_url": "https://example.com/original",
  "audience": "Proprietários de pequenas empresas nos EUA",
  "brand_voice": "claro, prático, sem exageros",
  "outputs": [
    "linkedin_post",
    "short_posts",
    "email_intro",
    "video_script"
  ]
}
Passe o texto real da origem sempre que prático. Uma URL por si só não é a mesma coisa que conteúdo de origem verificado. Buscar e analisar uma página adiciona outro ponto de falha e pode introduzir navegação, cookies, publicidade ou texto não relacionado no prompt.
Também mantenha as instruções separadas do material de origem. Se você ingerir páginas de terceiros, e-mails ou documentos enviados, trate seus conteúdos como dados não confiáveis, em vez de comandos de fluxo de trabalho. A orientação de segurança da Anthropic descreve explicitamente a injeção indireta de prompt como instruções maliciosas incorporadas no conteúdo que o modelo lê. Veja a orientação de mitigação de injeção de prompt da Anthropic.
Passo 4: Valide e normalize antes da chamada do modelo
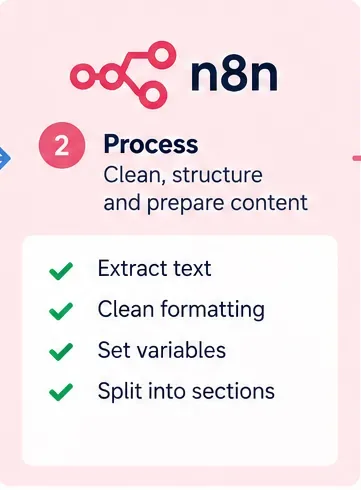
Ilustração gerada por IA de um estágio de pré-processamento; não é uma captura de tela real do fluxo de trabalho do n8n.
Antes de gastar tokens, rejeite entradas ruins. No mínimo, verifique se source_id, title e source_text existem e se source_text não está vazio. Normalize o ruído de formatação óbvio, mas preserve fatos, citações, URLs, cabeçalhos e outros detalhes da origem que o Claude pode precisar.
Um estágio de pré-processamento útil pode:
Remover espaços em branco à esquerda e à direita
Converter linhas em branco repetidas para um formato consistente
Definir valores padrão de público e voz
Rejeitar texto de origem abaixo de um comprimento mínimo útil
Criar um source_id estável para deduplicação
Registrar os tipos de saída solicitados
Não divida um artigo normal em muitas chamadas de modelo, a menos que você realmente precise. Múltiplas chamadas aumentam a complexidade da orquestração e podem produzir um tom inconsistente. Para material de origem grande, considere resumir ou dividir em blocos deliberadamente, em vez de truncar acidentalmente a entrada.
Passo 5: Conecte o Claude corretamente—e entenda o custo
Ilustração gerada por IA do papel do Claude no fluxo de trabalho; não é uma captura de tela do Console da Anthropic ou do n8n.
O n8n fornece um nó Modelo de Chat Anthropic e credenciais Anthropic que usam uma chave de API. A documentação de credenciais do n8n orienta os usuários a criar uma chave no Console da Anthropic e armazená-la na credencial do n8n, em vez de codificá-la no texto do fluxo de trabalho. Veja a documentação de credenciais Anthropic do n8n e a documentação do Modelo de Chat Anthropic do n8n.
Para este pipeline, conecte o Modelo de Chat Anthropic a uma Cadeia LLM Básica. Uma escolha prática de modelo depende de sua meta de qualidade e custo:
Escolha do modelo
Quando faz sentido
Preço atual da API verificado em 11 de setembro de 2026
Claude Haiku 4.5
Reescritas simples de alto volume e primeiros rascunhos
$1/MTok entrada; $5/MTok saída
Claude Sonnet 5
Padrão mais forte para reaproveitamento multiformato sutil
$2/MTok entrada; $10/MTok saída
Claude Opus 5
Apenas quando a tarefa genuinamente precisa de raciocínio mais profundo
$5/MTok entrada; $25/MTok saída
Os preços acima vêm da página de preços atual da Anthropic e podem mudar. Também evite copiar IDs de modelos antigos de tutoriais antigos. A Anthropic mantém uma página de descontinuação de modelos porque os modelos são periodicamente descontinuados e aposentados. Verifique a documentação de descontinuação de modelos da Anthropic antes de codificar um nome de modelo.
Passo 6: Use um prompt que preserve a fidelidade à origem
Ilustração gerada por IA de geração de conteúdo multiformato; as saídas listadas são exemplos, não recursos de produto garantidos.
O prompt deve tornar explícito o limite da transformação: o Claude pode reformular e comprimir a origem, mas não deve inventar fatos que não estão presentes. A orientação atual de prompting da Anthropic recomenda instruções claras e tags estruturadas para entradas complexas. Veja a documentação de melhores práticas de prompting da Anthropic.
Uma mensagem de sistema prática é:
Você é um editor de reaproveitamento de conteúdo.
Use apenas afirmações factuais suportadas pela origem fornecida.
Não invente estatísticas, citações, resultados de clientes, datas ou capacidades de produto.
Preserve o significado original ao adaptar formato e tom.
Se uma saída exigir informações não presentes na origem, defina needs_review como true
e explique as informações ausentes em review_notes.
Retorne apenas os campos estruturados solicitados.
Em seguida, construa a mensagem do usuário a partir das expressões do n8n:
Exemplo: se a origem diz que um produto foi lançado em maio, mas nunca fornece números de clientes, o Claude pode transformar o fato do lançamento em um post mais curto, mas não deve adicionar “10.000 clientes” para fazer o post soar mais forte.
Passo 7: Force saída estruturada em vez de analisar prosa
Ilustração gerada por IA de saídas de conteúdo estruturado; não é uma captura de tela da resposta da API do Claude.
Texto livre é difícil de rotear. Se o Claude retornar cabeçalhos que mudam de uma execução para a próxima, os nós a jusante tornam-se frágeis. O Analisador de Saída Estruturada do n8n pode retornar campos com base em um JSON Schema, e a Cadeia LLM Básica pode exigir um formato de saída específico. Veja a documentação do Analisador de Saída Estruturada do n8n.
Se você optar por chamar a API de Mensagens do Claude diretamente com o nó Requisição HTTP do n8n, em vez de usar a integração do Modelo de Chat Anthropic, a Anthropic também suporta saídas estruturadas nativas através de output_config.format em modelos suportados. Veja a documentação de Saídas Estruturadas da Anthropic e a referência da API de Mensagens do Claude.
Passo 8: Salve rascunhos, revise-os e depois automatize a publicação
Ilustração gerada por IA de destinos de rascunho; não é uma captura de tela de uma integração ao vivo ou prova de que qualquer conta está conectada.
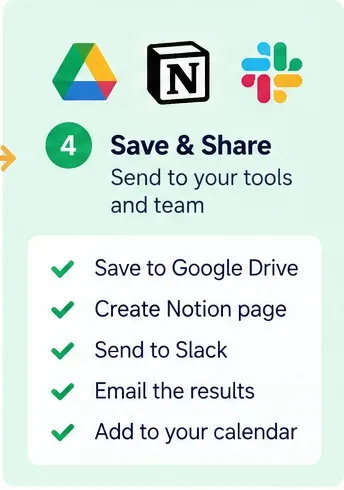
Para a primeira versão de produção, armazene os campos gerados em um local de revisão, em vez de enviá-los diretamente para canais públicos. Destinos comuns incluem um banco de dados, Google Drive, Google Sheets, Notion, um rascunho de CMS ou uma mensagem interna de revisão.
Use needs_review como um portão rígido. Considere também uma etapa de revisão humana para qualquer coisa que envie uma mensagem externa ou altere um sistema de produção. O n8n atualmente suporta aprovação humana no loop para chamadas de ferramentas de IA, onde um revisor pode aprovar ou negar ações selecionadas. Veja a documentação de humano no loop do n8n.
Implantação recomendada:
Semana 1: gere apenas rascunhos.
Semana 2: compare as saídas com a origem e corrija falhas de prompt/esquema.
Semana 3: permita que rascunhos aprovados se movam automaticamente para pastas de rascunho de destino.
Apenas após o fluxo de trabalho estar estável: considere a publicação automática para formatos de baixo risco.
Um fluxo de trabalho n8n concreto de ponta a ponta
Para uma versão simples orientada por webhook, crie estes nós na ordem:
#
Nó
Propósito
1
Webhook
Receber o item de origem aprovado.
2
Editar Campos / Código
Normalizar nomes de campos e padrões.
3
Se
Rejeitar texto de origem ausente ou vazio.
4
Cadeia LLM Básica
Conter as instruções de reaproveitamento e o conteúdo dinâmico da origem.
5
Modelo de Chat Anthropic
Gerar os rascunhos reaproveitados.
6
Analisador de Saída Estruturada
Impor campos JSON estáveis.
7
Se
Roteie needs_review=true para revisão manual.
8
Nó de destino
Salvar a saída aprovada como rascunhos.
9
Responder ao Webhook
Retornar status e ID do registro gerado ao chamador.
Se você preferir um pipeline agendado, substitua o Webhook por um Gatilho de Agenda e adicione um nó de origem que recupere itens aprovados e não processados.
Como evitar reaproveitar a mesma origem duas vezes
Adicione um source_id imutável a cada item e armazene IDs processados. Antes que o Claude execute, verifique se esse ID já foi concluído com sucesso. Isso é idempotência básica: repetir o mesmo gatilho não deve criar rascunhos duplicados, a menos que você solicite explicitamente uma nova versão.
Para revisões, use uma chave composta como source_id + source_revision. Isso permite que a versão 2 de um artigo gere novos rascunhos sem fingir que é a mesma origem que a versão 1.
Como reduzir o custo da API Claude
A escolha do modelo é apenas uma alavanca. O maior custo evitável é frequentemente enviar texto desnecessário ou gerar saídas desnecessariamente longas.
Remova navegação, boilerplate e HTML não relacionado antes da chamada do modelo.
Solicite apenas os formatos que você realmente precisa.
Defina restrições sensatas de comprimento de saída no prompt.
Use Haiku 4.5 para transformações simples de alto volume quando a qualidade for suficiente.
Use Sonnet 5 quando a origem exigir mais nuance ou adaptação cruzada de formato mais forte.
Não envie o mesmo guia de marca longo em cada chamada se você puder representá-lo com instruções estáveis concisas.
Meça o uso de tokens e o custo, em vez de assumir que um fluxo de trabalho curto é barato.
A Anthropic também oferece cache de prompt e processamento em lote para cargas de trabalho aplicáveis, mas esses recursos têm seus próprios requisitos e preços. Não os adicione ao primeiro fluxo de trabalho, a menos que contexto repetido ou processamento de alto volume não urgente torne a complexidade adicional valiosa.
Três modos de falha para testar antes de publicar
1. Fatos alucinados
Alimente o fluxo de trabalho com uma origem que intencionalmente omite uma estatística. O comportamento esperado é que a saída não invente uma. Se isso acontecer, fortaleça as instruções de fidelidade à origem e o portão de revisão.
2. Saída estruturada quebrada
Teste cada campo obrigatório, matrizes vazias, texto de origem incomumente longo e caracteres especiais. Um pipeline não é confiável apenas porque uma saída de demonstração atraente pareceu correta.
3. Execuções duplicadas
Envie o mesmo source_id duas vezes. A segunda execução deve parar, atualizar o registro existente ou criar intencionalmente uma revisão de acordo com seu design—não duplicar silenciosamente cada rascunho.
Você precisa de um Agente de IA para isso?
Normalmente, não. Um Agente de IA é útil quando o modelo deve decidir quais ferramentas chamar ou tomar ações diferentes com base em um objetivo aberto. O reaproveitamento de conteúdo é normalmente uma transformação previsível, então uma cadeia é mais fácil de inspecionar, testar e controlar.
Mude para um agente apenas quando você tiver uma necessidade concreta, como escolher dinamicamente ferramentas de pesquisa, decidir qual destino recebe um rascunho ou pedir a um humano informações ausentes. Mesmo assim, mantenha ações de publicação irreversíveis atrás de uma revisão explícita até que o fluxo de trabalho seja bem testado.
Lista de verificação final de construção
Auto-hospede a Community Edition do n8n se você quiser que a camada de software n8n permaneça gratuita.
Não descreva o uso da API Claude como permanentemente gratuito.
Use um Webhook para processamento sob demanda ou Gatilho de Agenda para lotes agendados.
Normalize cada origem em um contrato de entrada.
Passe o texto da origem, não apenas uma URL.
Armazene a chave de API Anthropic nas credenciais do n8n.
Use um modelo Claude ativo e verifique a página de descontinuação periodicamente.
Use uma Cadeia LLM Básica para reaproveitamento previsível.
Exija um esquema de saída estruturada.
Adicione needs_review e notas de revisão ao esquema.
Deduplicar com um ID de origem estável.
Salve rascunhos antes de habilitar a publicação automática.
Teste alucinações, entradas malformadas, gatilhos duplicados e caminhos de falha.
Monitore o uso de tokens e os custos de serviços externos.
A melhor primeira versão é deliberadamente chata: uma entrada limpa, uma chamada Claude controlada, uma resposta JSON validada e um destino de rascunho. Essa arquitetura é fácil de depurar e barata de operar. Uma vez que funcione de forma confiável em material de origem real, você pode adicionar mais canais, agendamento, aprovações humanas, análises ou integrações de publicação sem reconstruir o pipeline central.