Reduzir a fatura da API de um LLM em 50% é possível em muitas cargas de trabalho, mas não é uma garantia universal. O resultado depende de onde vem o seu gasto: tokens de entrada não armazenados em cache, tokens de entrada armazenados em cache, tokens de saída, tokens de raciocínio, chamadas de ferramentas ou novas tentativas. A compressão de prompts funciona melhor quando entradas longas ou repetitivas representam uma parcela significativa da fatura. Portanto, o objetivo prático não é “tornar cada prompt metade do tamanho”. É “remover tokens que não alteram a resposta, preservar os tokens que alteram e verificar a economia no tráfego real”.
Este guia usa quatro etapas de implementação: medir a linha de base, remover entradas redundantes, organizar prompts para reutilização de cache e mover instruções de saída verbosas para controles estruturados onde a API os suporta. Os exemplos são ilustrativos, não afirmações de benchmark. Os preços dos provedores e o comportamento do cache mudam com o tempo, então verifique as taxas atuais antes de fazer uma estimativa de produção.
O que uma redução de custo de API de 50% realmente exige?
Comece com a equação de faturamento do seu modelo. Para uma carga de trabalho de texto simples, o custo total da solicitação é aproximadamente o custo da entrada não armazenada em cache mais a entrada armazenada em cache mais a saída. Alguns modelos ou recursos adicionam outras categorias faturáveis. As respostas atuais da API da OpenAI expõem o uso de tokens de entrada e saída, incluindo detalhes de tokens em cache, e suas páginas de modelos publicam taxas separadas para entrada, entrada em cache e saída.
| Carga de trabalho ilustrativa | Tokens de entrada | Tokens de saída | Resultado relativo |
|---|
| Solicitação de linha de base | 10.000 | 1.000 | 100% do custo de linha de base |
| Apenas a entrada é reduzida pela metade | 5.000 | 1.000 | Menos de 50% de economia total quando a saída permanece inalterada |
| Entrada e saída são ambas reduzidas pela metade | 5.000 | 500 | Aproximadamente 50% menor custo baseado em tokens quando as taxas permanecem inalteradas |
Para um exemplo concreto atual, a página oficial do modelo GPT-5.6 Sol listava, em 11 de setembro de 2026, US$ 4 por milhão de tokens de entrada, US$ 0,40 por milhão de tokens de entrada em cache e US$ 20 por milhão de tokens de saída. A essas taxas, uma solicitação de 10.000 entradas/1.000 saídas custa cerca de US$ 0,06 antes de outras taxas. Reduzir apenas a entrada para 5.000 tokens traz esse exemplo para cerca de US$ 0,04, uma redução de 33%. Reduzir tanto a entrada quanto a saída pela metade traz para cerca de US$ 0,03, uma redução de 50%. Esses preços podem mudar, então trate a aritmética como um método, não como uma cotação permanente. Veja a página oficial do modelo GPT-5.6 Sol para preços atuais.
Referência rápida: as quatro jogadas de maior valor
| Técnica | Melhor ajuste | Risco principal | O que medir |
|---|
| Auditoria de tokens | Qualquer carga de trabalho de produção | Otimizar o componente errado | Entrada, entrada em cache, saída, novas tentativas, custo por tarefa bem-sucedida |
| Remoção de redundância | Prompts de sistema longos, políticas repetidas, exemplos verbosos | Excluir uma restrição que realmente importa | Sucesso da tarefa e paridade de seguimento de instruções |
| Layout amigável ao cache | Solicitações repetidas compartilhando instruções ou contexto estáveis | Baixa reutilização de cache porque o texto dinâmico aparece muito cedo | Razão de tokens em cache e latência |
| Controles de saída estruturada | Extração JSON, classificação, formatos de resposta fixos | Esquema muito rígido para a tarefa | Tokens de saída, falhas de análise, novas tentativas |
Etapa 1: Meça a linha de base real de tokens antes de alterar os prompts
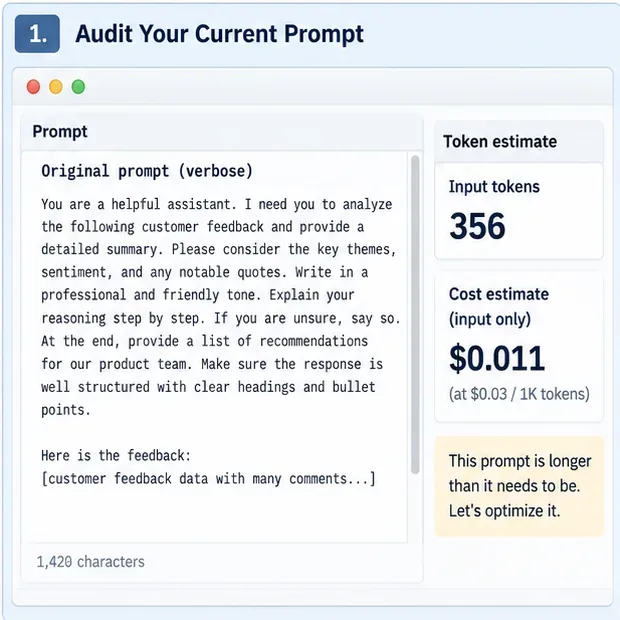
Legenda: Uma interface ilustrativa de auditoria de tokens registra o tamanho original do prompt e uma estimativa de custo de amostra antes da compressão; os números não são os preços atuais do provedor.
Colete uma amostra representativa de solicitações de produção em vez de otimizar um prompt escolhido a dedo. No mínimo, registre tokens de entrada, tokens de entrada em cache quando disponíveis, tokens de saída, nome do modelo, latência, novas tentativas e se a resposta final passou na sua verificação de qualidade de negócios. Se o seu provedor oferecer um endpoint de contagem de tokens de entrada, use-o antes de enviar solicitações quando precisar de orçamento determinístico. A OpenAI documenta atualmente um endpoint de contagem de tokens de entrada de Respostas em sua referência oficial da API.
Calcule o custo por tarefa bem-sucedida, não apenas o custo por chamada de API. Um prompt comprimido que causa mais novas tentativas pode ser mais caro, mesmo que cada solicitação seja mais curta. Segmente a linha de base por tipo de tarefa também: resumo, extração, resposta a perguntas RAG, uso de ferramentas agênticas e conversas longas geralmente têm perfis de tokens diferentes.
Etapa 2: Remova redundância sem excluir informações críticas para a decisão

Legenda: Um prompt ilustrativo antes e depois mantém as mesmas saídas solicitadas, removendo palavras repetidas e instruções de processo desnecessárias.
A primeira passada de compressão mais segura é a deduplicação semântica. Exclua descrições de papel repetidas, restrições duplicadas, preenchimento educado, explicações de formatação óbvia e exemplos que ensinam o mesmo padrão mais de uma vez. Mescle regras sobrepostas em uma única instrução. Prefira uma frase precisa a várias frases que reafirmam o mesmo requisito.
Antes
Você é um assistente útil que é um especialista em análise de produtos.
Preciso que você analise o seguinte feedback do cliente e forneça
um resumo detalhado. Por favor, identifique os temas principais, o sentimento geral,
citações notáveis e recomendações para nossa equipe de produto. Certifique-se
de que sua resposta seja profissional, clara, concisa e bem estruturada.
Depois
Analise o feedback do cliente.
Retorne: temas principais, sentimento geral, citações notáveis e recomendações de produto.
Seja conciso e factual.
Não comprima exceções, limites de política, definições de domínio, regras de segurança de ferramentas ou requisitos de evidência simplesmente porque são longos. Esses são frequentemente tokens de alto valor. Um teste útil é perguntar: “Se eu remover esta frase, a saída aceitável pode mudar?” Se sim, mantenha-a, a menos que um controle de API ou esquema possa impor o mesmo comportamento de forma mais confiável.
Etapa 3: Coloque conteúdo estável primeiro e conteúdo dinâmico por último
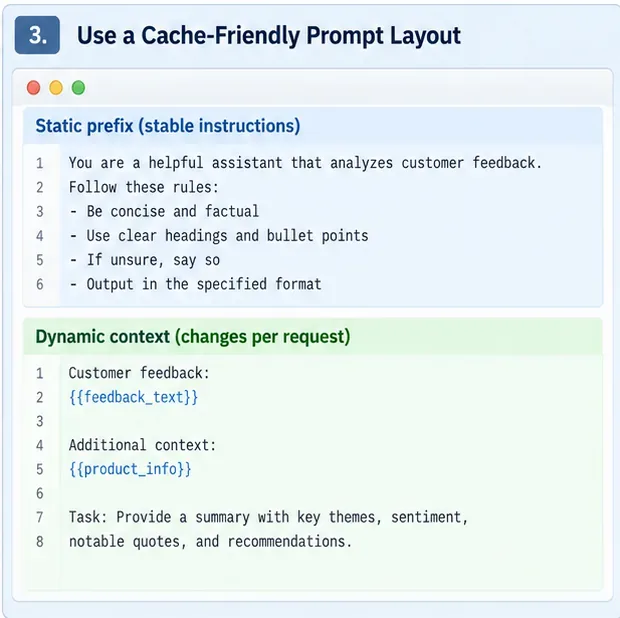
Legenda: Um layout de prompt ilustrativo coloca instruções estáveis em um prefixo reutilizável e anexa o contexto específico da solicitação mais tarde.
O cache de prompts não reduz a contagem bruta de tokens, mas pode reduzir a quantidade faturada na taxa normal de entrada e diminuir a latência de processamento do prompt. Isso torna o layout do prompt parte da otimização de custos. Agrupe instruções do sistema, exemplos compartilhados, orientação de ferramentas e outro conteúdo estável juntos. Coloque fatos específicos da solicitação, passagens recuperadas, dados do usuário e a pergunta atual mais tarde.
A orientação do modelo da OpenAI recomenda explicitamente colocar conteúdo estático primeiro e conteúdo dinâmico por último para melhorar a reutilização do cache de prompts, e seu objeto de uso de resposta expõe informações de tokens em cache para medição. Veja a orientação oficial do modelo e a referência da API de Respostas.
Evite alterar espaços em branco inofensivos, ordem de exemplos, timestamps, IDs aleatórios ou texto por usuário dentro de um prefixo de outra forma reutilizável, a menos que a semântica de cache do provedor diga que essas alterações são seguras. Meça os acertos de cache da resposta da API em vez de assumir que um prompt está sendo reutilizado.
Etapa 4: Substitua prosa sobre formato por controles de saída estruturada
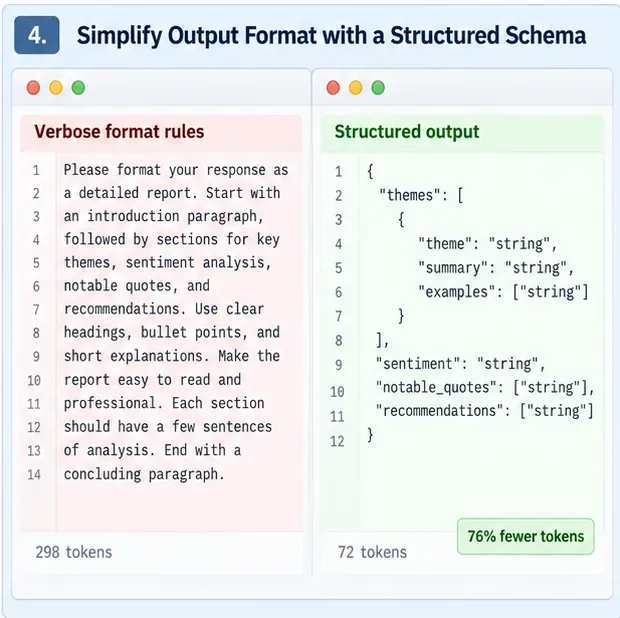
Legenda: Uma visão ilustrativa de saída estruturada mostra como um esquema pode substituir muitas linhas de prosa que descrevem repetidamente a mesma forma de resposta.
Prompts de extração e classificação frequentemente desperdiçam tokens descrevendo campos JSON, valores permitidos, aninhamento, ordenação e regras de validação em linguagem natural. Quando a API suporta saídas estruturadas ou argumentos de ferramenta tipados, mova o máximo possível desse contrato para a interface estruturada e mantenha a instrução em linguagem natural focada no significado.
A orientação atual da OpenAI recomenda especificamente remover definições de esquema de saída do prompt quando possível e usar Saídas Estruturadas em vez disso. Isso pode reduzir o texto do prompt e também reduzir novas tentativas de saída malformada. O mecanismo exato varia por provedor, então não copie um formato de solicitação específico da OpenAI para outra API sem verificar a documentação desse provedor.
Compressão avançada para RAG, documentos longos e conversas
Depois que as quatro etapas básicas estiverem estáveis, economias maiores geralmente vêm da redução do contexto, em vez de polir a redação das frases. Em sistemas RAG, recupere menos passagens, mas mais relevantes, deduplique trechos quase idênticos e evite anexar documentos que não podem afetar a resposta. Para conversas longas, mantenha fatos duráveis e decisões não resolvidas, mas resuma ou descarte turnos que não influenciam mais a tarefa atual. Para sistemas de agentes, exponha apenas as ferramentas e descrições de ferramentas relevantes para o estágio atual quando sua arquitetura permitir com segurança.
Compressores de prompt aprendidos são outra opção para contextos muito longos. O projeto de código aberto da Microsoft LLMLingua implementa compressão de prompt em nível de token. O artigo original do LLMLingua relatou taxas de compressão de até 20× com degradação limitada do benchmark em suas configurações avaliadas. O LongLLMLingua visa tarefas de contexto longo, enquanto o LLMLingua-2 usa um compressor aprendido agnóstico à tarefa. Esses são resultados de pesquisa, não uma promessa de que as mesmas taxas preservarão a qualidade nos seus dados. Faça benchmark das suas próprias tarefas, idiomas, modelos e tipos de prompt antes de implantar compressão agressiva.
Como provar que a otimização é realmente melhor
Execute uma avaliação A/B nas mesmas solicitações representativas. As versões de linha de base e comprimidas devem usar o mesmo modelo, configurações de raciocínio, ferramentas, entradas de recuperação e critérios de sucesso. Altere uma técnica de compressão por vez quando possível, para que você possa identificar o que causou uma regressão.
| Métrica | Por que importa | Interpretação sugerida |
|---|
| Redução de tokens de entrada | Mostra a redução bruta do prompt | Útil, mas não suficiente por si só |
| Razão de tokens em cache | Mostra se prefixos estáveis são reutilizados | Maior é geralmente melhor quando a qualidade permanece inalterada |
| Redução de tokens de saída | Pode alterar materialmente o custo total | Verifique se a saída concisa ainda completa a tarefa |
| Custo por tarefa bem-sucedida | Inclui novas tentativas e falhas | Esta é a principal métrica de negócios |
| Sucesso da tarefa / precisão | Detecta perda de informação | Defina um limite de não inferioridade aceitável antes de testar |
| Latência p50 e p95 | Mostra o impacto real no usuário | O pré-processamento de compressão pode compensar as economias de inferência |
Não declare vitória porque um prompt é 50% mais curto. A condição de aceitação mais forte é: a configuração comprimida reduz o custo medido em aproximadamente a sua meta, permanecendo dentro das suas tolerâncias pré-definidas de qualidade, latência e confiabilidade.
Quando você deve parar de comprimir?
Para ou recue quando a próxima redução remover fatos necessários para decisões corretas, aumentar alucinações, causar erros de chamada de ferramenta, enfraquecer a conformidade com políticas ou aumentar novas tentativas o suficiente para apagar as economias. A compressão também pode adicionar latência se você executar um modelo separado para comprimir cada prompt. Um estudo de 2026 sobre compressão de prompts em configurações de inferência do mundo real descobriu que a sobrecarga de pré-processamento pode cancelar os ganhos de inferência fora de regimes favoráveis de comprimento de prompt e hardware, o que é outra razão para medir o desempenho de ponta a ponta, em vez de apenas a contagem de tokens.
Para prompts pequenos, a limpeza manual e a organização amigável ao cache geralmente são mais fáceis de justificar do que adicionar um modelo de compressão dedicado. Para cargas úteis RAG grandes ou fluxos de trabalho multi-documento, a seleção de contexto e a compressão aprendida tornam-se mais atraentes porque o volume de tokens removíveis é muito maior.
Lista de verificação rápida de implementação
- Capture uma linha de base de produção com entrada, entrada em cache, saída, latência, novas tentativas e sucesso da tarefa.
- Remova instruções duplicadas, prosa de baixo valor e exemplos redundantes primeiro.
- Preserve definições de domínio, exceções, requisitos de evidência e restrições de segurança.
- Coloque conteúdo estável do prompt antes do conteúdo dinâmico específico da solicitação quando a semântica de cache recompensar prefixos reutilizáveis.
- Use saídas estruturadas ou esquemas de ferramentas em vez de descrever repetidamente formatos de resposta fixos em prosa.
- Para RAG, reduza contexto irrelevante e duplicado antes de tentar compressão em nível de token.
- Limite o comprimento da saída apenas quando a tarefa ainda puder ser concluída corretamente.
- Compare o custo por tarefa bem-sucedida, não apenas a contagem de tokens do prompt.
- Execute testes de regressão antes e depois de cada alteração significativa de compressão.
- Reverifique os preços do provedor e as regras de cache sempre que alterar modelos ou versões da API.
Conclusão
Uma redução de 50% é uma meta de engenharia razoável para algumas cargas de trabalho verbosas e pesadas em contexto, mas deve ser tratada como um resultado a ser validado, não uma expectativa padrão. O caminho mais confiável é medir primeiro, remover texto semanticamente redundante, maximizar a reutilização segura do cache, encurtar contratos de saída com controles estruturados e, em seguida, atacar os maiores blocos de contexto restantes com poda de recuperação, resumo ou um compressor de prompt testado. Se o custo final por tarefa bem-sucedida cair enquanto a qualidade permanecer dentro da sua faixa de aceitação, a compressão está funcionando. Se a qualidade ou as novas tentativas deteriorarem, restaure a informação ausente e otimize uma parte diferente da solicitação.
Referências primárias








