Início
» Domínios
»
Como executar o DeepSeek offline no Windows 11 com o LM Studio
Como executar o DeepSeek offline no Windows 11 com o LM Studio
Sim, você pode executar o DeepSeek completamente offline no Windows 11 com o LM Studio, mas precisa de uma configuração inicial online. Instale o LM Studio, baixe um modelo DeepSeek compatível e o runtime necessário, carregue o modelo uma vez e, em seguida, você pode desconectar da internet. A documentação oficial de modo offline do LM Studio afirma que conversar com modelos baixados, conversar com documentos locais e executar seu servidor local não exigem acesso à internet.
Para um PC típico com Windows 11, o ponto de partida mais prático não é o maior modelo DeepSeek atual. Um modelo GGUF menor, como o DeepSeek-R1-0528-Qwen3-8B, é muito mais fácil de executar localmente. O LM Studio publicou suporte para esse modelo destilado de 8B em maio de 2025 e afirma que ele funciona no formato GGUF com o LM Studio 0.3.16 ou mais recente. Em contraste, a orientação de agosto de 2026 do LM Studio para o DeepSeek V4 Flash diz que o uso local requer cerca de 156GB de memória do sistema. Isso torna o V4 Flash uma escolha ruim para a maioria das máquinas Windows de consumo, mesmo sendo mais novo e mais capaz.
Este guia foi verificado em 11 de setembro de 2026. O changelog do LM Studio lista a versão 0.4.24 datada de 9 de setembro de 2026. Como a interface do LM Studio evolui, um botão pode se mover ligeiramente entre as versões, mas o fluxo de trabalho principal—baixar um modelo, carregá-lo, conversar localmente e, opcionalmente, expor uma API localhost—permanece documentado pelo LM Studio.
Antes de Começar: Seu PC com Windows 11 Atende aos Requisitos?
O LM Studio atualmente suporta tanto PCs Windows x64 quanto sistemas Windows baseados em ARM. Para x64, a CPU deve suportar AVX2. O LM Studio recomenda pelo menos 16GB de RAM e pelo menos 4GB de VRAM dedicada. Essas são recomendações a nível de aplicativo, não uma promessa de que todos os modelos caberão. O tamanho do modelo, a quantização, o comprimento do contexto e a descarga para GPU afetam o uso de memória.
O que você tem
Recomendação prática
Por quê
16GB de RAM, GPU modesta ou gráficos integrados
Comece com um modelo destilado DeepSeek de 8B ou menor em uma variante GGUF de 4 bits
Mantém a pegada do modelo relativamente gerenciável, preservando a capacidade útil de raciocínio.
Mais RAM e uma GPU mais forte
Tente variantes destiladas maiores apenas após verificar a estimativa de adequação do dispositivo do LM Studio
Modelos maiores podem melhorar a qualidade, mas consomem substancialmente mais memória e podem ser muito mais lentos.
PC de jogos ou laptop comum
Não comece com o DeepSeek V4 Flash
O LM Studio diz que o modelo V4 Flash local precisa de pelo menos 156GB de memória do sistema.
A documentação de download de modelos do LM Studio explica que as compilações quantizadas trocam alguma fidelidade por arquivos menores e menor pressão de memória. Sua recomendação geral é escolher uma opção de 4 bits ou superior quando seu hardware puder suportá-la. Se você não tiver certeza, uma versão GGUF de 4 bits é um primeiro teste sensato.
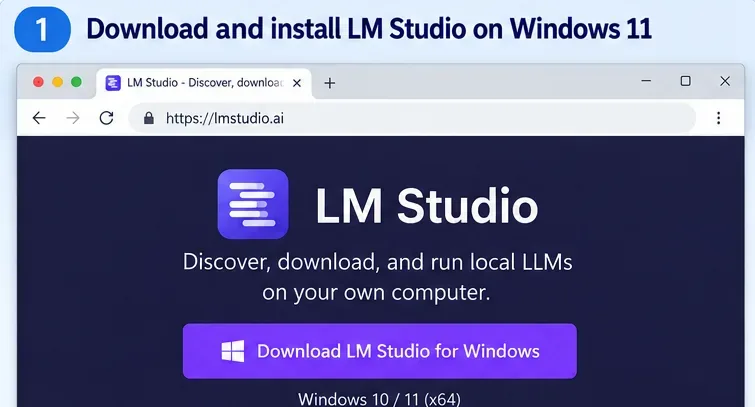
Baixe a compilação estável atual do Windows na página oficial de download do LM Studio. Use o instalador que corresponde à arquitetura do seu Windows. Em um PC x64, certifique-se de que seu processador suporta AVX2 antes de solucionar erros de carregamento de modelo mais tarde.
A visualização de download do Windows para o LM Studio. Escolha o instalador que corresponde ao seu sistema Windows 11 antes de passar para o download do modelo.
Inicie o LM Studio enquanto você ainda tem uma conexão com a internet. Isso é importante porque o aplicativo pode precisar baixar ou atualizar um LM Runtime. O LM Studio descreve os runtimes como motores de inferência empacotados, como seu runtime baseado em llama.cpp para modelos GGUF. Os downloads de runtime exigem conectividade, mesmo que a inferência possa funcionar offline posteriormente.
Passo 2: Baixe um Modelo DeepSeek que Caiba no Seu PC
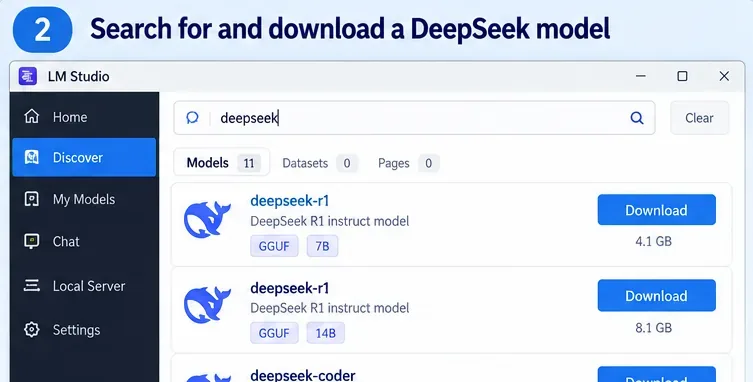
Abra a área Discover no LM Studio e pesquise por DeepSeek. O LM Studio pode pesquisar modelos suportados do Hugging Face por palavra-chave, por um identificador user/model ou até mesmo por uma URL completa do Hugging Face.
Pesquise por DeepSeek no Discover, depois escolha um modelo e quantização apropriados para seu hardware. As entradas exatas do catálogo e os tamanhos de arquivo mudam com o tempo.
Qual modelo DeepSeek você deve escolher?
Para a maioria das pessoas seguindo este guia, comece com o DeepSeek-R1-0528-Qwen3-8B. O LM Studio diz que este modelo destilado de 8B suporta raciocínio e uso de ferramentas, está disponível como GGUF e pode rodar com muito menos memória do que os modelos DeepSeek principais. A orientação do LM Studio para Windows ainda recomenda 16GB de RAM para o aplicativo como um todo, então não trate uma afirmação de baixa memória específica do modelo como uma meta confortável para o sistema inteiro.
O DeepSeek também lançou variantes destiladas R1 anteriores com 1,5B, 7B, 8B, 14B, 32B e 70B parâmetros. Essas opções dão espaço para equilibrar velocidade e uso de memória contra capacidade. Veja o repositório oficial do DeepSeek-R1 para detalhes da família de modelos e licenciamento, e a nota de execução local do DeepSeek-R1-0528 do LM Studio para a opção de 8B.
Se você estiver tentado pelo DeepSeek V4 Flash porque é mais novo, verifique o requisito de hardware primeiro. O artigo oficial do V4 Flash do LM Studio diz que o modelo Mixture-of-Experts de 284B precisa de pelo menos 156GB de memória do sistema para uso local. É viável em estações de trabalho de alta memória, não em um laptop Windows normal.
Passo 3: Carregue o Modelo na Memória
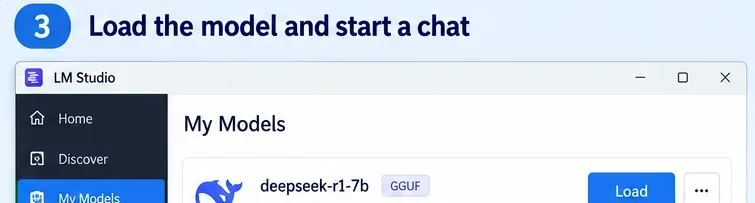
Depois que o download terminar, vá para seus modelos baixados ou abra o carregador de modelos a partir do Chat. Selecione o modelo DeepSeek e carregue-o. O LM Studio explica que carregar um modelo aloca memória para os pesos do modelo e o estado relacionado do runtime.
Um modelo GGUF DeepSeek baixado pronto para carregar. Se o carregamento falhar, tente um modelo menor ou uma quantização de menor memória antes de alterar configurações avançadas.
Para sua primeira execução, mantenha as configurações de carregamento conservadoras. Uma janela de contexto muito grande pode consumir memória adicional significativa, então há pouco motivo para maximizar o contexto imediatamente. Carregue o modelo com um contexto modesto, verifique se ele funciona e expanda apenas quando sua carga de trabalho exigir.
Se o LM Studio relatar que o modelo não cabe, a correção mais confiável geralmente é escolher um modelo menor ou uma quantização mais compacta. Fechar aplicativos pesados em memória pode ajudar, mas não muda a pegada fundamental do modelo.
Passo 4: Desconecte a Internet e Verifique se o DeepSeek Realmente Funciona Offline
Este é o passo que separa "modelo local" de meramente "usar um cliente de desktop". Uma vez que o modelo e seu runtime estão instalados, desligue o Wi-Fi e desconecte o Ethernet. Em seguida, inicie um novo chat e envie um prompt simples como:
Explique a diferença entre RAM e VRAM em cinco tópicos.
Se o modelo responder enquanto o PC não tem conexão de rede, a inferência é local. O LM Studio afirma que, uma vez que um LLM está em sua máquina, ele pode rodar inteiramente offline e que o texto inserido em chats de LLM locais não sai do seu dispositivo. Sua documentação offline também diz que o processamento de documentos locais e RAG permanecem na máquina.
Um modelo DeepSeek carregado respondendo no LM Studio Chat. Para verificar a operação offline você mesmo, desconecte o acesso à rede após o modelo e o runtime estarem totalmente baixados e repita um prompt simples.
Há um limite importante: pesquisar modelos, baixar novos modelos, baixar runtimes e verificar atualizações do aplicativo exigem acesso à internet. Se você adicionar posteriormente modelos em nuvem, servidores MCP remotos, ferramentas web ou outras integrações de rede, esses recursos também podem exigir conectividade. As afirmações de privacidade offline se aplicam ao fluxo de trabalho local, não aos serviços que você conecta deliberadamente depois.
Passo 5: Opcional—Use o DeepSeek Através de uma API Local
Se você quiser que outro aplicativo Windows, script, extensão de IDE ou ferramenta interna chame seu modelo DeepSeek local, o LM Studio pode executar um servidor local. A documentação atual para desenvolvedores diz que você pode iniciá-lo a partir da página Developer ou com:
lms server start
Por padrão, o servidor está disponível em http://localhost:1234. O LM Studio fornece endpoints REST nativos e endpoints compatíveis com OpenAI. O servidor em si pode operar offline, desde que o modelo e o runtime já estejam locais. No entanto, se você expor o servidor além do localhost, revise as configurações de autenticação e acesso à rede primeiro.
RAM/VRAM insuficiente, contexto excessivo ou CPU/runtime não suportado
Tente um modelo DeepSeek menor, uma quantização menor ou um comprimento de contexto menor. No Windows x64, confirme o suporte AVX2.
O LM Studio funciona online, mas não após desconectar
O modelo ou o runtime necessário não foi totalmente baixado
Reconecte uma vez, termine todos os downloads de modelo/runtime, carregue o modelo com sucesso e repita o teste offline.
A geração é muito lenta
O modelo é grande demais para a aceleração de GPU disponível e depende fortemente da CPU/memória do sistema
Escolha um modelo ou quantização menor. Um modelo maior não é útil se a latência tornar o fluxo de trabalho impraticável.
Você não consegue encontrar um modelo enquanto offline
A pesquisa Discover precisa de acesso à rede
Baixe os modelos antes de ficar offline, ou faça o sideload de um arquivo de modelo obtido através de outro processo controlado.
Você esperava que o V4 Flash rodasse em um laptop normal
Seu requisito de memória local é de classe estação de trabalho
Use um modelo destilado R1 em vez disso, a menos que sua máquina tenha aproximadamente 156GB ou mais de memória do sistema.
Quando Esta Configuração é Adequada
Executar o DeepSeek offline com o LM Studio é uma ótima opção quando você deseja inferência local privada, custos previsíveis após baixar o modelo, experimentação sem chaves de API ou uma API localhost para desenvolvimento. Também é útil quando sua máquina precisa continuar funcionando sem acesso à internet.
É uma opção menos adequada quando você precisa do modelo DeepSeek mais forte disponível, mas só tem hardware de consumo, quando precisa de throughput extremamente alto ou quando sua carga de trabalho depende de informações web ao vivo. Modelos locais só sabem o que está em seus pesos e no contexto que você fornece, a menos que você conecte deliberadamente ferramentas externas ou fontes de dados.
Checklist Rápido
Use um sistema Windows 11 que atenda aos requisitos do LM Studio; CPUs x64 precisam de AVX2.
Mantenha o acesso à internet ativado para os downloads iniciais do LM Studio, runtime e modelos.
Comece com um modelo GGUF DeepSeek menor, especialmente um modelo destilado de classe 8B.
Escolha uma quantização de 4 bits ou superior se seu hardware puder suportá-la.
Carregue o modelo com sucesso antes de desconectar a rede.
Desligue o Wi-Fi/Ethernet e execute um novo prompt para verificar a inferência offline.
Reduza o tamanho do modelo ou o comprimento do contexto se encontrar erros de memória.
Use o servidor localhost do LM Studio apenas se precisar de acesso à API local.
Conclusão
A maneira mais fácil de executar o DeepSeek offline no Windows 11 é combinar o LM Studio com um modelo GGUF DeepSeek menor que realmente caiba no seu hardware. Para um PC normal, um modelo destilado R1 de classe 8B é um ponto de partida muito mais realista do que o DeepSeek V4 Flash. Complete os downloads enquanto estiver online, carregue o modelo, desconecte a rede e verifique se um novo chat ainda responde. Uma vez que isso funcione, você tem uma configuração DeepSeek genuinamente local, em vez de um wrapper de desktop em torno de uma API em nuvem.