Início
» Domínios
»
Como corrigir o erro "Tempo limite da API" ao executar fluxos de trabalho multiagentes
Como corrigir o erro "Tempo limite da API" ao executar fluxos de trabalho multiagentes
Um erro de "tempo limite da API" em um fluxo de trabalho multiagente raramente é resolvido alterando-se apenas um número. Um planejador pode chamar três agentes, cada agente pode chamar uma API de LLM, serviço de busca, banco de dados ou ferramenta, e cada camada pode ter seu próprio tempo limite, política de repetição, pool de conexões e limite de concorrência. A solução prática é identificar qual camada atinge o tempo limite primeiro e, em seguida, escolher entre esperas mais longas, menos chamadas simultâneas, novas tentativas mais inteligentes, um caminho crítico mais curto ou um design de trabalho assíncrono.
A relação de compromisso é importante: aumentar o tempo limite é simples, mas mantém os recursos ocupados por mais tempo; novas tentativas agressivas podem multiplicar a carga e o custo; diminuir a concorrência melhora a estabilidade, mas reduz a taxa de transferência máxima; agentes paralelos reduzem a latência real apenas quando os serviços subsequentes conseguem absorver a distribuição de recursos. Não existe uma configuração ideal única para todos os sistemas multiagentes.
Qual timeout você está atingindo exatamente?
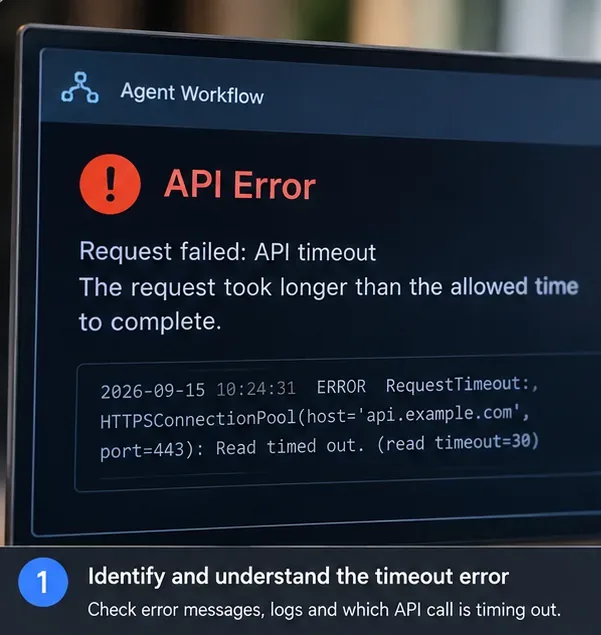
Comece classificando a falha em vez de tratar cada timeout como o mesmo evento. Os clientes HTTP podem sofrer timeouts durante a conexão, leitura, escrita ou enquanto aguardam uma conexão de um pool. O HTTPX, por exemplo, documenta quatro tipos distintos de timeout: conexão, leitura, escrita e pool. Seu comportamento padrão é gerar um timeout após cinco segundos de inatividade na rede, e não necessariamente cinco segundos de duração total da requisição. Consulte a documentação oficial sobre timeouts do HTTPX .
Se você usa o SDK Python da OpenAI, o arquivo README oficial atual informa que as requisições têm um tempo limite de cliente padrão de 10 minutos e que as falhas de tempo limite são tentadas duas vezes por padrão. O SDK também tenta novamente automaticamente erros de conexão, além de respostas HTTP 408, 409, 429 e 5xx, com um pequeno intervalo de espera exponencial. Esses são os valores padrão do SDK e não garantem que todos os proxies, balanceadores de carga, gateways ou orquestradores à frente da requisição aguardarão 10 minutos. Consulte o arquivo README oficial do SDK Python da OpenAI .
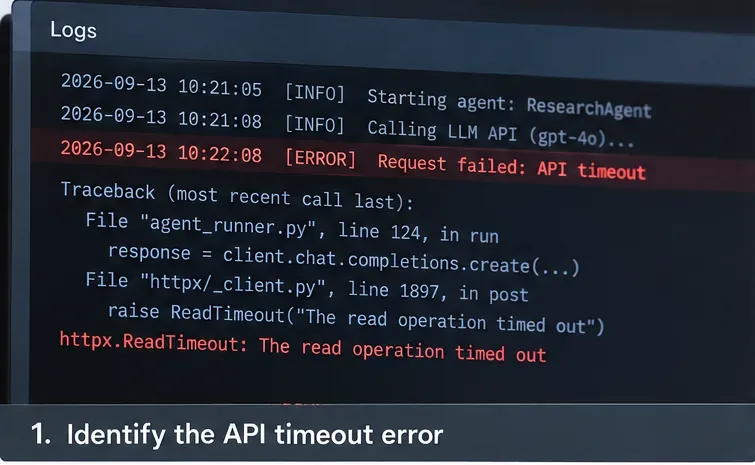
Etapa 1: capture a exceção exata e o agente, o endpoint e a camada de transporte que apresentaram o tempo limite, em vez de registrar apenas uma falha genérica no fluxo de trabalho.
Qual solução você deve escolher?
Opção
Melhor ajuste
Principal benefício
Principal compensação
Aumente o tempo limite da solicitação.
Chamadas de modelo/ferramenta saudáveis, mas legitimamente lentas
Alterações mínimas no código e na arquitetura.
Os trabalhadores e as conexões permanecem ocupados por mais tempo; um gateway upstream ainda pode encerrar a solicitação primeiro.
Tente novamente com recuo exponencial.
Erros transitórios de rede, limites de taxa, falhas selecionadas de nível 5xx
Recupera-se automaticamente de falhas de curta duração.
Pode multiplicar o tráfego, a latência e o custo; inseguro para ações não idempotentes, a menos que seja projetado com cuidado.
Reduzir a concorrência de agentes
Erros 429, timeouts de pool, saturação a jusante
Reduz picos de tráfego e disputas na fila.
Menor produtividade máxima, por vezes, maior tempo de conclusão do fluxo de trabalho.
Paralelizar agentes independentes
Fluxos de trabalho sequenciais com ramificações independentes
Reduz o caminho crítico.
Aumenta o número de solicitações simultâneas e pode acionar limites de taxa ou de conexão.
Saída parcial do fluxo
Experiência do usuário interativa onde a latência do primeiro byte é crucial.
Os usuários percebem o progresso mais rapidamente.
Não resolve automaticamente um tempo limite de integração rígido ou um serviço downstream sobrecarregado.
Mover o trabalho para uma tarefa/fila assíncrona
Fluxos de trabalho que podem levar dezenas de segundos ou minutos
Desacopla o tempo de vida da requisição HTTP do tempo de vida do fluxo de trabalho.
Requer estado de trabalho, polling/webhooks, idempotência, persistência e monitoramento operacional.
Passo 1: Encontre a primeira camada que ultrapasse o prazo limite.
Registre um ID de correlação para todo o fluxo de trabalho e um ID de intervalo ou filho para cada chamada de agente e ferramenta. Registre a hora de início, a hora de término, o ponto de extremidade, o número da tentativa, o tipo de exceção, o status da resposta (quando disponível) e se o cancelamento partiu do solicitante ou do serviço subsequente.
A questão importante é: "quem parou de esperar primeiro?" Se a chamada LLM terminar em 42 segundos, mas um gateway de API desistir em 30 segundos, aumentar o tempo limite do cliente LLM de 60 para 120 segundos não muda nada. A documentação atual da Amazon para APIs HTTP do API Gateway lista um tempo limite máximo de integração de 30 segundos, o que é um bom exemplo de por que o prazo mais curto na cadeia geralmente determina o resultado. Consulte Cotas de API HTTP do Amazon API Gateway .
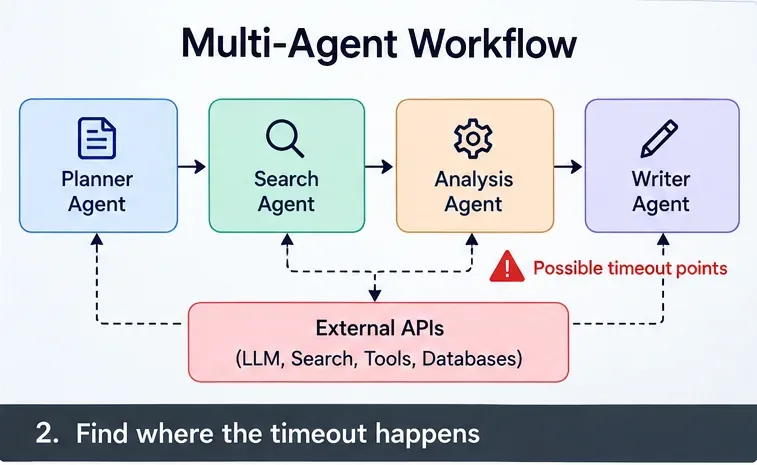
Etapa 2: mapeie o caminho da solicitação e marque todos os locais que podem encerrar ou atrasar uma chamada: orquestrador, agente, gateway, API do modelo, API de pesquisa, banco de dados e serviço de ferramenta.
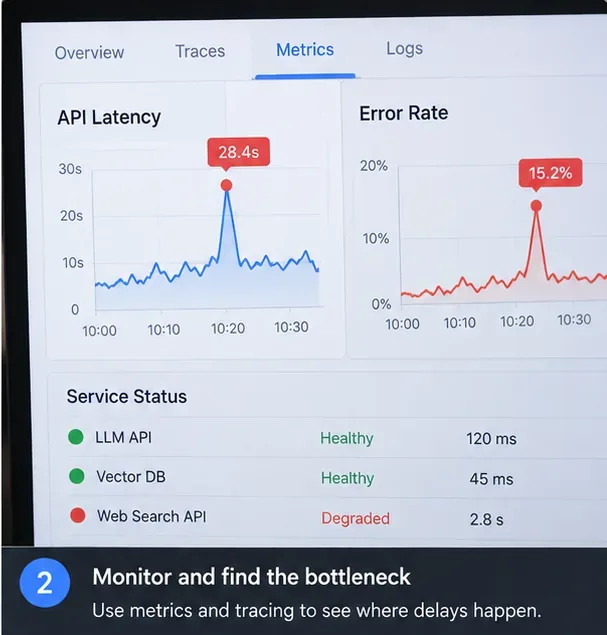
Etapa 2: Meça o caminho crítico, não apenas a latência média.
A latência média pode parecer normal, enquanto uma pequena parcela de chamadas lentas causa a maioria das falhas no fluxo de trabalho. Monitore pelo menos a taxa de sucesso por dependência, além das latências p50, p95 e p99. Em um estágio de fan-out, registre também o tempo de fila e o tempo de espera no pool de conexões, pois uma "API lenta" pode, na verdade, ser um cliente sobrecarregado aguardando uma conexão livre.
Use os rastreamentos para responder a três perguntas práticas: qual dependência domina o caminho crítico, se vários agentes lentos são executados sequencialmente quando poderiam ser executados simultaneamente e se os picos de concorrência coincidem com erros 429, de tempo limite do pool ou 5xx.
Etapa 3: compare a latência, os erros e a integridade das dependências em conjunto; um pico de tempo limite que coincide com uma dependência degradada sugere uma correção diferente de um pico de concorrência em todo o sistema.
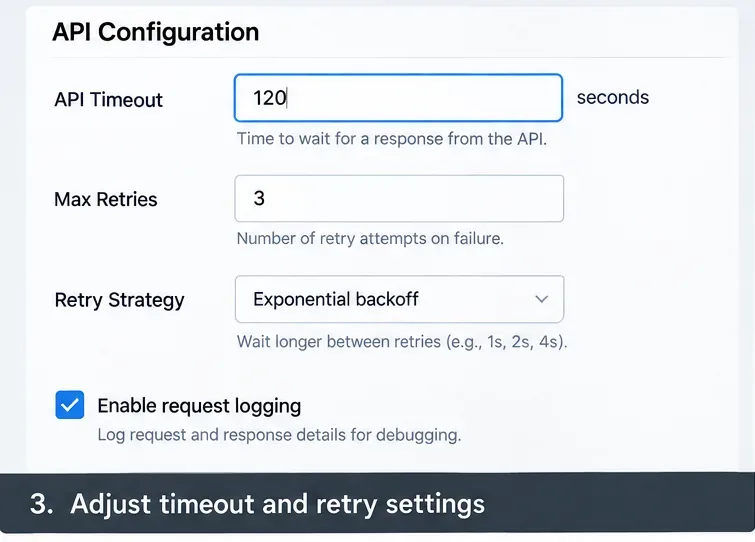
Etapa 3: Elabore um orçamento de tempo limite de fora para dentro.
Defina primeiro um prazo final para o fluxo de trabalho de ponta a ponta e, em seguida, reduza os prazos internos para que as camadas inferiores falhem cedo o suficiente para que o orquestrador se recupere. Por exemplo, um prazo de 120 segundos para a interação com o usuário pode reservar 10 segundos para orquestração e tratamento de respostas, deixando 110 segundos para trabalho útil. Uma chamada de ferramenta individual pode receber 15 segundos, enquanto uma chamada de modelo pode receber 45 ou 60 segundos, dependendo da latência observada.
Não copie esses valores cegamente; eles são um exemplo de método de orçamento, não valores padrão universais. Escolha valores com base na sua distribuição de latência medida e no SLO do produto. O prazo externo deve ser longo o suficiente para abranger a chamada interna, suas tentativas permitidas, os atrasos de backoff e o tempo de limpeza.
O Python 3.11 e versões posteriores permitem asyncio.timeout()definir um prazo limite para o trabalho assíncrono. Quando o prazo expira, a tarefa é cancelada e o gerenciador de contexto exibe uma exceção TimeoutError. Consulte a documentação oficial sobre timeouts do asyncio em Python .
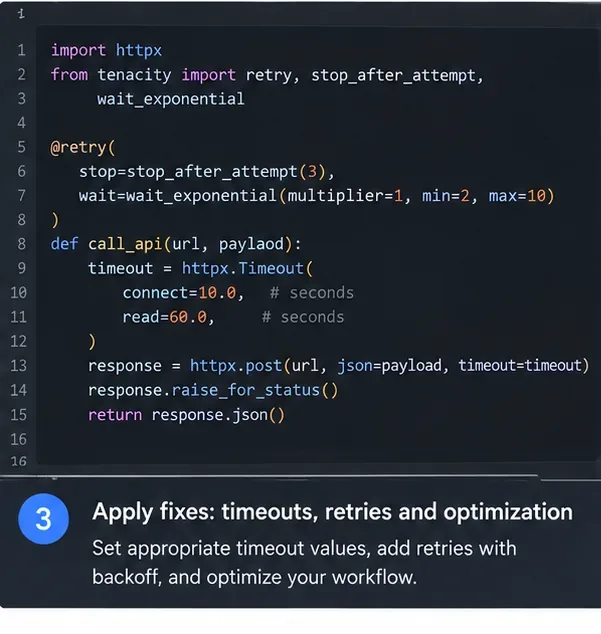
Passo 4: configure os valores de tempo limite e de novas tentativas como um orçamento coordenado, em vez de aumentar cada valor independentemente.
Passo 4: Limite a concorrência antes de aumentar as tentativas.
Sistemas multiagentes frequentemente falham porque o crescimento da demanda é mais rápido do que o esperado. Se 20 solicitações de usuários iniciarem cinco agentes cada, e cada agente iniciar duas ferramentas, o sistema pode gerar até 200 chamadas subsequentes antes de realizar novas tentativas. Adicionar novas tentativas primeiro pode transformar o congestionamento em uma tempestade de tentativas.
Um limitador de concorrência costuma ser a melhor primeira medida quando você observa respostas 429, timeouts do pool, aumento do tempo de espera na fila ou uma dependência downstream saturada. O Python asyncio.Semaphoreoferece uma maneira simples, baseada em contadores, de limitar quantas corrotinas entram em uma seção protegida simultaneamente. Consulte a documentação oficial de semáforos do Python .
import asyncio

sem = asyncio.Semaphore(8)

async def guarded_agent_call(agent, task):
    async with sem:
        return await agent.run(task)
A compensação é intencional: um limite inferior protege os serviços subsequentes, mas pode aumentar o enfileiramento dentro do seu aplicativo. Ajuste-o considerando a taxa de transferência, a latência do percentil 95, os limites de taxa e a capacidade do pool de conexões, em vez de escolher o maior número que sua máquina pode agendar.
Etapa 5: combine concorrência limitada com configurações de transporte explícitas para que um pool de conexões completo não se disfarce de modelo ou ferramenta lenta.
Passo 5: Tente novamente apenas as falhas que provavelmente terão sucesso posteriormente.
As tentativas são valiosas para falhas de conexão transitórias, limites de taxa, erros selecionados do servidor e tempos limite de requisição, quando repetir a operação é seguro. Elas são uma opção inadequada para erros de validação, falhas de autenticação, bugs determinísticos de ferramentas ou ações com efeitos colaterais sem proteção de idempotência.
Fique atento à multiplicação de tentativas. Se um SDK fizer duas tentativas, isso significa até três tentativas para uma chamada lógica. Se a sua camada de agentes também repetir a chamada inteira duas vezes, o máximo teórico passa a ser nove tentativas para essa operação lógica: três tentativas externas multiplicadas por três tentativas do SDK. Se o orquestrador repetir um estágio inteiro de cinco agentes, o volume de requisições pode crescer rapidamente.
Centralize a responsabilidade pelas novas tentativas sempre que possível. Para chamadas LLM usando o SDK Python da OpenAI, lembre-se de que o SDK atual já tenta novamente duas vezes em certos tipos de falhas por padrão. Adicione uma nova tentativa externa somente quando tiver um motivo específico e puder limitar o orçamento total de tentativas.
Etapa 6: classifique o erro antes de tentar novamente; um tempo limite de leitura pode justificar uma nova tentativa limitada, enquanto um erro de configuração permanente geralmente não o faz.
Etapa 6: Encurte o caminho crítico sem criar um problema de ramificação.
Se os agentes de planejamento, pesquisa, avaliação e redação forem executados estritamente um após o outro, a latência total será aproximadamente a soma de suas durações. Ramificações independentes podem, às vezes, ser executadas simultaneamente, reduzindo o tempo real na ramificação mais lenta, em vez da soma de todas as ramificações.
O TaskGroup do Python asyncio.TaskGroupé uma maneira estruturada de executar tarefas relacionadas simultaneamente. A documentação atual do Python observa que o TaskGroup aguarda a conclusão das tarefas no grupo e cancela as tarefas restantes quando uma delas falha com uma exceção que não permite cancelamento, proporcionando um comportamento de segurança mais robusto do que a criação de tarefas sem estrutura definida. Consulte a documentação oficial do TaskGroup do Python .
A paralelização não é gratuita. Se o mesmo provedor impuser um limite rígido de solicitações por minuto ou de solicitações simultâneas, executar quatro agentes ao mesmo tempo pode transformar um fluxo de trabalho lento, porém eficiente, em uma rápida sequência de 429 respostas. Paralelize apenas tarefas verdadeiramente independentes e mantenha o limitador de concorrência global ativado.
Passo 7: Quando você deve parar de usar uma solicitação HTTP síncrona?
Se os fluxos de trabalho normais rotineiramente ultrapassam o tempo limite de requisição mais curto em seu caminho de rede, migrar para um modelo de trabalho assíncrono geralmente é mais eficiente do que estender continuamente cada tempo limite. A requisição HTTP inicial pode validar a entrada, criar um trabalho persistente e retornar imediatamente um ID de trabalho. Os workers então executam o grafo multiagente fora do ciclo de vida da requisição, enquanto o cliente recebe o progresso por meio de polling, eventos enviados pelo servidor, WebSockets ou um webhook.
O streaming é útil quando o servidor pode começar a enviar dados relevantes antecipadamente. O SDK Python da OpenAI, por exemplo, oferece suporte ao streaming de eventos enviados pelo servidor para chamadas da API de Respostas. O streaming melhora a percepção de capacidade de resposta e pode manter uma conexão ativa produzindo dados, mas não resolve automaticamente o problema do tempo máximo de vida útil das requisições em todos os proxies. Consulte a documentação oficial da OpenAI sobre streaming de eventos .
Escolha uma tarefa assíncrona quando a durabilidade for mais importante do que a simplicidade imediata: tarefas de pesquisa longas, fluxos de trabalho de agentes com aprovação humana, muitas chamadas de ferramentas, operações dispendiosas que você não deseja repetir ou cargas de trabalho que precisam sobreviver a desconexões do cliente. O custo é o gerenciamento adicional de estado: status da tarefa, pontos de verificação, chaves de idempotência, cancelamento, armazenamento de resultados e propriedade de novas tentativas.
Etapa 7: para fluxos de trabalho longos, acompanhe a conclusão do agente como um estado de fluxo de trabalho persistente, em vez de depender de uma conexão de cliente permanecer aberta até que todos os agentes terminem.
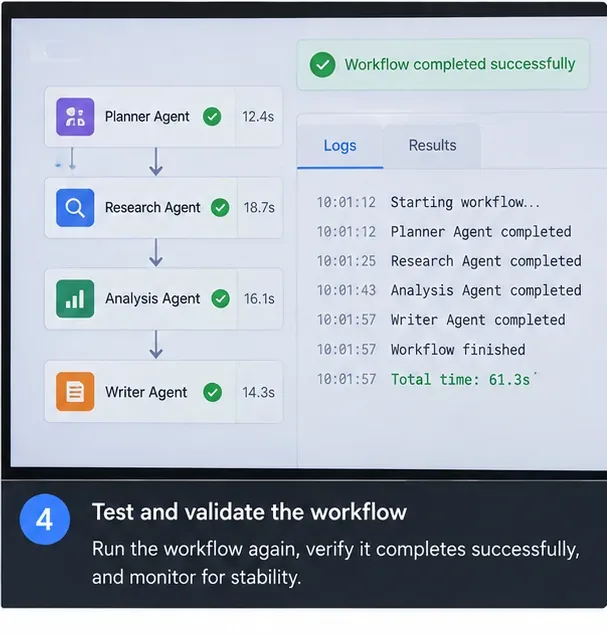
Etapa 8: Valide a correção sob carga realista.
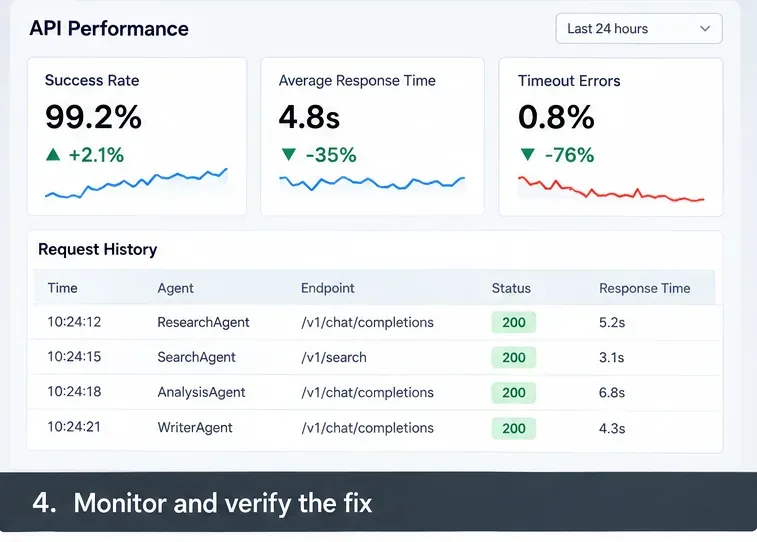
Uma correção não é comprovada apenas porque uma requisição é bem-sucedida. Teste com a simultaneidade esperada em produção e meça a taxa de sucesso, a taxa de timeout, as tentativas de repetição por tarefa lógica, a latência p95 e p99, o atraso na fila, a espera no pool de conexões, as taxas de erros 429/5xx downstream e o custo por fluxo de trabalho concluído.
Se você executa agentes no Kubernetes, use os recursos de readiness e liveness para diferentes finalidades. O Kubernetes documenta as sondagens de readiness como o mecanismo que determina se um Pod deve receber tráfego, enquanto as sondagens de liveness determinam quando um contêiner deve ser reiniciado. Sua documentação alerta explicitamente que verificações de liveness mal implementadas podem causar falhas em cascata sob carga. Consulte a documentação oficial de sondagens do Kubernetes .
Em casos de sobrecarga temporária, tornar-se "indisponível" costuma ser mais seguro do que interromper repetidamente o processamento de trabalhadores saudáveis, porém ocupados. Reserve as falhas de disponibilidade para situações em que reiniciar o processo seja realmente a ação de recuperação adequada.
Etapa 8: verifique a alteração com métricas de tráfego e latência de cauda semelhantes às de produção, e não apenas com uma única execução de teste bem-sucedida.
Como saber qual solução é a correta para o seu padrão de falha?
Padrão observado
A primeira mudança mais útil
O que não fazer primeiro
As chamadas terminam logo após o prazo do cliente; o fluxo de trabalho subsequente está saudável.
Aumente o tempo limite interno específico e redefina o prazo externo.
Aumentar as tentativas
Os erros 429 e os tempos limite de pool aumentam com a concorrência.
Reduzir a concorrência e adicionar enfileiramento/contrapressão.
Lançar mais agentes em paralelo
Ocasionalmente ocorrem erros 408/5xx ou falhas de rede.
Use tentativas de recuperação exponencial limitada para operações idempotentes.
Repetir indefinidamente para cada exceção
O fluxo de trabalho normalmente leva mais tempo do que os limites do gateway.
Utilize uma arquitetura de tarefas assíncronas ou um design de streaming compatível.
Continue aumentando apenas o tempo limite do SDK.
Uma dependência lenta domina a latência p99
Otimize, armazene em cache, substitua ou isole essa dependência; considere uma alternativa.
Ajustar tempos limite de agentes não relacionados
As falhas só aparecem após a adição de agentes paralelos.
Mantenha o paralelismo útil, mas adicione um semáforo global e limites por provedor.
Suponha que o processamento paralelo seja sempre mais rápido.
Uma base de produção prática
Para uma API multiagente típica, uma base sólida consiste em atribuir um ID de correlação a cada fluxo de trabalho, rastrear cada chamada de agente e ferramenta, definir um prazo final de ponta a ponta, atribuir prazos menores por chamada dentro desse prazo, impor um limite de concorrência global por provedor downstream, manter as tentativas limitadas e idempotentes e persistir informações suficientes para retomar ou relatar a conclusão parcial.
Em seguida, faça os ajustes com base nas medições. Se o sistema for estável, mas muito lento, paralelize seletivamente o trabalho independente. Se for rápido com baixa carga, mas falhar com carga máxima, reduza o fan-out e adicione backpressure. Se os fluxos de trabalho bem-sucedidos naturalmente levarem mais tempo do que o caminho de solicitação síncrona permite, mude a arquitetura em vez de tentar fazer com que cada proxy espere mais tempo.