Início
» Domínios
»
Como criar GPTs personalizados que não esquecem seus arquivos de conhecimento
Como criar GPTs personalizados que não esquecem seus arquivos de conhecimento
Situação atual, verificada em 13 de setembro de 2026: A OpenAI informa que contas pessoais do ChatGPT, incluindo as versões Free, Go, Plus e Pro, não podem criar ou publicar novos GPTs. Os GPTs existentes ainda podem ser usados e, quando elegíveis, editados. Nos espaços de trabalho Business, Enterprise e Edu, a criação depende das configurações e permissões do espaço de trabalho. A OpenAI também informa que os fluxos de trabalho de GPTs personalizados estão sendo migrados para plugins, com a migração prevista para 17 de setembro de 2026 e a desativação planejada para os GPTs Enterprise afetados em 11 de dezembro de 2026. Se você estiver lendo isso posteriormente, verifique a situação mais recente na documentação da OpenAI sobre Criação e edição de GPTs antes de criar um novo fluxo de trabalho.
Um GPT personalizado que parece "esquecer" um arquivo de conhecimento geralmente não perdeu o arquivo. As perguntas frequentes sobre uploads de arquivos da OpenAI afirmam que os arquivos enviados como conhecimento para o GPT são retidos até que o GPT personalizado seja excluído. O problema mais comum é a recuperação: o modelo não lê necessariamente todos os arquivos enviados na íntegra para cada pergunta. Ele recupera o material que parece relevante para o enunciado, portanto, a qualidade da fonte, a estrutura do arquivo, as instruções e os testes influenciam se a passagem correta é apresentada.
Além disso, diferencie "conhecimento" de "memória". A documentação do ChatGPT da OpenAI afirma que os GPTs não utilizam memória salva, instruções personalizadas ou conversas anteriores; cada conversa começa do zero. O conhecimento carregado é, portanto, uma fonte de referência configurada, e não uma memória conversacional acumulada de chats anteriores.
Qual deve ser a aparência de um resultado confiável?
O objetivo não é forçar um GPT a mencionar um arquivo a cada interação. O objetivo é fazer com que as respostas dependentes da fonte sejam consistentemente fundamentadas no material correto, enquanto as perguntas sem suporte são corrigidas de forma segura, em vez de gerar um palpite confiante.
Sinal de qualidade
O que significa "bom"
Quando alterar a configuração
Correção
A resposta corresponde ao arquivo oficial da questão testada.
Se a resposta estiver errada, apesar do fato estar presente, simplifique a fonte ou restrinja o enunciado.
Aterramento
O GPT pode nomear o arquivo ou seção de suporte quando solicitado.
Se a resposta for baseada em conhecimento geral, reforce as instruções de prioridade da fonte e repita o teste.
Abstenção
Quando os arquivos não contêm a resposta, o GPT indica isso claramente.
Se a empresa criar uma política, preço, data ou procedimento, adicione uma regra explícita que proíba suposições.
Se pequenas alterações na redação causarem grandes desvios, reduza a ambiguidade tanto nos arquivos quanto nas instruções.
Atualizar integridade
Após a revisão do conteúdo original, as mesmas questões de avaliação refletem o novo conteúdo.
Se as respostas antigas persistirem, verifique se o arquivo atualizado está anexado, salve o GPT e execute os testes novamente.
Oito passos para tornar o uso de arquivos de conhecimento mais confiável
1. Confirme se sua conta ou espaço de trabalho ainda pode criar ou editar o GPT.
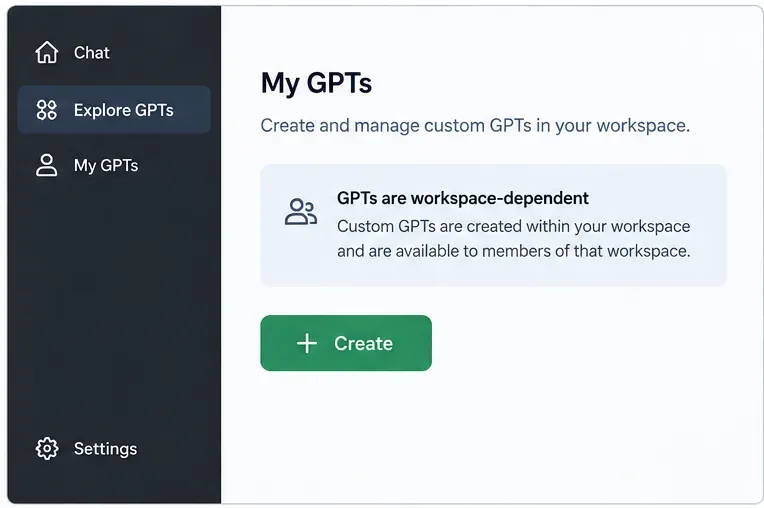
Comece verificando os requisitos de elegibilidade, pois a ausência do botão "Criar" pode agora ser o comportamento esperado, e não um problema do navegador. As diretrizes atuais da OpenAI para GPTs no ChatGPT indicam que a criação de novos GPTs não está disponível para contas pessoais. Espaços de trabalho gerenciados ainda podem permitir a criação de GPTs com base nas políticas de administração e permissões de função. Se você já possui um GPT, verifique se a edição ainda está disponível para sua conta.
Em espaços de trabalho gerenciados elegíveis, comece pela área GPT; a disponibilidade depende das permissões do espaço de trabalho.
Não perca tempo solucionando problemas de recuperação de conhecimento até ter certeza de que está trabalhando em um editor compatível. Se sua organização já está migrando para plugins, considere o GPT personalizado restante como um candidato à migração, em vez de uma nova dependência de longo prazo.
2. Separe as instruções de comportamento do conhecimento.
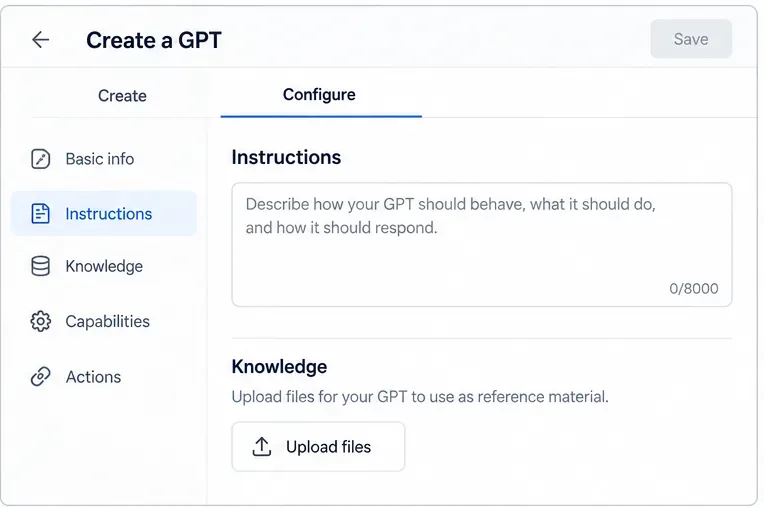
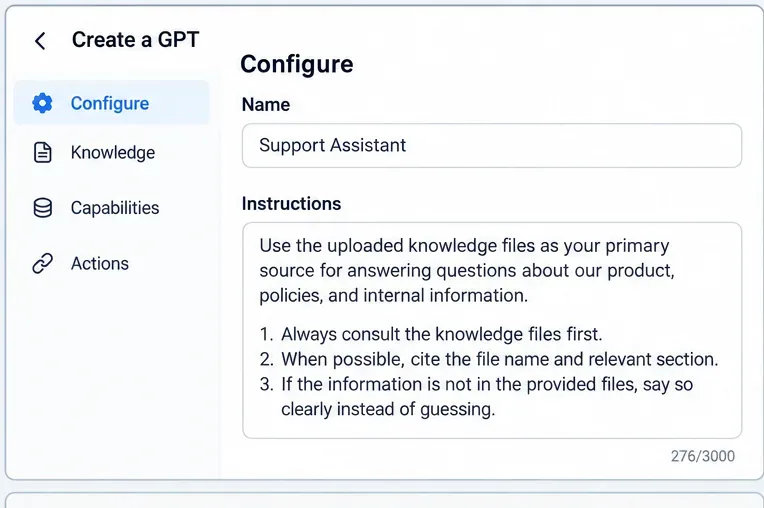
Use o campo Instruções para regras como tom, ordem de decisão, formato de citação, comportamento de escalonamento e o que o GPT deve fazer quando uma fonte não responde. Use Conhecimento para material de referência: manuais, documentação do produto, políticas, perguntas frequentes, especificações ou guias internos. A OpenAI recomenda explicitamente essa separação porque o conhecimento funciona melhor como material de origem, enquanto as instruções definem o comportamento.
Mantenha as regras de comportamento nas Instruções e o material de referência na Área de Conhecimento.
Essa distinção é importante para a confiabilidade. Uma frase como "Nunca cite um preço expirado" pertence às Instruções. A tabela de preços propriamente dita pertence à Base de Conhecimento. Misturar regras em um PDF de referência extenso torna o comportamento mais difícil de controlar e testar.
3. Prepare os arquivos para recuperação, não apenas para leitura humana.
Dê preferência a arquivos claros, com texto conciso, títulos descritivos, seções curtas, terminologia consistente e datas de versão inequívocas. Uma brochura com design atraente pode ser menos eficaz do que um simples arquivo Markdown ou texto se as informações essenciais estiverem espalhadas por colunas, destaques, capturas de tela ou layouts decorativos.
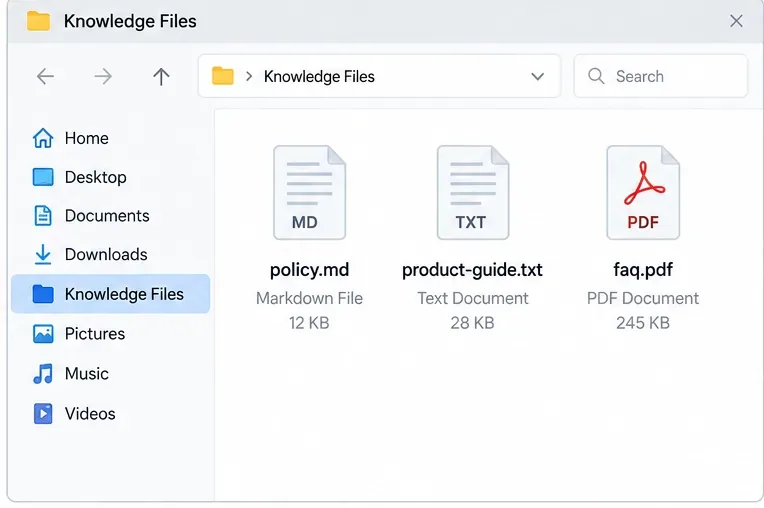
Arquivos com texto predefinido, nomes claros e estrutura simples são mais fáceis de recuperar de forma confiável.
Isso é especialmente importante para PDFs. As perguntas frequentes da OpenAI sobre recuperação visual com PDFs afirmam que os PDFs enviados como conhecimento do GPT são processados com recuperação somente de texto. Em outras palavras, um gráfico, diagrama ou captura de tela dentro do PDF não deve ser o único local onde uma regra crítica existe. Adicione uma explicação em texto ou um arquivo complementar baseado em texto.
Remova também duplicatas obsoletas. Se um arquivo indica um prazo de devolução de 14 dias e outro indica 30 dias, a recuperação do arquivo pode exibir qualquer uma das informações. Nomes de arquivo como returns-policy-2026-09.md e a exibição da "data de vigência" facilitam a auditoria do controle de versões.
4. Carregue um pequeno conjunto de conhecimento coerente e verifique-o.
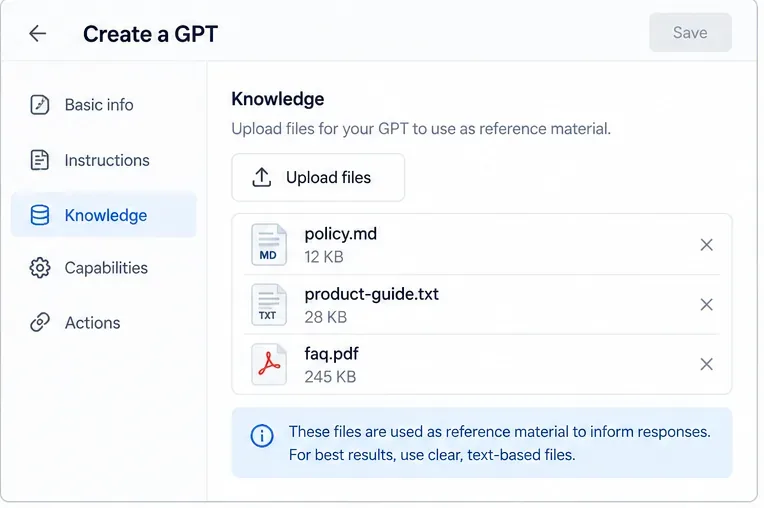
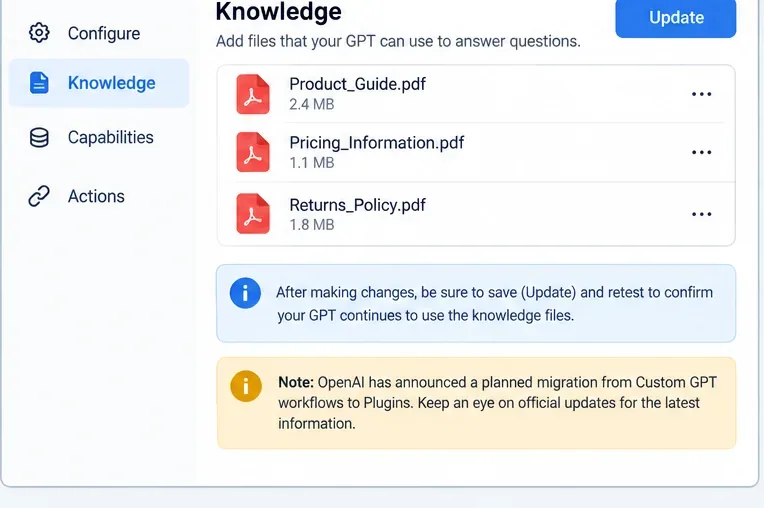
Faça o upload apenas dos arquivos que o GPT realmente precisa. As diretrizes da OpenAI para arquivos corporativos indicam que, em geral, menos documentos, porém mais específicos, melhoram a precisão da recuperação baseada em arquivos. Após o upload, confirme se todos os arquivos esperados aparecem na lista de conhecimento antes de prosseguir.
Faça o upload do conjunto de referência e, em seguida, verifique se todos os arquivos esperados aparecem antes de realizar o teste.
Atualmente, existe uma inconsistência na documentação em relação à quantidade de arquivos. O guia do editor GPT indica que você pode anexar até 20 arquivos a um GPT, enquanto as Perguntas Frequentes sobre Upload de Arquivos mencionam um limite de até 10 arquivos por GPT durante toda a sua duração. Ambos os documentos listam um limite rígido de 512 MB por arquivo, e as Perguntas Frequentes sobre Upload de Arquivos listam um limite de 2 milhões de tokens para arquivos de texto e documentos. Como as páginas oficiais divergem quanto à quantidade de arquivos, não projete um fluxo de trabalho crítico com base no número maior sem antes verificar o editor e a documentação atuais da sua conta.
5. Adicionar instruções orientadas à recuperação
Não confie em instruções vagas como "Use os arquivos enviados". Indique o que deve acontecer quando uma pergunta pertence a um domínio com base em conhecimento específico. Um padrão prático é: consultar primeiro o conhecimento fornecido; dar preferência a ele em relação ao conhecimento geral do modelo para informações específicas da empresa; identificar o arquivo ou seção de suporte quando viável; e informar que a informação não está disponível quando os arquivos não comprovarem a resposta.
As instruções orientadas para a recuperação de informações devem definir a prioridade da fonte, o comportamento da citação e uma alternativa que não exija adivinhação.
As orientações de resolução de problemas da OpenAI recomendam instruções mais específicas que se refiram mais diretamente aos documentos anexados quando o conhecimento não estiver sendo bem utilizado. Também recomendam manter as regras e o comportamento do fluxo de trabalho nas Instruções, em vez de incluí-los nos arquivos enviados. Consulte a seção " Resolução de problemas de GPTs" .
Evite instruções contraditórias. “Sempre responda ao usuário” entra em conflito com “Nunca responda a menos que o arquivo o suporte”. Substitua esse conflito por uma alternativa explícita, como: “Se os arquivos de conhecimento não contiverem o fato necessário, informe que as fontes fornecidas não estabelecem a resposta e sugira a próxima etapa aprovada”.
6. Execute testes de aterramento positivos no Preview.
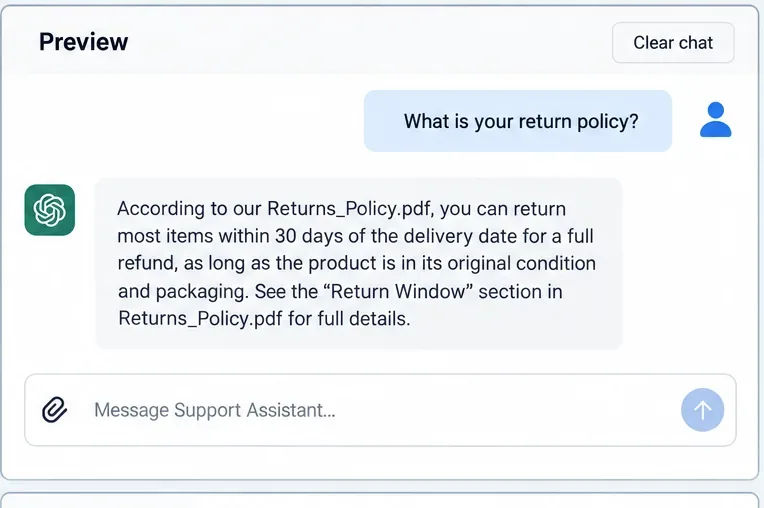
Inclua questões de teste cujas respostas corretas estejam definitivamente presentes nos arquivos. Não teste apenas a frase mais fácil da primeira página. Inclua questões que exijam a consulta de diferentes seções, o reconhecimento de formulações alternativas e a distinção entre políticas semelhantes.
Um teste com resultado positivo indica a resposta correta e identifica o arquivo ou seção de suporte.
Para cada teste, registre a resposta esperada, o arquivo de origem esperado e se o GPT citou ou identificou essa fonte quando solicitado. As diretrizes personalizadas do GPT da OpenAI Academy recomendam a criação de um conjunto de avaliação com aproximadamente 10 a 15 perguntas representativas com respostas corretas. Isso é suficiente para expor padrões de falha recorrentes sem transformar cada edição em um grande projeto de teste.
Avalie a resposta pela sua fundamentação, e não apenas pela sua fluidez. Uma resposta bem elaborada, mas com uma política incorreta, é um fracasso. Uma resposta mais concisa, que cite corretamente o documento normativo, geralmente resulta em um produto melhor.
7. Realize testes negativos e reformule os testes.
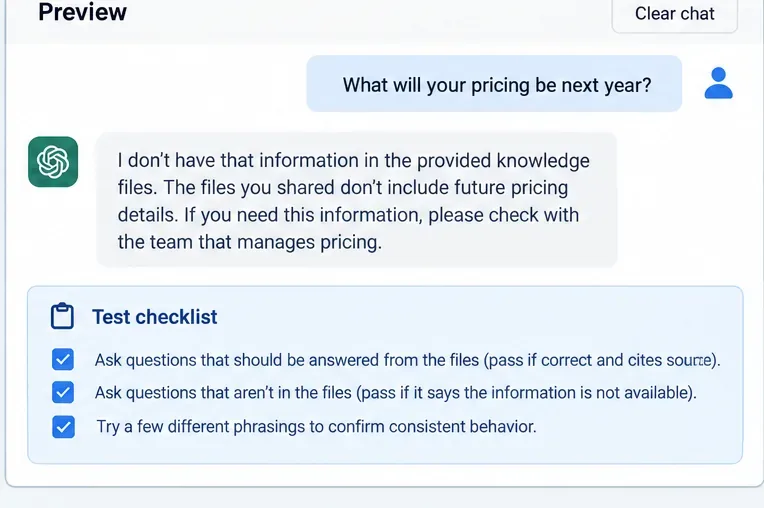
Um assistente de conhecimento confiável deve saber o que não sabe. Faça perguntas que estejam intencionalmente ausentes dos arquivos: um preço futuro, um recurso ainda não lançado, uma política para um país não abrangido pelo manual ou uma data que esteja além do escopo do documento. O resultado desejado é uma limitação clara, não uma invenção plausível.
Os testes negativos são importantes: o GPT deve admitir quando uma resposta não está nos arquivos e manter a consistência em todas as reformulações.
Em seguida, reformule algumas perguntas positivas e negativas de várias maneiras. Se “Qual é o prazo para reembolso?” funcionar, mas “Quanto tempo tenho para devolver o produto?” não, o problema pode ser a abrangência da pesquisa, e não a falta de conhecimento. Melhore os títulos, a terminologia ou as instruções antes de adicionar mais arquivos.
8. Atualizações de versão, novos testes e saber quando o conhecimento estático é a ferramenta errada.
Sempre que você alterar uma fonte, remova a versão obsoleta, anexe a versão atual, salve ou atualize o GPT e execute novamente o mesmo conjunto de avaliação. Manter um pequeno registro de alterações fora do GPT pode ajudar a identificar se uma regressão foi causada por novas instruções, uma fonte substituída ou uma mudança de plataforma.
Após alterar os arquivos de origem ou as instruções, salve a atualização e execute novamente o mesmo conjunto de avaliação.
O conhecimento estático tem limitações. Se a fonte muda constantemente, o acesso precisa refletir as permissões de cada usuário ou o assistente precisa de dados operacionais em tempo real, o upload repetido de arquivos torna-se frágil. A documentação dos aplicativos com sincronização da OpenAI descreve fontes conectadas indexadas que permanecem atualizadas, respeitando as permissões da fonte. A OpenAI também está direcionando os fluxos de trabalho do GPT personalizado para plugins, portanto, uma base de conhecimento que muda frequentemente é uma forte candidata a uma arquitetura conectada ou migrada, em vez de uma pilha crescente de arquivos estáticos.
Como diagnosticar um GPT que ainda "esquece" um arquivo
Se um fato conhecido for omitido, primeiro comprove que ele está de fato presente em um arquivo anexo e atualizado. Em seguida, faça uma pergunta mais específica que mencione o documento ou tópico. Se a pergunta específica funcionar, aprimore os indicadores de recuperação simplificando os títulos, dividindo um documento muito amplo ou removendo versões conflitantes. Se a pergunta específica ainda falhar, converta o material essencial para um texto mais conciso e teste novamente.
Não resolva imediatamente cada falha adicionando mais instruções. Regras excessivas ou conflitantes podem tornar o comportamento menos previsível. Da mesma forma, não adicione mais arquivos até ter certeza de que o conjunto existente está correto. O sinal de qualidade desejado é a repetibilidade: o mesmo pequeno conjunto de avaliação deve ser aprovado após cada alteração, especialmente para questões de alto risco relacionadas a políticas, aspectos legais, preços ou operações.
O limite prático: você pode melhorar a recuperação, mas não garanti-la.
Nenhum comando consegue fazer com que um modelo generativo consulte todos os arquivos de conhecimento para cada resposta com absoluta certeza. Portanto, um GPT personalizado confiável é um fluxo de trabalho projetado, não um upload único: arquivos de origem focados, instruções explícitas de prioridade de origem, um comportamento de abstenção definido e avaliação repetível. Se esses controles ainda não atenderem à precisão ou à atualização necessárias, altere a arquitetura em vez de continuar ajustando a mesma configuração estática.
Para GPTs elegíveis, esse processo pode reduzir substancialmente o problema de "esqueceu meu arquivo". No entanto, para novos trabalhos iniciados no final de 2026, a decisão a longo prazo também deve levar em conta a transição anunciada pela OpenAI de fluxos de trabalho GPT personalizados para plugins e a disponibilidade de fontes de conhecimento conectadas.