Início
» Domínios
»
Como criar um agente automatizado de processamento de faturas usando IA de código aberto
Como criar um agente automatizado de processamento de faturas usando IA de código aberto
Um agente automatizado de processamento de faturas não precisa começar como um grande sistema autônomo de IA. Para uma primeira versão útil, pense em um agente como um fluxo de trabalho de software controlado que recebe uma fatura, aciona as ferramentas de documento e IA corretas, valida o resultado, decide se um humano precisa revisá-lo e somente então salva ou exporta os dados aprovados.
Essa distinção é importante em finanças. Um modelo de linguagem pode ajudar a transformar layouts de faturas complexos em campos estruturados, mas não deve ser o único fator a determinar se uma fatura é válida ou segura para lançamento. O design intuitivo deste guia mantém a extração probabilística e as verificações contábeis importantes determinísticas.
Ao final, você terá um protótipo local que aceita faturas em PDF ou imagem, extrai campos como fornecedor, número da fatura, datas, moeda, totais e itens de linha, valida esses campos de acordo com regras, encaminha documentos questionáveis para revisão, armazena um registro de auditoria e expõe o processo por meio de uma API.
O que você precisa entender antes de começar?
Existem quatro termos que vale a pena conhecer:
O OCR (reconhecimento óptico de caracteres) transforma o texto visível em uma imagem ou digitalização em texto legível por máquina.
A análise sintática de documentos preserva mais estrutura do que o OCR simples, como ordem de leitura, tabelas, cabeçalhos e regiões de layout.
O LLM (modelo de linguagem de grande porte) consegue mapear textos variáveis de faturas em uma estrutura JSON consistente.
A intervenção humana significa que o sistema para e pede a uma pessoa para rever os casos que falham nas verificações, em vez de presumir que todos os resultados estão corretos.
Em setembro de 2026, vários projetos de código aberto com manutenção ativa abrangiam essas camadas. O Docling oferece suporte a PDF, imagens, documentos do Office e outros formatos de documento; o PaddleOCR fornece fluxos de trabalho de OCR e compreensão de documentos e é distribuído sob a licença Apache 2.0; e o projeto Tesseract documenta sua versão 5.x atual como um mecanismo de OCR de código aberto no manual oficial do Tesseract .
Para inferência de modelos locais, a documentação do servidor llama.cpp descreve endpoints compatíveis com OpenAI e saída JSON com restrições de esquema. Isso o torna útil para um serviço de extração, pois permite solicitar que um modelo hospedado localmente retorne um objeto definido em vez de um texto genérico.
Um aviso importante sobre licenciamento: um mecanismo de inferência de código aberto não torna automaticamente todos os pesos do modelo de código aberto. Verifique a licença do modelo específico que você implanta, especialmente para uso comercial.
Qual conjunto de ferramentas um iniciante deve usar?
Camada
Escolha prática
Por que está aqui?
Conversão de documentos
Docling
Converte PDFs e imagens em uma representação de documento estruturada e texto exportável.
Recurso alternativo de OCR
PaddleOCR ou Tesseract
Útil quando a fatura é uma digitalização ou foto e a extração de texto requer OCR.
Extração local de IA
llama.cpp + um modelo de instrução adequado
Mapeia o texto variável da fatura para um esquema JSON estável, mantendo a inferência local.
Validação de esquema
Pydantic
Valida os dados do Python em relação aos tipos de campo e restrições declarados.
API
FastAPI
Aceita o envio de faturas e retorna os resultados do processamento.
Armazenar
SQLite para um protótipo; PostgreSQL para um serviço compartilhado.
Armazena dados normalizados, status de revisão, identidade do arquivo de origem e eventos de auditoria.
Uma função determinística é mais fácil de depurar. Adicione uma estrutura de agentes com estado quando o ramificação e a revisão humana se tornarem mais complexos.
A documentação oficial do Pydantic explica que os modelos herdam de `PydanticModel` BaseModel, validam os dados recebidos e podem emitir JSON Schema por meio de `PydanticModel` model_json_schema(). Consulte Validação de modelo do Pydantic . Se posteriormente você precisar de ramificação com estado e de longa duração, a referência do LangGraph descreve o suporte para agentes com estado de longa duração, persistência e fluxos de trabalho com intervenção humana.
Etapa 1: Configure o projeto e defina um primeiro objetivo específico.
Não comece com "automatizar contas a pagar". Comece com uma classe de documento e um contrato de saída. Um bom MVP (Produto Mínimo Viável) inclui: faturas de fornecedores em inglês, entrada de PDF ou imagem, uma entidade legal, uma moeda definida e nenhuma execução automática de pagamentos.
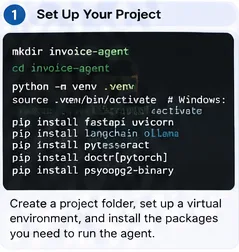
Instale seu mecanismo de OCR separadamente, se necessário. O guia de instalação atual do Docling utiliza pip install doclingo pacote básico de OCR do PaddleOCR, enquanto a documentação de instalação atual distingue esse pacote dos grupos de dependências opcionais de análise de documentos e extração de informações. Utilize o guia de instalação do Docling ou o guia de instalação do PaddleOCR 3.x em vez de copiar uma lista de dependências antiga.
Passo 1: Primeiro, crie um pequeno projeto Python isolado. Mantenha o primeiro tipo de fatura e o esquema de saída suficientemente restritos para permitir testes completos.
Etapa 2: Converter faturas em texto e dados de layout
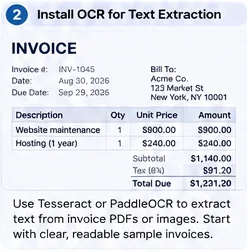
Os PDFs nativos podem já conter texto utilizável. PDFs digitalizados e fotos requerem OCR. Seu analisador deve ocultar essa diferença do restante do fluxo de trabalho: os estágios posteriores devem receber o texto do documento normalizado, além de quaisquer informações úteis de layout ou tabela.
Uma conversão mínima para Docling se parece com isto:
from docling.document_converter import DocumentConverter

converter = DocumentConverter()

def parse_document(path: str) -> str:
    result = converter.convert(path)
    return result.document.export_to_markdown()
O guia de início rápido oficial do Docling usa o mesmo padrão de conversão e exportação. Para coleções com grande volume de OCR, teste o PaddleOCR ou o Tesseract em suas próprias digitalizações. A documentação do projeto PaddleOCR recomenda sua família mais recente, PP-StructureV3, para análise de documentos, enquanto o Tesseract pode ser chamado pela linha de comando ou API para OCR de texto impresso.
Etapa 2: Comece com faturas de amostra legíveis que contenham os campos que você planeja extrair e, em seguida, adicione análises mais complexas somente depois que o fluxo de trabalho básico estiver funcionando.
Etapa 3: Decida exatamente quais dados o agente está autorizado a produzir.
O esquema de extração é o contrato entre a IA e a lógica contábil. Evite um esquema gigantesco que inclua "tudo o que possa aparecer em uma fatura". Comece com campos que você possa validar.
from datetime import date
from decimal import Decimal
from pydantic import BaseModel, Field, ConfigDict

class LineItem(BaseModel):
    description: str
    quantity: Decimal | None = None
    unit_price: Decimal | None = None
    amount: Decimal

class Invoice(BaseModel):
    model_config = ConfigDict(extra="forbid")

    vendor_name: str
    invoice_number: str
    invoice_date: date
    due_date: date | None = None
    currency: str = Field(min_length=3, max_length=3)
    subtotal: Decimal | None = None
    tax: Decimal | None = None
    total: Decimal
    line_items: list[LineItem] = []
extra="forbid"É útil neste contexto porque campos LLM inesperados não devem ser incorporados silenciosamente ao seu registro contábil. Observe também que a validação do Pydantic confirma a estrutura e os tipos; ela não comprova que o fornecedor ou o valor extraídos correspondem à imagem da fatura.
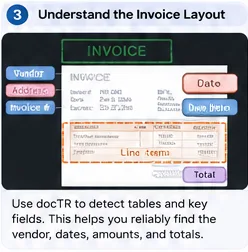
Etapa 3: Defina os campos de destino com base nas necessidades do negócio e, em seguida, use o layout e as informações da tabela para preservar a origem desses valores.
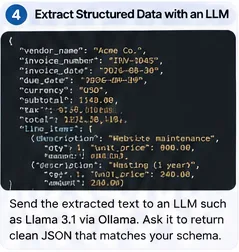
Etapa 4: Use um modelo local para mapear o texto do documento em JSON estruturado.
Execute um modelo de instruções adequado por trás do servidor HTTP do llama.cpp. O tamanho exato do modelo depende do seu hardware e da complexidade da fatura. Não assuma que um modelo maior seja automaticamente melhor; avalie a precisão dos campos, a latência e o uso de memória no seu próprio conjunto de faturas.
O llama.cpp atualmente suporta respostas JSON com restrições de esquema. Você pode derivar esse esquema do Pydantic e enviá-lo com a solicitação de extração:
import json
import httpx

def extract_invoice(document_text: str) -> Invoice:
    schema = Invoice.model_json_schema()

    prompt = f"""
Extract one supplier invoice from the text below.
Do not invent values. If an optional field is absent, use null.
Currency must be a three-letter code.
Return only data that fits the required schema.

DOCUMENT:
{document_text}
"""

    payload = {
        "model": "local-model",
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0,
        "response_format": {
            "type": "json_schema",
            "schema": schema
        }
    }

    r = httpx.post(
        "http://127.0.0.1:8080/v1/chat/completions",
        json=payload,
        timeout=120
    )
    r.raise_for_status()

    content = r.json()["choices"][0]["message"]["content"]
    return Invoice.model_validate_json(content)
A geração com restrições de esquema ajuda a obter uma estrutura válida, mas não garante a veracidade semântica. Um objeto JSON perfeitamente válido ainda pode conter um total incorreto. É por isso que a próxima etapa é obrigatória.
Etapa 4: Solicite ao modelo local um objeto estritamente estruturado, e não um texto livre, para que a validação subsequente receba campos previsíveis.
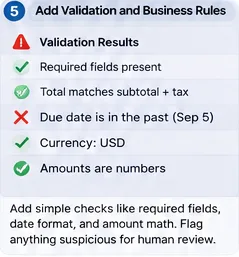
Etapa 5: Adicionar verificações contábeis determinísticas e regras de revisão
Não pergunte ao analista de software "Você está confiante?" e confie na resposta. A autodeclaração de confiança no modelo não é um controle calibrado. Crie verificações que possam ser recalculadas a partir dos dados extraídos e dos seus sistemas.
Algumas regras iniciais úteis incluem:
Os campos obrigatórios estão presentes;
O número da fatura ainda não está registrado para o mesmo fornecedor;
A moeda é permitida para esse fornecedor ou entidade;
Os valores dos itens da linha somam aproximadamente o subtotal;
O subtotal mais o imposto é aproximadamente igual ao total;
A data da fatura e a data de vencimento são plausíveis;
O fornecedor já existe no seu cadastro de fornecedores ou está encaminhado para integração;
As referências dos pedidos de compra correspondem quando a correspondência de pedidos de compra é necessária.
from decimal import Decimal

def validate_business_rules(inv: Invoice) -> list[str]:
    errors = []

    if inv.subtotal is not None and inv.tax is not None:
        expected = inv.subtotal + inv.tax
        if abs(expected - inv.total) > Decimal("0.02"):
            errors.append("subtotal_plus_tax_does_not_match_total")

    line_sum = sum((x.amount for x in inv.line_items), Decimal("0"))
    if inv.subtotal is not None and abs(line_sum - inv.subtotal) > Decimal("0.02"):
        errors.append("line_items_do_not_match_subtotal")

    if inv.due_date and inv.due_date < inv.invoice_date:
        errors.append("due_date_before_invoice_date")

    return errors
Direcione todas as verificações com falha para uma fila de revisão. Para uma primeira implementação, é razoável direcionar todas as faturas para revisão enquanto você avalia a qualidade da extração. Os limites de automação devem ser baseados em evidências coletadas em suas próprias faturas etiquetadas, e não em uma porcentagem genérica copiada de outro sistema.
Etapa 5: Trate as regras de aritmética, detecção de duplicados, correspondência de fornecedores e datas como controles determinísticos; encaminhe as exceções para uma pessoa.
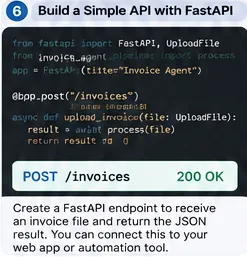
Etapa 6: Encapsule o processador em uma pequena API
Uma API permite que um formulário de upload, um sistema de envio de e-mail, um monitor de pastas compartilhadas ou uma integração contábil chamem a mesma função de processamento. O guia oficial de upload de arquivos da FastAPI recomenda UploadFileo uso de um arquivo de spool para arquivos enviados e observa que ele é mais adequado do que carregar arquivos grandes inteiramente na memória.
from pathlib import Path
from tempfile import NamedTemporaryFile
from fastapi import FastAPI, UploadFile, HTTPException

app = FastAPI()

@app.post("/invoices")
async def process_upload(file: UploadFile):
    if file.content_type not in {
        "application/pdf",
        "image/png",
        "image/jpeg"
    }:
        raise HTTPException(415, "Unsupported file type")

    suffix = Path(file.filename or "").suffix

    with NamedTemporaryFile(suffix=suffix, delete=False) as tmp:
        tmp.write(await file.read())
        path = tmp.name

    result = process_invoice(path)
    return result
Consulte a documentação atual do FastAPI sobre requisições de arquivos para obter informações sobre os padrões de upload suportados. Em produção, também é importante impor limites de tamanho de arquivo, verificação de malware quando apropriado, autenticação de usuários, IDs de requisição e limpeza segura de arquivos temporários.
Etapa 6: Exponha um ponto de extremidade de processamento após a conclusão do pipeline local, para que vários canais de entrada possam reutilizar o mesmo caminho de validação.
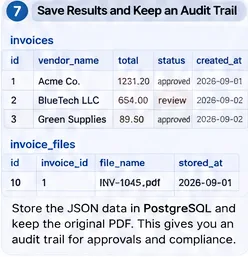
Etapa 7: Armazene as evidências originais, o resultado normalizado e os eventos de auditoria.
Nunca armazene apenas o JSON final. Mantenha evidências suficientes para reconstruir o que aconteceu: identidade do arquivo original, hash, versão do analisador sintático, identificador do modelo, versão do prompt, JSON extraído, resultados da validação, decisão de revisão, registros de data e hora e o usuário ou serviço que aprovou a alteração.
Um protótipo simples pode usar SQLite. Um serviço multiusuário pode usar PostgreSQL com restrições de unicidade e chave estrangeira. A documentação atual do PostgreSQL aborda restrições de tabela , que são úteis para proteger chaves e relacionamentos independentemente do pipeline de IA.
CREATE TABLE invoices (
    id BIGSERIAL PRIMARY KEY,
    vendor_id BIGINT NOT NULL,
    invoice_number TEXT NOT NULL,
    invoice_date DATE NOT NULL,
    currency CHAR(3) NOT NULL,
    total NUMERIC(18,2) NOT NULL,
    status TEXT NOT NULL,
    source_sha256 TEXT NOT NULL,
    extracted_json JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (vendor_id, invoice_number)
);
O hash de origem oferece uma segunda maneira de detectar reenvios acidentais. Mantenha as permissões de armazenamento de arquivos mais restritivas do que as dos logs gerais do aplicativo, pois as faturas geralmente contêm endereços, dados bancários, números de identificação fiscal e outras informações comerciais confidenciais.
Etapa 7: Mantenha os dados normalizados da fatura e os metadados do arquivo de origem para que as aprovações, duplicatas e correções posteriores permaneçam auditáveis.
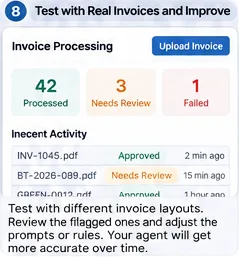
Etapa 8: Teste com variações reais de faturas antes de automatizar as ações subsequentes.
Um protótipo que funciona com cinco PDFs limpos não está pronto para produção. Crie um conjunto de avaliação rotulado que represente as entradas que você realmente recebe: diferentes fornecedores, digitalizações, páginas rotacionadas, fontes pequenas, faturas com várias páginas, descontos, linhas negativas, impostos, custos de envio, múltiplas moedas, pedidos de compra ausentes e envios duplicados.
Monitore as métricas de nível de campo separadamente. A "precisão da fatura" pode mascarar o fato de que o nome do fornecedor é fácil de verificar, enquanto a quantidade do item de linha não é confiável. No mínimo, meça:
Precisão exata na correspondência do número da fatura, moeda e datas;
Precisão da tolerância numérica para subtotal, imposto e total;
Precisão e revocação de itens de linha, caso os itens de linha sejam relevantes posteriormente;
Percentagem encaminhada para revisão humana;
taxa de aprovação automática falsa;
latência de processamento e taxa de falhas;
Precisão na detecção de duplicados.
Armazene as falhas como casos de teste. Sempre que corrigir uma regra de análise sintática, um prompt, um esquema ou um modelo, execute novamente todo o conjunto de avaliação. Isso evita que a melhoria de um fornecedor quebre silenciosamente o layout de outro.
Etapa 8: Meça a fila de revisão e os casos de falha em faturas representativas antes de permitir que o agente automatize ações contábeis subsequentes.
Como o agente deve decidir o que acontece a seguir?
Mantenha a máquina de estados explícita. O "agente" pode ser uma função Python simples inicialmente:
Isso já se assemelha a um agente, pois coordena ferramentas e escolhe um caminho. Você não precisa de um LLM para escolher cada próximo passo. Adicione o LangGraph ou outra estrutura de orquestração quando precisar de revisões persistentes em vários estágios, novas tentativas, retornos de chamada assíncronos ou várias ferramentas especializadas cuja ordem de execução varia de acordo com o caso.
Que erros os iniciantes devem evitar?
Deixar que o LLM seja o controle contábil
O modelo deve extrair e normalizar os dados; o código e os dados confiáveis do sistema devem ser verificados. Cálculos aritméticos, verificações de duplicatas, status do fornecedor, correspondência de pedidos de compra e limites de aprovação pertencem à lógica determinística.
Descartar o documento original após a extração.
Guarde a fatura original ou uma referência controlada a ela. Os revisores precisam de evidências, e você precisa de uma maneira de reproduzir as falhas após atualizações do modelo ou do analisador sintático.
Usando um único prompt sem uma versão
Armazene uma versão de prompt e um identificador de modelo com cada fatura processada. Caso contrário, você não poderá explicar por que duas faturas processadas com meses de diferença se comportaram de maneira diferente.
Publicação automática de todos os resultados válidos de acordo com o esquema.
A validade do JSON não é a mesma que a validade da fatura. Comece com uma revisão humana e, em seguida, automatize apenas os casos de baixo risco após a sua avaliação demonstrar um desempenho aceitável.
Ignorando licenças de modelo e dados
Bibliotecas e pesos de modelos podem ter licenças diferentes. PaddleOCR e Tesseract publicam licenças de código aberto, enquanto a licença do modelo que você executa por meio do llama.cpp depende desse ponto de verificação específico. Confirme-a antes da implantação.
Construir a interface do usuário antes de comprovar a qualidade da extração.
Um painel de controle impecável não compensa erros. Teste primeiro a análise sintática de documentos, a extração de esquemas e a validação; adicione uma interface de revisão depois de saber o que os revisores realmente precisam ver.
Quando você deve usar apenas OCR, modelos de layout ou um LLM?
Abordagem
Melhor ajuste
Principal limitação
OCR + regras
Um pequeno número de modelos de fornecedores altamente estáveis.
As regras tornam-se frágeis à medida que os layouts variam.
Modelo de layout de documento
Tabelas, formulários e campos onde a posição importa.
Pode ser necessário treinamento específico para a tarefa ou pós-processamento.
OCR/analisador de documentos + mestrado em direito local
Vários formatos de fatura com um esquema de destino comum
Deve ser restringido e validado; a inferência exige mais poder computacional.
Modelo de visão-linguagem
Documentos complexos onde o texto e o layout visual estão intimamente ligados.
Requisitos de hardware mais elevados e maior complexidade de avaliação.
A documentação atual do LayoutLMv3 da Hugging Face descreve um modelo de IA para documentos que combina informações de texto e layout visual. A documentação do PP-StructureV3 da PaddleOCR também se concentra em layout, tabelas e análise estruturada de documentos. Essas são opções para quando texto simples mais um modelo LLM não são suficientes.
Qual é o caminho sensato do protótipo à produção?
Avance por etapas. Primeiro, execute localmente em uma pasta com faturas etiquetadas. Segundo, adicione a API e o armazenamento persistente. Terceiro, introduza uma fila de revisão humana. Quarto, integre consultas somente leitura, como cadastro de fornecedores ou pedidos de compra. Quinto, permita a exportação controlada para uma área de preparação contábil. Somente após o monitoramento comprovar a eficácia dos controles, considere a contabilização automática para casos de baixo risco bem definidos.
Em cada etapa, preserve três coisas: evidências (o documento original e a fonte extraída), determinismo (regras de negócio que podem ser executadas novamente) e rastreabilidade (qual analisador, modelo, solicitação e revisor produziu o registro final).
Lista de verificação final
O analisador de faturas funciona tanto com PDFs nativos digitais quanto com as digitalizações que você recebe.
O resultado da extração é limitado a um esquema Pydantic versionado.
O modelo não pode inventar valores ausentes.
Totais, datas, duplicados, identidade do fornecedor e regras de pedidos de compra são validados fora do LLM.
Regras que não forem cumpridas geram um estado de revisão humana em vez de correção automática.
O documento original, o hash de origem, o modelo, a versão do prompt e o resultado da validação são registrados.
A API restringe o tipo e o tamanho dos arquivos e exige autenticação antes do uso em produção.
Seu conjunto de testes contém variações reais de layout e casos extremos.
As licenças do modelo e da biblioteca foram verificadas para a sua implementação pretendida.
Os lançamentos contábeis subsequentes são introduzidos gradualmente e permanecem auditáveis.
Se esses controles estiverem implementados, você terá mais do que uma demonstração de OCR: terá a base de um agente de processamento de faturas confiável. Os componentes de código aberto podem mudar com o tempo, mas a arquitetura permanece robusta: analisar as evidências, extraí-las para um esquema, validá-las com código, encaminhar as dúvidas para as pessoas responsáveis e registrar cada decisão.