Início
» Domínios
»
Guia passo a passo: automatizando o monitoramento semanal de concorrentes usando agentes de IA
Guia passo a passo: automatizando o monitoramento semanal de concorrentes usando agentes de IA
O monitoramento de concorrentes frequentemente falha por uma razão simples: a pesquisa está espalhada por muitas abas, muitas pessoas e muitas definições do que conta como uma mudança significativa. Uma pessoa verifica as páginas de preços, outra observa as notas de lançamento, alguém escaneia as notícias do setor e, na sexta-feira, a equipe tem uma pilha de links, mas nenhuma resposta confiável para a pergunta que importa: o que mudou esta semana e isso é relevante?
Um agente de IA pode reduzir esse trabalho manual, mas o agente é apenas uma parte do sistema. Um fluxo de trabalho semanal confiável também precisa de uma lista de fontes, um formato de evidência, uma linha de base da semana anterior, um agendador e uma etapa de revisão humana. Se você pular essas peças, pode automatizar o ruído com a mesma eficiência que a percepção.
Este guia constrói o fluxo de trabalho das decisões mais fáceis às mais técnicas. A implementação concreta usa o atual OpenAI Agents SDK e o GitHub Actions porque sua documentação oficial suporta busca na web, saídas estruturadas, rastreamento e fluxos de trabalho agendados. A arquitetura em si é neutra em relação ao fornecedor: você pode substituir qualquer componente se outro tempo de execução de agentes ou agendador se ajustar melhor à sua pilha tecnológica.
O que um agente de monitoramento semanal de concorrentes deve realmente fazer?
No mínimo, o sistema deve responder a quatro perguntas: o que mudou, de onde veio a evidência, como a mudança difere do último estado conhecido e se uma pessoa deve se importar. "Agente de IA" aqui significa um fluxo de trabalho baseado em LLM que tem instruções e ferramentas e pode executar uma sequência de ações em direção a um objetivo. O atual Agents SDK da OpenAI descreve os agentes dessa mesma maneira geral: um modelo configurado com instruções, ferramentas e comportamento opcional de tempo de execução, como guardrails e saídas estruturadas. Veja a documentação oficial do OpenAI Agents SDK.
Não projete a primeira versão para "monitorar tudo". Comece com um escopo pequeno que você ainda possa auditar manualmente. Depois de confiar no pipeline, amplie-o.
Etapa 1: Defina os concorrentes, sinais e perguntas semanais
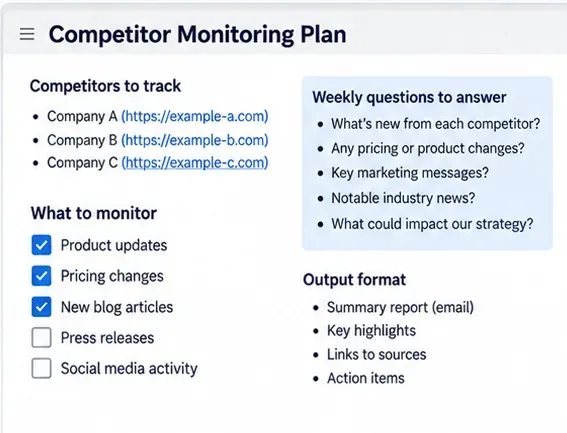
Crie um resumo de monitoramento antes de escrever qualquer código de agente. Para cada concorrente, decida quais mudanças valem a pena relatar. Sinais típicos incluem mudanças de preços públicos, lançamentos de produtos, notas de lançamento, novas integrações, mudanças de posicionamento, atualizações importantes de documentação, parcerias públicas, anúncios executivos e principais padrões de contratação. A lista exata deve corresponder às decisões que sua equipe realmente toma.
Um resumo útil separa sinais de perguntas. "Página de preços mudou" é um sinal. "O novo plano torna o concorrente mais atraente para equipes pequenas?" é uma pergunta analítica. O agente deve coletar o primeiro e raciocinar sobre o segundo apenas depois de ter evidências.
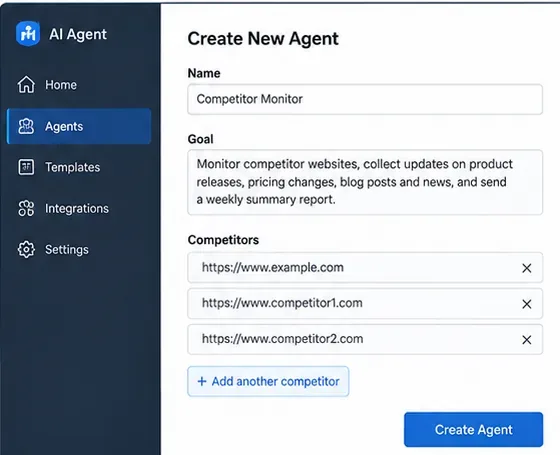
Ilustração conceitual gerada por IA de um resumo de monitoramento; não é uma captura de tela de um produto real.
Para uma primeira execução semanal, escreva uma frase que defina o sucesso. Por exemplo: "Até a manhã de segunda-feira, produza um resumo vinculado a fontes de mudanças materiais dos últimos sete dias para cinco concorrentes nomeados, sem alegações não fundamentadas." Essa frase se torna um teste de aceitação prático mais tarde.
Etapa 2: Construa um registro de fontes em vez de depender de busca aberta
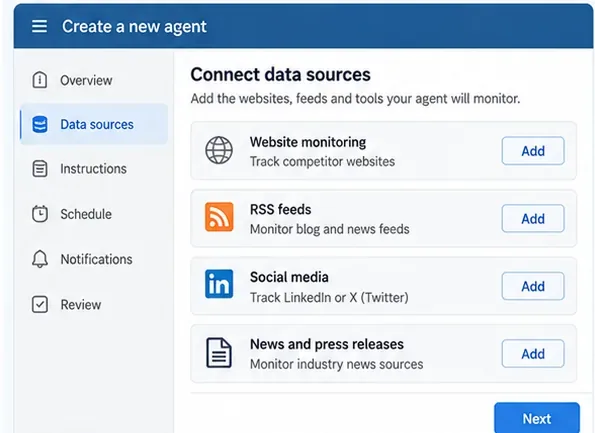
A busca na web é útil para descoberta, mas um sistema de monitoramento não deve depender apenas dos rankings de busca. Construa um pequeno registro de fontes com campos como concorrente, tipo de fonte, URL, prioridade, frequência esperada de atualização e qual pergunta a fonte pode responder.
Sinal
Fonte preferida
Por que é útil
Preços
Páginas oficiais de preços e planos
Fonte mais próxima da oferta comercial atual
Mudanças de produto
Notas de lançamento, changelog, blog de produto
Geralmente fornece datas e contexto de recursos
Posicionamento
Página inicial, páginas de produto, páginas de campanha
Mostra como a empresa apresenta o produto
Notícias corporativas
Sala de imprensa e blog da empresa
Útil para parcerias, financiamento, liderança e lançamentos
Contexto de mercado
Fontes de notícias públicas respeitáveis
Adiciona contexto independente às alegações de primeira mão
Prefira páginas públicas, feeds oficiais, APIs documentadas e fontes que você está autorizado a acessar. Não projete o agente para contornar logins, paywalls, restrições de robots ou controles de acesso. Para plataformas sociais, prefira APIs oficiais ou feeds públicos onde disponíveis, em vez de raspagem frágil.
Ilustração conceitual gerada por IA de um registro de fontes; use apenas fontes que você tem permissão para acessar.
O atual Agents SDK da OpenAI inclui uma WebSearchTool hospedada para agentes que usam modelos OpenAI Responses. A documentação oficial da ferramenta também distingue a busca na web hospedada de ferramentas de função locais, o que é útil se você quiser que o agente chame seu próprio buscador de URL, banco de dados, leitor RSS ou serviço de detecção de mudanças. Veja o guia oficial de ferramentas do Agents SDK.
Etapa 3: Defina o esquema de evidência antes de pedir ao modelo para resumir
A maneira mais fácil de obter relatórios semanais inconsistentes é pedir por "um resumo das notícias dos concorrentes". Em vez disso, defina uma descoberta estruturada. No mínimo, cada descoberta deve conter o concorrente, categoria, data observada, resumo curto, URL da fonte, trecho de evidência ou nota da fonte e uma flag de confiança ou revisão.
Adicione campos para previous_state e current_state quando o sinal puder ser comparado diretamente, como preço de plano, disponibilidade de recurso, título ou integração documentada. Isso torna o relatório sobre mudança em vez de sobre o que o modelo encontrou naquela semana.
A saída estruturada também torna o fluxo de trabalho mais fácil de testar. O Agents SDK atualmente suporta um output_type em um agente, e a documentação oficial recomenda tipos Python normais, como modelos Pydantic ou dataclasses, para resultados estruturados. Veja o guia oficial de configuração de agentes.
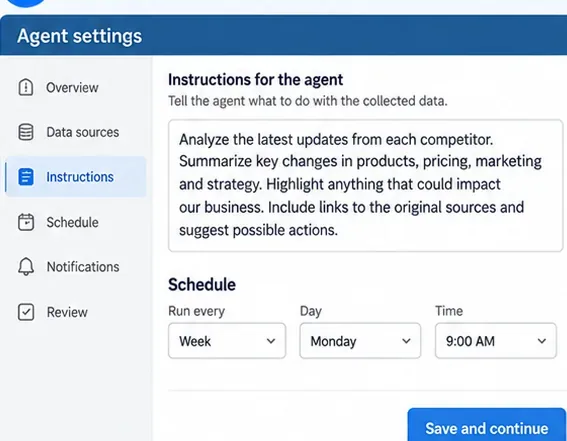
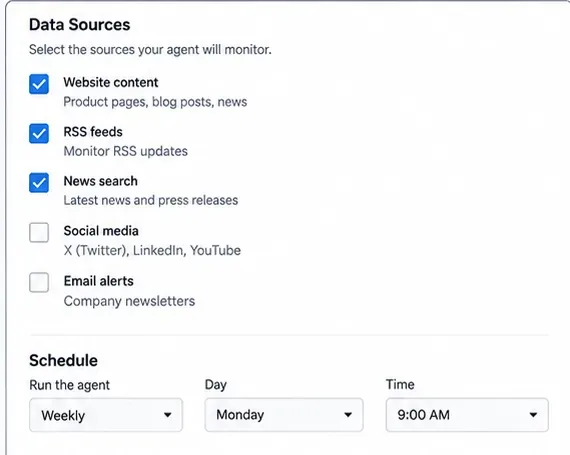
Ilustração conceitual gerada por IA de instruções de agente e agendamento; não é uma interface de produto real.
O último campo é importante. Um bom sistema de monitoramento deve ser capaz de dizer "nenhuma mudança material encontrada" em vez de fabricar uma atualização para preencher espaço.
Etapa 4: Execute um piloto manual antes de automatizar qualquer coisa
Execute o fluxo de trabalho manualmente por um período de relatório e compare o resultado com sua própria revisão das mesmas fontes. Esse piloto revela problemas que são mais difíceis de notar após o agendamento: resultados de busca obsoletos, histórias duplicadas, uma taxonomia de categoria pouco clara, inferências não fundamentadas, URLs de fontes ausentes e descobertas que são tecnicamente novas, mas estrategicamente irrelevantes.
Para cada descoberta proposta, pergunte: a fonte é de primeira mão ou independentemente respeitável, a mudança está dentro da janela de data pretendida, posso apontar para a evidência exata e o mesmo item seria relatado novamente na próxima semana se nada mudar? Se a resposta para a última pergunta for sim, você ainda precisa de uma linha de base ou regra de deduplicação.
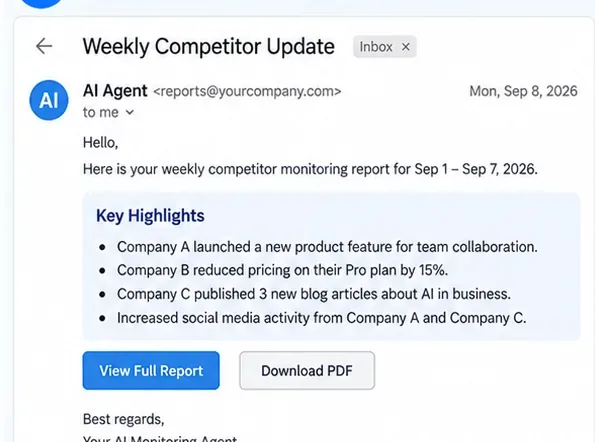
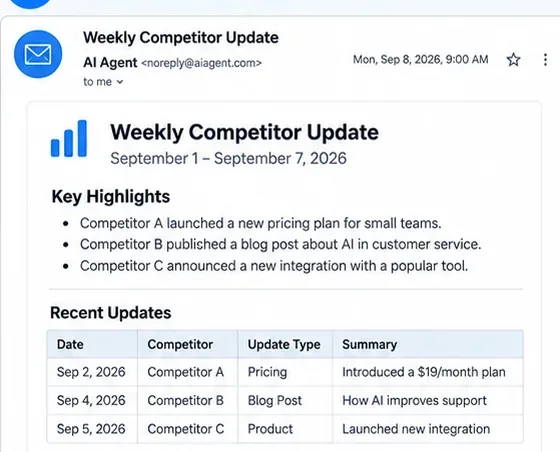
Ilustração conceitual gerada por IA de um relatório de piloto manual com links de evidência.
Não trate trechos de busca como o registro de evidência. Armazene a URL da fonte e, onde seus termos e direitos de acesso permitirem, um instantâneo normalizado ou texto extraído usado para comparação. A busca deve ajudar a localizar evidências; não deve se tornar um substituto para evidências.
Etapa 5: Implemente o agente com busca na web, saída estruturada e uma linha de base
Depois que o piloto manual produzir descobertas úteis, integre o agente ao código. A partir de setembro de 2026, o Python Agents SDK da OpenAI pode combinar um Agent, WebSearchTool hospedada e output_type estruturado. O exemplo a seguir é intencionalmente pequeno: demonstra a camada de agente, não a camada de armazenamento.
from pydantic import BaseModel
from agents import Agent, Runner, WebSearchTool

class Finding(BaseModel):
    competitor: str
    category: str
    summary: str
    source_url: str
    evidence: str
    observed_at: str
    needs_human_review: bool

class WeeklyReport(BaseModel):
    findings: list[Finding]
    executive_summary: str

agent = Agent(
    name="Weekly competitor monitor",
    instructions=(
        "Monitor only the competitors and topics in the input. "
        "Use public web sources. Every finding must include a source URL "
        "and evidence. Prefer first-party sources for product and pricing claims. "
        "Do not invent a change when no material change is supported."
    ),
    tools=[WebSearchTool()],
    output_type=WeeklyReport,
)

result = Runner.run_sync(
    agent,
    "Review the configured competitors for the reporting window and return the report."
)

report = result.final_output
A instalação do pacote e o padrão de execução estão documentados no início rápido oficial do Agents SDK. O SDK também documenta Runner.run_sync() como o wrapper síncrono em torno da execução normal do agente.
Ilustração conceitual gerada por IA de um fluxo de trabalho de agente; os detalhes de implementação dependem da sua pilha tecnológica.
Adicione detecção determinística de mudanças onde puder
Não peça ao modelo para redescobrir cada estado antigo da memória. Persista uma linha de base. Para cada fonte, armazene a última observação bem-sucedida: texto normalizado, um hash de conteúdo, campos selecionados como preço ou nome do plano, o timestamp da observação e a URL da fonte. Na próxima execução, compare a nova observação com a linha de base primeiro. Depois, dê ao agente a diferença para interpretar.
Esse design híbrido é mais confiável do que "IA compara dois sites inteiros" porque o código determinístico lida com a comparação exata, enquanto o modelo lida com classificação, relevância e explicação. Se uma página mudar apenas seu rodapé ou parâmetros de rastreamento, seu normalizador pode remover esse ruído antes que o agente o veja.
Etapa 6: Agende o fluxo de trabalho semanalmente e mantenha as credenciais fora do código
Você pode executar o monitor de qualquer agendador que se ajuste ao seu ambiente. O GitHub Actions é uma opção prática para um fluxo de trabalho baseado em repositório. A documentação atual do GitHub diz que fluxos de trabalho agendados usam a sintaxe cron POSIX, são executados no branch padrão, têm UTC como padrão e podem opcionalmente especificar um fuso horário IANA. O GitHub também avisa que as execuções podem ser atrasadas durante períodos de alta carga, especialmente no início da hora, então um minuto como 17 é preferível a 00 quando a execução exata no início da hora não é necessária. Veja a documentação oficial de agendamento do GitHub Actions.
Armazene chaves de API como segredos criptografados em vez de commitá-los no repositório. O guia oficial de segredos do GitHub explica segredos de repositório, ambiente e organização e recomenda evitar a divulgação acidental nos logs do fluxo de trabalho.
Ilustração conceitual gerada por IA de uma camada de agendamento; o artigo usa o GitHub Actions como exemplo concreto.
Um detalhe operacional é fácil de perder: o GitHub diz que fluxos de trabalho agendados em repositórios públicos são desativados automaticamente após 60 dias sem atividade no repositório. Se este fluxo de trabalho for crítico para a missão, monitore o monitor — registre o horário da última execução bem-sucedida e alerte quando o trabalho semanal esperado não for concluído.
Etapa 7: Coloque um portão de revisão humana entre "descoberta" e "decisão"
O monitoramento semanal de concorrentes é um fluxo de trabalho de leitura e resumo, portanto, não deve alterar automaticamente preços, publicar conteúdo ou alterar um roteiro de produto. Uma pessoa deve revisar alegações materiais antes que elas influenciem uma decisão. A revisão pode ser leve: aprovar, rejeitar, mesclar com outra descoberta ou marcar como "observar na próxima semana".
Exija uma revisão mais forte para categorias de alto impacto, como preços, alegações legais, incidentes de segurança, demissões, aquisições ou declarações que dependem de relatórios de terceiros. Para mudanças de produto e preços, prefira a própria página do concorrente como evidência primária, mesmo que uma notícia tenha ajudado você a descobri-la.
Ilustração conceitual gerada por IA do estágio de revisão humana antes que as descobertas sejam compartilhadas ou agidas.
Se sua implementação posteriormente adicionar ferramentas que podem tomar ações, o Agents SDK inclui guardrails e mecanismos de aprovação humana no loop. A documentação oficial de guardrails descreve guardrails de entrada, saída e ferramenta, enquanto o guia de humano no loop explica pausar chamadas de ferramenta sensíveis para aprovação.
Etapa 8: Acompanhe tendências, rastreie falhas e faça uma autoverificação do sistema
Um relatório semanal útil se torna mais valioso após várias execuções, porque você pode distinguir eventos isolados de padrões. Armazene cada descoberta aprovada em uma tabela simples ou banco de dados com concorrente, categoria, data, fonte e status de revisão. Então você pode responder a perguntas como qual concorrente mudou os preços com mais frequência, quais temas recorrentes aparecem nas notas de lançamento ou quais fontes monitoradas não estão mais produzindo sinais úteis.
Ilustração conceitual gerada por IA de acompanhamento de tendências e autoverificação ao longo de várias execuções semanais.
Para o próprio agente, mantenha a observabilidade. O Agents SDK da OpenAI inclui rastreamento integrado que registra gerações de modelo, chamadas de ferramenta, transferências, guardrails e eventos personalizados. O guia oficial de rastreamento descreve como traços e spans podem ser usados para depurar e monitorar fluxos de trabalho. Seja deliberado sobre dados sensíveis, pois os payloads de rastreamento podem incluir entradas/saídas de modelo e ferramenta dependendo da configuração.
Autoverificação antes de confiar no relatório semanal
Cada descoberta material tem uma URL de fonte funcional e uma data dentro da janela de relatório.
Alegações de produto e preços de primeira mão são apoiadas por evidências de primeira mão sempre que possível.
O sistema compara com o último estado conhecido em vez de simplesmente repetir notícias antigas.
"Nenhuma mudança material" é um resultado aceitável para qualquer concorrente.
Histórias duplicadas de múltiplas fontes são mescladas em vez de contadas como mudanças separadas.
O trabalho agendado tem um timestamp de sucesso registrado e execuções perdidas são detectáveis.
Chaves de API e outras credenciais são armazenadas como segredos e não aparecem em logs ou relatórios.
Um humano revisa descobertas de alto impacto antes que a equipe aja sobre elas.
Erros comuns que tornam o monitoramento de concorrentes com IA não confiável
Monitorar apenas através de consultas de busca
A busca é excelente para descoberta, mas instável como linha de base histórica. Mantenha URLs de fontes explícitas e persista observações anteriores.
Pedir ao modelo por "notícias importantes" sem um esquema
A importância é subjetiva. Defina categorias, requisitos de evidência e uma flag de revisão para que a saída possa ser auditada.
Deixar o agente resumir sem datas
Um resultado pode ser relevante, mas antigo. Sempre inclua a janela de relatório e exija uma data observada ou publicada quando a fonte fornecer uma.
Enviar cada item descoberto para as partes interessadas
Separe a coleta do relatório. A camada de coleta pode encontrar muitos itens candidatos; o relatório final deve conter apenas mudanças baseadas em evidências, deduplicadas, que atendam às suas regras de relevância.
Automatizar ações muito cedo
A primeira versão mais segura é somente leitura: coletar, comparar, resumir e solicitar revisão. Adicione ações de escrita apenas depois que você puder medir falsos positivos e entender os modos de falha.
Uma arquitetura simples que você pode reutilizar
O padrão durável é: registro de fontes → coleta → normalização → comparação de linha de base → análise de agente → descobertas estruturadas → revisão humana → relatório semanal → armazenamento de tendências. O agente de IA é mais forte nos estágios de interpretação, enquanto o código comum geralmente é melhor para agendamento exato, armazenamento de estado, hashing, novas tentativas e comparações determinísticas.
Se o fluxo de trabalho passar na autoverificação por várias execuções consecutivas, você pode expandir com cuidado: adicionar mais concorrentes, adicionar agentes especializados para mudanças de preços ou produtos, adicionar um banco de dados ou rotear relatórios aprovados para e-mail, Slack ou sua base de conhecimento interna. O objetivo não é criar o agente mais autônomo. É criar o menor sistema repetível que dá à sua equipe mudanças de concorrentes oportunas e baseadas em fontes toda semana.