O configurație bună Ollama–Obsidian nu este doar una în care o casetă de chat returnează text. Pentru managementul personal al cunoștințelor, testul mai bun este dacă sistemul poate utiliza notele pe care le-ai intenționat, să îți păstreze controlul asupra vault-ului, să răspundă la o viteză acceptabilă și să admită atunci când notele tale nu conțin răspunsul. Dacă aceste condiții nu sunt îndeplinite, schimbarea modelului, a configurației de recuperare sau a plugin-ului este mai utilă decât ajustarea repetată a prompturilor.
Începând cu septembrie 2026, API-ul local al Ollama este încă servit implicit la http://localhost:11434, cu rute API sub /api, iar accesul local nu necesită autentificare. Ollama oferă, de asemenea, embedding-uri pentru căutare semantică și generare augmentată prin recuperare (RAG), care este partea care face ca răspunsurile la întrebări pe întregul vault să fie material diferite de chat-ul obișnuit. Vezi introducerea oficială a API-ului Ollama, documentația de autentificare locală și documentația pentru embedding-uri.
Acest ghid folosește Copilot for Obsidian ca exemplu de plugin comunitar, deoarece proiectul său acceptă în prezent modele locale Ollama și fluxuri de lucru orientate către vault. Formularea exactă a setărilor se poate schimba între versiunile plugin-ului, așa că utilizează repository-ul actual Copilot for Obsidian și ghidul de configurare a modelului local dacă o etichetă din instalarea ta diferă de capturile de ecran sau pașii de mai jos.
Ce ar trebui să realizeze efectiv o configurare locală reușită de PKM?
Înainte de a instala orice, definește rezultatul pe care îl dorești. O configurare locală utilă ar trebui să treacă patru teste practice:
- Conexiune: Obsidian poate accesa un model pe care Ollama îl servește efectiv pe mașina ta.
- Încadrare (Grounding): când întrebi despre o notă sau vault-ul tău, răspunsul reflectă conținutul relevant al notei în loc să se bazeze doar pe antrenamentul general al modelului.
- Performanță: timpul de răspuns și utilizarea memoriei sunt suficient de acceptabile încât să folosești realist fluxul de lucru.
- Control: știi ce plugin poate citi sau modifica notele, ce endpoint de model folosește și dacă sunt activate funcții opționale web sau cloud.
Aceste criterii contează deoarece „model local conectat” și „management personal bun al cunoștințelor” nu sunt același lucru. Chat-ul poate funcționa perfect în timp ce recuperarea din vault este slabă, iar un model puternic poate produce în continuare răspunsuri slabe dacă sunt recuperate notele greșite.
Pasul 1: Instalează Ollama, descarcă un model și verifică API-ul local
Instalează Ollama folosind instrucțiunile oficiale pentru sistemul tău de operare. Ollama acceptă în prezent macOS, Windows și Linux; ghidul de pornire rapidă oficial este cel mai sigur punct de plecare deoarece instalarea și recomandările de modele se schimbă în timp.
Descarcă un model de chat înainte de a deschide Obsidian. De exemplu:
ollama pull gemma3
ollama ls
Nu trebuie neapărat să folosești gemma3. Partea importantă este ca numele modelului pe care îl introduci ulterior în Obsidian să corespundă unui model pe care Ollama îl poate lista local. Începe cu un model pe care computerul tău îl poate rula confortabil, în loc să alegi automat cel mai mare model disponibil.
În continuare, verifică API-ul independent de Obsidian:
curl http://localhost:11434/api/tags
Dacă acea comandă returnează o listă JSON care conține modelul tău, serviciul de bază Ollama funcționează. Poți rula și ollama ps în timp ce un model este activ. Ollama documentează această comandă ca o modalitate de a vedea dacă un model este încărcat în memoria CPU, memoria GPU sau un mix al ambelor. Dacă răspunsurile sunt dureros de lente sau mașina devine nefuncțională, acesta este un semnal să treci la un model mai mic sau să reduci cerințele de context, în loc să presupui că Obsidian este problema.
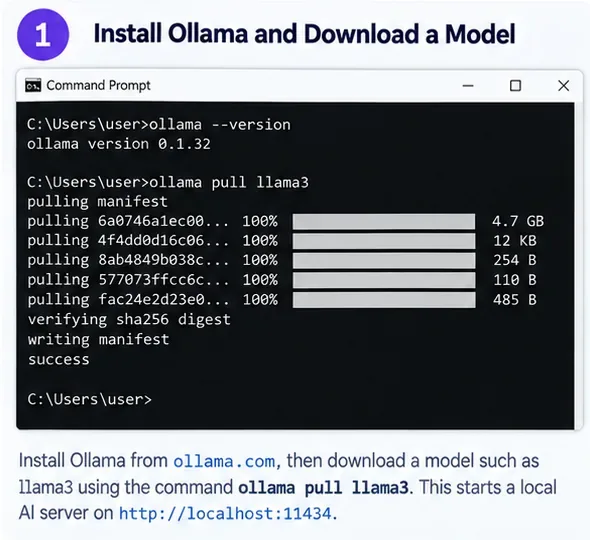
Ilustrație generată de AI a pasului de instalare Ollama și descărcare a modelului. Numerele de versiune și detaliile de descărcare a modelului afișate în imagine sunt ilustrative, nu o înregistrare a unei versiuni curente.
Pasul 2: Instalează plugin-ul Obsidian și conectează modelul său de chat la Ollama
Obsidian tratează plugin-urile comunitare ca cod de la terți. Documentația sa oficială avertizează că aceste plugin-uri rulează cod în numele tău, așa că revizuiește sursa plugin-ului și permisiunile dacă vault-ul tău conține material sensibil. Pentru a instala unul, deschide Setări → Plugin-uri comunitare, activează plugin-urile comunitare dacă este necesar, alege Răsfoire, apoi instalează și activează plugin-ul. Procesul exact este documentat în pagina de ajutor oficială Obsidian pentru Plugin-uri comunitare.
Pentru acest ghid, instalează Copilot din directorul comunitar și confirmă că plugin-ul indică proiectul verificat Copilot for Obsidian legat mai sus. Evită să alegi un plugin cu nume similar doar pentru că apare primul în rezultatele căutării.
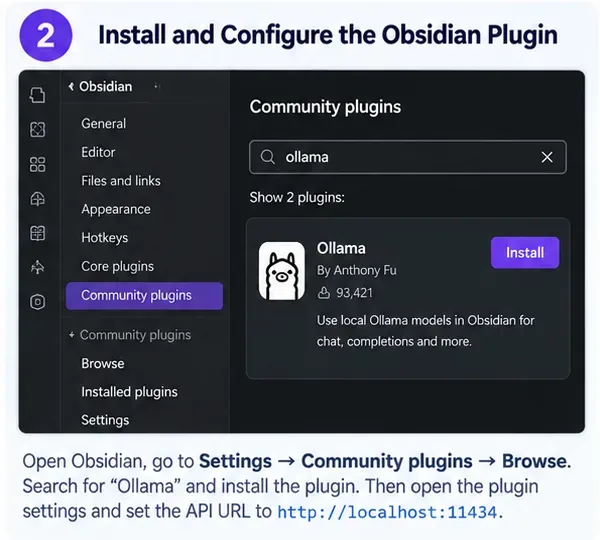
Ilustrație conceptuală generată de AI a browser-ului de plugin-uri comunitare. Cardul plugin-ului, numele autorului și numărul de descărcări afișate sunt ilustrative și nu trebuie tratate ca date verificate din director; utilizează proiectul Copilot verificat legat în acest articol.
Deschide setările Copilot și caută zona de configurare a modelului, organizată în prezent sub setările Models. Adaugă un model de chat personalizat cu aceste valori:
- Furnizor: Ollama.
- Model: numele exact al modelului local raportat de
ollama ls.
- URL de bază:
http://localhost:11434.
- Cheie API: Ollama însuși nu necesită una pentru accesul localhost. Dacă un câmp al plugin-ului necesită un placeholder, urmează instrucțiunile actuale ale acelui plugin în loc să inventezi o cheie cloud.
Există o greșeală ușoară de URL de evitat. Când testezi Ollama manual, endpointurile API arată ca http://localhost:11434/api/chat. Furnizorul Ollama nativ al Copilot, totuși, se așteaptă la adresa serverului de bază și construiește endpointul intern, așa că folosește http://localhost:11434 cu excepția cazului în care plugin-ul actual cere specific un endpoint complet. De asemenea, nu adăuga /v1 când folosești furnizorul Ollama nativ. API-ul compatibil OpenAI separat al Ollama folosește /v1, dar aceasta este o cale de integrare diferită.
Pasul 3: Testează încadrarea la nivel de notă înainte de a indexa tot vault-ul
Nu începe prin a indexa mii de note. Mai întâi, dovedește că conexiunea de bază de chat funcționează cu un test mic, controlat. Creează o notă temporară care conține trei fapte ușor de verificat, cum ar fi un nume de proiect, un termen limită și o decizie. Apoi atașează sau menționează acea notă în Copilot și cere modelului să rezume doar ceea ce spune nota.
Un rezultat bun ar trebui să reproducă acele fapte cu acuratețe, să evite adăugarea de afirmații nejustificate și să rămână în cadrul cerut. Un rezultat slab ar putea răspunde din cunoștințe generale ignorând nota, să inventeze detalii sau să omită un fapt important care este prezent în mod evident.
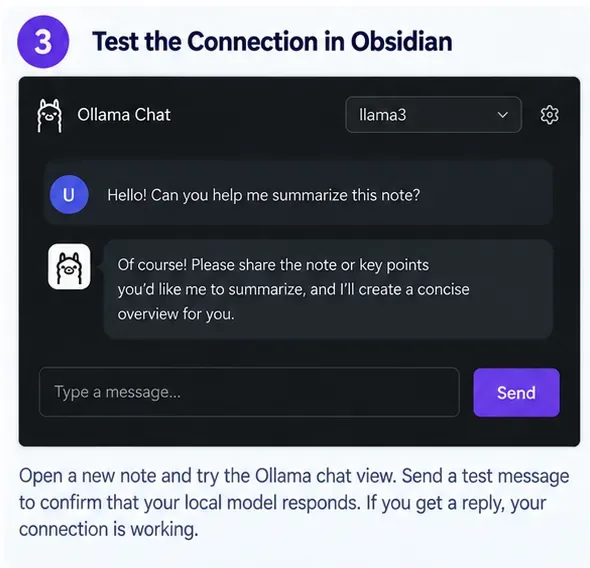
Ilustrație conceptuală generată de AI a unui test de chat local în Obsidian. Demonstrează tipul de rezultat de verificat, nu o captură de ecran reală a unei versiuni specifice de plugin.
Dacă nu există răspuns, depistează erorile de jos în sus. Mai întâi rulează din nou curl http://localhost:11434/api/tags. Dacă eșuează, problema este Ollama, nu Obsidian. Dacă API-ul funcționează dar Copilot nu, reverifică numele modelului și URL-ul de bază. Abia după aceste verificări ar trebui să investighezi o problemă de origine/CORS. Codul actual Copilot include o cale de request menită să gestioneze accesul local Ollama, în timp ce ghidul său de configurare locală documentează și OLLAMA_ORIGINS pentru configurațiile care necesită acces direct din originea Obsidian. Folosește metoda documentată pentru versiunea Copilot instalată în loc să aplici automat soluții alternative vechi cu variabile de mediu.
Pasul 4: Adaugă recuperare conștientă de vault doar dacă chat-ul la nivel de notă trece testul
Pentru managementul personal al cunoștințelor, cea mai mare îmbunătățire a calității vine adesea din recuperare, nu din trecerea la un model de chat mai mare. RAG înseamnă că sistemul recuperează mai întâi fragmente din notele tale care par relevante, apoi oferă acele fragmente modelului de limbaj ca context. Acest lucru permite unui model local să răspundă la întrebări despre informații pe care nu a fost niciodată antrenat.
Pentru a face și recuperarea locală, folosește un model de embedding Ollama. Documentația actuală Ollama recomandă modele precum embeddinggemma, qwen3-embedding și all-minilm. De exemplu:
ollama pull embeddinggemma
Configurează acel model în setările de embedding pentru căutarea în vault sau QA ale Copilot folosind furnizorul Ollama, apoi construiește sau reconstruiește indexul local. Folosește același model de embedding pentru indexare și interogare; Ollama recomandă explicit acest lucru deoarece vectorii produși de modele diferite nu sunt direct interschimbabili.

Ilustrație conceptuală generată de AI a unui flux de lucru de note alimentat de Ollama. Numele comenzilor și aspectul meniului sunt exemple, nu o afirmație despre UI-ul exact al versiunii curente Copilot.
Odată ce indexarea se termină, testează recuperarea cu întrebări ale căror răspunsuri le cunoști deja. Cere un fapt care apare într-o notă, apoi o relație care necesită două note. În final, cere ceva care nu este în vault. Cel mai bun rezultat nu este răspunsul cel mai fluent; este cel care folosește dovada corectă și refuză să inventeze fapte lipsă.
Cum să judeci dacă rezultatul este suficient de bun
| Verificare de calitate | Semnal de trecere | Când să schimbi abordarea |
|---|
| Conexiune locală | /api/tags funcționează și același model răspunde în Obsidian | Dacă curl eșuează, repară Ollama mai întâi; dacă doar Obsidian eșuează, inspectează setările de model/URL ale plugin-ului |
| Încadrare la nivel de notă | Faptele cunoscute din nota atașată sunt reproduse cu acuratețe | Dacă chat-ul ignoră nota, repară selecția de context înainte de a schimba modelele |
| Recuperare din vault | Notele relevante sunt afișate consecvent pentru întrebări cu răspuns cunoscut | Dacă recuperarea este slabă, îmbunătățește embedding-urile/indexarea sau îngustează domeniul indexat |
| Calitatea generării | Modelul separă faptele susținute de incertitudine | Dacă recuperarea este bună dar răspunsurile sunt slabe, încearcă un model de chat mai puternic |
| Latență | Poți interacționa fără blocaje lungi repetate | Dacă Ollama este în mare parte legat de CPU sau înfometat de memorie, folosește un model mai mic sau mai puțin context |
| Confidențialitate | Endpointul configurat este localhost și funcțiile opționale cloud/web sunt dezactivate | Dacă un endpoint remote sau un instrument web este activ, fluxul de lucru nu mai este complet local |
Când un model mai mare nu este soluția corectă
Dacă răspunsurile sunt greșite deoarece sistemul recuperează notele greșite, actualizarea modelului de chat poate îmbunătăți proza fără a repara dovada. Îmbunătățește recuperarea mai întâi. Invers, dacă pasajele corecte sunt recuperate dar modelul nu le poate sintetiza în mod fiabil, atunci un model de chat mai bun poate ajuta.
Hardware-ul stabilește, de asemenea, un plafon practic. Ollama notează că fișierele de model pot consuma stocare substanțială, iar contexte mai mari consumă mai multă memorie. Folosește ollama ps pentru a vedea cum este încărcat modelul curent. Un flux de lucru care rulează tehnic dar durează atât de mult încât încetezi să îl folosești nu este un sistem PKM de succes.
Limite de confidențialitate și siguranță ale AI-ului „local” Obsidian
API-ul localhost al Ollama însuși nu necesită autentificare, ceea ce este convenabil pe o singură mașină, dar înseamnă și că nu ar trebui să exporți casual portul 11434 la o rețea. Menține-l legat local cu excepția cazului în care securizezi deliberat o configurație remote.
Reține, de asemenea, că „Ollama este local” nu înseamnă automat că „întregul flux de lucru Obsidian este offline”. Plugin-urile comunitare pot conține integrări cu furnizori cloud, căutare web, telemetrie sau instrumente de agent. Revizuiește setările actuale ale plugin-ului și dezactivează funcțiile pe care nu intenționezi să le folosești. Dacă scopul tău este procesarea strict offline, testează cu rețeaua deconectată după ce toate modelele și plugin-urile sunt deja instalate.
Autoverificare finală
Configurația ta este gata pentru managementul personal al cunoștințelor de zi cu zi când toate aceste afirmații sunt adevărate: API-ul Ollama răspunde local; Obsidian folosește exact modelul local pe care l-ai intenționat; un test controlat al notei returnează faptele corecte; recuperarea din vault găsește notele corecte pentru întrebările cu răspuns cunoscut; întrebările nejustificate nu declanșează fabricări încrezătoare; iar performanța este suficient de rapidă încât să folosești efectiv fluxul de lucru.
Dacă doar primele două afirmații sunt adevărate, ai conectat cu succes Ollama la Obsidian, dar nu ai încă un asistent de management al cunoștințelor fiabil. Tratează calitatea recuperării, comportamentul modelului și configurația de confidențialitate ca părți separate ale sistemului și schimbă partea care eșuează efectiv.









