Acasă
» domenii
»
Cum să rulezi DeepSeek offline pe Windows 11 cu LM Studio
Cum să rulezi DeepSeek offline pe Windows 11 cu LM Studio
Da, poți rula DeepSeek complet offline pe Windows 11 cu LM Studio, dar ai nevoie de o primă configurare online. Instalează LM Studio, descarcă un model DeepSeek compatibil și runtime-ul necesar, încarcă modelul o dată, iar apoi te poți deconecta de la internet. Documentația oficială offline a LM Studio menționează că discuțiile cu modelele descărcate, discuțiile cu documente locale și rularea serverului local nu necesită acces la internet.
Pentru un PC Windows 11 tipic, cel mai practic punct de plecare nu este cel mai mare model DeepSeek actual. Un model GGUF mai mic, precum DeepSeek-R1-0528-Qwen3-8B, este mult mai ușor de rulat local. LM Studio a publicat suport pentru acel model distilat de 8B în mai 2025 și afirmă că funcționează în format GGUF cu LM Studio 0.3.16 sau o versiune mai nouă. Prin contrast, ghidul LM Studio din august 2026 pentru DeepSeek V4 Flash afirmă că utilizarea locală necesită aproximativ 156GB de memorie de sistem. Acest lucru face ca V4 Flash să fie o alegere proastă pentru majoritatea mașinilor Windows de consum, chiar dacă este mai nou și mai capabil.
Acest ghid a fost verificat pe 11 septembrie 2026. Changelog-ul LM Studio listează versiunea 0.4.24 datată 9 septembrie 2026. Deoarece interfața LM Studio evoluează, un buton se poate muta ușor între versiuni, dar fluxul de lucru principal—descărcarea unui model, încărcarea lui, conversația locală și expunerea opțională a unei API localhost—rămâne documentat de LM Studio.
Înainte de a începe: Se potrivește PC-ul tău Windows 11?
LM Studio acceptă în prezent atât PC-uri Windows x64, cât și sisteme Windows bazate pe ARM. Pentru x64, procesorul trebuie să suporte AVX2. LM Studio recomandă cel puțin 16GB de RAM și cel puțin 4GB de VRAM dedicat. Acestea sunt recomandări la nivel de aplicație, nu o promisiune că fiecare model se va potrivi. Dimensiunea modelului, cuantizarea, lungimea contextului și descărcarea pe GPU afectează toate utilizarea memoriei.
Ce ai la dispoziție
Recomandare practică
De ce
16GB RAM, GPU modest sau grafică integrată
Începe cu un model distilat DeepSeek de 8B sau mai mic într-o variantă GGUF pe 4 biți
Menține amprenta modelului relativ gestionabilă, păstrând în același timp o capacitate utilă de raționament.
Mai mult RAM și un GPU mai puternic
Încearcă variante distilate mai mari doar după verificarea estimării de compatibilitate a dispozitivului din LM Studio
Modelele mai mari pot îmbunătăți calitatea, dar consumă semnificativ mai multă memorie și pot fi mult mai lente.
PC de gaming obișnuit sau laptop
Nu începe cu DeepSeek V4 Flash
LM Studio afirmă că modelul local V4 Flash necesită cel puțin 156GB de memorie de sistem.
Documentația de descărcare a modelelor LM Studio explică faptul că versiunile cuantificate sacrifică o parte din fidelitate pentru fișiere mai mici și o presiune mai mică asupra memoriei. Recomandarea generală este să alegi o opțiune pe 4 biți sau mai mare atunci când hardware-ul tău o poate gestiona. Dacă nu ești sigur, o versiune GGUF pe 4 biți este un prim test rezonabil.
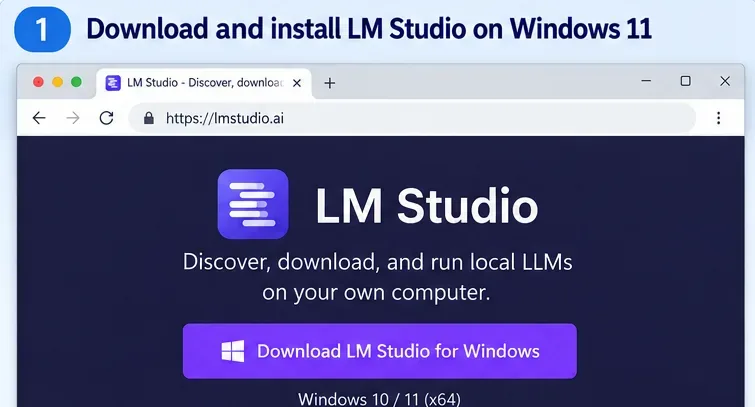
Descarcă versiunea stabilă actuală pentru Windows de pe pagina oficială de descărcare LM Studio. Folosește instalatorul care corespunde arhitecturii tale Windows. Pe un PC x64, asigură-te că procesorul tău suportă AVX2 înainte de a depana erorile de încărcare a modelului mai târziu.
Vizualizarea de descărcare pentru Windows a LM Studio. Alege instalatorul care corespunde sistemului tău Windows 11 înainte de a trece la descărcarea modelului.
Lansează LM Studio în timp ce ai încă o conexiune la internet. Acest lucru este important deoarece aplicația poate avea nevoie să descarce sau să actualizeze un LM Runtime. LM Studio descrie runtime-urile ca motoare de inferență împachetate, cum ar fi runtime-ul său bazat pe llama.cpp pentru modelele GGUF. Descărcările runtime-ului necesită conectivitate, chiar dacă inferența poate funcționa offline ulterior.
Pasul 2: Descarcă un model DeepSeek care se potrivește PC-ului tău
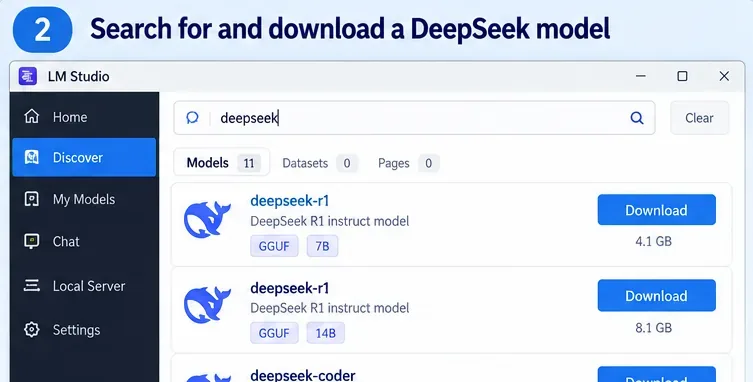
Deschide zona Discover din LM Studio și caută DeepSeek. LM Studio poate căuta modele suportate pe Hugging Face după cuvânt cheie, după un identificator user/model sau chiar după o URL completă Hugging Face.
Caută DeepSeek în Discover, apoi alege un model și o cuantizare potrivite pentru hardware-ul tău. Intrările exacte din catalog și dimensiunile fișierelor se schimbă în timp.
Ce model DeepSeek ar trebui să alegi?
Pentru majoritatea persoanelor care urmează acest ghid, începe cu DeepSeek-R1-0528-Qwen3-8B. LM Studio afirmă că acest model distilat de 8B suportă raționamentul și utilizarea instrumentelor, este disponibil ca GGUF și poate rula cu mult mai puțină memorie decât modelele DeepSeek flagship. Ghidul LM Studio pentru Windows recomandă în continuare 16GB de RAM pentru aplicația în ansamblu, deci nu trata o afirmație de memorie scăzută specifică modelului ca pe o țintă confortabilă pentru întregul sistem.
DeepSeek a lansat și variante distilate R1 anterioare cu 1.5B, 7B, 8B, 14B, 32B și 70B de parametri. Acestea îți oferă spațiu pentru a echilibra viteza și utilizarea memoriei împotriva capabilităților. Vezi repository-ul oficial DeepSeek-R1 pentru familia de modele și detaliile de licențiere, și nota LM Studio privind rularea locală a DeepSeek-R1-0528 pentru opțiunea de 8B.
Dacă ești tentat de DeepSeek V4 Flash pentru că este mai nou, verifică mai întâi cerințele hardware. Articolul oficial V4 Flash al LM Studio afirmă că modelul Mixture-of-Experts de 284B necesită cel puțin 156GB de memorie de sistem pentru utilizarea locală. Este viabil pe stații de lucru cu memorie mare, nu pe un laptop Windows obișnuit.
Pasul 3: Încarcă modelul în memorie
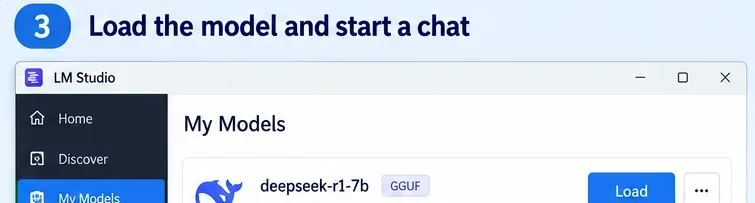
După ce descărcarea se termină, mergi la modelele tale descărcate sau deschide încărcătorul de modele din Chat. Selectează modelul DeepSeek și încarcă-l. LM Studio explică faptul că încărcarea unui model alocă memorie pentru greutățile modelului și starea runtime-ului asociată.
Un model DeepSeek GGUF descărcat, gata de încărcat. Dacă încărcarea eșuează, încearcă un model mai mic sau o cuantizare cu memorie mai mică înainte de a modifica setările avansate.
Pentru prima ta rulare, menține setările de încărcare conservatoare. O fereastră de context foarte mare poate consuma memorie suplimentară semnificativă, deci există puține motive să maximizezi contextul imediat. Încarcă modelul cu un context modest, verifică dacă funcționează și extinde-l doar atunci când sarcina ta o cere.
Dacă LM Studio raportează că modelul nu se potrivește, cea mai fiabilă soluție este de obicei să alegi un model mai mic sau o cuantizare mai compactă. Închiderea aplicațiilor care consumă multă memorie poate ajuta, dar nu schimbă amprenta fundamentală a modelului.
Pasul 4: Deconectează internetul și verifică dacă DeepSeek funcționează cu adevărat offline
Acesta este pasul care separă „model local” de simpla „utilizare a unui client desktop”. Odată ce modelul și runtime-ul său sunt instalate, oprește Wi-Fi și deconectează Ethernet. Apoi, pornește o nouă conversație și trimite un prompt simplu, cum ar fi:
Explică diferența dintre RAM și VRAM în cinci puncte.
Dacă modelul răspunde în timp ce PC-ul nu are conexiune la rețea, inferența este locală. LM Studio declară că, odată ce un LLM este pe mașina ta, acesta poate rula complet offline și că textul introdus în conversațiile locale cu LLM nu părăsește dispozitivul tău. Documentația sa offline afirmă, de asemenea, că procesarea documentelor locale și RAG rămân pe mașină.
Un model DeepSeek încărcat răspunzând în LM Studio Chat. Pentru a verifica singur funcționarea offline, deconectează accesul la rețea după ce modelul și runtime-ul sunt complet descărcate și repetă un prompt simplu.
Există o graniță importantă: căutarea de modele, descărcarea de modele noi, descărcarea de runtime-uri și verificarea actualizărilor aplicației necesită acces la internet. Dacă adaugi ulterior modele cloud, servere MCP remote, instrumente web sau alte integrări de rețea, aceste funcții pot necesita, de asemenea, conectivitate. Afirmațiile de confidențialitate offline se aplică fluxului de lucru local, nu serviciilor la care te conectezi deliberat ulterior.
Pasul 5: Opțional—Utilizează DeepSeek printr-o API locală
Dacă dorești ca o altă aplicație Windows, script, extensie IDE sau instrument intern să apeleze modelul tău local DeepSeek, LM Studio poate rula un server local. Documentația actuală pentru dezvoltatori afirmă că îl poți porni din pagina Developer sau cu:
lms server start
În mod implicit, serverul este disponibil la http://localhost:1234. LM Studio oferă endpoint-uri REST native și endpoint-uri compatibile OpenAI. Serverul însuși poate funcționa offline atâta timp cât modelul și runtime-ul sunt deja locale. Cu toate acestea, dacă expui serverul dincolo de localhost, verifică mai întâi setările de autentificare și acces la rețea.
RAM/VRAM insuficient, context prea mare sau CPU/runtime nesuportat
Încearcă un model DeepSeek mai mic, o cuantizare mai mică sau o lungime de context mai mică. Pe Windows x64, confirmă suportul AVX2.
LM Studio funcționează online, dar nu după deconectare
Modelul sau runtime-ul necesar nu au fost descărcate complet
Reconectează-te o dată, termină toate descărcările de modele/runtime, încarcă modelul cu succes, apoi repetă testul offline.
Generarea este foarte lentă
Modelul este prea mare pentru accelerarea GPU disponibilă și se bazează puternic pe CPU/memoria de sistem
Alege un model sau o cuantizare mai mică. Un model mai mare nu este util dacă latența face fluxul de lucru impracticabil.
Nu poți găsi un model în timp ce ești offline
Căutarea Discover necesită acces la rețea
Descarcă modelele înainte de a deveni offline, sau încarcă manual un fișier de model obținut printr-un alt proces controlat.
Te așteptai ca V4 Flash să ruleze pe un laptop obișnuit
Cerința sa de memorie locală este de nivel stație de lucru
Folosește în schimb un model distilat R1, cu excepția cazului în care mașina ta are aproximativ 156GB sau mai multă memorie de sistem.
Când se potrivește această configurare
Rularea DeepSeek offline cu LM Studio este o potrivire puternică atunci când dorești inferență locală privată, costuri predictibile după descărcarea modelului, experimentare fără chei API sau o API localhost pentru dezvoltare. Este, de asemenea, utilă atunci când mașina ta trebuie să continue să funcționeze fără acces la internet.
Este o potrivire mai slabă atunci când ai nevoie de cel mai puternic model DeepSeek disponibil, dar ai doar hardware de consum, când ai nevoie de un throughput extrem de mare sau când sarcina ta depinde de informații web live. Modelele locale știu doar ceea ce este în greutățile lor și în contextul pe care îl furnizezi, cu excepția cazului în care conectezi deliberat instrumente sau surse de date externe.
Checklist rapid
Folosește un sistem Windows 11 care îndeplinește cerințele LM Studio; procesoarele x64 au nevoie de AVX2.
Menține accesul la internet pentru descărcările inițiale LM Studio, runtime și model.
Începe cu un model DeepSeek GGUF mai mic, în special un model distilat de clasă 8B.
Alege o cuantizare pe 4 biți sau mai mare dacă hardware-ul tău o poate susține.
Încarcă modelul cu succes înainte de a deconecta rețeaua.
Oprește Wi-Fi/Ethernet și rulează un prompt nou pentru a verifica inferența offline.
Reduce dimensiunea modelului sau lungimea contextului dacă întâmpini erori de memorie.
Folosește serverul localhost al LM Studio doar dacă ai nevoie de acces la API local.
Concluzie
Cea mai ușoară metodă de a rula DeepSeek offline pe Windows 11 este să asociezi LM Studio cu un model DeepSeek GGUF mai mic care se potrivește efectiv hardware-ului tău. Pentru un PC obișnuit, un model distilat R1 de clasă 8B este un punct de plecare mult mai realist decât DeepSeek V4 Flash. Completează descărcările în timp ce ești online, încarcă modelul, deconectează rețeaua și verifică dacă o nouă conversație răspunde în continuare. Odată ce acest lucru funcționează, ai o configurare DeepSeek cu adevărat locală, nu un wrapper desktop în jurul unei API cloud.