Acasă
» domenii
»
Cum să împiedici agenții CrewAI să execute sarcini redundante: Un ghid practic de deduplicare
Cum să împiedici agenții CrewAI să execute sarcini redundante: Un ghid practic de deduplicare
Când agenții CrewAI par să execute aceeași sarcină de două ori, cauza nu este de obicei o singură setare de „sarcină duplicată”. Repetarea poate proveni din descrieri de sarcini suprapuse, delegare ierarhică, comportament de reîncercare, declanșatoare multiple de flux, lansări repetate ale echipei sau instrumente cu efecte secundare care nu sunt protejate de o cheie de idempotență.
Această referință practică a fost verificată în raport cu documentația oficială CrewAI pe 13 septembrie 2026. Documentația actuală a fost rezolvată la CrewAI v1.15.14. Cea mai importantă distincție este următoarea: prevenirea raționamentului redundant într-o singură rulare este diferită de prevenirea de două ori a aceleiași acțiuni de business în mai multe rulări . CrewAI oferă contextul sarcinii, sarcinile condiționate, apelurile inverse, starea fluxului, persistența și memorarea în cache a instrumentelor, dar tot trebuie să proiectați condiții explicite de omitere pentru munca care trebuie să se întâmple o singură dată.
Diagnostic rapid: de ce se întâmplă aceeași lucrare de două ori?
Simptom
Cauza probabilă
Prima soluție de încercat
Doi agenți cercetează aceeași temă
Roluri sau descrieri de sarcini care se suprapun
Acordați fiecărei sarcini un proprietar și transmiteți rezultatul anterior prin intermediul acestuia.context
Un manager solicită o muncă pe care un alt agent a făcut-o deja
Delegare ierarhică plus responsabilități ambigue
Clarificați instrucțiunile managerului, rolurile agenților și dreptul de proprietate asupra instrumentelor
Aceeași sarcină se execută de mai multe ori după ce validarea eșuează
Reîncercări de parapet
Inspectați eroarea guardrail și reduceți-o guardrail_max_retriesîn timpul depanării
Un agent apelează în mod repetat același instrument
Buget de iterație mare, condiție de oprire slabă sau reîncercări de apelare a instrumentului
Coborâți max_iter, strângeți randamentul așteptat și inspectați jurnalele de etape
O metodă Flow se declanșează de mai multe ori
Metode multiple @start()sau evenimente multiple în amonte
Folosiți un singur punct de intrare, un router, steaguri de stat sau, and_atunci când este cazul
O mutație a adresei de e-mail/plată/API are loc de două ori după repornire
Fără gardă de idempotență încrucișată
Utilizarea unei chei de operație deterministe în stocarea tranzacțională persistentă sau externă
Ai activat memoria, dar sarcinile tot sunt reluate
Memoria furnizează context; nu este un deduplicator la nivel de planificator
Urmăriți explicit lucrările finalizate în loc să vă bazați pe rechemare
Ai activat memoria cache, dar întreaga sarcină se execută din nou.
Cache-ul CrewAI este documentat pentru rezultatele execuției instrumentului
Adăugați o logică de omitere la nivel de sarcină sau un depozit de idempotență
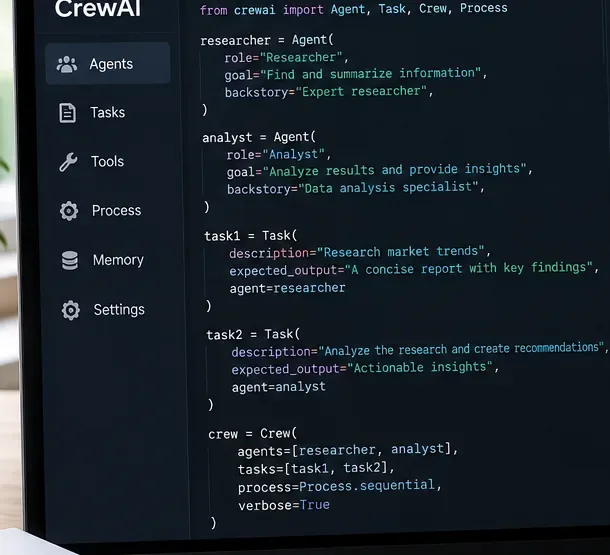
Cea mai simplă regulă anti-duplicare este și cea mai eficientă: fiecare unitate de lucru semnificativă ar trebui să aibă un proprietar de sarcină. Într-un proces CrewAI secvențial, sarcinile rulează în ordinea în care sunt declarate. Atributul contextpermite unei sarcini ulterioare să consume rezultatul unei sarcini anterioare în loc să redescopere independent aceleași informații.
Proprietatea separată este mai ușor de raționat: o sarcină cercetează, următoarea sarcină analizează cercetarea în loc să o repete.
Un anti-pattern comun arată conceptual astfel:
research_task: "Research the customer and summarize findings"
analysis_task: "Research the customer, analyze findings, and recommend actions"
writer_task:   "Review the customer, research missing details, and write the report"
Toate cele trei sarcini conțin permisiunea de cercetare, deci căutarea repetată este previzibilă. Se preferă un lanț mai restrâns:
from crewai import Agent, Crew, Process, Task

research_task = Task(
    description="Research the customer once and return verified facts and sources.",
    expected_output="Structured research notes with sources.",
    agent=researcher,
)

analysis_task = Task(
    description="Analyze only the research provided in context. Do not perform new research.",
    expected_output="Prioritized findings and recommendations.",
    agent=analyst,
    context=[research_task],
)

crew = Crew(
    agents=[researcher, analyst],
    tasks=[research_task, analysis_task],
    process=Process.sequential,
)
Listă de verificare practică pentru limitele sarcinilor
Dați fiecărei sarcină un verb diferit de celelalte: a cerceta, a normaliza, a analiza, a scrie, a revizui.
Spune ce nu trebuie să facă sarcina atunci când suprapunerea este costisitoare.
Faceți ca rezultatul așteptat să fie suficient de concret încât următoarea sarcină să îl poată consuma direct.
Transmiteți rezultatele anterioare în contextloc să le spuneți agenților de mai târziu să „cerceteze dacă este necesar”.
Restricționați instrumentele la nivel de sarcină sau agent atunci când un singur rol ar trebui să aibă permisiunea de a căuta, scrie într-o bază de date, trimite mesaje sau apela o API externă.
2. Sari peste lucrările care sunt deja satisfăcute de ConditionalTask
Dacă o sarcină este necesară doar atunci când un rezultat anterior este incomplet, nu faceți ca agentul să decidă informal dacă să repete lucrarea. CrewAI oferă ConditionalTask, a cărui condiție primește rezultatul sarcinii anterioare și poate sări peste execuție atunci când condiția este falsă.
Exemplul oficial folosește o condiție care verifică dacă au fost returnate suficiente înregistrări de evenimente; dacă există deja suficiente date, sarcina de extra-fetch este omisă. Consultați Sarcini condiționale CrewAI .
from typing import List
from pydantic import BaseModel
from crewai import Agent, Crew, Task
from crewai.tasks.conditional_task import ConditionalTask
from crewai.tasks.task_output import TaskOutput

class ResearchOutput(BaseModel):
    sources: List[str]
    summary: str

def needs_more_sources(output: TaskOutput) -> bool:
    return len(output.pydantic.sources) < 5

research = Task(
    description="Find up to five authoritative sources about the topic.",
    expected_output="A structured research result.",
    agent=researcher,
    output_pydantic=ResearchOutput,
)

enrich = ConditionalTask(
    description="Find only the missing sources needed to reach five total.",
    expected_output="Additional authoritative sources only.",
    condition=needs_more_sources,
    agent=researcher,
)
Acest model este mai puternic decât solicitarea unui agent de a evita duplicarea muncii, deoarece decizia de omitere este o logică deterministă Python, mai degrabă decât o altă judecată bazată pe modelul de limbaj.
3. Să știți când delegarea creează o duplicare aparentă
CrewAI acceptă atât procese secvențiale, cât și ierarhice. Într-o echipă ierarhică, un manager alocă sarcini, deleagă munca, validează rezultatele și stabilește dacă finalizarea sarcinilor este satisfăcătoare. Această flexibilitate este utilă atunci când alocarea muncii trebuie să fie dinamică, dar înseamnă și că responsabilitatea este mai puțin explicită decât într-o echipă secvențială.
Documentația CrewAI pentru agenți precizează în prezent că allow_delegationvaloarea implicită este False. Se păstrează această valoare implicită pentru specialiști, cu excepția cazului în care un agent trebuie cu adevărat să predea sarcina unui alt agent. Într-un proces ierarhic, managerul însuși este responsabil pentru delegare. Consultați ghidul procesului ierarhic .
Un punct de plecare sigur pentru o echipă care produce apeluri redundante este:
researcher = Agent(
    role="Researcher",
    goal="Collect evidence once and return it in structured form.",
    backstory="You gather evidence; you do not write the final report.",
    allow_delegation=False,
    max_iter=8,
    max_retry_limit=1,
)

writer = Agent(
    role="Writer",
    goal="Write from supplied context without doing fresh research.",
    backstory="You synthesize existing evidence into a final answer.",
    allow_delegation=False,
    max_iter=6,
)
Apoi, adăugați delegarea înapoi doar acolo unde produce un beneficiu măsurabil. Dacă orchestrarea ierarhică nu este necesară, Process.sequentialeste mai ușor de depanat deoarece ordinea sarcinilor și responsabilitatea sunt explicite.
4. Nu confundați reîncercările cu programarea duplicată
Uneori, se așteaptă reluarea sarcinilor. Guardrail-urile CrewAI pot valida o ieșire și pot trimite feedback agentului atunci când validarea eșuează. Documentația actuală a sarcinii menționează că guardrail_max_retriesvaloarea implicită este 3, iar un guardrail eșuat reia sarcina până la această limită.
Agenții expun, de asemenea, max_retry_limiterorile de execuție și max_iternumărul maxim de iterații ale agentului înainte de a produce cel mai bun răspuns disponibil. Documentația actuală a agenților listează o valoare implicită max_iterde 20 și o limită implicită de reîncercări de eroare de 2.
Aceste mecanisme rezolvă diferite probleme:
Setare
Ceea ce limitează
De ce poate părea redundant
guardrail_max_retries
Reîncercări după ce validarea rezultatului sarcinii eșuează
Aceeași sarcină este reexecutată intenționat cu feedback de tip guardrail
max_retry_limit
Reîncercări după erori de execuție
O încercare eșuată poate repeta apelul unui instrument
max_iter
Iterații ale raționamentului/instrumentului de către agent
Un agent incert poate face mai multe apeluri similare de instrumente înainte de a termina
În timpul depanării, reduceți temporar aceste limite. Dacă repetiția dispare, verificați de ce sarcina a eșuat la validare sau de ce agentul a crezut că este necesară o altă iterație a instrumentului. Nu setați pur și simplu toate valorile de reîncercare la zero în producție; reîncercările pot fi potrivite pentru erori tranzitorii.
5. Urmăriți ce a fost executat cu adevărat înainte de a rescrie solicitările
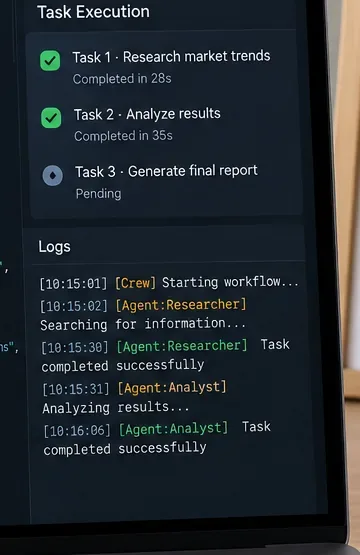
Jurnalele de execuție ajută la separarea unei a doua execuții reale de mai mulți pași, reîncercări sau apeluri de instrumente în cadrul unei singure sarcini.
CrewAI expune mai multe opțiuni de observabilitate. La nivel de echipă, documentația actuală include controale de urmărire verbose, step_callback, task_callback, output_log_file, și . Agenții acceptă, de asemenea step_callback. Acestea sunt utile pentru a răspunde la patru întrebări:
A pornit planificatorul aceeași sarcină de două ori?
A efectuat un agent mai multe iterații în cadrul unei singure sarcini?
A respins o barieră de protecție ieșirea și a declanșat o reîncercare?
S-a repetat un apel de instrument chiar dacă sarcina în sine a rulat o singură dată?
Pentru o rulare inițială de diagnosticare, activați ieșirea detaliată și un fișier jurnal JSON:
Fluxurile introduc o altă clasă de repetiție. Documentația actuală a fluxurilor CrewAI spune că toate @start()metodele satisfăcute se execută atunci când fluxul începe sau se reia. Dacă definiți mai multe porniri necondiționate și două dintre ele declanșează în cele din urmă aceeași echipă, duplicarea se află în grafic, nu în interiorul echipei.
În mod similar, or_listenerele pot rula atunci când orice metodă din amonte emite ieșire. Exemplul propriu al CrewAI arată listenerul declanșându-se o dată pentru fiecare emisie din amonte. Se utilizează and_atunci când operațiunea din aval ar trebui să aștepte până când mai multe cerințe preliminare sunt finalizate sau se utilizează @router()atunci când doar o ramificare ar trebui să continue.
Înainte de a adăuga un al doilea @start(), întrebați-vă dacă acesta reprezintă într-adevăr un punct de intrare independent. Dacă nu, utilizați o metodă de pornire și listener-uri explicite.
7. Adăugați o cheie de finalizare pentru idempotența între runde
Acesta este cel mai important model de producție atunci când o sarcină are un efect secundar extern, cum ar fi trimiterea de e-mailuri, facturarea unei metode de plată, crearea unei înregistrări CRM, postarea unui mesaj sau începerea unui job.
Fluxurile CrewAI acceptă stări structurate și @persistdecoratorul. Persistența permite unui flux să recupereze starea după reporniri. Cu toate acestea, starea persistentă nu decide dacă o acțiune de business ar trebui omisă. Stocați propria cheie de operare deterministă și verificați-o înainte de a aplica efectul secundar.
Persistența și memoria sunt elemente constitutive utile, dar un flux de lucru de producție are nevoie în continuare de o regulă explicită „deja finalizat?” pentru acțiunile care trebuie să se întâmple o singură dată.
from hashlib import sha256
import json
from pydantic import BaseModel
from crewai.flow.flow import Flow, start
from crewai.flow.persistence import persist

class JobState(BaseModel):
    completed_keys: list[str] = []
    report: str = ""

def operation_key(customer_id: str, period: str) -> str:
    payload = {"customer_id": customer_id, "period": period}
    raw = json.dumps(payload, sort_keys=True).encode()
    return sha256(raw).hexdigest()

@persist
class ReportFlow(Flow[JobState]):

    @start()
    def run_report(self):
        key = operation_key("customer-123", "2026-09")

        if key in self.state.completed_keys:
            return self.state.report

        result = reporting_crew.kickoff(
            inputs={"customer_id": "customer-123", "period": "2026-09"}
        )

        self.state.report = result.raw
        self.state.completed_keys.append(key)
        return self.state.report
Documente CrewAI care @persistpot stoca starea Flow după repornire și care arată că reluarea cu același ID de stare reîncarcă cea mai recentă instantanee. Consultați documentația CrewAI Flow despre persistența acestuia .
Atenție importantă privind producția: exemplul de mai sus este util pentru deduplicarea obișnuită a fluxului de lucru, dar nu este suficient pentru un efect secundar critic din punct de vedere financiar sau juridic. Un proces se poate bloca după ce acțiunea externă are succes, dar înainte ca cheia de finalizare să fie persistentă. Pentru un comportament puternic de tip „exact-once-like”, utilizați un depozit tranzacțional extern sau propria cheie de idempotență a API-ului țintă și înregistrați operațiunea atomic, acolo unde este posibil.
8. Stocați în cache apelurile repetate ale instrumentelor, dar nu confundați memoria cache cu idempotența sarcinilor
Agenții și echipele CrewAI expun cache, iar documentația oficială descrie acest lucru ca memorând în cache rezultatele execuției instrumentului. Documentația actuală a agenților arată că memorarea în cache este activată în mod implicit, iar instrucțiunile de performanță recomandă menținerea acesteia activată pentru utilizarea repetitivă a instrumentului.
Acest lucru este util atunci când un agent efectuează aceeași căutare costisitoare sau apelul unui instrument determinist de mai multe ori. Nu înseamnă că apelarea crew.kickoff()de două ori va omite automat sarcinile echipei. Sarcina aparține în continuare grafului de execuție.
Folosește memoria cache pentru citiri repetate. Folosește o cheie idempotență pentru scrieri repetate.
Operațiune
Protecție preferată
Căutați în aceeași documentație
Cache-ul instrumentelor
Reutilizați cunoștințele anterioare în mai multe sarcini
Memorie sau context de sarcină
Sari peste o sarcină opțională atunci când există deja suficiente date
ConditionalTask
Împiedicați declanșarea incorectă a unei ramuri Flow
Reproiectarea routerului, a condiției de stare and_sau a grafului
Prevenirea scrierilor externe duplicate la reîncercări/reporniri
Cheie idempotență persistentă sau stocare tranzacțională externă
9. Memoria reduce descoperirile repetate, dar nu anulează sarcinile
Sistemul de memorie unificat al CrewAI stochează informații după sarcini și recheamă contextul relevant înainte de sarcini. Documentele actuale precizează că, cu memoria echipajului activată, informațiile discrete sunt extrase din rezultatele sarcinilor, iar amintirile relevante sunt injectate în solicitările ulterioare ale sarcinilor.
Asta poate reduce redescoperirile inutile, mai ales când un scriitor ar trebui să știe ce a găsit deja un cercetător. Dar memoria este un context de recuperare, nu un indicator de omitere. O sarcină programată explicit rulează în continuare, cu excepția cazului în care logica Crew sau Flow decide altfel.
Folosește memoria pentru „Ce știm deja?”. Folosește starea sau o sarcină condițională pentru „Ar trebui să ruleze această operațiune?”. Consultați Memoria CrewAI .
10. Folosește ieșiri structurate pentru a face deciziile de omitere fiabile
Rezultatul în limbaj natural este dificil de utilizat pentru controlul determinist al fluxului de lucru. Sarcinile CrewAI pot returna ieșiri Pydantic sau JSON prin output_pydanticși output_json. Un rezultat structurat facilitează decizia dacă este necesară îmbogățirea, revizuirea, escalarea sau o altă sarcină.
Apoi, direcționează pe baza câmpurilor, în loc să ceri unui alt agent să interpreteze un paragraf în proză. Acest lucru reduce de obicei atât munca duplicată, cât și ambiguitatea promptă.
Configurație anti-redundanță recomandată
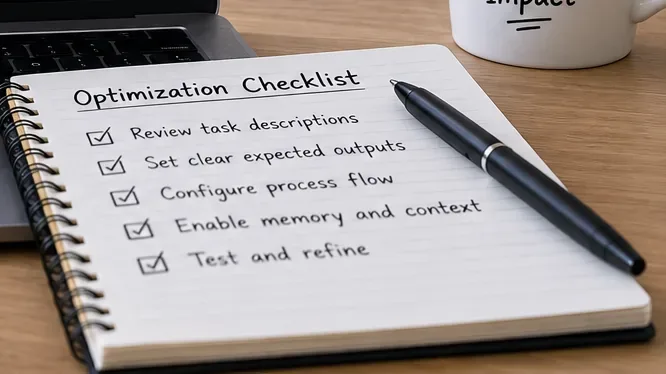
O listă de verificare compactă pentru revizuire este utilă înainte de creșterea complexității modelului: majoritatea problemelor de redundanță sunt mai ușor de rezolvat mai întâi în proiectarea sarcinilor și controlul fluxului.
Pentru o producție tipică de la cercetare la raport, începeți conservator:
Apoi adăugați complexitate doar atunci când o cerință o impune:
Adăugați memorie atunci când informațiile ar trebui reutilizate în mai multe sarcini sau rulări.
Adăugați o condițională ConditionalTask atunci când o activitate ar trebui să ruleze numai dacă rezultatul anterior este incomplet.
Folosește procesul ierarhic atunci când este cu adevărat necesară alocarea dinamică a managerilor.
Activați delegarea doar pentru agenții care trebuie să predea munca colegilor.
Adăugați bariere de protecție pentru calitatea rezultatelor, acceptând în același timp faptul că o barieră de protecție defectă provoacă intenționat reîncercări.
Adăugați persistența fluxului atunci când starea trebuie să supraviețuiască repornirilor.
Adăugați un strat extern de idempotență atunci când efectele secundare duplicate sunt inacceptabile.
Listă de verificare finală pentru depanare
Este același lucru Taskdeclarat de două ori în lista de sarcini a echipajului?
Două descrieri de sarcini autorizează aceeași cercetare sau apel la instrumente?
Poate o sarcină ulterioară să consume în schimb sarcina anterioară context?
Ar trebui ca sarcina repetată să fie un ConditionalTask?
Folosești orchestrare ierarhică când cea secvențială ar fi suficientă?
Este allow_delegationactivat pentru agenții care nu au nevoie de el?
O respingere a unui guardrail cauzează o reîncercare?
Este max_itersuficient de mare încât o singură sarcină să execute mai multe apeluri similare de instrumente?
Mai multe @start()metode sau or_ascultători folosesc aceeași echipă din aval?
O secundă kickoff()reprezintă o rulare nouă intenționată sau o invocare duplicată accidentală?
Te bazezi pe memorie sau pe memoria cache ca și cum ar fi controale de idempotență la nivel de sarcină?
Scrierile externe au o cheie de idempotență deterministă?
Pot jurnalele să dovedească dacă duplicatul a apărut la nivel de sarcină, pas de agent, instrument sau flux?
Concluzie
Oprirea muncii redundante CrewAI este în mare parte o problemă de orchestrare. Faceți responsabilitatea explicită, înlănțuiți sarcinile cu context, omiteți condiționat munca deja satisfăcută, mențineți delegarea restrânsă, înțelegeți când reîncercările sunt intenționate și urmăriți execuția înainte de a schimba solicitările. Pentru fluxuri și efecte secundare de producție, mergeți cu un pas mai departe: mențineți o cheie de finalizare deterministă sau utilizați un mecanism extern de idempotență.
Modelul mental util este simplu: contextul previne redescoperirea, condițiile previn sarcinile inutile, memoria cache previne calculul repetat al instrumentelor, iar idempotența previne efectele secundare repetate . Acestea rezolvă probleme conexe, dar nu sunt interschimbabile.