Reducerea facturii API LLM cu 50% este posibilă în multe sarcini de lucru, dar nu este o garanție universală. Rezultatul depinde de proveniența cheltuielilor: tokeni de intrare necacheți, tokeni de intrare cache-uiți, tokeni de ieșire, tokeni de raționament, apeluri de instrumente sau reîncercări. Compresia prompturilor funcționează cel mai bine atunci când intrările lungi sau repetitive reprezintă o parte semnificativă a facturii. Prin urmare, obiectivul practic nu este „să faci fiecare prompt de două ori mai scurt”. Este „să elimini tokenii care nu schimbă răspunsul, să păstrezi tokenii care îl schimbă și să verifici economiile pe traficul real”.
Acest ghid utilizează patru pași de implementare: măsurarea liniei de bază, eliminarea intrărilor redundante, organizarea prompturilor pentru reutilizarea cache-ului și mutarea instrucțiunilor verbioase de ieșire în controale structurate, acolo unde API-ul le suportă. Exemplele sunt ilustrative, nu afirmații de benchmark. Prețurile furnizorilor și comportamentul cache-ului se schimbă în timp, așa că verifică tarifele curente înainte de a face o estimare pentru producție.
Ce necesită de fapt o reducere a costurilor API cu 50%?
Începe cu ecuația de facturare pentru modelul tău. Pentru o sarcină de lucru text simplă, costul total al cererii este aproximativ costul intrării necacheate plus intrarea cache-uită plus ieșirea. Unele modele sau funcții adaugă alte categorii facturabile. Răspunsurile actuale ale API-ului OpenAI expun utilizarea tokenilor de intrare și ieșire, inclusiv detaliile privind tokenii cache-uiți, iar paginile modelelor publică tarife separate pentru intrare, intrare cache-uită și ieșire.
| Sarcină de lucru ilustrativă | Tokeni de intrare | Tokeni de ieșire | Rezultat relativ |
|---|
| Cerere de bază | 10.000 | 1.000 | 100% din costul de bază |
| Doar intrarea este înjumătățită | 5.000 | 1.000 | Mai puțin de 50% economie totală când ieșirea rămâne neschimbată |
| Intrarea și ieșirea sunt ambele înjumătățite | 5.000 | 500 | Aproximativ 50% cost mai mic bazat pe tokeni când tarifele sunt neschimbate |
Pentru un exemplu concret actual, pagina oficială a modelului GPT-5.6 Sol lista, la 11 septembrie 2026, 4 USD per milion de tokeni de intrare, 0,40 USD per milion de tokeni de intrare cache-uiți și 20 USD per milion de tokeni de ieșire. La aceste tarife, o cerere cu 10.000 de tokeni de intrare și 1.000 de tokeni de ieșire costă aproximativ 0,06 USD înainte de alte taxe. Reducerea doar a intrării la 5.000 de tokeni aduce acest exemplu la aproximativ 0,04 USD, o reducere de 33%. Reducerea la jumătate atât a intrării, cât și a ieșirii, aduce costul la aproximativ 0,03 USD, o reducere de 50%. Aceste prețuri se pot schimba, așa că tratează calculul ca pe o metodă, nu ca pe o ofertă permanentă. Vezi pagina oficială a modelului GPT-5.6 Sol pentru prețurile curente.
Referință rapidă: cele patru mișcări cu cea mai mare valoare
| Tehnică | Cel mai bun fit | Risc principal | Ce să măsori |
|---|
| Audit de tokeni | Orice sarcină de lucru de producție | Optimizarea componentei greșite | Intrare, intrare cache-uită, ieșire, reîncercări, cost per sarcină reușită |
| Eliminarea redundanței | Prompturi de sistem lungi, politici repetate, exemple verbioase | Ștergerea unei constrângeri care contează cu adevărat | Succesul sarcinii și paritatea respectării instrucțiunilor |
| Layout prietenos cu cache-ul | Cereri repetate care împărtășesc instrucțiuni sau context stabil | Reutilizare scăzută a cache-ului deoarece textul dinamic apare prea devreme | Raportul de tokeni cache-uiți și latența |
| Controale de ieșire structurată | Extracție JSON, clasificare, formate de răspuns fixe | Schemă prea rigidă pentru sarcină | Tokeni de ieșire, eșecuri de analiză, reîncercări |
Pasul 1: Măsoară linia de bază reală a tokenilor înainte de a modifica prompturile
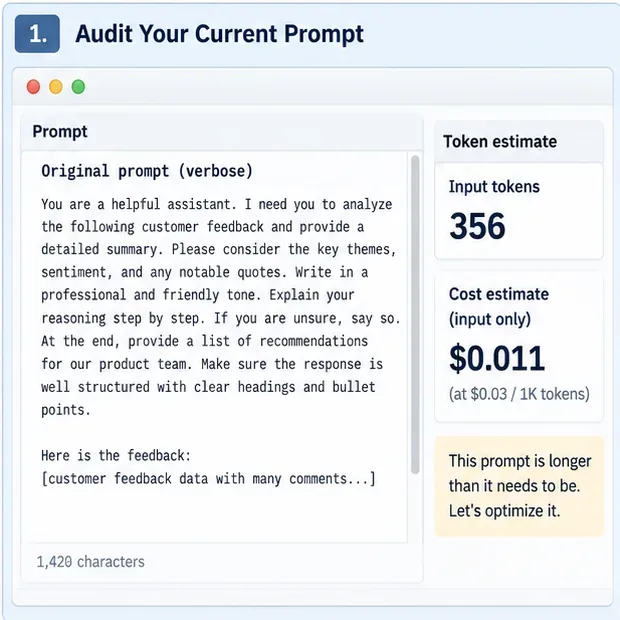
Caption: O interfață ilustrativă de audit de tokeni înregistrează dimensiunea originală a promptului și o estimare de cost eșantion înainte de compresie; cifrele nu sunt prețurile curente ale furnizorului.
Colectează un eșantion reprezentativ de cereri de producție, în loc să optimizezi un singur prompt ales manual. Cel puțin, înregistrează tokenii de intrare, tokenii de intrare cache-uiți când sunt disponibili, tokenii de ieșire, numele modelului, latența, reîncercările și dacă răspunsul final a trecut verificarea ta de calitate de afaceri. Dacă furnizorul tău oferă un endpoint de numărare a tokenilor de intrare, folosește-l înainte de a trimite cereri când ai nevoie de bugetare deterministă. OpenAI documentează în prezent un endpoint de numărare a tokenilor de intrare pentru Responses în referința oficială a API-ului.
Calculează costul per sarcină reușită, nu doar costul per apel API. Un prompt comprimat care cauzează mai multe reîncercări poate fi mai scump, chiar dacă fiecare cerere este mai scurtă. Segmentează linia de bază și după tipul de sarcină: rezumare, extracție, răspunsuri la întrebări RAG, utilizare agentivă a instrumentelor și conversații lungi au de obicei profile diferite de tokeni.
Pasul 2: Elimină redundanța fără a șterge informații critice pentru decizie

Caption: Un prompt ilustrativ înainte și după păstrează aceleași ieșiri solicitate, eliminând formulările repetate și instrucțiunile de proces unnecessary.
Cea mai sigură primă trecere de compresie este deduplicarea semantică. Șterge descrierile de rol repetate, constrângerile duplicate, umplutura politicoasă, explicațiile despre formatarea evidentă și exemplele care învață același model de mai multe ori. Combină regulile suprapuse într-o singură instrucțiune. Preferă o propoziție precisă în locul mai multor propoziții care reiau aceeași cerință.
Înainte
Ești un asistent util care este expert în analiza produselor.
Am nevoie să analizezi următorul feedback al clienților și să furnizezi
un rezum detaliat. Te rog să identifici temele cheie, sentimentul general,
citatele notabile și recomandările pentru echipa noastră de produs. Asigură-te
că răspunsul tău este profesional, clar, concis și bine structurat.
După
Analizează feedback-ul clienților.
Returnează: teme cheie, sentiment general, citate notabile și recomandări de produs.
Fii concis și factual.
Nu comprima excepțiile, limitele de politică, definițiile de domeniu, regulile de siguranță ale instrumentelor sau cerințele de dovezi doar pentru că sunt lungi. Acestea sunt adesea tokeni de valoare mare. Un test util este să întrebi: „Dacă elimin această propoziție, se poate schimba ieșirea acceptabilă?” Dacă da, păstreaz-o, cu excepția cazului în care un control API sau o schemă poate impune același comportament mai fiabil.
Pasul 3: Pune conținutul stabil primul și conținutul dinamic ultimul
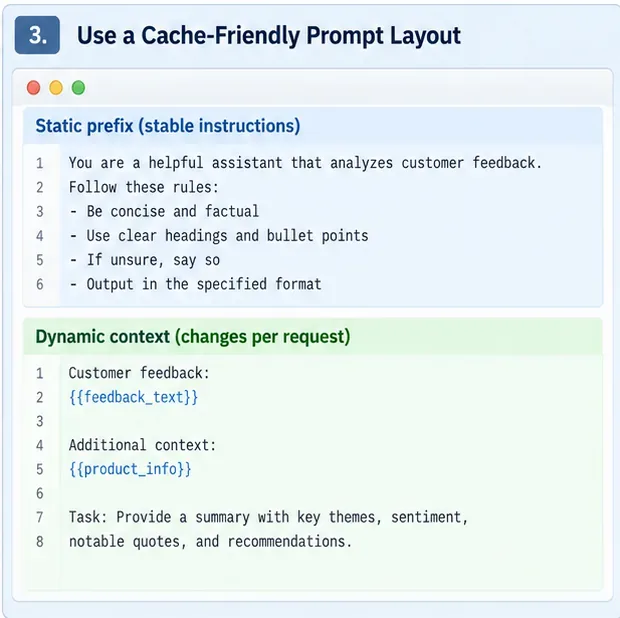
Caption: Un layout ilustrativ de prompt plasează instrucțiunile stabile într-un prefix reutilizabil și adaugă contextul specific cererii mai târziu.
Cache-ul de prompturi nu reduce numărul brut de tokeni, dar poate reduce suma facturată la tariful normal de intrare și poate scădea latența de procesare a promptului. Acest lucru face ca layout-ul promptului să fie parte a optimizării costurilor. Grupează instrucțiunile de sistem, exemplele partajate, ghidajul instrumentelor și alte conținuturi stabile împreună. Pune faptele specifice cererii, pasajele recuperate, datele utilizatorului și întrebarea curentă mai târziu.
Ghidajul modelului OpenAI recomandă explicit plasarea conținutului static primul și a conținutului dinamic ultimul pentru a îmbunătăți reutilizarea cache-ului de prompturi, iar obiectul de utilizare a răspunsului expune informații despre tokenii cache-uiți pentru măsurare. Vezi ghidajul oficial al modelului și referința API Responses.
Evită modificarea spațiilor albe inofensive, ordinea exemplelor, marcajele temporale, ID-urile aleatorii sau textul per utilizator în interiorul unui prefix altfel reutilizabil, cu excepția cazului în care semantica cache-ului furnizorului spune că aceste modificări sunt sigure. Măsoară loviturile de cache din răspunsul API în loc să presupui că un prompt este reutilizat.
Pasul 4: Înlocuiește proza despre format cu controale de ieșire structurată
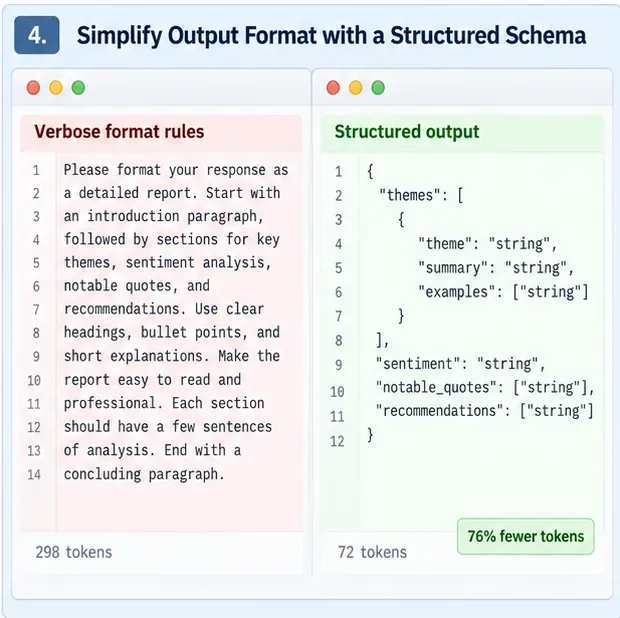
Caption: O vedere ilustrativă a ieșirii structurate arată cum o schemă poate înlocui multe linii de proză care descriu în mod repetat aceeași formă de răspuns.
Prompturile de extracție și clasificare irosesc adesea tokeni descriind câmpurile JSON, valorile permise, imbricarea, ordinea și regulile de validare în limbaj natural. Când API-ul suportă ieșiri structurate sau argumente de instrumente tipizate, mută cât mai mult din acel contract în interfața structurată și menține instrucțiunea în limbaj natural concentrată pe sens.
Ghidajul actual OpenAI recomandă specific eliminarea definițiilor schemei de ieșire din prompt unde este posibil și utilizarea în schimb a Structured Outputs. Acest lucru poate reduce textul promptului și poate reduce, de asemenea, reîncercările pentru ieșiri malformate. Mecanismul exact variază în funcție de furnizor, așa că nu copia un format de cerere specific OpenAI într-un alt API fără a verifica documentația acelui furnizor.
Compresie avansată pentru RAG, documente lungi și conversații
După ce cei patru pași de bază sunt stabili, economiile mai mari provin de obicei din reducerea contextului, nu din lustruirea formulărilor propozițiilor. În sistemele RAG, recuperează mai puține, dar mai relevante pasaje, deduplică bucățile aproape identice și evită atașarea documentelor care nu pot afecta răspunsul. Pentru conversații lungi, păstrează faptele durabile și deciziile nerezolvate, dar rezumă sau elimină turele care nu mai influențează sarcina curentă. Pentru sistemele agentice, expune doar instrumentele și descrierile instrumentelor relevante pentru etapa curentă, atunci când arhitectura ta permite acest lucru în siguranță.
Compresoarele de prompturi învățate sunt o altă opțiune pentru contexte foarte lungi. Proiectul open-source LLMLingua al Microsoft implementează compresia prompturilor la nivel de token. Lucrarea originală LLMLingua a raportat rapoarte de compresie de până la 20× cu degradare limitată a benchmark-ului în seturile evaluate. LongLLMLingua vizează sarcini cu context lung, în timp ce LLMLingua-2 utilizează un compresor învățat agnostic la sarcină. Acestea sunt rezultate de cercetare, nu o promisiune că aceleași rapoarte vor păstra calitatea pe datele tale. Benchmark-uiește-ți propriile sarcini, limbi, modele și tipuri de prompturi înainte de a implementa compresia agresivă.
Cum să dovedești că optimizarea este chiar mai bună
Rulează o evaluare A/B pe aceleași cereri reprezentative. Versiunile de bază și comprimate ar trebui să utilizeze același model, setări de raționament, instrumente, intrări de recuperare și criterii de succes. Schimbă o tehnică de compresie la un moment dat, când este posibil, pentru a putea identifica ce a cauzat o regresie.
| Metrică | De ce contează | Interpretare sugerată |
|---|
| Reducerea tokenilor de intrare | Arată micșorarea brută a promptului | Utilă, dar nu suficientă singură |
| Raportul de tokeni cache-uiți | Arată dacă prefixele stabile sunt reutilizate | Mai mare este de obicei mai bine când calitatea este neschimbată |
| Reducerea tokenilor de ieșire | Poate schimba material costul total | Verifică dacă ieșirea concisă încă finalizează sarcina |
| Cost per sarcină reușită | Include reîncercările și eșecurile | Aceasta este metrica de afaceri primară |
| Succesul sarcinii / acuratețea | Detectează pierderea de informații | Setează un prag de non-inferioritate acceptabil înainte de testare |
| Latența p50 și p95 | Arată impactul real asupra utilizatorului | Preprocesarea compresiei poate anula economiile de inferență |
Nu declara victoria pentru că un prompt este cu 50% mai scurt. Condiția de acceptare mai puternică este: configurația comprimată reduce costul măsurat cu aproximativ suma țintă, rămânând în limitele tale predefinite de toleranță pentru calitate, latență și fiabilitate.
Când ar trebui să te oprești din comprimare?
Oprește-te sau dă înapoi când următoarea reducere elimină faptele necesare pentru decizii corecte, crește halucinațiile, cauzează erori de apelare a instrumentelor, slăbește conformitatea cu politica sau crește reîncercările suficient pentru a șterge economiile. Compresia poate adăuga, de asemenea, latență dacă rulezi un model separat pentru a comprima fiecare prompt. Un studiu din 2026 al compresiei prompturilor în setări reale de inferență a constatat că suprasarcina de preprocesare poate anula câștigurile de inferență în afara regimurilor favorabile de lungime a promptului și hardware, ceea ce este un alt motiv pentru a măsura performanța end-to-end, nu doar numărul de tokeni.
Pentru prompturi mici, curățarea manuală și organizarea prietenoasă cu cache-ul sunt de obicei mai ușor de justificat decât adăugarea unui model de compresie dedicat. Pentru payload-uri RAG mari sau fluxuri de lucru cu documente multiple, selecția contextului și compresia învățată devin mai atractive deoarece volumul de tokeni eliminabili este mult mai mare.
Checklist rapid de implementare
- Capturează o linie de bază de producție cu intrare, intrare cache-uită, ieșire, latență, reîncercări și succesul sarcinii.
- Elimină mai întâi instrucțiunile duplicate, proza de valoare scăzută și exemplele redundante.
- Păstrează definițiile de domeniu, excepțiile, cerințele de dovezi și constrângerile de siguranță.
- Pune conținutul stabil al promptului înaintea conținutului dinamic specific cererii când semantica cache-ului recompensează prefixele reutilizabile.
- Folosește ieșiri structurate sau scheme de instrumente în loc să descrii în mod repetat formate de răspuns fixe în proză.
- Pentru RAG, reduce contextul irelevant și duplicat înainte de a încerca compresia la nivel de token.
- Limitează lungimea ieșirii doar atunci când sarcina poate fi încă finalizată corect.
- Compară costul per sarcină reușită, nu doar numărul de tokeni din prompt.
- Rulează teste de regresie înainte și după fiecare modificare semnificativă de compresie.
- Reverifică prețurile furnizorului și regulile de cache ori de câte ori schimbi modelele sau versiunile API.
Concluzie
O reducere de 50% este o țintă de inginerie rezonabilă pentru unele sarcini de lucru verbioase, cu context greu, dar ar trebui tratată ca un rezultat de validat, nu ca o așteptare implicită. Cea mai fiabilă cale este să măsori mai întâi, să elimini textul semantic redundant, să maximizezi reutilizarea sigură a cache-ului, să scurtezi contractele de ieșire cu controale structurate și apoi să ataci cele mai mari blocuri de context rămase cu tăierea recuperării, rezumarea sau un compresor de prompturi testat. Dacă costul final per sarcină reușită scade în timp ce calitatea rămâne în banda ta de acceptare, compresia funcționează. Dacă calitatea sau reîncercările se deteriorează, restaurează informațiile lipsă și optimizează o altă parte a cererii.
Referințe principale








