Главная
» Домены
»
Как автоматически генерировать SEO-мета-заголовки и описания с помощью Local Ollama
Как автоматически генерировать SEO-мета-заголовки и описания с помощью Local Ollama
У вас есть 300 страниц товаров, документации или блога, готовых к публикации, но столбец метаданных по-прежнему пуст. Написание каждого заголовка и метаописания вручную — медленный процесс; копирование одного шаблона по всему сайту приводит к повторяющимся результатам; а запрос к локальной языковой модели на «SEO-заголовок» часто выдает лишние комментарии, вымышленные утверждения или непоследовательное форматирование.
Более эффективный подход заключается в том, чтобы рассматривать генерацию метаданных как небольшой конвейер обработки данных: предоставлять модели только данные, специфичные для конкретной страницы, требовать структурированный вывод, проверять его в коде, а затем анализировать исключения перед публикацией. Ollama хорошо подходит для такого рабочего процесса, поскольку ее локальный API доступен после http://localhost:11434/apiустановки, и Ollama поддерживает структурированный вывод в формате JSON-схемы. Документация Ollama и Google Search, на которую здесь ссылаются, была проверена 13 сентября 2026 года.
Почему автоматическая SEO-метаданалитика работает неправильно
Большинство сбоев происходит из-за особенностей рабочего процесса вокруг модели, а не из-за одного «неправильного запроса». К распространенным причинам относятся: предоставление слишком малого количества контента для страницы, предоставление модели возможности отвечать в свободной форме, применение одной и той же формулы ключевых слов ко всем URL-адресам и публикация результатов без проверки на дублирование на уровне сайта.
Существует также распространённое заблуждение относительно ограничений по количеству символов. Google утверждает, что фиксированного ограничения по длине для элементов страницы <title>или мета-описаний нет; заголовки ссылок и сниппеты обрезаются по мере необходимости, как правило, в зависимости от ширины экрана устройства. Google также может генерировать другой заголовок ссылки или сниппет из содержимого страницы, если его системы сочтут другое представление более полезным. См. официальные рекомендации Google по заголовкам ссылок , сниппетам и мета-описаниям .
Это означает, что скрипт может устанавливать ограничения по длине текста для обеспечения единообразия, но не должен обозначать эти числа как требования Google. В приведенном ниже примере 65 символов для заголовка и 165 для описания являются лишь внутренними ограничениями. Измените их в соответствии с вашей CMS, брендом, потребностями локализации и процессом проверки.
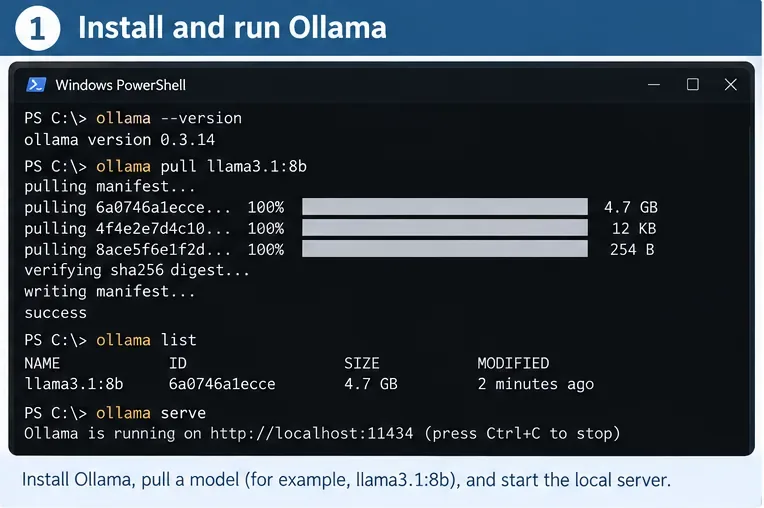
Шаг 1: Установите Ollama и убедитесь, что локальный API работает.
В официальном руководстве по быстрому запуску Ollama указаны поддерживаемые macOS, Windows и Linux. После установки загрузите локальную модель. В текущей документации Ollama часто используется gemma3в примерах API, поэтому это удобный нейтральный пример для данного руководства:
ollama pull gemma3
Затем проверьте локальную конечную точку:
curl http://localhost:11434/api/generate -d '{"model":"gemma3","prompt":"Reply with the word ready.","stream":false}'
В документации API Ollama указано, что локальный API обслуживается по адресу http://localhost:11434/api. Ollama также заявляет, что локальный доступ по этому адресу не требует аутентификации. Если ваша локальная служба не запущена, ollama serveиспользуйте документированную команду CLI для ее запуска. Избегайте подстановки -cloudмодели, если ваша цель — действительно локальный вывод результатов.
Схема рабочего процесса на этапе настройки: проверка Ollama, загрузка локальной модели, подтверждение ее наличия в локальном списке моделей и обеспечение доступности сервиса на localhost. Приведенные значения имени модели и длины являются примерами значений рабочего процесса, а не требованиями SEO.
Выберите модель в соответствии с вашим оборудованием.
В этой статье намеренно не утверждается, что существует универсальная модель, которая лучше всего подходит для SEO-метаданных. Доступность моделей и совместимость с оборудованием меняются со временем, а более крупные модели требуют больше памяти и, как правило, работают медленнее. Начните с модели, которую ваш компьютер может комфортно обрабатывать, сгенерируйте небольшой набор отзывов, а затем сравните фактическую точность, уникальность, задержку и согласованность, прежде чем обрабатывать тысячи страниц.
Шаг 2: Принудительно формируйте структурированный вывод вместо анализа текста.
Свободный текст плохо поддается автоматизации. Ответ типа «Вот три отличных варианта…» заставляет вашу программу гадать, где начинается фактический заголовок. Документация Ollama по структурированным выводам поддерживает передачу JSON-схемы в formatполе. В документации также рекомендуется использовать многократно применяемые схемы через Pydantic в Python и отмечается, что низкая температура, например 0, может повысить детерминизм.
Установите два пакета Python, использованных в этом примере:
python -m pip install -U ollama pydantic
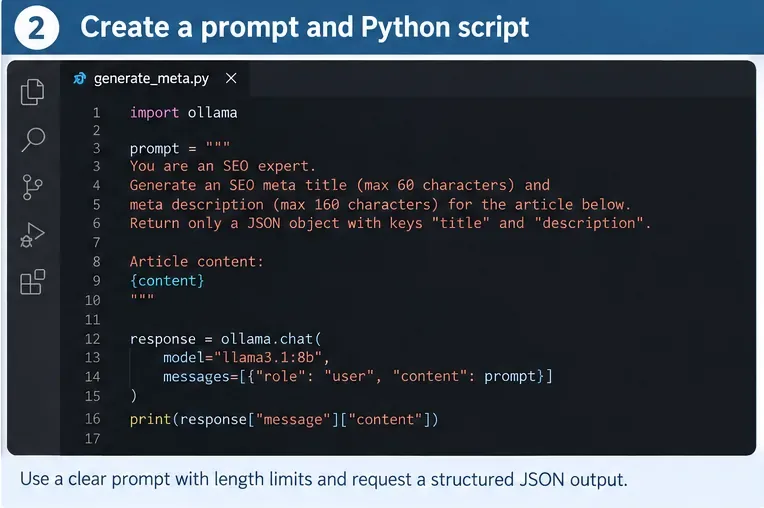
Затем создайте generate_meta.py:
from ollama import Client
from pydantic import BaseModel, Field

MODEL = "gemma3"
client = Client(host="http://localhost:11434")

class SeoMeta(BaseModel):
    title: str = Field(min_length=10, max_length=65)
    description: str = Field(min_length=70, max_length=165)

SYSTEM = """
You create SEO metadata from the page content supplied by the user.

Rules:
- Accurately describe only what is present in the page content.
- Write a concise, descriptive title.
- Write a useful meta description that distinguishes this page from other pages.
- Do not repeat keywords unnaturally.
- Keep the same primary language as the page.
- Do not invent prices, dates, features, guarantees, statistics, or claims.
- The length bounds in the JSON schema are our editorial limits, not Google rules.
- Return only the structured result required by the schema.
"""

def generate_meta(url: str, source_title: str, h1: str, body_text: str) -> SeoMeta:
    prompt = f"""
URL: {url}
Current title: {source_title}
H1: {h1}

Page text:
{body_text[:12000]}

Create one meta title and one meta description for this page.
"""
    response = client.chat(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        format=SeoMeta.model_json_schema(),
        options={"temperature": 0},
    )
    return SeoMeta.model_validate_json(response.message.content)

if __name__ == "__main__":
    result = generate_meta(
        url="https://example.com/guides/clean-cast-iron",
        source_title="Cast Iron Guide",
        h1="How to Clean a Cast-Iron Skillet Without Damaging the Seasoning",
        body_text=(
            "This guide explains how to remove stuck food, wash a cast-iron "
            "skillet, dry it thoroughly, and apply a thin layer of oil..."
        ),
    )
    print(result.model_dump_json(indent=2))
Генератор должен четко указывать информацию о страницах, полях вывода и редакционных ограничениях. В производственной среде предпочтительнее использовать структурированный вывод Ollama в формате JSON-схемы и проверку на стороне приложения, чем полагаться только на формулировку подсказки.
Почему в задании указаны текущий заголовок и H1?
Google утверждает, что его система ссылок по заголовкам может учитывать основной визуальный заголовок страницы <title>, заголовки типа <h1><head>, og:title<head>, выделенный текст, текст ссылки и другие сигналы. Вашему локальному генератору не обязательно воспроизводить систему Google, но указание исходного заголовка, заголовка H1, URL и репрезентативного текста основного содержимого помогает поддерживать соответствие предлагаемых метаданных странице, которую фактически увидят читатели.
Не следует загружать в модель списки несвязанных ключевых слов и просить её «вписать их». Google настоятельно рекомендует использовать описательные, лаконичные заголовки и предостерегает от перенасыщения ключевыми словами и повторения шаблонного текста. Что касается описаний, Google утверждает, что программная генерация описаний для каждой страницы подходит для крупных сайтов, использующих базы данных, если описания точны, понятны человеку и разнообразны.
Шаг 3: Запустите одну страницу, затем проведите валидацию, прежде чем масштабировать.
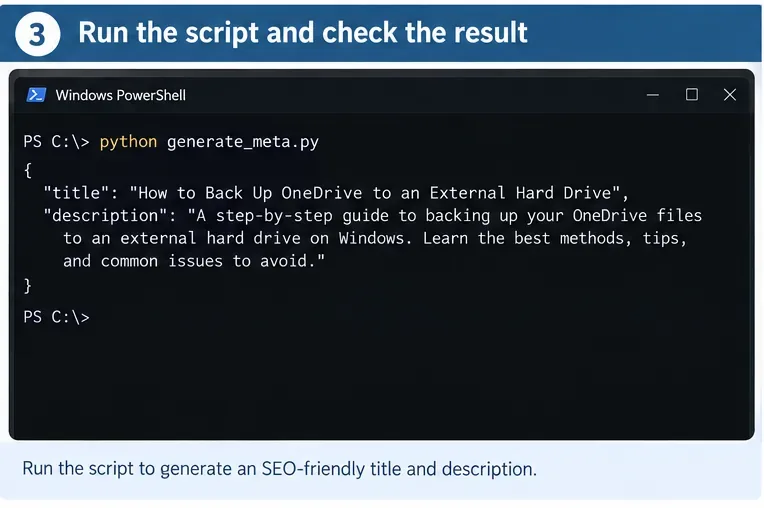
Запустите скрипт:
python generate_meta.py
Успешный результат должен представлять собой JSON-объект, который Pydantic сможет проверить. Что еще важнее, человек-проверяющий должен иметь возможность сравнить его с исходной страницей и быстро ответить на четыре вопроса:
Заголовок описывает именно эту страницу, а не весь сайт в целом?
В описании отсутствуют утверждения, даты, цены или характеристики, которые не указаны в исходном контенте?
Будут ли эти метаданные иметь смысл, если их читать без основного текста страницы?
Отличается ли это от метаданных, уже используемых на соседних страницах?
Сначала протестируйте одну репрезентативную страницу и проверьте структурированный результат, прежде чем запускать пакетное задание. Необходим JSON-ответ, пригодный для анализа, но точность фактов и релевантность на уровне страницы по-прежнему требуют проверки.
Добавьте возможность повторных попыток для случаев сбоев редактирования, а не только для ошибок API.
Схема может ограничивать типы и длину данных, но она не может гарантировать, что предложение является правдивым или достаточно конкретным. Разрабатывайте логику повторных попыток на основе измеримых проверок. Например, отклоняйте пустое поле, повторяющийся заголовок, запрещенный шаблонный текст или описание, которое почти дословно повторяет заголовок. Если страница содержит регулируемые или важные утверждения, требуйте проверки человеком, а не пытайтесь автоматизировать процесс проверки достоверности.
Не затягивайте с подсказками о необходимости повторной попытки. Вместо того чтобы перегенерировать всё с фразой «исправьте», сообщите модели, что именно не удалось: «Предложенный заголовок дублирует другую страницу. Перепишите его, используя уникальную тему из заголовка H1, при этом сохраняя все утверждения в рамках предоставленного контента». Это упростит аудит ошибок.
Шаг 4: Пакетная загрузка страниц в CSV-файл для проверки и публикации.
После того как одностраничный тест станет надежным, сохраните входные данные в CSV-файле со столбцами, такими как url, source_title, h1, и content. Поле содержимого должно содержать очищенный текст страницы, а не навигационные меню, уведомления о файлах cookie или тысячи несвязанных ссылок в нижнем колонтитуле.
Добавьте эту логику пакетной обработки ниже функции генератора или поместите ее в отдельный скрипт:
import csv

rows = []
seen_titles = set()

with open("pages.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        meta = generate_meta(
            url=row["url"],
            source_title=row.get("source_title", ""),
            h1=row.get("h1", ""),
            body_text=row["content"],
        )

        flags = []
        normalized = meta.title.casefold().strip()
        if normalized in seen_titles:
            flags.append("duplicate_title")
        seen_titles.add(normalized)

        rows.append({
            **row,
            "generated_title": meta.title,
            "generated_description": meta.description,
            "title_length": len(meta.title),
            "description_length": len(meta.description),
            "qa_flags": ",".join(flags),
        })

with open("seo_meta_output.csv", "w", newline="", encoding="utf-8") as f:
    fieldnames = list(rows[0].keys())
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(rows)
Полученный CSV-файл можно просмотреть в Excel, LibreOffice, инструменте импорта баз данных или в рабочем процессе вашей CMS. Не перезаписывайте автоматически актуальные метаданные при первом запуске. Сохраняйте исходный заголовок и описание вместе с сгенерированным предложением, чтобы рецензенты могли их сравнить, и чтобы откат был простым.
Очередь проверки в виде электронных таблиц упрощает аудит массового создания файлов: перед публикацией изменений сохраняются идентификатор исходной страницы, сгенерированный заголовок, сгенерированное описание, длина и флаги контроля качества.
Сделайте конвейер пакетной обработки более безопасным.
Проверять
Что отметить
Почему это важно
Проверка схемы
Отсутствующие или недопустимые поля
Предотвращает попадание некорректных данных в систему управления контентом.
Проверка наличия дубликатов документов на право собственности
Один и тот же нормализованный заголовок на двух URL-адресах.
Помогает различать страницы.
Проверка языка
Язык метаданных отличается от языка страницы.
Google рекомендует использовать язык и систему письма, соответствующие основному языку страницы.
Проверка доказательств
Цифры, цены, даты, марки или гарантии, отсутствующие в источнике.
Уменьшает количество галлюцинаторных заявлений.
Стандартная проверка
Длинные повторяющиеся фразы, встречающиеся на всем сайте.
Google не рекомендует использовать повторяющиеся стандартные заголовки.
Проверка длины редакционного текста
За пределами выбранного вами диапазона цен на жилье
Обеспечивает единообразие вывода в CMS; это не правило ограничения количества символов, установленное Google.
Проверка человеком
Стратегически важные, конфиденциальные, страницы с высокой посещаемостью или страницы с неоднозначной информацией
Автоматизация должна выявлять исключения, а не скрывать их.
Типичные проблемы, от самых простых до самых сложных.
Подключение к API не удается.
Сначала убедитесь, что Ollama запущена и http://localhost:11434доступна. В официальной документации по аутентификации указано, что аутентификация для локального API не требуется. Если ваш скрипт случайно указывает на https://ollama.com/apiдругой размещенный конечный пункт, для которого требуется аутентификация.
Ответ содержит текст, обрамляющий JSON-данные.
Используйте схему целиком format=SeoMeta.model_json_schema(), а не запрашивайте только JSON на естественном языке. Структурированный вывод — это подходящий уровень управления для производственного конвейера.
Все названия звучат одинаково.
Введите для каждой страницы текст заголовка H1 и содержательный основной контент, удалите лишние элементы глобальной навигации и явно запросите описание, специфичное для каждой страницы. Затем выполните проверку на дубликаты и сходство между страницами. Повторение часто является проблемой на входных данных, прежде чем стать проблемой модели.
Модель создает признаки или статистические данные.
Сократите входные данные до текста авторитетной страницы и ужесточите правило обоснования: никаких фактических утверждений, выходящих за рамки предоставленного контента. Для важных страниц сравнивайте сгенерированные утверждения со структурированными полями источника перед утверждением. Если сам источник неоднозначен, отправьте строку на проверку человеку, вместо того чтобы неоднократно предлагать модели угадывать.
Модель работает слишком медленно для обработки тысяч страниц.
Перед изменением архитектуры проведите измерения. Зарегистрируйте время генерации страницы, размер входных данных, имя модели и частоту ошибок. Удалите нерелевантный основной текст, обработайте стабильные разделы страницы и протестируйте локальную модель меньшего размера, если качество остается приемлемым. Самая быстрая модель бесполезна, если ее метаданные создают больше работы по проверке, чем экономят.
Дополнительно: используйте существующую интеграцию в стиле OpenAI.
Если у вас уже есть код, написанный для клиента, совместимого с OpenAI, Ollama документирует частичную совместимость с API OpenAI по адресу [ http://localhost:11434/v1/ссылка на документацию]. Это может сократить объем работы по миграции. Для нового инструмента, работающего только с локальными метаданными, нативный клиент Ollama на Python проще и предоставляет примеры структурированного вывода непосредственно в документации Ollama.
Как самостоятельно проверить готовую систему
Прежде чем считать автоматизацию завершенной, создайте набор отзывов, содержащий различные типы контента: короткую статью, подробное руководство, страницу товара, страницу категории, страницу с цифрами и страницу на каждом поддерживаемом языке. Запустите одну и ту же модель и запрос для всех отзывов, затем проверьте следующий контрольный список.
Локальная конечная точка — это [укажите адрес] localhost, и выбранная модель является локальной, а не моделью с облачными метками.
Каждый ответ проверяется на соответствие схеме без ручной очистки JSON.
В наборе отзывов ни один сгенерированный заголовок не дублируется.
Все фактические утверждения содержатся в предоставленном контенте страницы.
Метаданные используют тот же основной язык и систему письма, что и страница.
Заголовок описательный и лаконичный, без повторения ключевых слов.
Описание кратко описывает конкретную страницу, а не сайт в целом.
Ваши внутренние ограничения по длине обозначены как редакционные правила, а не требования Google.
Старые метаданные, сгенерированное предложение, флаги контроля качества, название модели и версия запроса сохраняются для проверки и отката.
Рецензент знает, какие флаги требуют ручной проверки перед публикацией.
Наконец, помните, что автоматизация может контролировать, а что нет. Хорошее <title>мета-описание предоставляет поисковым системам полезные сигналы на уровне страницы, но Google может генерировать заголовки, ссылки и сниппеты из другого контента страницы. Поэтому цель состоит не в том, чтобы навязывать определенный вариант отображения результатов поиска. Цель состоит в том, чтобы создавать точные, уникальные и полезные метаданные в больших масштабах, сохраняя при этом достаточную проверку и анализ для выявления ошибок до того, как они попадут в рабочую среду.