Главная
» Домены
»
Как исправить ошибку «Превышен контекстный лимит» при анализе длинных документов, не потеряв ключевые данные.
Как исправить ошибку «Превышен контекстный лимит» при анализе длинных документов, не потеряв ключевые данные.
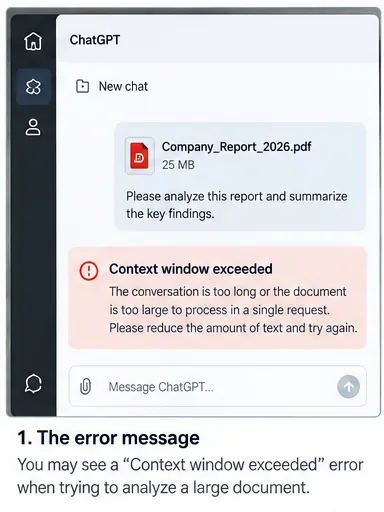
Вы загружаете длинный отчет, запрашиваете подробный анализ, и вместо ответа получаете сообщение типа «Превышен лимит контекстного окна», «Превышен максимальный лимит контекстного окна» или другое предупреждение о том, что запрос слишком большой. Самое неприятное то, что файл мог быть успешно загружен, и тот же документ мог бы подойти даже для более узкого вопроса.
Причина проста, но её легко упустить из виду: ограничение на загрузку и контекстное окно модели — это не одно и то же. Модель должна уместить материал, который она активно рассматривает, в ограниченный бюджет токенов. Этот бюджет может включать ваши инструкции, историю переписки, текст, извлеченный из файлов, определения инструментов, полученные фрагменты текста, токены рассуждений и место для ответа. Таким образом, документ может быть разрешен для загрузки, но при этом оказаться слишком большим для анализа за один проход.
Лучшее решение, как правило, — не повторять одну и ту же сложную попытку. Начните с наименее радикальных изменений, а затем переходите к разбивке на части, извлечению информации или рабочему процессу с более широким контекстом только в том случае, если более простой подход по-прежнему не срабатывает.
Во-первых, убедитесь, что ошибка действительно связана с контекстным окном.
Прежде чем вносить изменения в документ, следует различать контекстную ошибку и ограничение на загрузку или хранение данных. В текущих рекомендациях OpenAI по загрузке файлов указано, что файлы, загружаемые в ChatGPT или GPT, имеют жесткое ограничение в 512 МБ на файл, в то время как текстовые и документные файлы ограничены 2 миллионами токенов на файл. Это ограничения на загрузку, а не гарантия того, что весь текст будет помещен в активный контекст модели одновременно.
Раздел часто задаваемых вопросов (FAQ) по загрузке файлов на сайте OpenAI — это авторитетный источник информации о текущих лимитах загрузки. Точные лимиты различаются в зависимости от продукта, тарифного плана, модели и провайдера, поэтому не следует предполагать, что число, скопированное из старой статьи, по-прежнему актуально.
То, что вы видите
Вероятное узкое место
Лучший первый ход
Файл отклоняется до начала анализа.
Размер файла, тип файла, объем хранилища или квота на загрузку.
Проверьте текущие правила загрузки.
Файл загружается, но длительный запрос завершается ошибкой контекста.
Активный запрос превышает контекстный бюджет модели.
Сократите запрос и уменьшите активный контекст.
Ответ охватывает первые страницы, но не включает последующие разделы.
Не весь материал был помещен непосредственно в контекст, или же при поиске были упущены важные фрагменты.
Задавайте более узкие вопросы или разделяйте вопросы по разделам.
Разговор вначале казался удачным, но после многих попыток потерпел неудачу.
Накопленная история чата расходует контекст.
Начните новую аналитическую ветку с кратким обзором результатов.
Ошибка контекстного окна может появиться после успешной загрузки документа, поскольку активный запрос все еще должен соответствовать бюджету токенов модели.
Шаг 1: Измерьте документ, прежде чем вносить в него изменения.
Количество страниц и мегабайты — полезные подсказки, но для понимания контекста текста важна именно токенизация. Токенизация зависит от языка, форматирования, пунктуации и кодировки модели, поэтому для 100-страничного технического руководства может потребоваться совершенно другое количество токенов, чем для 100-страничной презентации.
В рекомендациях OpenAI по подсчету токенов предлагается проверять контекстное окно целевой модели и оставлять место для выходных данных, а для моделей, выполняющих рассуждения, — для токенов рассуждений. Также отмечается, что структура сообщений, инструменты, файлы, изображения и схемы могут добавлять токены помимо подсчитываемого обычного текста.
Для быстрой оценки объема запишите количество страниц файла, приблизительное количество слов, число основных разделов, а также наличие приложений, повторяющихся юридических формулировок, необработанных журналов, стенограмм, таблиц или ссылок, которые вам на самом деле не нужны для выполнения задачи.
Перед началом поиска и устранения неисправностей проверьте масштаб документа. Размер файла и количество страниц являются лишь приблизительными показателями; для анализа текста более важным ограничением является использование токенов.
Шаг 2: Сократите объем активного разговора, прежде чем прикасаться к файлу.
Если документ не слишком большой, самым дешевым решением может быть удаление накопившегося контекста, а не разделение файла. Начните новый чат или запрос и передайте только важные инструкции. Замените долгий обмен сообщениями короткой передачей информации, например: «Проанализируйте прилагаемый отчет на предмет факторов, влияющих на выручку, существенных рисков и рекомендаций для руководства. Предоставьте пять выводов с указанием страниц или разделов».
Также удалите повторяющийся фоновый материал, примеры, которые больше не нужны, дублированный вставленный текст и предыдущие черновые варианты. Если вы используете рабочий процесс API, учитывайте весь запрос целиком, а не только сам документ. Запрос, который едва помещается, оставляет мало места для ответа и может непредсказуемо завершиться неудачей по мере роста инструкций или схем инструментов.
Признак успеха: тот же файл работает в новом потоке с активной командной строкой. В этом случае проблема заключалась, по крайней мере частично, в накопленном контексте, а не в самом документе.
Шаг 3: Сузьте вопрос и уточните требуемый результат.
Запрос «Проанализируйте все данные в этом 400-страничном документе и составьте исчерпывающий отчет» заставляет систему рассматривать множество тем одновременно. Вместо этого задавайте вопросы по одному. Например, сначала запросите информацию об основных рисках документа, затем о финансовых предположениях, а затем о противоречиях между заявлениями руководства и подтверждающими данными.
Формат ответа должен быть ограничен. Запрос на 20-страничный отчет потребляет гораздо больше ресурсов, чем запрос на таблицу из 10 строк. Окончательный ответ всегда можно дополнить после сбора доказательств.
Полезным вариантом целенаправленного задания может быть следующий: «Используя только этот документ, определите до восьми утверждений, относящихся к оттоку клиентов. Для каждого утверждения укажите ссылку на раздел или страницу, краткое пояснение в одном предложении и любые указанные ограничения. Если в документе недостаточно доказательств, укажите это».
Когда следует перейти к следующему шагу: если при решении конкретного вопроса по-прежнему возникает та же ошибка, или если вам необходимо достоверное освещение всего документа, а не только одной темы, разделите исходный код.
Шаг 4: Разделите документ по смыслу, а не только по количеству страниц.
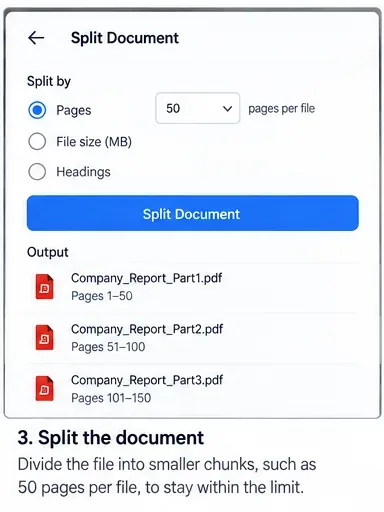
Разделение на части — наиболее надежный универсальный способ обработки очень длинных документов. Разделите файл по естественным границам, таким как главы, разделы отчетов, контракты, приложения, диапазоны дат или реплики выступающих. Логические части лучше сохраняют контекст, чем произвольные разрезы каждые 50 страниц.
Если раздел сильно зависит от предыдущего, укажите небольшое совпадение или краткую пояснительную записку, описывающую предыдущий раздел. Четко обозначьте части, например 01_Executive_Summary.pdf, , 02_Financial_Results.pdf, и 03_Risk_Factors.pdf. По возможности сохраняйте исходные номера страниц, чтобы окончательный вариант можно было проверить.
Разбейте очень длинный источник на логичные, четко обозначенные разделы. Сохраните исходные ссылки на страницы или разделы, чтобы в дальнейшем можно было проверить результаты синтеза по отношению к источнику.
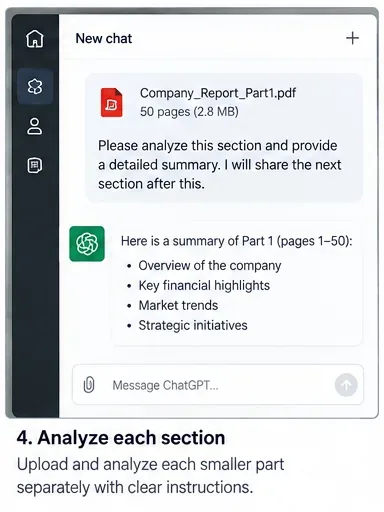
Шаг 5: Проанализируйте каждый фрагмент, используя ту же схему доказательств.
Не следует просто запрашивать произвольное краткое изложение каждой части. Используйте одинаковую структуру для каждого фрагмента, чтобы результаты можно было объединить без потери важных различий. Практическая схема может включать название раздела, основные выводы, подтверждающие доказательства, ссылку на страницу или заголовок, неопределенности и открытые вопросы.
Например: «Проанализируйте только часть 3. Верните: (1) не более пяти существенных выводов, (2) доказательства для каждого вывода, (3) ссылку на исходную страницу или раздел, (4) любые оговорки, указанные автором, и (5) вопросы, которые необходимо проверить в другом разделе. Не делайте выводов о фактах, которые не содержатся в этой части».
Такой подход также упрощает оценку качества. Если в сводке фрагмента содержатся утверждения без указания источников, следует исправить этот фрагмент перед продолжением, вместо того чтобы надеяться, что окончательный синтез исправит его.
Анализируйте каждый раздел по отдельности, используя фиксированный формат вывода, чтобы каждый частичный результат можно было впоследствии объединить и отследить до источника.
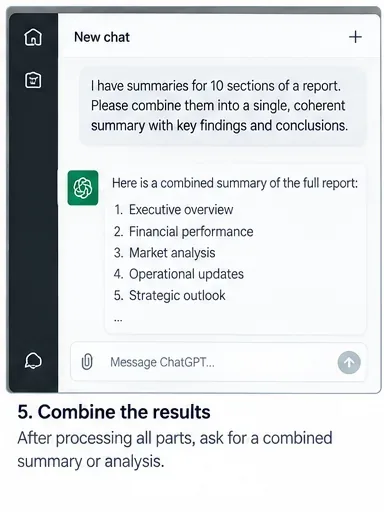
Шаг 6: Создайте сводку сводок вместо перезагрузки каждого полного фрагмента.
После анализа отдельных частей создайте компактный пакет доказательств из результатов обработки фрагментов и синтезируйте его. Не отправляйте автоматически каждый исходный фрагмент плюс каждое резюме обратно в один итоговый запрос; это может воспроизвести ту же проблему контекста.
В подсказке для синтеза следует указать модели на необходимость сохранения разногласий и пробелов. Например: «Объедините результаты анализа этих разделов в один отчет. Объедините повторяющиеся выводы, сохраните противоречивые данные как отдельные пункты, сохраните все ссылки на источники и отметьте любые вопросы, которые не могут быть решены на основе резюме».
Этот иерархический метод особенно полезен для книг, документов регулирующих органов, наборов данных для раскрытия информации, длинных коллекций интервью и исследований, содержащих множество документов. Его главный недостаток — сжатие информации: детали, пропущенные в кратком изложении, не могут волшебным образом появиться позже. Именно поэтому схема доказательств и ссылки на источники имеют значение.
Объединяйте результаты анализа отдельных разделов, вместо того чтобы заново загружать весь исходный текст. Сохраняйте ссылки, разногласия и нерешенные вопросы в процессе синтеза.
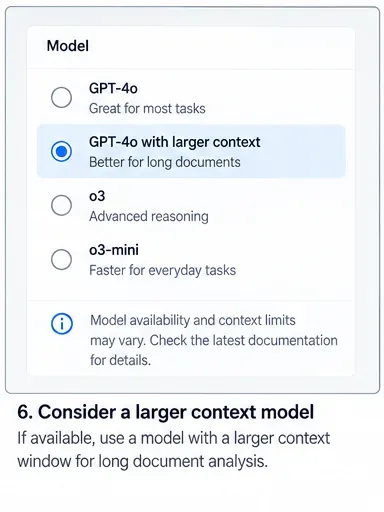
Шаг 7: Рассмотрите модель с более широким контекстом, но не рассматривайте ее как полное решение.
Модель с большим контекстным окном может уменьшить необходимость агрессивного разбиения на фрагменты. В текущей документации OpenAI указаны ограничения по контекстному окну и максимальному выходному объему для моделей API, и эти значения могут меняться по мере обновления моделей.
Однако размер контекста заголовка модели не обязательно совпадает с объемом загруженного файла, который продукт помещает непосредственно в запрос. В руководстве OpenAI для корпоративных приложений в настоящее время описывается отдельный процесс «наполнения контекстом» для загруженных текстовых документов: до 110 000 токенов из загруженных документов могут быть помещены непосредственно в контекст, а дополнительный материал доступен через частный поисковый индекс. OpenAI прямо заявляет, что это поведение находится в стадии активной разработки и может быть изменено. См. Оптимизация загрузки файлов в ChatGPT Enterprise .
Практический вывод заключается в том, что модель с более широким контекстом следует выбирать, когда она существенно упрощает рабочий процесс, но при этом необходимо проверять, действительно ли рассматриваются соответствующие разделы. Более широкий контекст не отменяет необходимости в хорошем определении области исследования, ссылках на источники или проверке.
Более широкая контекстная модель может помочь, но лучше проверить пределы для конкретной модели и поверхности изделия, которые вы используете, вместо того, чтобы полагаться на общее значение.
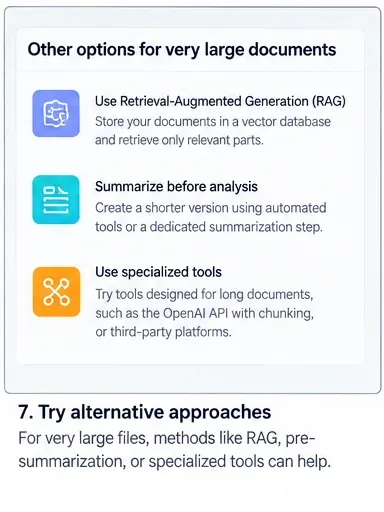
Шаг 8: Для очень больших корпусов данных перейдите от метода «собрать все подряд» к методу поиска.
Если задача включает сотни или тысячи страниц, поисковая система обычно является более предпочтительным решением, чем попытка уместить весь корпус в один запрос. Поисковые системы индексируют источник, ищут фрагменты текста, относящиеся к текущему вопросу, и помещают в контекст только эти фрагменты.
В документации OpenAI по поиску файлов описывается размещенный инструмент для поиска загруженных файлов в векторных хранилищах. Поиск особенно хорошо подходит для решения целевых вопросов, таких как: «В каких разделах для удобства определено прекращение действия?» или «Где в отчете обсуждается концентрация цепочки поставок?»
Надежность поиска снижается, когда задача действительно требует одновременного знания каждого фрагмента текста, например, доказательство того, что тема никогда не встречается, сравнение каждой ячейки таблицы в огромной коллекции или выполнение исчерпывающего построчного преобразования. В таких случаях, помимо поиска, следует использовать систематическую пакетную обработку или предварительную обработку на основе кода.
В корпусах, которые остаются слишком большими после сегментации, поиск может выводить в активный контекст для каждого вопроса только наиболее релевантные фрагменты.
Улучшенное исправление API: намеренное усечение управляющих данных.
Разработчики, использующие API ответов OpenAI, имеют дополнительную возможность. В справочнике API описана настройка truncation: при значении disabled, которое является документально подтвержденным значением по умолчанию, запрос, превышающий контекстное окно модели, завершается ошибкой; при значении auto, предыдущие элементы диалога можно удалить, чтобы запрос соответствовал размеру окна. См. справочник по API ответов .
Автоматическое усечение может предотвратить серьёзную ошибку, но оно изменяет информацию, доступную модели. При анализе документов незаметное удаление раннего контекста может быть хуже, чем получение ошибки. Используйте его только в том случае, если ваше приложение разработано таким образом, что более старые фрагменты разговора можно исключить или они уже кратко изложены в другом месте.
Как проверить, действительно ли исправление сработало?
Одного успешного запроса недостаточно. Цель — обоснованный анализ, охватывающий необходимый материал, без незаметной потери доказательств. Проверьте результат, прежде чем считать проблему решенной.
Проверка охвата: подтвердите, что каждая необходимая глава, диапазон дат или исходный файл присутствуют в плане анализа или итоговой таблице доказательств.
Проверка прослеживаемости: выборочно проверьте важные утверждения и сопоставьте ссылки на них с первоисточником, указав соответствующие страницы, разделы или файлы.
Проверка границ: осмотрите результаты вблизи границ фрагментов, чтобы убедиться, что концепция не была разделена или противоречит друг другу в разных частях.
Контрольная проверка с отрицательным результатом: задайте один вопрос, на который, как известно, нет ответа. Хороший рабочий процесс должен предполагать, что доказательство отсутствует, а не выдумывать его.
Проверка воспроизводимости: повторно проведите опрос по нескольким репрезентативным вопросам. Значительные изменения в цитируемых доказательствах могут указывать на слабую способность к поиску информации или на слишком общий вопрос.
Проверка бюджета: если вы используете API, проверьте фактическое использование токенов на входе и выходе, а не полагайтесь только на приблизительные оценки количества слов.
Последний этап — проверка: необходимо проверить охват, ссылки на источники, границы фрагментов и наличие неподтвержденных утверждений, прежде чем доверять результатам объединенного анализа.
Чего не следует делать
Не следует повторно отправлять один и тот же запрос слишком большого размера и ожидать изменения лимита токенов. Не удаляйте ссылки на исходный код во время разбиения на фрагменты. Не следует предполагать, что принятие файла означает активность каждой страницы в контексте. И не следует исправлять ошибку, слишком сильно сокращая ответ, чтобы анализ больше не мог удовлетворить поставленную задачу.
Также следует избегать восприятия автоматического усечения как невидимой магии. Если система отбрасывает старые элементы, запрос может быть выполнен успешно, но при этом могут быть потеряны важные инструкции или доказательства. Для анализа, имеющего большое значение, явное разбиение на фрагменты и извлечение данных обычно проще контролировать.
Практическое правило принятия решений
Если подходит новая тема и более узкий вопрос, упростите рабочий процесс. Если задача требует широкого охвата одного длинного документа, разделите его на логические разделы и синтезируйте структурированный анализ фрагментов. Если вы неоднократно запрашиваете очень большую коллекцию документов, используйте поиск. Если вы контролируете API и все еще приближаетесь к пределу, измерьте количество токенов, зарезервируйте место для вывода, выберите подходящую модель и сделайте поведение усечения явным проектным решением.
Наиболее убедительный результат — это не тот, который вмещает в себя как можно больше текста в одном запросе. Это тот, который охватывает необходимые доказательства, обеспечивает отслеживаемость и ясно показывает, когда информация была недоступна.