Главная
» Домены
»
Как создать частную локальную базу знаний на основе ИИ для личных документов
Как создать частную локальную базу знаний на основе ИИ для личных документов
Самое простое практическое решение: запустите языковую модель, модель встраивания, индекс документов и интерфейс чата на своем компьютере. Простой стек — это Ollama для локального обслуживания моделей и самостоятельно размещенный AnythingLLM для загрузки документов, генерации с дополненной информацией (RAG) и чата. Храните базу данных векторов локально, используйте постоянное хранилище, избегайте облачных провайдеров моделей и проверяйте, что ответы действительно основаны на ваших файлах.
Иллюстративный пример: представьте, что на протяжении всего руководства Джордан организует свою личную коллекцию, включающую руководства по ведению домашнего хозяйства, PDF-файлы страховых полисов, протоколы совещаний, справочник по личным финансам и несколько отчетов по проектам. Джордан — вымышленный персонаж. Описанные ниже файлы, вопросы, ответы и результаты являются примерами для объяснения рабочего процесса, а не результатами тестирования или отзывом.
В этом руководстве используется четырехэтапная схема настройки, чтобы границы конфиденциальности оставались понятными. Оно подходит для одного человека или небольшой группы доверенных лиц, которым нужен локальный поиск документов и ответы на вопросы. Если вам необходимы корпоративные средства контроля идентификации, многоузловая доступность, централизованный аудит или гарантии соответствия нормативным требованиям, следует рассматривать это как базовую архитектуру, а не как полноценное решение для обеспечения соответствия требованиям.
Что на самом деле означает «частная локальная база знаний ИИ»?
Локальная база знаний — это не то же самое, что обучение модели на ваших документах. В типичном рабочем процессе RAG система извлекает текст из ваших файлов, разбивает текст на фрагменты, преобразует эти фрагменты в числовые эмбеддинги, сохраняет их в векторной базе данных, извлекает релевантные фрагменты для каждого вопроса и отправляет только эти фрагменты языковой модели в качестве контекста.
В текущей документации AnythingLLM описаны рабочие процессы как с прикрепленными документами, так и с встроенными документами. Прикрепленные документы могут вставлять полный текст в чат, если это позволяет контекстное окно, в то время как RAG извлекает более мелкие релевантные фрагменты из встроенных документов. В текущей документации по локальной базе данных LanceDB также указано, что база данных LanceDB по умолчанию хранит текст документов и их встраивания внутри приложения AnythingLLM. См. документацию по рабочим процессам с документами AnythingLLM и документацию по LanceDB AnythingLLM .
Компонент
Роль в локальном стеке
выбор, учитывающий конфиденциальность
оллама
Запускает модель чата и, при необходимости, модель встраивания на вашем компьютере.
Используйте локальную модель, а не конечную точку модели, размещенную в облаке.
AnythingLLM
Предоставляет пользовательский интерфейс, управление документами, разбивку на блоки, функцию RAG и организацию рабочего пространства.
Запустите его локально и обеспечьте постоянное хранение данных в каталоге хранилища.
модель встраивания
Преобразует фрагменты документов и запросы в векторы для семантического поиска.
Используйте локальный встраиватель, если документы не обязательно отправлять во внешний сервис.
LanceDB
Сохраняет векторные представления, используемые для поиска релевантных фрагментов текста.
Используйте локальный экземпляр по умолчанию, если вам не требуется удаленная база данных.
Оригинальные файлы и резервные копии
Оставайтесь авторитетным источником.
Защитите их с помощью стандартных средств контроля доступа операционной системы, шифрования и резервного копирования.
Прежде чем начать: определите границы приватности.
Ключевой вопрос не в том, «Локально ли приложение?», а в том, «Какие компоненты могут отправлять текст документов или подсказки за пределы компьютера?». Локальный пользовательский интерфейс все еще можно настроить для вызова облачной LLM, облачного API для встраивания, веб-поиска или удаленных инструментов. Для частной конфигурации держите LLM, встраиватель и базу данных векторов локально, если вы намеренно не приняли условия обмена данными с внешним поставщиком.
В документации AnythingLLM описана анонимная телеметрия и предусмотрен способ её отключения. В документации по конфиденциальности также различается удаление документа из одной рабочей области и полное удаление его из библиотеки документов. Для полного удаления данных в AnythingLLM в текущей документации рекомендуется удалить документ из раздела « Мои документы» , что удалит проанализированный исходный код, кэшированные эмбеддинги, а также ссылки на рабочую область. Перед добавлением конфиденциальных данных ознакомьтесь с документацией AnythingLLM по вопросам конфиденциальности и обработки данных .
Вам также потребуется достаточно памяти для выбранной локальной модели. Единого правильного размера модели не существует, поскольку полезная скорость зависит от ЦП, ГП, ОЗУ или видеопамяти, квантизации, длины контекста и количества извлекаемых документов. Начните с модели, которая подходит вам по размеру, а не выбирайте самую большую модель, которую ваш компьютер едва может загрузить.
Шаг 1: Установите Ollama и подготовьте локальные модели чата и встраивания.
Установите Ollama, следуя инструкциям для вашей операционной системы. Ollama доступна для macOS, Windows и Linux, а её локальный API по умолчанию работает на порту 11434. Официальное руководство по быстрому запуску Ollama — лучший источник информации о текущей установке и синтаксисе команд.
После установки выберите модель чата, подходящую для вашего оборудования. Точная модель здесь намеренно не указана, поскольку каталог моделей меняется, а требования к оборудованию различаются. Типичная команда имеет следующий вид:
ollama pull <chat-model-name>
Для RAG также необходима модель встраивания. В текущей документации Ollama по встраиваниям, проверенной в сентябре 2026 года, в качестве рекомендуемых вариантов перечислены такие модели, как embeddinggemma, qwen3-embedding, и all-minilm. Вы можете ознакомиться с текущим списком в документации Ollama по встраиваниям . Например:
ollama pull embeddinggemma
Не используйте обычную модель чата в качестве модели встраивания только потому, что она отображается в выпадающем списке моделей. В текущей документации AnythingLLM по встраиванию Ollama прямо указано, что Ollama может отображать как модели чата, так и модели встраивания в одном и том же списке. Используйте фактическую модель встраивания для индексирования документов. См. настройку встраивания AnythingLLM Ollama .
Показательный пример работы терминала для загрузки локальной модели с помощью Ollama. Номер версии, отображаемый в этом примере, не является рекомендуемой текущей версией; проверьте установленную версию по официальной документации Ollama.
В вымышленной ситуации Джордана цель на данном этапе проста: генерация и встраивание документов должны быть возможны без отправки документов домохозяйства на удаленный API.
Шаг 2: Запустите AnythingLLM локально с постоянным хранилищем и подключите его к Ollama.
AnythingLLM предлагает варианты для настольных компьютеров и самостоятельного размещения. В этом руководстве используется Docker, поскольку границы хранилища четко определены и легко резервно копируются. Текущая локальная документация Docker рекомендует пользователям загрузить образ и подчеркивает необходимость постоянного хранилища, иначе данные приложения могут быть потеряны при повторном создании контейнера. Также указано, что веб-приложение доступно по адресу [адрес сайта] http://localhost:3001. Используйте официальное руководство AnythingLLM по локальному Docker, а не копируйте старую команду с форума.
docker pull mintplexlabs/anythingllm:latest
При запуске контейнера сохраните хранилище AnythingLLM, смонтировав каталог хоста в каталог `/etc/local /app/server/storage...
Затем настройте провайдер LLM как Ollama. Если AnythingLLM работает непосредственно на хосте, указанный по умолчанию адрес Ollama — http://127.0.0.1:11434. Если AnythingLLM работает внутри Docker, а Ollama — на хосте, не используйте его localhostизнутри контейнера. В документации AnythingLLM по настройке сети в Docker указано, что http://host.docker.internal:11434на поддерживаемых настольных платформах следует использовать ; для Linux в документации описана настройка 172.17.0.1для этого шаблона подключения к хосту. См. примечание AnythingLLM о настройке сети на локальном хосте и конфигурацию Ollama LLM .
В настройках выберите Ollama в качестве поставщика LLM и, при необходимости, поставщика встраивания. Выберите модель чата для генерации и модель встраивания для индексирования. Разделение этих ролей предотвратит распространенную ошибку в настройке.
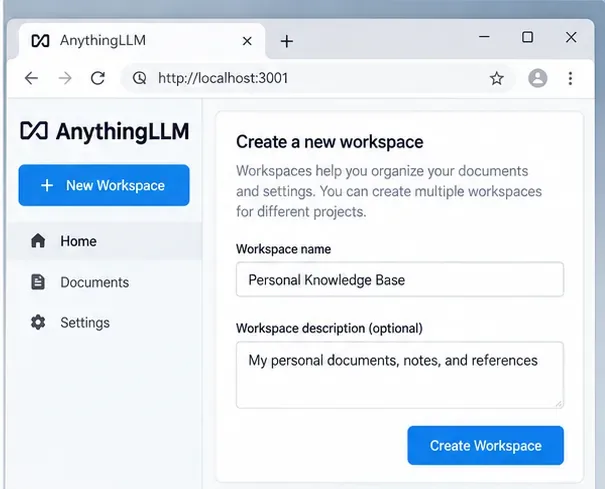
В документации указано, что саморазмещаемая версия AnythingLLM работает по адресу localhost:3001. Выделенное рабочее пространство позволяет четко определить назначение каждой коллекции документов и исключить из общего пула поиска материалы, не имеющие отношения к основной коллекции.
Джордан создает рабочее пространство под названием «Персональная база знаний» и избегает подключения к поставщикам облачных моделей. Это упрощает последующую проверку заданных границ: локальный пользовательский интерфейс, локальная модель обучения, локальные эмбеддинги, локальные векторы.
Шаг 3: Добавьте документы, выберите RAG вместо полнотекстового вложения и подтвердите загрузку.
Не начинайте с загрузки всего диска. Начните с небольшого, репрезентативного набора документов, содержимое которых вам хорошо известно. Это позволит вам контролируемым образом выявлять проблемы с извлечением или поиском данных до того, как индекс разрастется.
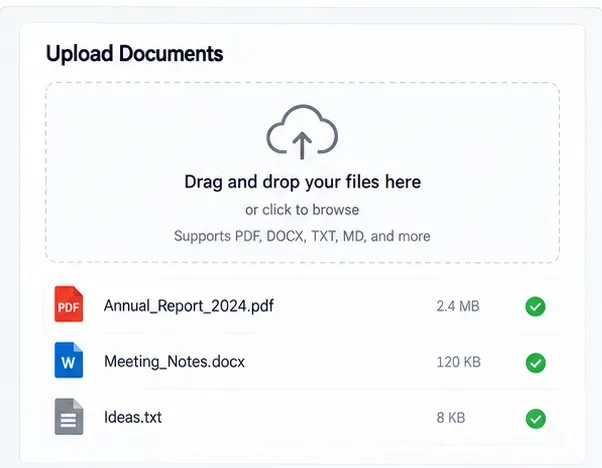
В примере Джордана полезная первая партия может включать один PDF-файл с возможностью поиска, один файл DOCX и одну заметку в формате обычного текста или Markdown. Если отсканированные PDF-файлы содержат изображения вместо выделяемого текста, убедитесь, что выбранный вами способ обработки документов действительно извлекает необходимый текст; файл, который кажется вам читаемым, все равно может содержать пустой или некачественный текст для RAG.
В настоящее время AnythingLLM поддерживает два основных типа поведения документов:
Прикрепленные документы: полезны, когда полный текст помещается в контекстное окно модели, и вы хотите, чтобы модель видела полный файл для этой ветки обсуждения.
Встроенные документы с помощью RAG: полезны для больших или многократно используемых коллекций. Система разбивает контент на фрагменты, встраивает их и извлекает релевантные части для заданного вопроса.
В текущем руководстве по AnythingLLM отмечается, что документы, встроенные в рабочую область, становятся доступными для всех потоков в этой рабочей области. Это удобно, но также означает, что членство в рабочей области является частью вашей модели конфиденциальности в многопользовательских развертываниях. Держите личные рабочие области отдельно от любых общих рабочих областей.
Пример представления процесса загрузки с несколькими типами документов. Сначала используйте небольшой, заведомо корректный пакет, затем проверьте извлечение и индексирование, прежде чем добавлять большой архив.
После встраивания задайте вопрос, ответ на который есть только в одном файле. Затем запросите деталь, которая отсутствует в любом файле. Первый вопрос проверяет способность к поиску; второй проверяет, допускает ли модель неопределенность вместо того, чтобы выдумывать ответ.
Что настраивать, если качество восстановления слабое?
AnythingLLM предоставляет элементы управления RAG на уровне рабочей области, такие как предпочтения поиска, максимальное количество контекстных фрагментов и пороговое значение сходства документов. В документации рекомендуется начинать с настроек рабочей области, а не предполагать, что проблема заключается в базовой модели. Увеличение количества извлекаемого контекста может помочь, когда ответ охватывает несколько разделов, но отправка слишком большого количества фрагментов также может добавить нерелевантный текст и израсходовать ресурсы контекстного окна.
Если после индексирования вы изменяете модели встраивания, повторно встройте затронутые документы таким образом, чтобы сохраненные векторы и векторы запроса принадлежали одному и тому же пространству встраивания. Смешивание встраиваний из разных моделей не является эффективной стратегией поиска.
Шаг 4: Проверьте обоснованные ответы, обеспечьте конфиденциальность и создайте резервную копию базы знаний.
База знаний полезна только в том случае, если вы можете обнаружить в ней ошибки. Составьте небольшой список для оценки на основе фактов, которые вы можете проверить напрямую. Например:
Запросите дату, сумму, модель продукта или пункт страхового полиса, которые дословно присутствуют в одном документе.
Задайте вопрос, затрагивающий несколько документов, для ответа на который необходимы данные из двух файлов.
Задайте заведомо неразрешимый вопрос и убедитесь, что ответ не содержит вымышленных сведений об источнике.
Задайте тот же вопрос, но в другой формулировке, чтобы проверить, насколько стабилен процесс извлечения информации.
Откройте исходный документ и вручную подтвердите каждое важное утверждение.
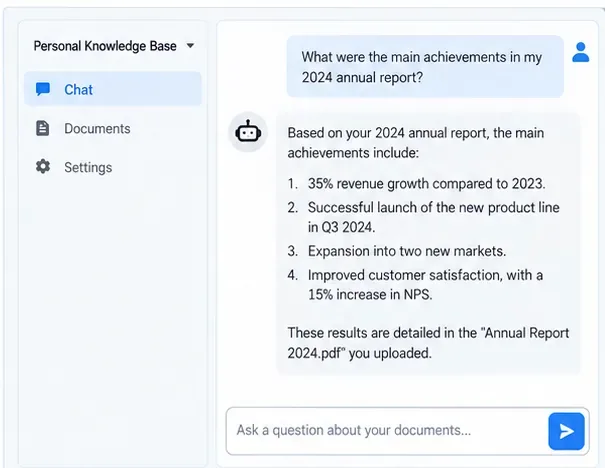
Гипотетический ответ, основанный на документе, используется для иллюстрации этапа проверки. Приведенные рисунки представляют собой вымышленный пример контента; в реальной базе знаний необходимо проверить важные утверждения, сопоставив их с исходным файлом.
Для Джордана хорошее правило принятия ответа — это не «ответ кажется правильным». Это правило означает «ответ соответствует источнику, включает необходимый контекст и безопасно отклоняется, если источник не содержит нужной информации». Это правило особенно важно для налогов, страхования, юридических документов, медицинских записей или финансовых решений.
После того, как всё заработает, сохраните настройки в тайне.
Локальный вывод данных снижает риск утечки информации, но конфиденциальность по-прежнему зависит от конфигурации. Используйте эти элементы управления в качестве практического контрольного списка:
Если только удаленный доступ не защищен намеренно, служба AnythingLLM должна быть привязана к локальному компьютеру или доверенной частной сети.
Не добавляйте интеграции с Cloud LLM, Cloud Embedding, веб-поиском, браузерами или агентами в рабочую область, содержащую конфиденциальную информацию, если вы не понимаете, что именно передают эти интеграции.
Отключите анонимную телеметрию, если ваша политика конфиденциальности требует отсутствия телеметрии по продукту.
Используйте встроенные в операционную систему функции шифрования диска и права доступа к учетной записи. Локальная база данных векторов останется доступной для чтения, даже если злоумышленник получит доступ к компьютеру.
Удаляйте конфиденциальные файлы не только из одной рабочей области, но и из библиотеки документов, если вы планируете полное удаление файлов внутри AnythingLLM.
Устраните неполадки в Ollama, AnythingLLM, Docker и операционной системе хоста. «Офлайн» не означает «никогда не поддерживалось».
Сделайте резервные копии тех частей, которые сложно воспроизвести.
Исходные документы остаются вашим источником достоверной информации, но каталог хранения AnythingLLM содержит базу данных приложения, проанализированные документы, векторные данные и конфигурацию, необходимую для предотвращения перестройки всего после сбоя диска. Создайте резервные копии как папки с исходными документами, так и постоянного хранилища AnythingLLM. Если вы используете тома Docker вместо смонтированного каталога хоста, следуйте официальной документации Docker по резервному копированию и восстановлению томов .
Проверка восстановления, а не просто создание резервной копии. Резервная копия считается работоспособной только тогда, когда вы можете восстановить её в другой каталог или на другой компьютер, запустить локальный стек, открыть рабочую область и корректно получить известный факт.
Когда такая конфигурация подходит — и когда она не подходит
Эта архитектура отлично подходит, если ваш приоритет — хранение личных документов на контролируемом вами оборудовании, вам удобно запускать локальное программное обеспечение, и вам нужен семантический поиск и ответы на естественном языке по небольшой библиотеке документов. Она также полезна, когда доступ в интернет ненадежен или когда вам нужны предсказуемые локальные затраты после загрузки моделей.
Этот вариант менее подходит, если ваш компьютер не может запустить адекватную локальную модель, вам необходим бесперебойный доступ со многих устройств за пределами вашей домашней сети, или вам требуется корпоративный уровень идентификации, аудита, юридического удержания, централизованного управления ключами или гарантированной поддержки. В таких случаях правильным решением может стать управляемое частное развертывание или корпоративная платформа RAG, а не установка на одном ПК.
Краткий контрольный список для настройки
Установите Ollama и проверьте работу локальной модели.
Установите специализированную модель встраивания, например, ту, которая указана в текущей документации Ollama по встраиванию данных.
Запустите AnythingLLM локально с использованием постоянного хранилища.
Подключите AnythingLLM к локальной конечной точке Ollama, используя правильный адрес хоста, соответствующий вашему методу развертывания.
Если цель состоит в локальном поиске документов, используйте локальную базу данных векторов, например, LanceDB, которая используется по умолчанию в AnythingLLM.
Создайте рабочее пространство с узкими рамками.
Начните с нескольких известных документов и проверьте правильность извлечения.
Используйте RAG для больших коллекций документов, которые можно использовать повторно, и прикрепляйте полные тексты только в том случае, если документ удобно вписывается в контекст модели.
Прежде чем доверять системе, проверьте, на какие вопросы можно ответить, а на какие — нет.
Отключите ненужные внешние интеграции и телеметрию в соответствии с вашими требованиями к конфиденциальности.
Создайте резервные копии исходных документов и постоянного хранилища приложения, а затем протестируйте восстановление.