Главная
» Домены
»
Как запустить DeepSeek офлайн на Windows 11 с помощью LM Studio
Как запустить DeepSeek офлайн на Windows 11 с помощью LM Studio
Да, вы можете запускать DeepSeek полностью офлайн на Windows 11 с помощью LM Studio, но сначала потребуется один этап настройки с подключением к интернету. Установите LM Studio, загрузите совместимую модель DeepSeek и необходимую среду выполнения, загрузите модель один раз, а затем вы можете отключиться от интернета. В официальной документации LM Studio по офлайн-режиму указано, что чат с загруженными моделями, чат с локальными документами и запуск локального сервера не требуют доступа к интернету.
Для типичного ПК с Windows 11 наиболее практичной отправной точкой является не самая крупная текущая модель DeepSeek. Меньшая модель в формате GGUF, такая как DeepSeek-R1-0528-Qwen3-8B, гораздо проще запускается локально. LM Studio опубликовала поддержку этой дистиллированной модели на 8B в мае 2025 года и сообщает, что она работает в формате GGUF с LM Studio версии 0.3.16 или новее. Для сравнения, руководство LM Studio от августа 2026 года для DeepSeek V4 Flash указывает, что локальное использование требует примерно 156 ГБ системной памяти. Это делает V4 Flash плохим выбором для большинства потребительских машин на Windows, несмотря на то, что она новее и мощнее.
Это руководство было проверено 11 сентября 2026 года. В журнале изменений LM Studio указана версия 0.4.24 от 9 сентября 2026 года. Поскольку интерфейс LM Studio развивается, кнопки могут немного смещаться между сборками, но основной рабочий процесс — загрузка модели, её запуск, локальный чат и, при необходимости, предоставление API на localhost — остается задокументированным в LM Studio.
Перед началом: подходит ли ваш ПК с Windows 11?
LM Studio в настоящее время поддерживает как ПК с Windows на архитектуре x64, так и системы Windows на базе ARM. Для архитектуры x64 процессор должен поддерживать набор инструкций AVX2. LM Studio рекомендует иметь не менее 16 ГБ оперативной памяти и не менее 4 ГБ выделенной видеопамяти (VRAM). Это рекомендации на уровне приложения, а не гарантия того, что каждая модель поместится в память. Размер модели, квантование, длина контекста и разгрузка на GPU влияют на использование памяти.
Что у вас есть
Практическая рекомендация
Почему
16 ГБ ОЗУ, скромная видеокарта или интегрированная графика
Начните с дистиллированной модели DeepSeek на 8B или меньше в варианте GGUF с 4-битным квантованием
Это позволяет относительно легко управлять размером модели, сохраняя при этом полезные способности к рассуждению.
Больше ОЗУ и более мощная видеокарта
Попробуйте более крупные дистиллированные варианты только после проверки оценки совместимости с устройством в LM Studio
Более крупные модели могут улучшить качество, но потребляют значительно больше памяти и могут работать гораздо медленнее.
Обычный игровой ПК или ноутбук
Не начинайте с DeepSeek V4 Flash
LM Studio сообщает, что локальная модель V4 Flash требует не менее 156 ГБ системной памяти.
В документации LM Studio по загрузке моделей объясняется, что квантованные сборки жертвуют некоторой точностью ради меньших файлов и снижения нагрузки на память. Общая рекомендация — выбирать вариант с 4-битным квантованием или выше, если ваше оборудование позволяет это. Если вы не уверены, версия GGUF с 4-битным квантованием является разумным первым тестом.
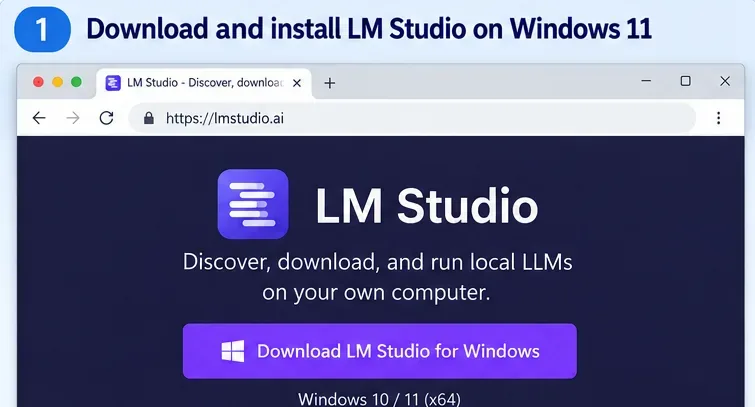
Загрузите текущую стабильную сборку для Windows с официальной страницы загрузки LM Studio. Используйте установщик, соответствующий архитектуре вашей системы Windows. На ПК с архитектурой x64 убедитесь, что ваш процессор поддерживает AVX2, прежде чем устранять ошибки загрузки модели позже.
Вид страницы загрузки для Windows в LM Studio. Выберите установщик, соответствующий вашей системе Windows 11, прежде чем переходить к загрузке модели.
Запустите LM Studio, пока у вас еще есть подключение к интернету. Это важно, так как приложению может потребоваться загрузить или обновить среду выполнения LM Runtime. LM Studio описывает среды выполнения как упакованные движки вывода, такие как её среда выполнения на базе llama.cpp для моделей GGUF. Загрузка сред выполнения требует подключения к сети, даже если сам вывод может работать офлайн после этого.
Шаг 2: Загрузка модели DeepSeek, подходящей для вашего ПК
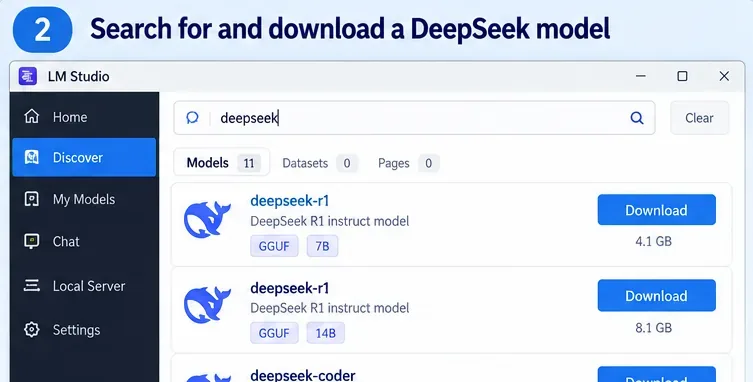
Откройте раздел Discover в LM Studio и выполните поиск по запросу DeepSeek. LM Studio может искать поддерживаемые модели Hugging Face по ключевым словам, по идентификатору вида user/model или даже по полному URL Hugging Face.
Выполните поиск DeepSeek в разделе Discover, затем выберите модель и уровень квантования, соответствующие вашему оборудованию. Точные записи в каталоге и размеры файлов со временем меняются.
Какую модель DeepSeek выбрать?
Для большинства людей, следующих этому руководству, начните с DeepSeek-R1-0528-Qwen3-8B. LM Studio сообщает, что эта дистиллированная модель на 8B поддерживает рассуждения и использование инструментов, доступна в формате GGUF и может работать с гораздо меньшим объемом памяти, чем флагманские модели DeepSeek. Руководство LM Studio для Windows по-прежнему рекомендует 16 ГБ ОЗУ для приложения в целом, поэтому не воспринимайте заявления о низком потреблении памяти для конкретной модели как комфортную цель для всей системы.
DeepSeek также выпустила более ранние дистиллированные варианты R1 с параметрами 1.5B, 7B, 8B, 14B, 32B и 70B. Они дают вам возможность балансировать между скоростью, использованием памяти и возможностями. См. официальный репозиторий DeepSeek-R1 для получения информации о семействе моделей и деталях лицензирования, а также заметку LM Studio о локальном запуске DeepSeek-R1-0528 для варианта на 8B.
Если вас искушает DeepSeek V4 Flash из-за её новизны, сначала проверьте требования к оборудованию. В официальной статье о V4 Flash LM Studio указано, что модель Mixture-of-Experts на 284B требует не менее 156 ГБ системной памяти для локального использования. Она жизнеспособна на рабочих станциях с большим объемом памяти, но не на обычном ноутбуке с Windows.
Шаг 3: Загрузка модели в память
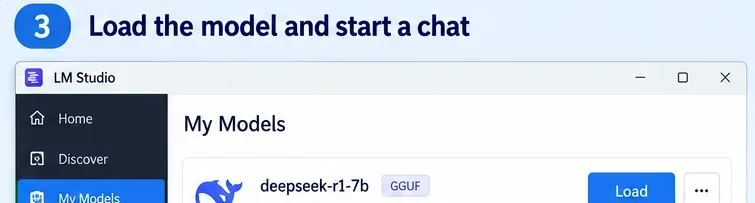
После завершения загрузки перейдите к загруженным моделям или откройте загрузчик моделей из чата. Выберите модель DeepSeek и загрузите её. LM Studio объясняет, что загрузка модели выделяет память для весов модели и связанного состояния среды выполнения.
Загруженная модель DeepSeek GGUF, готовая к запуску. Если загрузка не удается, попробуйте меньшую модель или квантование с меньшим потреблением памяти, прежде чем менять расширенные настройки.
Для первого запуска сохраняйте настройки загрузки консервативными. Очень большое окно контекста может потреблять значительный дополнительный объем памяти, поэтому нет особой необходимости сразу максимизировать контекст. Загрузите модель с умеренным контекстом, убедитесь, что она работает, и расширяйте его только тогда, когда этого требует ваша рабочая нагрузка.
Если LM Studio сообщает, что модель не помещается в память, наиболее надежным решением обычно является выбор меньшей модели или более компактного квантования. Закрытие приложений, потребляющих много памяти, может помочь, но не меняет фундаментальный размер модели.
Шаг 4: Отключите интернет и проверьте, действительно ли DeepSeek работает офлайн
Этот шаг отделяет «локальную модель» от простого «использования настольного клиента». После того как модель и её среда выполнения установлены, выключите Wi-Fi и отключите Ethernet. Затем начните новый чат и отправьте простой запрос, например:
Объясните разницу между ОЗУ и VRAM в пяти пунктах.
Если модель отвечает, когда у ПК нет сетевого подключения, вывод выполняется локально. LM Studio утверждает, что после установки LLM на ваше устройство она может работать полностью офлайн, и текст, введенный в локальные чаты LLM, не покидает ваше устройство. В документации по офлайн-режиму также указано, что обработка локальных документов и RAG остаются на машине.
Загруженная модель DeepSeek отвечает в чате LM Studio. Чтобы самостоятельно проверить офлайн-работу, отключите сетевой доступ после полной загрузки модели и среды выполнения и повторите простой запрос.
Существует важная граница: поиск моделей, загрузка новых моделей, загрузка сред выполнения и проверка обновлений приложения требуют доступа к интернету. Если вы позже добавите облачные модели, удаленные серверы MCP, веб-инструменты или другие сетевые интеграции, эти функции также могут потребовать подключения. Заявления о конфиденциальности в офлайн-режиме относятся к локальному рабочему процессу, а не к службам, которые вы сознательно подключаете позже.
Шаг 5: Опционально — использование DeepSeek через локальный API
Если вы хотите, чтобы другое приложение Windows, скрипт, расширение IDE или внутренний инструмент вызывали вашу локальную модель DeepSeek, LM Studio может запустить локальный сервер. Текущая документация для разработчиков говорит, что его можно запустить со страницы Developer или с помощью команды:
lms server start
По умолчанию сервер доступен по адресу http://localhost:1234. LM Studio предоставляет нативные конечные точки REST и конечные точки, совместимые с OpenAI. Сам сервер может работать офлайн, если модель и среда выполнения уже находятся локально. Однако, если вы выставляете сервер за пределы localhost, сначала проверьте настройки аутентификации и сетевого доступа.
Недостаточно ОЗУ/VRAM, слишком большой контекст или неподдерживаемый CPU/среда выполнения
Попробуйте меньшую модель DeepSeek, меньшее квантование или меньшую длину контекста. На Windows x64 убедитесь в поддержке AVX2.
LM Studio работает онлайн, но не после отключения
Модель или необходимая среда выполнения не были полностью загружены
Подключитесь один раз, завершите все загрузки моделей/сред выполнения, успешно загрузите модель, а затем повторите офлайн-тест.
Генерация очень медленная
Модель слишком велика для доступного ускорения GPU и сильно полагается на CPU/системную память
Выберите меньшую модель или квантование. Большая модель бесполезна, если задержки делают рабочий процесс непрактичным.
Вы не можете найти модель в офлайн-режиме
Поиск в разделе Discover требует сетевого доступа
Загрузите модели перед отключением от сети или загрузите файл модели через другой контролируемый процесс.
Вы ожидали, что V4 Flash будет работать на обычном ноутбуке
Её требование к локальной памяти относится к классу рабочих станций
Используйте вместо этого дистиллированную модель R1, если только на вашей машине нет примерно 156 ГБ или более системной памяти.
Когда эта настройка подходит
Запуск DeepSeek офлайн с LM Studio отлично подходит, когда вам нужен приватный локальный вывод, предсказуемые затраты после загрузки модели, эксперименты без ключей API или локальный API для разработки. Это также полезно, когда ваша машина должна продолжать работать без доступа к интернету.
Это менее подходящий вариант, когда вам нужна самая мощная доступная модель DeepSeek, но у вас есть только потребительское оборудование, когда вам нужна чрезвычайно высокая пропускная способность или когда ваша рабочая нагрузка зависит от актуальной информации из веба. Локальные модели знают только то, что находится в их весах и в предоставленном вами контексте, если вы сознательно не подключаете внешние инструменты или источники данных.
Краткий чек-лист
Используйте систему Windows 11, соответствующую требованиям LM Studio; процессоры x64 должны поддерживать AVX2.
Оставьте доступ к интернету включенным для начальной загрузки LM Studio, среды выполнения и моделей.
Начните с меньшей модели DeepSeek в формате GGUF, особенно с дистиллированной модели класса 8B.
Выберите квантование 4-бит или выше, если ваше оборудование может это поддержать.
Успешно загрузите модель перед отключением сети.
Выключите Wi-Fi/Ethernet и выполните новый запрос, чтобы проверить офлайн-вывод.
Уменьшите размер модели или длину контекста, если возникают ошибки памяти.
Используйте локальный сервер LM Studio только если вам нужен локальный доступ к API.
Итог
Самый простой способ запустить DeepSeek офлайн на Windows 11 — это связать LM Studio с меньшей моделью DeepSeek в формате GGUF, которая действительно помещается в ваше оборудование. Для обычного ПК дистиллированная модель R1 класса 8B является гораздо более реалистичной отправной точкой, чем DeepSeek V4 Flash. Завершите загрузки, пока вы онлайн, загрузите модель, отключите сеть и убедитесь, что новый чат все еще отвечает. Как только это заработает, у вас будет действительно локальная настройка DeepSeek, а не просто настольная оболочка вокруг облачного API.