Сократить счет за API LLM на 50% возможно во многих рабочих нагрузках, но это не универсальная гарантия. Результат зависит от того, откуда берутся ваши расходы: некешированные входные токены, кешированные входные токены, выходные токены, токены рассуждений, вызовы инструментов или повторные попытки. Сжатие промптов лучше всего работает, когда длинные или повторяющиеся входные данные составляют значительную часть счета. Поэтому практическая цель состоит не в том, чтобы «сделать каждый промпт вдвое короче». Она заключается в том, чтобы «удалить токены, которые не меняют ответ, сохранить токены, которые его меняют, и проверить экономию на реальном трафике».
Это руководство использует четыре шага внедрения: измерение базового уровня, удаление избыточных входных данных, организация промптов для повторного использования кеша и перенос подробных инструкций по выводу в структурированные элементы управления, если API их поддерживает. Примеры носят иллюстративный характер, а не являются утверждениями о бенчмарках. Цены провайдеров и поведение кеша со временем меняются, поэтому проверяйте текущие тарифы перед оценкой для производственной среды.
Что на самом деле требуется для снижения расходов на API на 50%?
Начните с уравнения биллинга для вашей модели. Для простой текстовой рабочей нагрузки общая стоимость запроса приблизительно равна стоимости некешированного ввода плюс кешированного ввода плюс вывода. Некоторые модели или функции добавляют другие оплачиваемые категории. Текущие ответы API OpenAI предоставляют информацию об использовании входных и выходных токенов, включая детали кешированных токенов, а страницы моделей публикуют отдельные тарифы для ввода, кешированного ввода и вывода.
| Иллюстративная рабочая нагрузка | Входные токены | Выходные токены | Относительный результат |
|---|
| Базовый запрос | 10 000 | 1 000 | 100% базовой стоимости |
| Только ввод сокращен вдвое | 5 000 | 1 000 | Менее 50% общей экономии, если вывод остается неизменным |
| Ввод и вывод сокращены вдвое | 5 000 | 500 | Приблизительно на 50% ниже стоимость на основе токенов при неизменных тарифах |
В качестве конкретного текущего примера официальная страница модели GPT-5.6 Sol указывала 11 сентября 2026 года цену $4 за миллион входных токенов, $0,40 за миллион кешированных входных токенов и $20 за миллион выходных токенов. По этим тарифам запрос с 10 000 входными и 1 000 выходными токенами стоит около $0,06 до учета других сборов. Сокращение только ввода до 5 000 токенов снижает эту сумму примерно до $0,04, что составляет 33% экономии. Сокращение и ввода, и вывода вдвое снижает стоимость примерно до $0,03, что составляет 50% экономии. Эти цены могут измениться, поэтому относитесь к расчетам как к методу, а не к постоянному предложению. Актуальные цены см. на официальной странице модели GPT-5.6 Sol.
Краткая справка: четыре наиболее эффективных действия
| Техника | Лучшее применение | Основной риск | Что измерять |
|---|
| Аудит токенов | Любая производственная рабочая нагрузка | Оптимизация неправильного компонента | Вход, кешированный вход, вывод, повторные попытки, стоимость на успешную задачу |
| Удаление избыточности | Длинные системные промпты, повторяющиеся политики, подробные примеры | Удаление ограничения, которое действительно важно | Успешность выполнения задачи и соответствие инструкциям |
| Кэш-ориентированная структура | Повторяющиеся запросы, использующие стабильные инструкции или контекст | Низкое повторное использование кеша из-за слишком раннего появления динамического текста | Доля кешированных токенов и задержка |
| Структурированный вывод | Извлечение JSON, классификация, фиксированные форматы ответов | Схема слишком жесткая для задачи | Выходные токены, ошибки разбора, повторные попытки |
Шаг 1: Измерьте реальный базовый уровень токенов перед изменением промптов
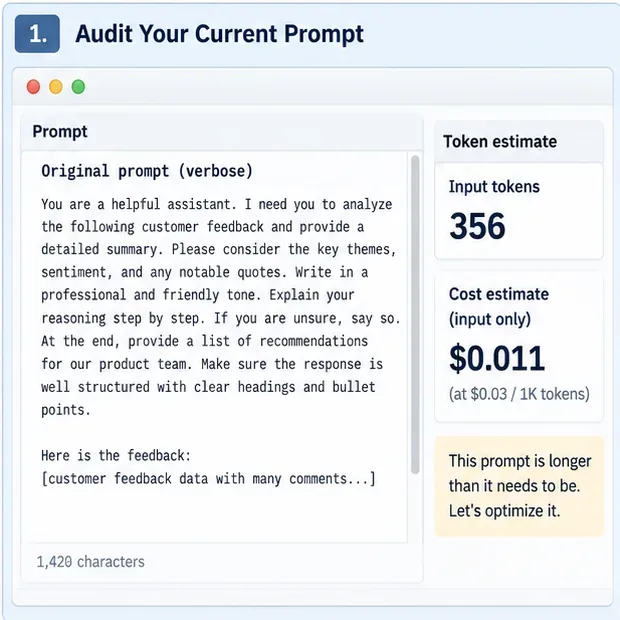
Подпись: Иллюстративный интерфейс аудита токенов записывает исходный размер промпта и примерную оценку стоимости до сжатия; цифры не отражают текущие тарифы провайдера.
Соберите репрезентативную выборку производственных запросов, а не оптимизируйте один вручную выбранный промпт. Как минимум, записывайте входные токены, кешированные входные токены (если доступны), выходные токены, название модели, задержку, повторные попытки и то, прошел ли финальный ответ вашу проверку бизнес-качества. Если ваш провайдер предлагает конечную точку для подсчета входных токенов, используйте ее перед отправкой запросов, когда вам нужен детерминированный бюджет. OpenAI в настоящее время документирует конечную точку подсчета входных токенов в своем официальном справочнике API.
Рассчитывайте стоимость на успешную задачу, а не только стоимость на вызов API. Сжатый промпт, вызывающий больше повторных попыток, может быть дороже, даже если каждый запрос короче. Также сегментируйте базовый уровень по типам задач: суммаризация, извлечение, ответы на вопросы RAG, агентное использование инструментов и длинные диалоги обычно имеют разные профили токенов.
Шаг 2: Удалите избыточность, не удаляя критически важную для принятия решений информацию

Подпись: Иллюстративное сравнение «до и после» сохраняет те же запрошенные выходные данные, удаляя повторяющиеся формулировки и ненужные инструкции по процессу.
Самым безопасным первым шагом сжатия является семантическая дедупликация. Удалите повторяющиеся описания ролей, дублирующиеся ограничения, вежливые заполнители, объяснения очевидного форматирования и примеры, которые учат одному и тому же шаблону более одного раза. Объедините перекрывающиеся правила в одну инструкцию. Предпочтите одно точное предложение нескольким предложениям, повторяющим одно и то же требование.
До
Вы — полезный ассистент, являющийся экспертом в анализе продуктов.
Мне нужно, чтобы вы проанализировали следующий отзыв клиента и предоставили
подробное резюме. Пожалуйста, определите ключевые темы, общую тональность,
примечательные цитаты и рекомендации для нашей команды продуктов. Убедитесь,
что ваш ответ профессиональный, четкий, лаконичный и хорошо структурированный.
После
Проанализируйте отзыв клиента.
Верните: ключевые темы, общую тональность, примечательные цитаты и рекомендации по продукту.
Будьте лаконичны и фактологичны.
Не сжимайте исключения, границы политик, определения домена, правила безопасности инструментов или требования к доказательствам только потому, что они длинные. Часто это высокоценные токены. Полезный тест: «Если я удалю это предложение, может ли приемлемый вывод измениться?» Если да, оставьте его, если только элемент управления API или схема не могут обеспечить такое же поведение более надежно.
Шаг 3: Поместите стабильный контент в начало, а динамический — в конец
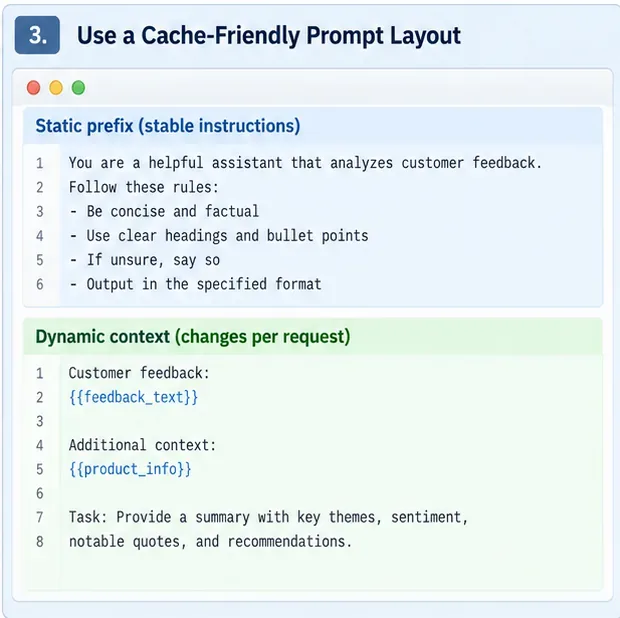
Подпись: Иллюстративная структура промпта помещает стабильные инструкции в переиспользуемый префикс и добавляет контекст, специфичный для запроса, позже.
Кеширование промптов не уменьшает сырое количество токенов, но может уменьшить объем, тарифицируемый по обычной ставке ввода, и снизить задержку обработки промпта. Это делает структуру промпта частью оптимизации затрат. Группируйте системные инструкции, общие примеры, руководства по инструментам и другой стабильный контент вместе. Помещайте факты, специфичные для запроса, извлеченные фрагменты, данные пользователя и текущий вопрос позже.
Руководство по моделям OpenAI явно рекомендует помещать статический контент в начало, а динамический — в конец, чтобы улучшить повторное использование кеша промптов, а объект использования ответа предоставляет информацию о кешированных токенах для измерения. См. официальное руководство по моделям и справочник API Responses.
Избегайте изменения безвредных пробелов, порядка примеров, временных меток, случайных идентификаторов или текста, специфичного для пользователя, внутри в остальном переиспользуемого префикса, если семантика кеша провайдера не указывает, что такие изменения безопасны. Измеряйте попадания в кеш из ответа API, а не предполагайте, что промпт переиспользуется.
Шаг 4: Замените прозу о формате элементами управления структурированным выводом
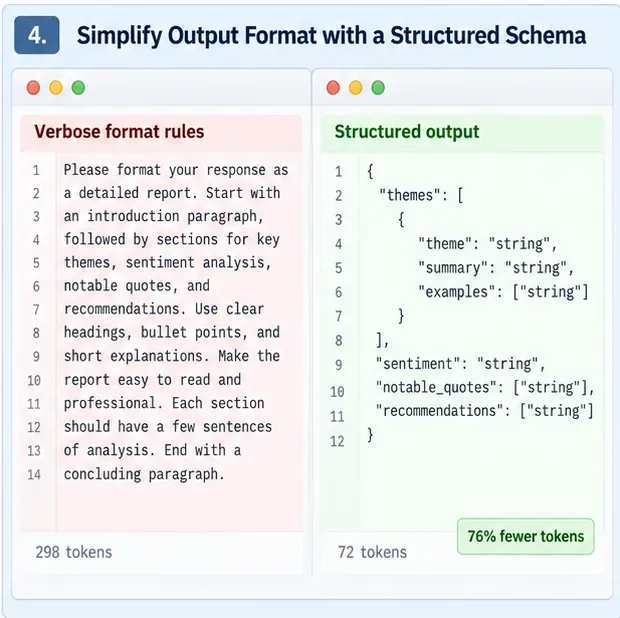
Подпись: Иллюстративный вид структурированного вывода показывает, как схема может заменить много строк прозы, которые многократно описывают одну и ту же форму ответа.
Промпты для извлечения и классификации часто тратят токены на описание полей JSON, допустимых значений, вложенности, порядка и правил валидации на естественном языке. Когда API поддерживает структурированные выводы или типизированные аргументы инструментов, перенесите как можно больше этого контракта в структурированный интерфейс и сосредоточьте инструкцию на естественном языке на смысле.
Текущее руководство OpenAI специально рекомендует удалять определения схемы вывода из промпта, где это возможно, и использовать вместо этого Structured Outputs. Это может уменьшить текст промпта, а также снизить количество повторных попыток из-за некорректного вывода. Точный механизм варьируется в зависимости от провайдера, поэтому не копируйте формат запроса, специфичный для OpenAI, в другой API, не проверив документацию этого провайдера.
Продвинутое сжатие для RAG, длинных документов и диалогов
После того как четыре базовых шага станут стабильными, большая экономия обычно достигается за счет сокращения контекста, а не шлифовки формулировок. В системах RAG извлекайте меньше, но более релевантных фрагментов, дедуплицируйте почти идентичные чанки и избегайте прикрепления документов, которые не могут повлиять на ответ. Для длинных диалогов сохраняйте долговременные факты и нерешенные решения, но суммируйте или удаляйте реплики, которые больше не влияют на текущую задачу. Для агентных систем предоставляйте только те инструменты и описания инструментов, которые относятся к текущему этапу, если ваша архитектура безопасно это позволяет.
Обучаемые компрессоры промптов — еще один вариант для очень длинных контекстов. Открытый исходный код Microsoft проект LLMLingua реализует сжатие промптов на уровне токенов. Оригинальная статья LLMLingua сообщила о коэффициентах сжатия до 20× с ограниченной деградацией бенчмарков в оцененных настройках. LongLLMLingua ориентирован на задачи с длинным контекстом, а LLMLingua-2 использует обучаемый компрессор, не зависящий от задачи. Это результаты исследований, а не обещание, что те же коэффициенты сохранят качество на ваших данных. Проводите бенчмаркинг собственных задач, языков, моделей и типов промптов перед развертыванием агрессивного сжатия.
Как доказать, что оптимизация действительно лучше
Проведите A/B-оценку на тех же репрезентативных запросах. Базовая и сжатая версии должны использовать одну и ту же модель, настройки рассуждений, инструменты, входные данные для поиска и критерии успеха. Меняйте одну технику сжатия за раз, когда это возможно, чтобы вы могли определить, что вызвало регрессию.
| Метрика | Почему это важно | Предлагаемая интерпретация |
|---|
| Сокращение входных токенов | Показывает сырое уменьшение размера промпта | Полезно, но само по себе недостаточно |
| Доля кешированных токенов | Показывает, переиспользуются ли стабильные префиксы | Чем выше, тем лучше, обычно, если качество не изменилось |
| Сокращение выходных токенов | Может существенно изменить общую стоимость | Убедитесь, что лаконичный вывод все еще завершает задачу |
| Стоимость на успешную задачу | Включает повторные попытки и сбои | Это основная бизнес-метрика |
| Успешность задачи / точность | Обнаруживает потерю информации | Установите приемлемый порог нехудшего результата перед тестированием |
| Задержка p50 и p95 | Показывает реальное влияние на пользователя | Предварительная обработка сжатия может компенсировать экономию на инференсе |
Не объявляйте победу только потому, что промпт стал на 50% короче. Более сильным условием приемки является: сжатая конфигурация снижает измеренную стоимость примерно на целевую сумму, оставаясь в пределах заранее определенных допусков по качеству, задержке и надежности.
Когда следует прекратить сжатие?
Остановитесь или отступите, когда следующее сокращение удаляет факты, необходимые для правильных решений, увеличивает галлюцинации, вызывает ошибки вызова инструментов, ослабляет соблюдение политик или повышает количество повторных попыток настолько, что сводит на нет экономию. Сжатие также может добавить задержку, если вы запускаете отдельную модель для сжатия каждого промпта. Исследование 2026 года по сжатию промптов в реальных условиях инференса обнаружило, что накладные расходы на предварительную обработку могут отменить выигрыш в инференсе вне благоприятных режимов длины промпта и оборудования, что является еще одной причиной измерять сквозную производительность, а не только количество токенов.
Для небольших промптов ручная очистка и кэш-ориентированная организация обычно легче обосновываются, чем добавление выделенной модели сжатия. Для больших полезных нагрузок RAG или многодокументных рабочих процессов выбор контекста и обучаемое сжатие становятся более привлекательными, поскольку объем удаляемых токенов намного больше.
Краткий контрольный список внедрения
- Зафиксируйте производственный базовый уровень с входом, кешированным входом, выводом, задержкой, повторными попытками и успешностью задач.
- Сначала удалите дублирующиеся инструкции, низкоценную прозу и избыточные примеры.
- Сохраняйте определения домена, исключения, требования к доказательствам и ограничения безопасности.
- Помещайте стабильный контент промпта перед динамическим контентом, специфичным для запроса, если семантика кеша вознаграждает переиспользуемые префиксы.
- Используйте структурированные выводы или схемы инструментов вместо многократного описания фиксированных форматов ответов в прозе.
- Для RAG сокращайте нерелевантный и дублирующийся контекст перед попытками сжатия на уровне токенов.
- Ограничивайте длину вывода только тогда, когда задача все еще может быть выполнена правильно.
- Сравнивайте стоимость на успешную задачу, а не только количество токенов промпта.
- Запускайте регрессионные тесты до и после каждого значимого изменения сжатия.
- Перепроверяйте цены провайдера и правила кеша при каждом изменении моделей или версий API.
Итог
Снижение на 50% — разумная инженерная цель для некоторых подробных, насыщенных контекстом рабочих нагрузок, но к ней следует относиться как к результату, который нужно валидировать, а не как к ожиданию по умолчанию. Самый надежный путь — сначала измерить, удалить семантически избыточный текст, максимизировать безопасное повторное использование кеша, сократить контракты вывода с помощью структурированных элементов управления, а затем атаковать оставшиеся самые большие блоки контекста с помощью обрезки извлечения, суммаризации или протестированного компрессора промптов. Если итоговая стоимость на успешную задачу падает, а качество остается в пределах вашего диапазона приемки, сжатие работает. Если качество или повторные попытки ухудшаются, восстановите недостающую информацию и оптимизируйте другую часть запроса.
Основные ссылки








