Главная
» Домены
»
Как создать бесплатный конвейер переработки контента с помощью ИИ на базе n8n и Claude (что действительно бесплатно)
Как создать бесплатный конвейер переработки контента с помощью ИИ на базе n8n и Claude (что действительно бесплатно)
Вы можете сделать автоматизационный слой конвейера переработки контента с помощью ИИ бесплатным, самостоятельно разместив n8n Community Edition, но рабочий процесс n8n на базе Claude не гарантирует нулевую стоимость на всех этапах. Это важное различие. n8n заявляет, что его саморазмещаемая Community Edition может использоваться бесплатно неограниченно долго, в то время как API Claude от Anthropic — это платный сервис для разработчиков с оплатой по мере использования. Бесплатный план чата Claude на сайте Claude не то же самое, что использование API внутри n8n.
По состоянию на 11 сентября 2026 года n8n документирует Community Edition как бесплатную саморазмещаемую версию с почти полным набором основных функций. Текущее ценообразование API Anthropic указывает Claude Sonnet 5 по цене $2 за миллион входных токенов и $10 за миллион выходных токенов, а Claude Haiku 4.5 — по $1 за миллион входных токенов и $5 за миллион выходных токенов. Цены и модели могут измениться, поэтому проверяйте их перед развертыванием. См. документацию n8n по Community Edition и текущую страницу цен Anthropic.
Таким образом, практическая версия «бесплатно» означает: бесплатное программное обеспечение n8n на инфраструктуре, которую вы контролируете, плюс любые расходы на использование API Claude, генерируемые вашим рабочим процессом. Если у вас уже есть инфраструктура и кредиты API, ваши дополнительные расходы могут быть временно нулевыми. Если нет, ожидайте как минимум затрат на использование модели и, возможно, затрат на хостинг.
Что будет делать этот конвейер
Приведенный ниже рабочий процесс берет один исходный элемент — например, пост в блоге, черновик рассылки, транскрипт подкаста, транскрипт вебинара или длинную заметку — и превращает его в несколько структурированных черновиков. Полезный стартовый вывод включает:
Один пост в стиле LinkedIn
Три коротких поста для социальных сетей
Одну тему письма и вступление
Один короткий хук для видео и сценарий
Пять ключевых выводов
Флаг проверки, если источник не содержит достаточно информации
Конвейер намеренно создает черновики в первую очередь. Автоматическую публикацию можно добавить позже, но обычно безопаснее сначала доказать качество контента, форматирование, точность источника и права на публикацию, прежде чем разрешать рабочему процессу ИИ публиковать без проверки.
Подходит ли вам этот подход?
Ситуация
Рекомендация
Почему
Вы перерабатываете свои собственные статьи или одобренный контент компании
Хорошо подходит
Источник контролируется, а цель преобразования предсказуема.
Вам нужны последовательные черновики для нескольких каналов
Хорошо подходит
n8n может многократно выполнять одно и то же преобразование.
Вы хотите постоянно бесплатный API Claude
Не подходит как заявлено
Использование API Claude тарифицируется; бесплатный план чата Claude не делает автоматизацию API бесплатной.
Вам нужно добавлять актуальные фактические исследования в каждый черновик
Используйте отдельный этап исследования/верификации
Переработка не должна незаметно превращаться в генерацию фактов.
Вы обрабатываете недоверенные веб-страницы или документы третьих сторон
Добавьте более сильную изоляцию ввода и проверку
Внешний контент может содержать инструкции, которые не должны управлять рабочим процессом.
Вам нужен сложный выбор инструментов и автономные решения
Рассмотрите ИИ-агента
Базовая цепочка LLM проще, когда задача представляет собой предсказуемое текстовое преобразование.
Рекомендуемая архитектура
Для первой версии не начинайте с автономного агента. Basic LLM Chain в n8n предназначен для передачи запроса подключенной языковой модели и может прикрепить парсер вывода. Этого достаточно для детерминированного рабочего процесса «источник на входе, отформатированные черновики на выходе». См. документацию n8n по Basic LLM Chain.
Шаг 1: Самостоятельно разместите n8n Community Edition
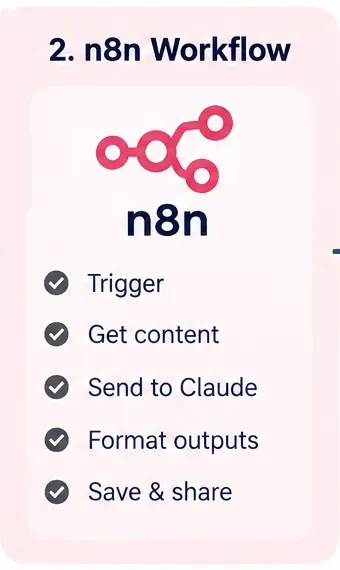
Иллюстрация, созданная ИИ, этапа рабочего процесса n8n; это не реальный скриншот n8n.
Текущая документация n8n поддерживает самостоятельное размещение с помощью Docker и описывает Community Edition как бесплатную. Docker — хорошая отправная точка, потому что он позволяет легко воспроизвести экземпляр n8n и предоставляет постоянный том для данных рабочих процессов и учетных данных.
Официальное руководство по Docker создает том n8n_data, открывает порт 5678, устанавливает переменные окружения, связанные с часовым поясом, и монтирует постоянный каталог данных. Для n8n 2.x в документации отмечается, что N8N_RUNNERS_ENABLED устарел и больше не требует установки. Используйте текущую команду из руководства по установке n8n с помощью Docker, а не копируйте старую команду из устаревшего руководства.
Для локального доказательства концепции достаточно открыть http://localhost:5678. Для производственного экземпляра, доступного из интернета, не просто открывайте локальный порт публично. Следуйте рекомендациям n8n по хостингу и безопасности для HTTPS, аутентификации, резервного копирования и настройки обратного прокси-сервера.
Используйте этот шаг, если: вам комфортно поддерживать собственный хост Docker. Если вы не хотите обновлять, защищать, создавать резервные копии и мониторить сервер, n8n Cloud проще, но это не постоянно бесплатный вариант, описанный здесь.
Шаг 2: Выберите способ запуска рабочего процесса
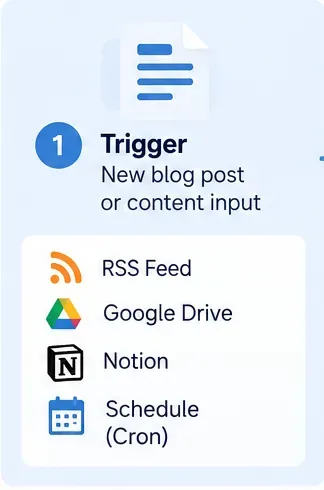
Иллюстрация, созданная ИИ, возможных триггеров рабочего процесса и источников контента; фактическая доступность узлов n8n и их конфигурация должны быть проверены в вашем экземпляре.
Используйте Webhook, когда другое приложение должно отправлять контент в n8n по запросу. Используйте Schedule Trigger, когда n8n должен проверять наличие контента в фиксированное время или через определенные интервалы.
Узел Webhook в n8n предоставляет отдельные тестовые и производственные URL-адреса. Тестовый URL предназначен для разработки; производственный URL регистрируется при публикации рабочего процесса. Узел Webhook также поддерживает варианты аутентификации, включая Basic auth, Header auth и JWT auth. См. документацию n8n по Webhook.
Для запланированной переработки Schedule Trigger в n8n запускается в фиксированное время или через интервалы, и n8n указывает, что рабочий процесс должен быть сохранен и опубликован для запланированного запуска. См. документацию n8n по Schedule Trigger.
Пример: если ваша CMS может вызывать webhook после того, как редактор одобрит статью, используйте webhook. Если вы храните одобренный исходный контент в папке и хотите пакетную обработку каждое утро по будням, расписание может быть проще.
Шаг 3: Определите один чистый контракт ввода
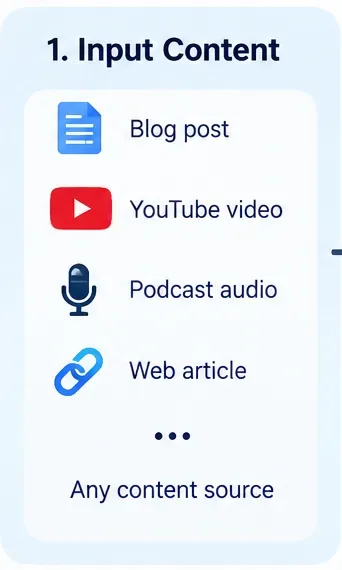
Иллюстрация, созданная ИИ, типов исходного контента, которые могут питать рабочий процесс переработки; она не изображает реальный экран n8n.
Не позволяйте каждому источнику поступать в разном формате. Нормализуйте входы в одну внутреннюю структуру перед вызовом Claude. Практичная полезная нагрузка JSON:
Передавайте фактический исходный текст, когда это возможно. URL-адрес сам по себе не то же самое, что проверенный исходный контент. Загрузка и анализ страницы добавляют еще одну точку отказа и могут привести к попаданию в запрос навигации, файлов cookie, рекламы или нерелевантного текста.
Также держите инструкции отдельно от исходного материала. Если вы загружаете страницы третьих сторон, электронные письма или загруженные документы, относитесь к их содержимому как к недоверенным данным, а не к командам рабочего процесса. Руководство Anthropic по безопасности явно описывает косвенную инъекцию запросов как вредоносные инструкции, встроенные в контент, который читает модель. См. руководство Anthropic по смягчению последствий инъекций запросов.
Шаг 4: Проверяйте и нормализуйте перед вызовом модели
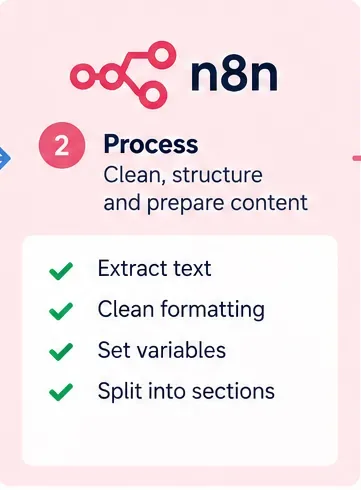
Иллюстрация, созданная ИИ, этапа предварительной обработки; это не реальный скриншот рабочего процесса n8n.
Прежде чем тратить токены, отклоняйте плохой ввод. Как минимум, проверьте, что существуют source_id, title и source_text, и что source_text не пуст. Нормализуйте очевидный шум форматирования, но сохраняйте факты, цитаты, URL-адреса, заголовки и другие детали источника, которые могут понадобиться Claude.
Полезный этап предварительной обработки может:
Удалять начальные и конечные пробелы
Преобразовывать повторяющиеся пустые строки в согласованный формат
Устанавливать значения аудитории и голоса по умолчанию
Отклонять исходный текст ниже минимальной полезной длины
Создавать стабильный source_id для дедупликации
Записывать запрошенные типы вывода
Не разбивайте обычную статью на множество вызовов модели, если вам это действительно не нужно. Множественные вызовы увеличивают сложность оркестрации и могут привести к непоследовательному тону. Для больших исходных материалов рассмотрите возможность намеренного суммирования или разбиения на части, а не случайного усечения ввода.
Шаг 5: Правильно подключите Claude — и поймите стоимость
Иллюстрация, созданная ИИ, роли Claude в рабочем процессе; это не скриншот Anthropic Console или n8n.
n8n предоставляет узел Anthropic Chat Model и учетные данные Anthropic, которые используют ключ API. Документация по учетным данным n8n направляет пользователей создавать ключ в Anthropic Console и хранить его в учетных данных n8n, а не жестко кодировать его в тексте рабочего процесса. См. документацию n8n по учетным данным Anthropic и документацию n8n по модели чата Anthropic.
Для этого конвейера подключите модель чата Anthropic к Basic LLM Chain. Практичный выбор модели зависит от ваших целей по качеству и стоимости:
Выбор модели
Когда это имеет смысл
Текущая цена API, проверенная 11 сентября 2026 г.
Claude Haiku 4.5
Высокий объем, более простые переписывания и первые черновики
$1/MTok вход; $5/MTok выход
Claude Sonnet 5
Более сильный вариант по умолчанию для многоформатной переработки с нюансами
$2/MTok вход; $10/MTok выход
Claude Opus 5
Только когда задача действительно требует более глубокого рассуждения
$5/MTok вход; $25/MTok выход
Приведенные выше цены взяты с текущей страницы цен Anthropic и могут измениться. Также избегайте копирования старых идентификаторов моделей из устаревших руководств. Anthropic поддерживает страницу устаревания моделей, потому что модели периодически устаревают и выводятся из эксплуатации. Проверьте документацию Anthropic по устареванию моделей перед жестким кодированием имени модели.
Шаг 6: Используйте один запрос, который сохраняет точность источника
Иллюстрация, созданная ИИ, многоформатной генерации контента; перечисленные выводы являются примерами, а не гарантированными функциями продукта.
Запрос должен четко обозначать границу преобразования: Claude может переформулировать и сжать источник, но не должен изобретать факты, которых нет. Текущее руководство Anthropic по составлению запросов рекомендует четкие инструкции и структурированные теги для сложных вводов. См. документацию Anthropic по лучшим практикам составления запросов.
Практичное системное сообщение:
You are a content repurposing editor.
Use only factual claims supported by the supplied source.
Do not invent statistics, quotes, customer results, dates, or product capabilities.
Preserve the original meaning while adapting format and tone.
If an output requires information not present in the source, set needs_review to true
and explain the missing information in review_notes.
Return the requested structured fields only.
Затем создайте пользовательское сообщение из выражений n8n:
Пример: если источник говорит, что продукт был запущен в мае, но никогда не приводит количество клиентов, Claude может превратить факт запуска в более короткий пост, но не должен добавлять «10 000 клиентов», чтобы пост звучал сильнее.
Шаг 7: Принудительно используйте структурированный вывод вместо анализа прозы
Иллюстрация, созданная ИИ, структурированных выводов контента; это не скриншот ответа API Claude.
Свободный текст неудобно маршрутизировать. Если Claude возвращает заголовки, которые меняются от одного выполнения к другому, последующие узлы становятся хрупкими. Structured Output Parser в n8n может возвращать поля на основе JSON Schema, а Basic LLM Chain может требовать конкретного формата вывода. См. документацию n8n по Structured Output Parser.
Если вы решите вызывать API сообщений Claude напрямую с помощью узла HTTP Request в n8n вместо использования интеграции модели чата Anthropic, Anthropic также поддерживает нативные структурированные выводы через output_config.format на поддерживаемых моделях. См. документацию Anthropic по структурированным выводам и справочник API сообщений Claude.
Шаг 8: Сохраняйте черновики, проверяйте их, затем автоматизируйте публикацию
Иллюстрация, созданная ИИ, мест назначения черновиков; это не скриншот живой интеграции и не доказательство того, что какой-либо аккаунт подключен.
Для первой производственной версии храните сгенерированные поля в месте проверки, а не отправляйте их напрямую в публичные каналы. Общие места назначения включают базу данных, Google Drive, Google Sheets, Notion, черновик в CMS или внутреннее сообщение для проверки.
Используйте needs_review как жесткий шлюз. Также рассмотрите этап человеческой проверки для всего, что отправляет внешнее сообщение или изменяет производственную систему. n8n в настоящее время поддерживает одобрение человеком в цикле для вызовов инструментов ИИ, где рецензент может одобрить или отклонить выбранные действия. См. документацию n8n по человеческому контролю в цикле.
Рекомендуемый график внедрения:
Неделя 1: генерируйте только черновики.
Неделя 2: сравнивайте выводы с источником и исправляйте сбои запроса/схемы.
Неделя 3: разрешите одобренным черновикам автоматически перемещаться в папки черновиков назначения.
Только после того, как рабочий процесс станет стабильным: рассмотрите автоматическую публикацию для форматов с низким риском.
Конкретный сквозной рабочий процесс n8n
Для простой версии на основе webhook создайте эти узлы в порядке:
#
Узел
Назначение
1
Webhook
Получить одобренный исходный элемент.
2
Edit Fields / Code
Нормализовать имена полей и значения по умолчанию.
3
If
Отклонить отсутствующий или пустой исходный текст.
4
Basic LLM Chain
Содержать инструкции по переработке и динамический исходный контент.
5
Anthropic Chat Model
Генерировать переработанные черновики.
6
Structured Output Parser
Обеспечить стабильные поля JSON.
7
If
Направить needs_review=true на ручную проверку.
8
Destination node
Сохранить одобренный вывод как черновики.
9
Respond to Webhook
Вернуть статус и сгенерированный ID записи вызывающему.
Если вы предпочитаете запланированный конвейер, замените Webhook на Schedule Trigger и добавьте узел источника, который извлекает одобренные, необработанные элементы.
Как избежать повторной переработки одного и того же источника
Добавьте неизменяемый source_id к каждому элементу и храните обработанные ID. Перед запуском Claude проверьте, был ли этот ID уже успешно обработан. Это базовая идемпотентность: повторение одного и того же триггера не должно создавать дублирующиеся черновики, если вы явно не запрашиваете новую версию.
Для ревизий используйте составной ключ, такой как source_id + source_revision. Это позволяет версии 2 статьи генерировать новые черновики, не притворяясь тем же источником, что и версия 1.
Как снизить стоимость API Claude
Выбор модели — это только один рычаг. Самая большая избегаемая стоимость часто заключается в отправке ненужного текста или генерации излишне длинных выводов.
Удаляйте навигацию, шаблонный текст и нерелевантный HTML перед вызовом модели.
Запрашивайте только те форматы, которые вам действительно нужны.
Устанавливайте разумные ограничения на длину вывода в запросе.
Используйте Haiku 4.5 для простых преобразований с высоким объемом, когда качество достаточное.
Используйте Sonnet 5, когда источник требует больше нюансов или более сильной адаптации между форматами.
Не отправляйте одно и то же длинное руководство по бренду при каждом вызове, если вы можете представить его краткими стабильными инструкциями.
Измеряйте использование токенов и стоимость, а не предполагайте, что короткий рабочий процесс дешев.
Anthropic также предлагает кэширование запросов и пакетную обработку для применимых рабочих нагрузок, но эти функции имеют свои собственные требования и цены. Не добавляйте их в первый рабочий процесс, если повторяющийся контекст или не срочная обработка с высоким объемом не оправдывают дополнительную сложность.
Три режима отказа, которые нужно протестировать перед публикацией
1. Галлюцинированные факты
Подайте в рабочий процесс источник, который намеренно опускает статистику. Ожидаемое поведение состоит в том, что вывод не изобретает ее. Если это происходит, усильте инструкции по точности источника и этап проверки.
2. Сломанный структурированный вывод
Протестируйте каждое обязательное поле, пустые массивы, необычно длинный исходный текст и специальные символы. Конвейер не является надежным только потому, что один привлекательный демонстрационный вывод выглядел правильно.
3. Дублирующиеся выполнения
Отправьте один и тот же source_id дважды. Второй запуск должен остановиться, обновить существующую запись или намеренно создать ревизию в соответствии с вашим дизайном — а не молча дублировать каждый черновик.
Нужен ли вам ИИ-агент для этого?
Обычно нет. ИИ-агент полезен, когда модель должна решить, какие инструменты вызывать, или предпринимать различные действия на основе открытой цели. Переработка контента обычно является предсказуемым преобразованием, поэтому цепочку легче инспектировать, тестировать и контролировать.
Переходите к агенту только тогда, когда у вас есть конкретная потребность, такая как динамический выбор инструментов исследования, решение о том, какое назначение получает черновик, или запрос у человека недостающей информации. Даже в этом случае держите необратимые действия по публикации за явной проверкой, пока рабочий процесс не будет хорошо протестирован.
Финальный контрольный список сборки
Самостоятельно разместите n8n Community Edition, если хотите, чтобы слой программного обеспечения n8n оставался бесплатным.
Не описывайте использование API Claude как постоянно бесплатное.
Используйте Webhook для обработки по запросу или Schedule Trigger для запланированных пакетов.
Нормализуйте каждый источник в один контракт ввода.
Передавайте исходный текст, а не только URL-адрес.
Храните ключ API Anthropic в учетных данных n8n.
Используйте активную модель Claude и периодически проверяйте страницу устаревания.
Используйте Basic LLM Chain для предсказуемой переработки.
Требуйте схему структурированного вывода.
Добавьте needs_review и заметки проверки в схему.
Дедуплицируйте с помощью стабильного ID источника.
Сохраняйте черновики перед включением автоматической публикации.
Тестируйте галлюцинации, некорректные вводы, дублирующиеся триггеры и пути отказа.
Мониторьте использование токенов и стоимость внешних сервисов.
Лучшая первая версия намеренно скучна: один чистый ввод, один контролируемый вызов Claude, один проверенный ответ JSON и одно место назначения для черновиков. Эта архитектура легко отлаживается и дешево эксплуатируется. Как только она надежно работает на реальных исходных материалах, вы можете добавить больше каналов, планирование, человеческие одобрения, аналитику или интеграции публикации, не перестраивая основной конвейер.