Главная
» Домены
»
Как измерить качество ответов на вопросы LLM с помощью оценочных инструментов.
Как измерить качество ответов на вопросы LLM с помощью оценочных инструментов.
Наиболее надежный способ измерения качества ответа LLM — рассматривать оценку как повторяемую систему тестирования, а не как единый результат. Определите, что означает «хорошо» для вашего приложения, создайте репрезентативный набор данных для оценки, объедините детерминированные проверки с модельными и человеческими оценками, сравните каждое возможное изменение с базовым уровнем и проверьте ошибки по категориям перед выпуском.
Это важно, потому что LLM может выдать ответ, который звучит безупречно, но при этом оказывается неверным, необоснованным, неполным, небезопасным или противоречащим вашим инструкциям. Полезная система оценки превращает эти расплывчатые опасения в четкие критерии, которые можно повторно использовать после изменения запроса, обновления модели, изменения способа получения данных, обновления инструмента или пересмотра политики безопасности.
Примечание к документации: описанные ниже возможности фреймворка были проверены на соответствие официальной документации, доступной по состоянию на 13 сентября 2026 года. Эти инструменты быстро развиваются, поэтому перед копированием кода, специфичного для фреймворка, в рабочую среду, проверьте актуальные API.
Что следует измерить в первую очередь?
Начните с того недостатка, который будет наиболее важен для ваших пользователей. Для бота, предоставляющего фактическую поддержку, решающее значение могут иметь корректность и соответствие политике. Для генерации с использованием дополненного поиска информации (RAG) важны обоснованность и качество поиска, поскольку даже беглый ответ может содержать вымышленные факты, не подтверждаемые полученным контекстом. Для агента качества окончательного ответа недостаточно; вам также может потребоваться оценить выбор инструмента, аргументацию инструмента, выполнение задачи и наличие ненужных шагов.
измерение качества
Что в нём спрашивается
Хороший тип оценщика
Правильность
Является ли этот ответ фактическим или логическим?
Правила кодекса плюс судья, использующий критерии оценки.
Укорененность
Подтверждаются ли утверждения предоставленным контекстом?
Проверки на уровне судьи или на уровне иска, специфичные для RAG.
Релевантность
Дает ли ответ ответ на сам вопрос, не отклоняясь от него?
Судья или эксперт по оценке работ (LLM)
Соответствие формату
Является ли полученный результат допустимым JSON, соответствует ли он схеме или иным образом пригоден для машинной обработки?
Детерминированный код
Безопасность и политика
Нарушает ли данный ответ правила вашего приложения?
Проверка политики, экспертная оценка (магистр права) и целенаправленная экспертиза с участием людей.
Эффективность
Какую задержку, расход токенов и стоимость требовал ответ?
Телеметрия и отслеживание
Не следует слишком рано усреднять эти показатели в одно число. Модель-кандидат, которая выигрывает два пункта в плане стиля, но вводит даже небольшое количество серьезных политических ошибок, может оказаться худшим вариантом для выпуска. Сохраняйте критически важные параметры видимыми в виде отдельных этапов.
Четырехэтапный алгоритм оценки, применимый к различным методологиям.
1. Создайте репрезентативный набор данных для оценки.
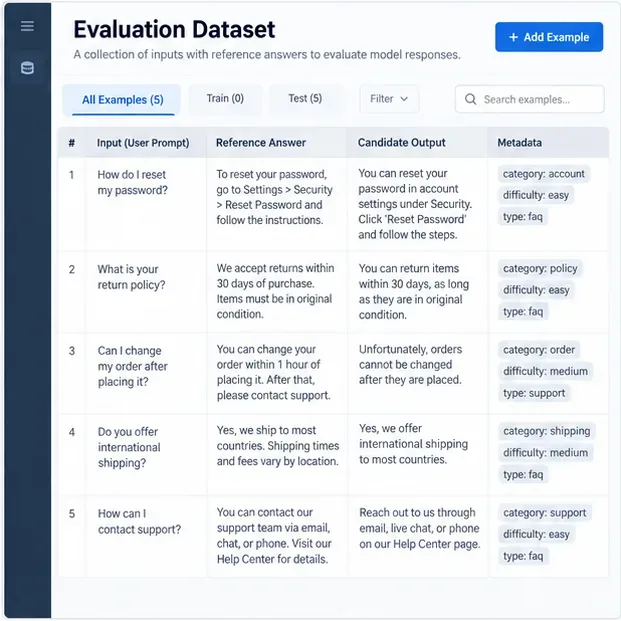
Ваш набор данных должен содержать реалистичные входные данные и, по возможности, ожидаемое поведение. Некоторые строки могут содержать точные эталонные ответы; для других может потребоваться определенная рубрика, а не одно «идеальное» предложение. Добавьте метаданные, такие как тип задачи, сегмент клиента, язык, сложность, условия получения или категория безопасности, чтобы вы могли позже сегментировать результаты.
Например, представьте себе помощника службы поддержки клиентов. Полезный набор вопросов для оценки должен содержать не только простые часто задаваемые вопросы. Он также должен включать неоднозначные запросы, исключения из правил, случаи отсутствия контекста, конфликтные подсказки, многоэтапные последующие действия и примеры, когда правильным поведением является утверждение, что ответ определить невозможно.
В текущих рекомендациях LangSmith по оценке рекомендуется начинать с вручную отобранных примеров, демонстрирующих корректное поведение, а затем расширять набор данных за счет исторических трассировок и сбоев, обнаруженных в производственной среде. Система оценки поддерживает наборы данных с входными данными, необязательными эталонными выходными данными и метаданными. См. документацию LangSmith по концепциям оценки .
В оценочном наборе данных следует сопоставлять реалистичные подсказки с примерами или ожидаемым поведением и сохранять метаданные для последующего анализа сбоев.
Когда подходит этот подход: почти всегда. Даже если вы используете оценку в реальных условиях, вам все равно нужен стабильный набор данных для регрессионного тестирования в автономном режиме. Если у вас нет эталонного ответа для заданий с открытым ответом, вместо этого сохраните рубрику, необходимые факты, запрещенные действия или попарные предпочтения.
2. Сопоставьте каждый параметр качества с соответствующим оценщиком.
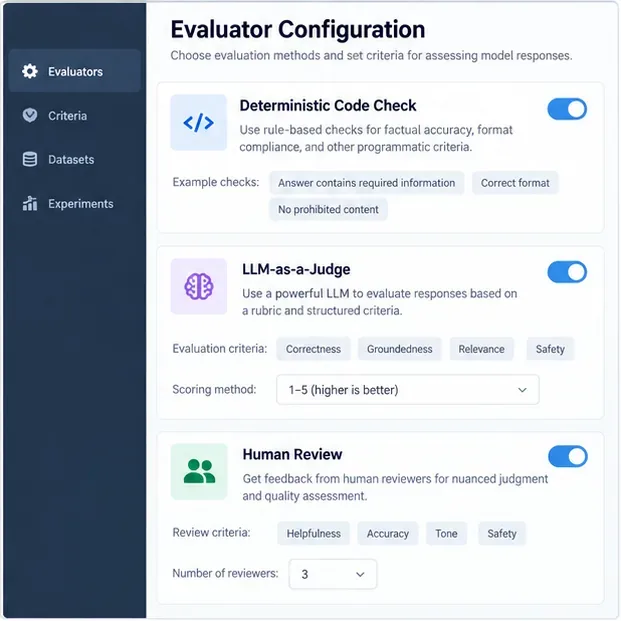
Наиболее эффективные оценочные системы используют смешанный состав экспертов, поскольку ни один эксперт не подходит идеально для решения всех вопросов.
Детерминированные проверки наиболее эффективны, когда требование однозначно: корректность JSON, точные метки, необходимые ключи, допуск по числу, правила регулярных выражений или использование допустимых аргументов при вызове инструмента.
Метрики, основанные на эталонных данных, могут помочь, когда существует известный ответ, но сходство строк само по себе часто слишком ненадежно для корректных перефразирований и слишком снисходительно к семантически некорректному тексту, имеющему общую лексику.
Кандидат на должность судьи, имеющий степень магистра права, может быть полезен для оценки по таким критериям, как полнота, релевантность, тон, достоверность или соответствие открытого ответа заданным критериям.
Попарная оценка полезна в тех случаях, когда проще решить, какой из вариантов лучше — кандидат А или базовый вариант В, чем присвоить осмысленный абсолютный балл.
Человеческий фактор по-прежнему важен для калибровки автоматизированных систем оценки, разрешения субъективных или важных случаев, а также для проверки того, отражает ли сам показатель ценность для пользователя.
Текущий API оценок OpenAI определяет оценку как критерии тестирования плюс схему источника данных и поддерживает многократно используемые средства оценки. Его API оценок включает детерминированные проверки строк, оценки на основе сходства текста и оценки на основе моделей; см. справочник по API оценок OpenAI и справочник по средствам оценки OpenAI . Сервис оценки искусственного интеллекта Vertex AI Gen от Google Cloud поддерживает точечные и попарные метрики на основе моделей, а также вычислительные метрики; его результаты могут включать оценки для каждого экземпляра, пояснения, совокупные средние значения, стандартные отклонения и попарные показатели выигрыша. См. документацию по результатам оценки Vertex AI .
По возможности используйте детерминированные правила, привлекайте экспертов-юристов, работающих по критериям LLM, для оценки семантического качества и сохраняйте возможность проведения экспертной оценки для калибровки и рассмотрения сложных случаев.
Когда такой подход уместен: используйте детерминированные проверки для машинно-проверяемых требований, LLM-судей для оценки семантических качеств и людей, если разногласия имеют существенные последствия для бизнеса или безопасности. Для системы RAG Ragas предоставляет такие метрики, как точность контекста, полнота контекста, релевантность ответа и достоверность, а также метрики использования агента/инструмента, включая точность вызова инструмента и точность достижения цели агентом. См. документацию по метрикам Ragas . DeepEval также предоставляет метрики, специфичные для задач, и пользовательскую оценку LLM-судей, включая оценку в стиле G-Eval; см. документацию по метрикам DeepEval .
3. Проведите тестирование с тем же набором данных, используя базовый вариант и вариант-кандидат.
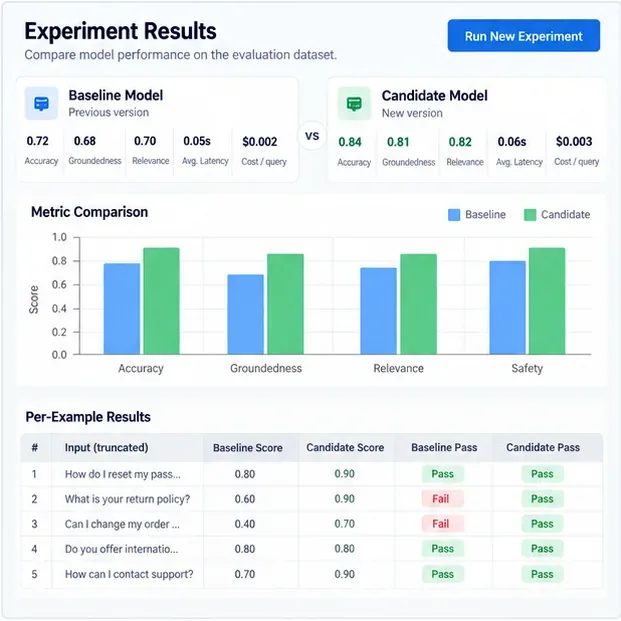
Абсолютные значения показателей полезны, но решения о выпуске обычно становятся более очевидными, когда новая конфигурация тестируется на основе уже проверенной версии. Старайтесь поддерживать набор данных, определения оценщика, параметры модели и настройки выборки в максимально стабильном состоянии. Затем сравните одни и те же примеры бок о бок.
Отслеживайте результаты как минимум на трех уровнях:
Результаты по каждому примеру: Какие именно подсказки улучшились, а какие ухудшились?
Результаты по отдельным фрагментам: Изменилась ли производительность при ответе на вопросы с длинным контекстом, при использовании определенного языка, в сложных случаях, при выборе категории товара или при вводе некорректных данных?
Сводные результаты: Что произошло с процентом успешных сдач, средним баллом, задержкой, использованием токенов, стоимостью и количеством серьезных неудач?
Для недетерминированных систем следует повторно запускать важные тесты достаточное количество раз, чтобы понять изменчивость, а не предполагать, что одно завершение теста отражает модель. Если решение о выпуске имеет важное значение, используйте парные сравнения на одних и тех же примерах и сообщайте о неопределенности, а не полагайтесь только на незначительное изменение среднего значения.
LangSmith поддерживает офлайн-эксперименты для сравнения версий и попарной оценки, в то время как текущий стек оценки GenAI от MLflow поддерживает наборы данных для оценки, встроенные и пользовательские оценщики, судей LLM, обратную связь от людей, трассировку и мониторинг в производственной среде. См. раздел «Оценка LangSmith» и «Оценка MLflow LLM и агентов» .
Сравните кандидата с текущим базовым показателем на тех же примерах, затем проанализируйте как общие показатели, так и результаты прохождения или непрохождения каждого примера.
Этот подход уместен при любых изменениях модели, системного запроса, конвейера обработки данных, реализации инструмента или настроек декодирования. Кандидата не следует повышать в должности только потому, что повысился один совокупный показатель; он должен соответствовать пороговым значениям для выпуска по критически важным параметрам и избегать неприемлемых регрессий на уровне отдельных сегментов.
4. Проанализируйте сбои, откалибруйте систему оценки и преобразуйте результаты регрессионного анализа в новые тесты.
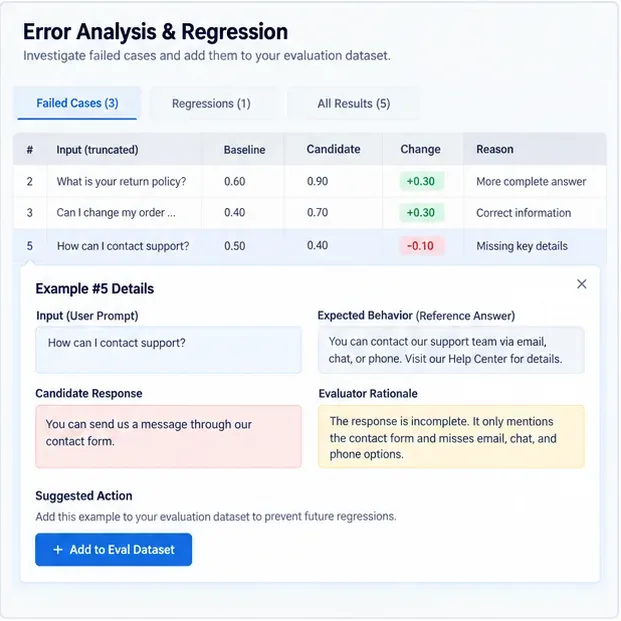
Результаты оценочного запуска ценны только в том случае, если они влияют на ваши дальнейшие действия. Сортируйте ошибки по степени серьезности и первопричине. Низкий балл за обоснованность может быть следствием слабого поиска информации, подсказки, побуждающей к угадыванию, слишком расплывчатой оценочной шкалы или неверного ответа на справочный вопрос. Перед изменением модели ознакомьтесь с базовыми примерами.
Затем важные сбои следует перевести в категорию постоянных регрессионных ошибок. Это создает замкнутый круг: в производственной среде обнаруживается сбой, человек подтверждает его, случай добавляется в автономный набор данных, исправление тестируется на всем наборе тестов, и будущие релизы блокируются от повторного возникновения той же проблемы.
Судьи, работающие по программе LLM, также нуждаются в оценке. В документации Google четко описывается сравнение результатов метрик, полученных с помощью моделей, с оценками людей для определения того, достаточно ли хорош судья для конкретного случая использования. В работе OpenAI GDPval аналогичным образом используется попарная оценка экспертов в качестве основного стандарта, а автоматическая оценка описывается как приближение, а не замена экспертной оценки. См. руководство Vertex AI по оценке модели судьи и методологию GDPval от OpenAI .
Проанализируйте фактические примеры с ошибками, убедитесь в правильности оценок эксперта и добавьте важные регрессии в постоянный набор тестовых данных.
Когда такой подход уместен: всегда для серьезных ошибок и всякий раз, когда судья LLM влияет на решение о выпуске. Если эксперты неоднократно не соглашаются с решением судьи, следует исправить критерии оценки, предоставить более четкие ссылки, изменить модель работы судьи или вернуть этот критерий в ведение экспертов.
Насколько надежен магистр права в качестве судьи?
Эксперты из числа студентов магистратуры обладают значительным влиянием, поскольку могут оценивать работы, написанные в свободной форме, в масштабе, недоступном для оценки только человеком. В оригинальном исследовании G-Eval сообщалось о значительно лучшей корреляции с человеческим суждением, чем с традиционными автоматическими метриками в изучаемой среде суммаризации. Однако в той же статье предупреждалось, что эксперты из числа студентов магистратуры могут отдавать предпочтение тексту, сгенерированному самими студентами. См. оригинальную статью G-Eval .
Отдельные исследования на платформах MT-Bench и Chatbot Arena показали, что опытные судьи с магистерской степенью в области права могут хорошо соответствовать предпочтениям людей, одновременно демонстрируя предвзятость в оценке, многословие, стремление к самовозвеличиванию и предвзятость, связанную с рассуждениями. См. оригинальное исследование о роли судьи с магистерской степенью в этой области .
Практический вывод не в том, чтобы «никогда не использовать судей с лицензией LLM». А в том, чтобы их калибровать. Создайте выборку с разметкой от человека, измерьте степень согласованности, изучите категории разногласий, рандомизируйте или меняйте порядок ответов в парных тестах, когда возможны эффекты позиции, и избегайте ситуации, когда один и тот же расплывчатый запрос судьи молча определяет каждое решение о выпуске.
Какую систему оценки следует выбрать?
Рамки
Наилучший вариант
Заметная сила
Оценщики и эксперты OpenAI
Команды, уже использующие API OpenAI и желающие проводить оценку производительности непосредственно через API, могут обратиться к соответствующим сервисам.
Многократно используемые определения оценок с детерминированными и модельными системами оценивания.
ЛангСмит
Приложения для программы LLM, требующие трассировки, наборов данных, офлайн-регрессионных тестов и онлайн-оценки.
Эффективный механизм сравнения результатов экспериментов и обратной связи в процессе производства.
Рагас
Конвейеры обработки данных RAG и оценка использования агентов/инструментов
Специально разработанные метрики поиска, достоверности, релевантности и инструментов.
DeepEval
Команды, ориентированные на Python, которым нужны оценки в формате тестирования и настраиваемые судьи LLM.
Обширный каталог метрик, оценка компонентов/сквозного процесса и метрики траектории агентов.
Оценка MLflow GenAI
Команды, которые уже используют MLflow или хотят связать оценку с трассировкой и управлением жизненным циклом, могут использовать этот метод.
Наборы данных, оценщики, обратная связь от людей, отслеживание экспериментов и мониторинг производства.
Vertex AI Gen AI Evaluation
Развертывания Google Cloud
Поточечные, попарные, модельные и вычислительные методы оценки
Выбор фреймворка менее важен, чем разработка алгоритма оценки. Вы можете создать слабый набор тестов на сложной платформе или сильный с помощью нескольких скриптов. Отдавайте предпочтение инструменту, который делает ваши тесты воспроизводимыми, версионированными, легко проверяемыми и простыми для запуска перед каждым значимым изменением.
Практическая оценочная таблица выпуска
Для помощника по производству полезное решение о выпуске можно выразить в виде набора критериев, а не одного комбинированного показателя. Например, необходимо требовать отсутствия критических сбоев безопасности в отобранном наборе критериев, отсутствия статистически значимого снижения корректности выполнения задач, минимального уровня соответствия требованиям для вопросов RAG, корректного структурированного вывода для каждого случая схемы, а также задержки или стоимости в рамках операционного бюджета. Точные пороговые значения должны определяться вашей допустимой степенью риска и требованиями пользователей; не существует универсального процента, который бы делал LLM «достаточно хорошим».
Также необходимо сохранять исходные примеры, лежащие в основе оценки. Если в релизе оценка повышается с 0,84 до 0,86, вам все равно нужно знать, какие два случая изменились и имеют ли эти изменения значение. На практике команды получают больше пользы от небольшого числа четко классифицированных сбоев, чем от впечатляющего среднего показателя на панели мониторинга без возможности отслеживания.
Распространенные ошибки при оценке
Тестирование только «счастливых сценариев»: добавление неоднозначности, граничных случаев, попыток внедрения подсказок, отсутствия контекста и известных исторических сбоев.
Используйте точное совпадение для ответов в свободной форме: используйте точное совпадение только в тех случаях, когда точность действительно необходима.
Доверять судье, имеющему степень магистра права, без предварительной оценки: сравните его оценку с оценками, данными человеком, и рассмотрите разногласия.
Оптимизация средних показателей при одновременном сокрытии серьезных сбоев: безопасность, политика и другие критически важные аспекты должны оставаться явными контрольными точками.
Изменение набора данных во время сравнения моделей: заморозьте набор данных для сравнения или создайте его версию, чтобы результаты оставались интерпретируемыми.
Игнорирование отклонений в производственной среде: офлайн-оценки защищают релизы; онлайн-оценка и выборочная проверка пользователями выявляют новое поведение пользователей и новые виды сбоев.
Итог
Оценка качества ответа LLM — это инженерная дисциплина, а не проверка на интуитивном уровне. Начните с репрезентативного набора данных, определите специфические для задачи параметры качества, выберите детерминированные проверки там, где это требование может быть вычислено, используйте экспертов LLM там, где необходима семантическая оценка, откалибруйте этих экспертов с помощью людей и сравните изменения кандидатов со стабильным базовым уровнем. Затем превратите каждый важный сбой в реальном мире в будущий регрессионный тест.
Если следовать этому циклу, то система оценки становится чем-то большим, чем просто панелью отчетов: она превращается в систему контроля качества, которая показывает, действительно ли изменение запроса, модели, способа получения данных или обновление агента улучшило продукт.