Главная
» Домены
»
Как исправить ошибку «API Timeout Error» при запуске многоагентных рабочих процессов
Как исправить ошибку «API Timeout Error» при запуске многоагентных рабочих процессов
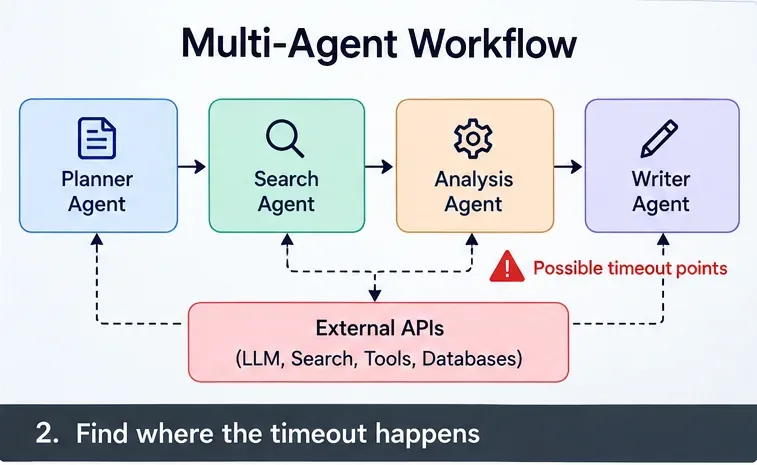
Ошибка «Тайм-аут API» в многоагентном рабочем процессе редко решается изменением одного параметра. Планировщик может вызывать три агента, каждый агент может вызывать LLM, службу поиска, базу данных или API инструмента, и каждый слой может иметь свой собственный тайм-аут, политику повторных попыток, пул соединений и ограничение на количество одновременных вызовов. Практическое решение заключается в определении того, какой слой выдает ошибку тайм-аута первым, а затем в выборе между более длительным ожиданием, меньшим количеством одновременных вызовов, более интеллектуальными повторными попытками, более коротким критическим путем или асинхронной архитектурой задания.
Компромисс имеет значение: увеличение тайм-аута — простая процедура, но она дольше удерживает ресурсы; агрессивные повторные попытки могут увеличить нагрузку и стоимость; снижение параллелизма повышает стабильность, но снижает пиковую пропускную способность; параллельные агенты уменьшают задержку по времени только тогда, когда нижестоящие сервисы могут справиться с разветвлением. Не существует единой оптимальной настройки для каждой многоагентной системы.
На какой именно таймаут вы нажимаете?
Начните с классификации сбоя, а не рассматривайте каждый таймаут как одно и то же событие. HTTP-клиенты могут выдавать ошибку таймаута во время подключения, чтения, записи или ожидания соединения из пула. Например, HTTPX описывает четыре отдельных типа таймаутов: подключение, чтение, запись и пул. По умолчанию таймаут срабатывает через пять секунд бездействия в сети, а не обязательно через пять секунд общей продолжительности запроса. См. официальную документацию по таймаутам HTTPX .
Если вы используете OpenAI Python SDK, в его официальном файле README указано, что по умолчанию время ожидания запроса составляет 10 минут, а в случае ошибки по умолчанию выполняется две повторные попытки. SDK также автоматически повторяет попытки при ошибках подключения, а также при ответах HTTP 408, 409, 429 и 5xx с небольшим экспоненциальным запаздыванием. Это настройки по умолчанию для SDK, а не гарантия того, что каждый прокси-сервер, балансировщик нагрузки, шлюз или оркестратор перед запросом будет ждать 10 минут. См. официальный файл README OpenAI Python SDK .
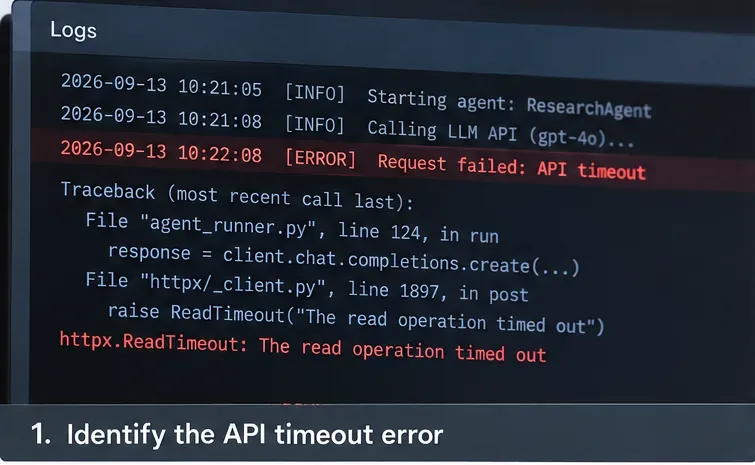
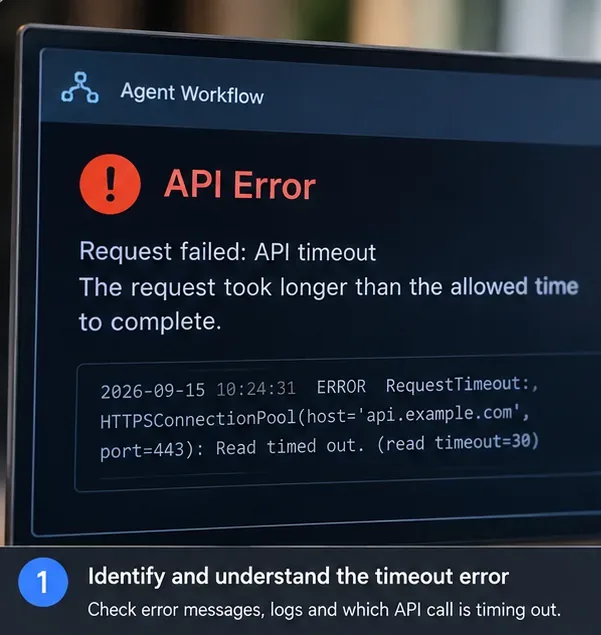
Шаг 1: зафиксируйте точное исключение, а также агент, конечную точку и транспортный уровень, приведшие к таймауту, вместо того, чтобы регистрировать только общую ошибку рабочего процесса.
Какой способ ремонта вам следует выбрать?
Вариант
Наилучший вариант
Главное преимущество
Главный компромисс
Увеличьте время ожидания запроса.
Здоровые, но действительно медленные вызовы моделей/инструментов.
Минимальные изменения в коде и архитектуре.
Рабочие процессы и соединения остаются занятыми дольше; вышестоящий шлюз может сначала завершить запрос.
Повторить попытку с экспоненциальной задержкой
Кратковременные сетевые ошибки, ограничения скорости, отдельные сбои 5xx.
Автоматически восстанавливается после кратковременных сбоев.
Может значительно увеличить трафик, задержку и стоимость; небезопасен для неидемпотентных действий, если не разработан тщательно.
Снижение одновременности агентов
429s, тайм-ауты пула, насыщение ниже по потоку
Уменьшает всплески активности и конкуренцию в очереди.
Более низкая пиковая пропускная способность и иногда более длительное время выполнения рабочего процесса.
Параллелизация независимых агентов
Последовательные рабочие процессы с независимыми ветвями
Сокращает критический путь
Увеличивает количество одновременных запросов и может привести к срабатыванию ограничений скорости или количества подключений.
Частичный вывод потока
Интерактивный пользовательский интерфейс, где важна задержка первого байта.
Пользователи видят прогресс быстрее.
Не устраняет автоматически проблему с превышением времени ожидания интеграции или перегрузкой нижестоящего сервиса.
Переместить задачу в асинхронную задачу/очередь.
Рабочие процессы, которые могут занимать десятки секунд или минут.
Разделяет жизненный цикл HTTP-запроса и жизненный цикл рабочего процесса.
Требуется контроль состояния задания, опрос/веб-хуки, идемпотентность, обеспечение постоянного доступа и оперативный мониторинг.
Шаг 1: Найдите первый слой, который превысил установленный срок.
Запишите идентификатор корреляции для всего рабочего процесса и идентификатор сегмента или дочернего элемента для каждого вызова агента и инструмента. Запишите время начала, время окончания, конечную точку, номер попытки, тип исключения, статус ответа (если доступен) и информацию о том, произошла ли отмена со стороны вызывающего абонента или нижестоящей службы.
Важный вопрос: «Кто первым перестал ждать?» Если вызов LLM завершается за 42 секунды, но шлюз API отказывается на 30 секундах, увеличение таймаута клиента LLM с 60 до 120 секунд ничего не меняет. В текущей документации Amazon для HTTP API шлюза указан максимальный таймаут интеграции в 30 секунд, что является хорошим примером того, почему самый короткий срок в цепочке часто определяет результат. См. квоты HTTP API шлюза Amazon .
Шаг 2: составьте карту пути запроса и отметьте все места, которые могут привести к завершению или задержке вызова: оркестратор, агент, шлюз, API модели, API поиска, база данных и сервис инструментов.
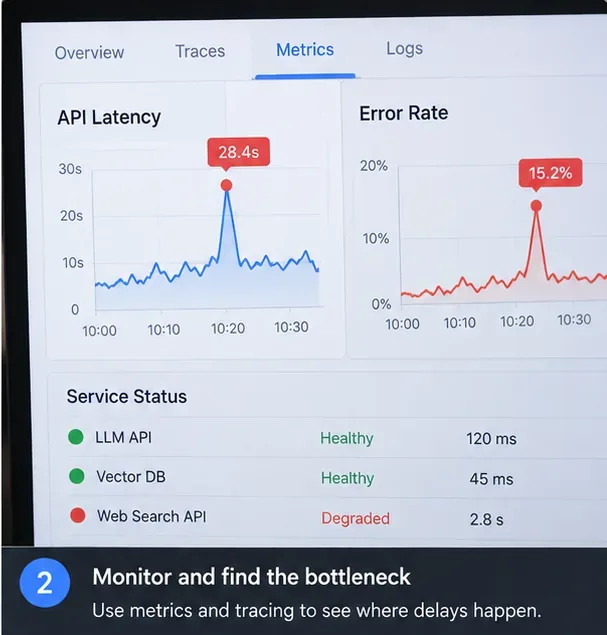
Шаг 2: Измерьте критический путь, а не только среднюю задержку.
Средняя задержка может выглядеть нормально, в то время как небольшое количество медленных вызовов является причиной большинства сбоев в рабочем процессе. Отслеживайте как минимум показатель успешности каждой зависимости, а также задержку p50, p95 и p99. На этапе развертывания также регистрируйте время ожидания в очереди и время ожидания в пуле соединений, поскольку «медленный API» на самом деле может быть перегруженным клиентом, ожидающим свободного соединения.
Используйте трассировку, чтобы ответить на три практических вопроса: какая зависимость доминирует на критическом пути, выполняются ли несколько медленных агентов последовательно, когда они могли бы выполняться одновременно, и совпадают ли всплески параллельной обработки с ошибками 429, pool-timeout или 5xx.
Шаг 3: сравните задержку, ошибки и состояние зависимостей; всплеск таймаута, совпадающий с одной из проблемных зависимостей, предполагает иное решение, чем всплеск параллельной обработки данных в масштабах всей системы.
Шаг 3: Составьте бюджет перерывов, исходя из внешних факторов.
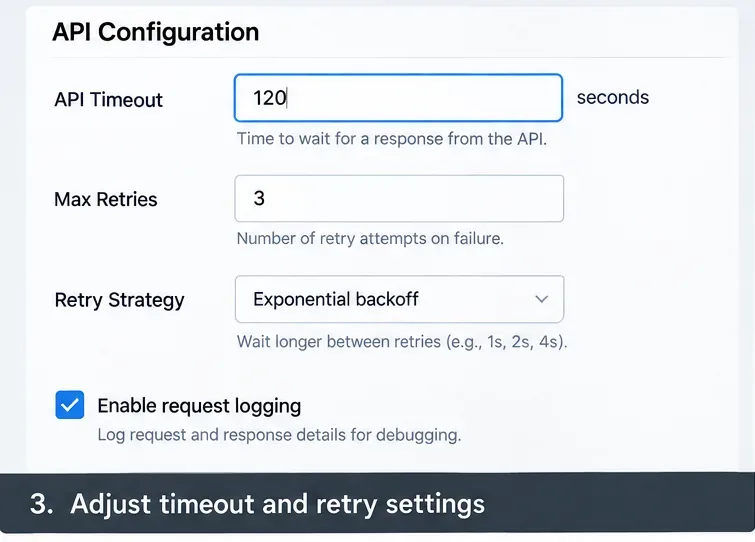
Сначала установите крайний срок для всего рабочего процесса, а затем сократите внутренние сроки, чтобы сбои на нижних уровнях происходили достаточно рано, чтобы оркестратор мог восстановиться. Например, при крайнем сроке в 120 секунд для взаимодействия с пользователем, 10 секунд могут быть зарезервированы для оркестрации и обработки ответов, оставив 110 секунд для полезной работы. На отдельный вызов инструмента может быть выделено 15 секунд, а на вызов модели — 45 или 60 секунд в зависимости от наблюдаемой задержки.
Не копируйте эти значения вслепую; это примерный метод планирования бюджета, а не универсальные значения по умолчанию. Выбирайте значения из распределения измеренных задержек и уровня обслуживания продукта. Внешний крайний срок должен быть достаточно длительным, чтобы вместить внутренний вызов, допустимые повторные попытки, задержки задержки и время очистки.
В Python 3.11 и более поздних версиях предусмотрена asyncio.timeout()возможность установки крайнего срока для асинхронной работы. По истечении этого срока задача отменяется, и менеджер контекста выдает сообщение об ошибке TimeoutError. См. официальную документацию Python по таймаутам asyncio .
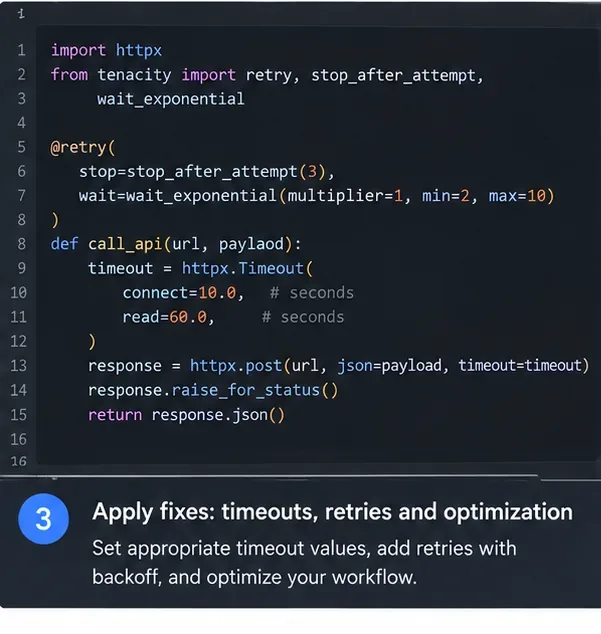
Шаг 4: настройте значения тайм-аута и количества повторных попыток как скоординированный бюджет, а не увеличивайте каждое значение по отдельности.
Шаг 4: Ограничьте количество параллельных запросов, прежде чем увеличивать количество повторных попыток.
Многоагентные системы часто дают сбои из-за того, что скорость распространения запросов превышает ожидаемую. Если 20 запросов от пользователей запускают по пять агентов, и каждый агент запускает два инструмента, система может создать до 200 нисходящих вызовов до повторных попыток. Добавление повторных попыток в первую очередь может превратить перегрузку в шторм повторных попыток.
При получении ответов с кодом 429, превышении времени ожидания пула, увеличении времени ожидания в очереди или насыщении зависимостей, ограничитель параллельного выполнения часто является лучшим первым шагом. Python asyncio.Semaphoreпредоставляет простой способ ограничения количества сопрограмм, одновременно входящих в защищенную секцию, с помощью счетчика. См. официальную документацию Python по семафорам .
import asyncio

sem = asyncio.Semaphore(8)

async def guarded_agent_call(agent, task):
    async with sem:
        return await agent.run(task)
Компромисс установлен намеренно: более низкий предел защищает нижестоящие сервисы, но может увеличить очередь внутри вашего приложения. Настраивайте его с учетом пропускной способности, задержки p95, ограничений скорости и емкости пула соединений, а не выбирайте максимально возможное число, которое может запланировать ваша машина.
Шаг 5: сопоставьте ограниченную параллельность с явными настройками транспорта, чтобы полный пул соединений не маскировался под медленную модель или инструмент.
Шаг 5: Повторяйте только те неудачные попытки, которые с большей вероятностью приведут к успеху в дальнейшем.
Повторные попытки полезны при временных сбоях соединения, ограничениях скорости, ошибках выбранного сервера и таймаутах запросов, когда повторение операции безопасно. Они являются плохим вариантом по умолчанию при ошибках проверки, сбоях аутентификации, детерминированных ошибках инструментов или действиях с побочными эффектами без защиты от идемпотентности.
Обратите внимание на умножение количества повторных попыток. Если SDK выполняет две повторные попытки, это означает до трех попыток для одного логического вызова. Если ваш агентский слой также дважды повторяет весь вызов, теоретический максимум становится девятью попытками для этой одной логической операции: три внешние попытки, умноженные на три попытки SDK. Если оркестратор затем повторяет весь этап с участием пяти агентов, объем запросов может быстро возрасти.
По возможности централизуйте управление повторными попытками. Для вызовов LLM с использованием OpenAI Python SDK помните, что текущий SDK уже по умолчанию повторяет определенные классы ошибок дважды. Добавляйте внешнюю повторную попытку только тогда, когда у вас есть конкретная причина и вы можете ограничить общий бюджет попыток. citeturn212133view0turn212133view1
Шаг 6: классифицируйте ошибку перед повторной попыткой; превышение времени ожидания чтения может оправдать ограниченное количество повторных попыток, в то время как постоянная ошибка конфигурации обычно этого не требует.
Шаг 6: Сократите критический путь, не создавая проблемы разветвления.
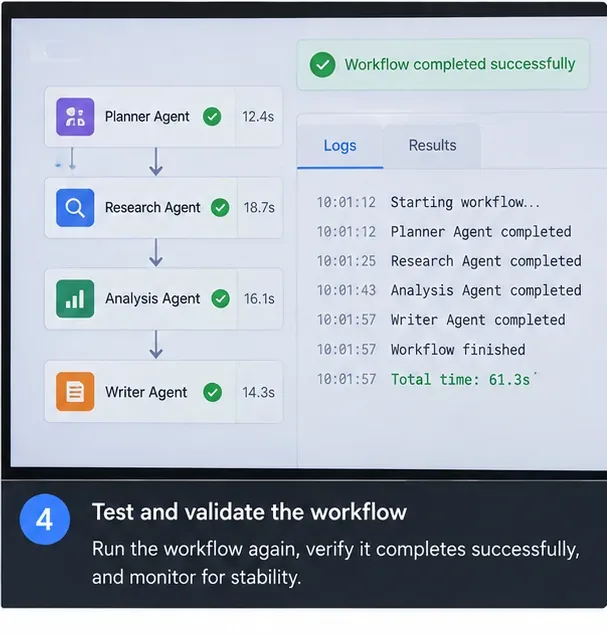
Если агенты «планировщик», «исследователь», «оценщик» и «писатель» работают строго последовательно, то общая задержка приблизительно равна сумме их длительностей. Независимые ветви иногда могут работать одновременно, сокращая время выполнения в сторону самой медленной ветви, а не беря его целиком.
TaskGroup в Python asyncio.TaskGroup— это структурированный способ одновременного выполнения связанных задач. В текущей документации Python отмечается, что TaskGroup ожидает завершения задач в группе и отменяет оставшиеся задачи, если одна из них завершается с ошибкой, не приводящей к отмене, что обеспечивает более высокий уровень безопасности, чем неструктурированное создание задач. См. официальную документацию по TaskGroup в Python .
Параллелизация не бесплатна. Если один и тот же провайдер устанавливает жесткий лимит запросов в минуту или одновременных запросов, запуск четырех агентов одновременно может превратить медленный, но успешный рабочий процесс в быстрый всплеск ответов (429). Параллелизуйте только действительно независимые задачи и сохраняйте глобальный ограничитель параллельного выполнения.
Шаг 7: Когда следует прекратить использование синхронных HTTP-запросов?
Если обычные рабочие процессы регулярно превышают кратчайшее время ожидания запроса в вашем сетевом пути, переход к асинхронной модели заданий обычно оказывается более эффективным, чем постоянное увеличение времени ожидания. Первоначальный HTTP-запрос может проверить входные данные, создать устойчивое задание и немедленно вернуть идентификатор задания. Затем рабочие процессы выполняют многоагентный граф вне жизненного цикла запроса, в то время как клиент получает информацию о ходе выполнения посредством опроса, событий, отправляемых сервером, WebSocket или веб-хука.
Потоковая передача данных полезна, когда сервер может начать отправлять значимые выходные данные на раннем этапе. Например, Python SDK OpenAI поддерживает потоковую передачу событий, отправляемых сервером, для вызовов API ответов. Потоковая передача повышает воспринимаемую скорость отклика и позволяет поддерживать активное соединение, генерирующее данные, но она не решает автоматически проблему максимального времени жизни запроса для каждого прокси-сервера. См. официальную справочную информацию по потоковой передаче событий OpenAI .
Выбирайте асинхронные задания, когда надежность важнее непосредственной простоты: длительные исследовательские задачи, рабочие процессы агентов с участием человека, множество вызовов инструментов, дорогостоящие операции, которые вы не хотите повторять, или рабочие нагрузки, которые должны выдерживать разрывы соединения с клиентом. Платой за это является дополнительное управление состоянием: статус задания, контрольные точки, ключи идемпотентности, отмена, хранение результатов и ответственность за повторную попытку.
Шаг 7: для длительных рабочих процессов отслеживайте завершение работы агента как устойчивое состояние рабочего процесса, вместо того чтобы полагаться на то, что одно клиентское соединение останется открытым до тех пор, пока не завершит работу каждый агент.
Шаг 8: Проверьте работоспособность исправления при реальной нагрузке.
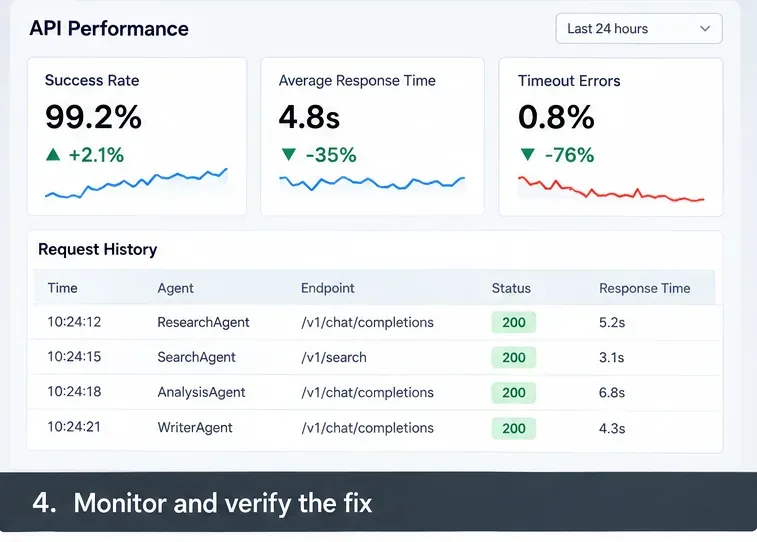
Исправление не считается доказанным, если хотя бы один запрос выполнен успешно. Проведите тестирование при ожидаемом в производственной среде уровне параллельной обработки и измерьте процент успешных запросов, процент тайм-аутов, количество повторных попыток для каждой логической задачи, задержку p95 и p99, задержку в очереди, ожидание в пуле соединений, скорость обработки запросов 429/5xx и стоимость выполнения одного рабочего процесса.
Если вы используете агенты в Kubernetes, используйте проверки готовности и работоспособности для разных целей. В документации Kubernetes проверки готовности описываются как механизм, определяющий, должен ли Pod получать трафик, а проверки работоспособности определяют, когда контейнер должен быть перезапущен. В документации прямо указывается, что плохо реализованные проверки работоспособности могут привести к каскадным сбоям под нагрузкой. См. официальную документацию Kubernetes по проверкам .
При временной перегрузке зачастую безопаснее оказаться «не готовым», чем неоднократно убивать здоровых, но занятых работников. Оставляйте отказы в работоспособности только для тех случаев, когда перезапуск процесса действительно является правильным решением.
Шаг 8: проверьте изменения, используя метрики трафика и задержки в хвостовой части графика, аналогичные тем, что используются в производственной среде, а не только результаты одного успешного тестового запуска.
Как определить, какое решение подходит именно для вашей модели отказов?
Наблюдаемая закономерность
Наиболее полезное первое изменение
Чего не следует делать в первую очередь
Звонки завершаются сразу после истечения срока, установленного клиентом; потоки данных в нисходящем направлении здоровы.
Увеличьте внутренний тайм-аут и пересмотрите бюджет внешнего дедлайна.
Увеличьте количество повторных попыток.
Количество ошибок 429 и тайм-аутов пула увеличивается с ростом количества параллельных запросов.
Снизьте параллелизм и добавьте очереди/обратное давление.
Запустите больше агентов параллельно.
Периодические ошибки 408/5xx или сбои в сети.
Используйте ограниченное количество повторных попыток с экспоненциальной задержкой для идемпотентных операций.
Повторять каждое исключение бесконечно.
Обработка запросов обычно занимает больше времени, чем позволяют лимиты шлюза.
Используйте асинхронную архитектуру заданий или поддерживаемую потоковую архитектуру.
Продолжайте повышать только значение таймаута SDK.
Одна медленная зависимость доминирует в задержке p99.
Оптимизируйте, кэшируйте, заменяйте или изолируйте эту зависимость; рассмотрите возможность использования резервного варианта.
Настройте тайм-ауты несвязанных агентов.
Сбои возникают только после добавления параллельных агентов.
Сохраните полезный параллелизм, но добавьте глобальный семафор и ограничения для каждого поставщика.
Предположим, что параллельное выполнение всегда быстрее.
Практическая производственная база
Для типичного API с несколькими агентами надежным базовым решением является присвоение каждому рабочему процессу идентификатора корреляции, отслеживание каждого вызова агента и инструмента, определение единого сквозного крайнего срока, назначение более коротких крайних сроков для каждого вызова внутри него, обеспечение глобального ограничения параллельного выполнения для каждого нижестоящего поставщика, ограничение количества повторных попыток и их идемпотентность, а также сохранение достаточного объема состояния для возобновления или сообщения о частичном завершении.
Затем настройте систему на основе измерений. Если система стабильна, но слишком медленная, выборочно распараллеливайте независимые задачи. Если она быстрая при низкой нагрузке, но дает сбой при пиковой нагрузке, уменьшите разветвление и добавьте обратное давление. Если успешные рабочие процессы по своей природе занимают больше времени, чем позволяет синхронный путь запроса, смените архитектуру, вместо того чтобы пытаться заставить каждый прокси-сервер ждать дольше.