Хорошая связка Ollama–Obsidian — это не просто чат-окно, возвращающее текст. Для управления личными знаниями (PKM) более важным критерием является способность системы использовать нужные вам заметки, сохранять ваш контроль над хранилищем, отвечать с приемлемой скоростью и признавать, когда ответа нет в ваших заметках. Если эти условия не выполняются, смена модели, настроек поиска или конфигурации плагина будет полезнее, чем бесконечная настройка промптов.
По состоянию на сентябрь 2026 года локальный API Ollama по умолчанию все еще обслуживается по адресу http://localhost:11434, маршруты API находятся в разделе /api, а локальный доступ не требует аутентификации. Ollama также предоставляет эмбеддинги для семантического поиска и генерации с дополненной выборкой (RAG), что делает ответы на вопросы по всему хранилищу качественно отличными от обычного чата. См. официальное введение в API Ollama, документацию по локальной аутентификации и документацию по эмбеддингам.
В этом руководстве в качестве примера сообщества используется плагин Copilot for Obsidian, поскольку его проект в настоящее время поддерживает локальные модели Ollama и рабочие процессы, ориентированные на хранилище. Точная формулировка настроек может меняться между релизами плагинов, поэтому, если ярлык в вашей установке отличается от скриншотов или шагов ниже, используйте актуальный репозиторий Copilot for Obsidian и его руководство по настройке локальной модели.
Какого результата должен достичь успешный локальный PKM-сетап?
Прежде чем что-либо устанавливать, определите желаемый результат. Полезная локальная настройка должна проходить четыре практических теста:
- Соединение: Obsidian может достичь модели, которую Ollama действительно обслуживает на вашем компьютере.
- Привязка к контексту (Grounding): когда вы спрашиваете о заметке или своем хранилище, ответ отражает содержание соответствующей заметки, а не полагается только на общие знания модели.
- Производительность: время ответа и использование памяти достаточно приемлемы, чтобы вы реально использовали этот рабочий процесс.
- Контроль: вы знаете, какой плагин может читать или изменять заметки, какой конечный точки модели он использует и включены ли какие-либо дополнительные функции веб или облака.
Эти критерии важны, потому что «локальная модель подключена» и «хорошее управление личными знаниями» — это не одно и то же. Чат может работать идеально, в то время как поиск по хранилищу слаб, и даже мощная модель может давать плохие ответы, если извлекаются неверные заметки.
Шаг 1: Установите Ollama, загрузите модель и проверьте локальный API
Установите Ollama, используя официальные инструкции для вашей операционной системы. Ollama в настоящее время поддерживает macOS, Windows и Linux; официальное быстрое начало является самой безопасной отправной точкой, поскольку рекомендации по установке и моделям со временем меняются.
Загрузите чат-модель перед открытием Obsidian. Например:
ollama pull gemma3
ollama ls
Вам не обязательно использовать gemma3. Важно, чтобы имя модели, которое вы позже введете в Obsidian, совпадало с моделью, которую Ollama может перечислить локально. Начните с модели, которую ваш компьютер может комфортно запускать, вместо того чтобы автоматически выбирать самую большую доступную модель.
Затем проверьте API независимо от Obsidian:
curl http://localhost:11434/api/tags
Если эта команда возвращает JSON-список, содержащий вашу модель, базовая служба Ollama работает. Вы также можете выполнить ollama ps, пока модель активна. Ollama документирует эту команду как способ увидеть, загружена ли модель в память CPU, память GPU или их смесь. Если ответы мучительно медленные или машина становится невосприимчивой, это сигнал перейти на меньшую модель или уменьшить требования к контексту, а не предполагать, что проблема в Obsidian.
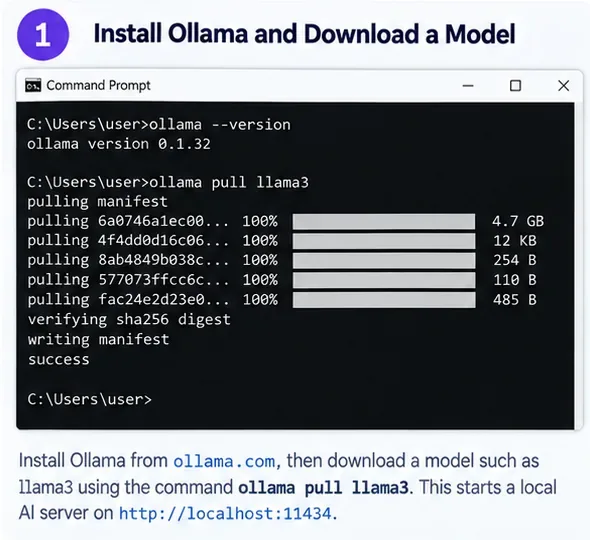
Иллюстрация, сгенерированная ИИ, шага установки Ollama и загрузки модели. Номера версий и детали загрузки моделей, показанные на изображении, являются иллюстративными, а не записью текущего релиза.
Шаг 2: Установите плагин Obsidian и подключите его чат-модель к Ollama
Obsidian рассматривает плагины сообщества как сторонний код. Его официальная документация предупреждает, что эти плагины выполняют код от вашего имени, поэтому проверьте исходный код плагина и разрешения, если ваше хранилище содержит конфиденциальные материалы. Чтобы установить один из них, откройте Настройки → Плагины сообщества, включите плагины сообщества при необходимости, выберите Обзор, затем установите и включите плагин. Точный процесс задокументирован на официальной странице помощи Obsidian по плагинам сообщества.
Для этого руководства установите Copilot из каталога сообщества и убедитесь, что плагин указывает на проверенный проект Copilot for Obsidian, связанный выше. Избегайте выбора плагина с похожим названием только потому, что он появляется первым в результатах поиска.
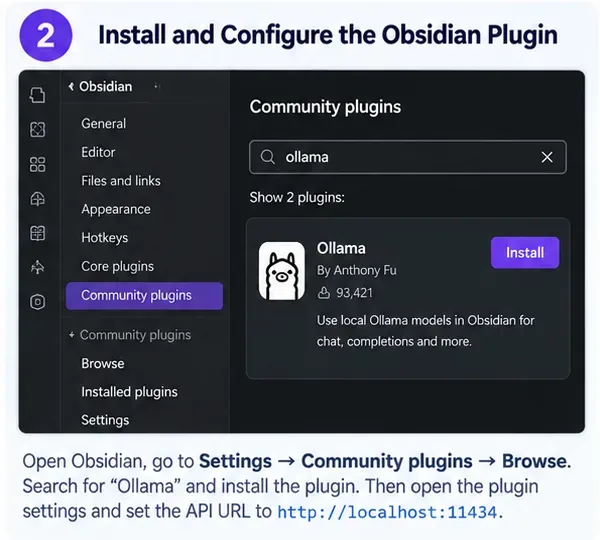
Концептуальная иллюстрация, сгенерированная ИИ, браузера плагинов сообщества. Карточка плагина, имя автора и количество загрузок, показанные на изображении, являются иллюстративными и не должны рассматриваться как проверенные данные каталога; используйте проверенный проект Copilot, связанный в этой статье.
Откройте настройки Copilot и найдите область конфигурации моделей, которая в настоящее время организована в его настройках Models. Добавьте пользовательскую чат-модель со следующими значениями:
- Провайдер: Ollama.
- Модель: точное имя локальной модели, сообщаемое
ollama ls.
- Базовый URL:
http://localhost:11434.
- API-ключ: Сам Ollama не требует его для доступа к localhost. Если поле плагина требует заполнителя, следуйте текущим инструкциям этого плагина, а не придумывайте облачный ключ.
Есть простая ошибка с URL, которую следует избегать. При тестировании Ollama вручную конечные точки API выглядят как http://localhost:11434/api/chat. Однако нативный провайдер Ollama в Copilot ожидает базовый адрес сервера и конструирует конечную точку внутренне, поэтому используйте http://localhost:11434, если текущий плагин специально не запрашивает полную конечную точку. Аналогично, не добавляйте /v1 при использовании нативного провайдера Ollama. Отдельный API Ollama, совместимый с OpenAI, использует /v1, но это другой путь интеграции.
Шаг 3: Протестируйте привязку к заметкам перед индексацией всего хранилища
Не начинайте с индексации тысяч заметок. Сначала докажите, что базовое чат-соединение работает с небольшим контролируемым тестом. Создайте временную заметку, содержащую три факта, которые легко проверить, такие как название проекта, срок и решение. Затем прикрепите или упомяните эту заметку в Copilot и попросите модель резюмировать только то, что написано в заметке.
Хороший результат должен точно воспроизводить эти факты, избегать добавления неподтвержденных утверждений и оставаться в рамках запрошенного вами объема. Плохой результат может отвечать из общих знаний, игнорируя заметку, выдумывать детали или опускать важный факт, который явно присутствует.
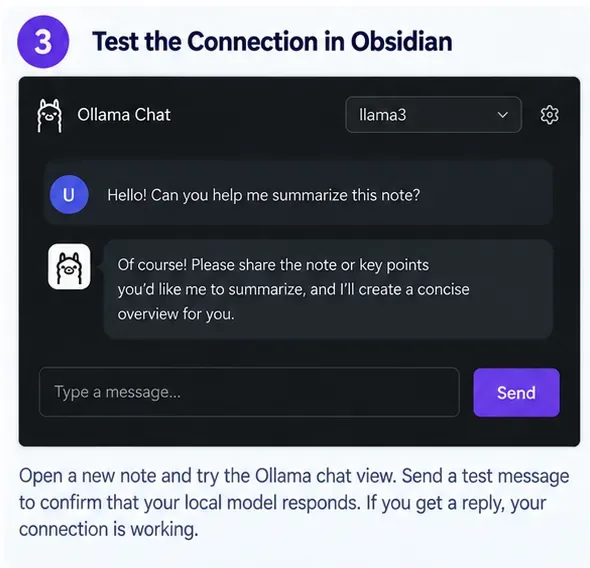
Концептуальная иллюстрация, сгенерированная ИИ, локального чат-теста в Obsidian. Она демонстрирует тип результата, который нужно проверить, а не реальный скриншот конкретного релиза плагина.
Если ответа нет, устраняйте неполадки снизу вверх. Сначала повторно выполните curl http://localhost:11434/api/tags. Если это не сработает, проблема в Ollama, а не в Obsidian. Если API работает, но Copilot нет, перепроверьте имя модели и базовый URL. Только после этих проверок следует исследовать проблему origin/CORS. Текущий код Copilot включает путь запроса, предназначенный для обработки локального доступа к Ollama, в то время как его руководство по локальной настройке также документирует OLLAMA_ORIGINS для конфигураций, требующих прямого доступа с origin Obsidian. Используйте метод, задокументированный для вашей установленной версии Copilot, вместо автоматического применения старых обходных путей с переменными окружения.
Шаг 4: Добавьте поиск, учитывающий хранилище, только если чат на уровне заметок проходит тест
Для управления личными знаниями наибольшее улучшение качества часто достигается за счет поиска, а не перехода на более крупную чат-модель. RAG означает, что система сначала извлекает фрагменты ваших заметок, которые кажутся релевантными, а затем передает эти фрагменты языковой модели в качестве контекста. Это позволяет локальной модели отвечать на вопросы об информации, на которой она никогда не обучалась.
Чтобы сделать поиск также локальным, используйте модель эмбеддингов Ollama. Текущая документация Ollama рекомендует такие модели, как embeddinggemma, qwen3-embedding и all-minilm. Например:
ollama pull embeddinggemma
Настройте эту модель в настройках поиска по хранилищу или эмбеддингов QA в Copilot, используя провайдера Ollama, затем создайте или перестройте локальный индекс. Используйте одну и ту же модель эмбеддингов для индексации и запросов; Ollama явно рекомендует это, потому что векторы, созданные разными моделями, не являются напрямую взаимозаменяемыми.

Концептуальная иллюстрация, сгенерированная ИИ, рабочего процесса с заметками на базе Ollama. Названия команд и макет меню являются примерами, а не утверждением о точном интерфейсе текущего релиза Copilot.
Как только индексация завершится, протестируйте поиск с вопросами, ответы на которые вы уже знаете. Спросите о факте, который появляется в одной заметке, затем о связи, требующей двух заметок. Наконец, спросите о чем-то, чего нет в хранилище. Лучший результат — не самый плавный ответ; это тот, который использует правильные доказательства и отказывается выдумывать отсутствующие факты.
Как судить, достаточно ли хорош результат
| Проверка качества | Сигнал успеха | Когда менять подход |
|---|
| Локальное соединение | /api/tags работает, и та же модель отвечает в Obsidian | Если curl не работает, сначала исправьте Ollama; если только Obsidian не работает, проверьте настройки модели/URL плагина |
| Привязка к заметкам | Известные факты из прикрепленной заметки воспроизводятся точно | Если чат игнорирует заметку, исправьте выбор контекста перед сменой моделей |
| Поиск по хранилищу | Релевантные заметки последовательно всплывают для вопросов с известными ответами | Если поиск слаб, улучшите эмбеддинги/индексацию или сузьте область индексации |
| Качество генерации | Модель отделяет подтвержденные факты от неопределенности | Если поиск хорош, но ответы слабые, попробуйте более мощную чат-модель |
| Задержка | Вы можете взаимодействовать без повторяющихся долгих задержек | Если Ollama в основном ограничена CPU или памятью, используйте меньшую модель или меньше контекста |
| Конфиденциальность | Настроенная конечная точка — localhost, а дополнительные облачные/веб-функции отключены | Если активна удаленная конечная точка или веб-инструмент, рабочий процесс больше не является полностью локальным |
Когда большая модель — не правильное решение
Если ответы неверны, потому что система извлекает неправильные заметки, обновление чат-модели может улучшить прозу, не исправляя доказательства. Сначала улучшите поиск. И наоборот, если правильные отрывки извлекаются, но модель не может надежно синтезировать их, тогда лучшая чат-модель может помочь.
Аппаратное обеспечение также устанавливает практический предел. Ollama отмечает, что файлы моделей могут потреблять значительный объем хранилища, а большие контексты потребляют больше памяти. Используйте ollama ps, чтобы увидеть, как загружается текущая модель. Рабочий процесс, который технически работает, но занимает столько времени, что вы перестаёте его использовать, не является успешной системой PKM.
Ограничения конфиденциальности и безопасности «локального» ИИ в Obsidian
Сам локальный API Ollama не требует аутентификации, что удобно на одном компьютере, но также означает, что вы не должны небрежно открывать порт 11434 для сети. Держите его привязанным локально, если только вы сознательно не защищаете удаленную конфигурацию.
Также помните, что «Ollama локальна» не означает автоматически, что «весь рабочий процесс Obsidian офлайн». Плагины сообщества могут содержать интеграции с облачными провайдерами, веб-поиск, телеметрию или инструменты агентов. Проверьте текущие настройки плагина и отключите функции, которые вы не собираетесь использовать. Если ваша цель — строгая офлайн-обработка, протестируйте с отключенной сетью после того, как все модели и плагины уже установлены.
Финальная самопроверка
Ваш сетап готов для повседневного управления личными знаниями, когда все следующие утверждения верны: API Ollama отвечает локально; Obsidian использует именно ту локальную модель, которую вы имели в виду; контролируемый тест заметки возвращает правильные факты; поиск по хранилищу находит правильные заметки для вопросов с известными ответами; неподтвержденные вопросы не вызывают уверенной выдумки; и производительность достаточно быстрая, чтобы вы действительно использовали рабочий процесс.
Если верны только первые два утверждения, вы успешно подключили Ollama к Obsidian, но у вас еще нет надежного помощника по управлению знаниями. Рассматривайте качество поиска, поведение модели и конфигурацию конфиденциальности как отдельные части системы и меняйте ту часть, которая действительно дает сбой.









